030|REALM:让语言模型在预训练时学会检索外部知识
论文:Kelvin Guu 等,REALM: Retrieval-Augmented Language Model Pre-Training,ICML 2020。原文 · PDF。本文聚焦潜在文档检索、掩码预训练和索引刷新,不把它简化成部署时手工加一次搜索。
先接住前作的问题
BERT把恢复文本所需信息主要压入参数,事实更新与容量因此受限。本篇组合遮盖预测与外部文档检索,追问没有逐条相关性标签时,阅读收益能否训练检索器。DPR的问答监督检索是平行路线,不能把两种训练信号混为一谈。
五个前置概念
五个前置概念是潜变量、边缘似然、稠密检索、最大内积搜索和索引刷新。掌握它们,后续读 DPR、RAG 与 Self-RAG 时就能辨别哪些部分在训练、哪些只是部署接口。
一、问题设定:外部文档怎样从词预测收益中获得检索监督
参数模型从语料压缩知识,更新事实通常需要再训练或编辑;外部文档可直接替换,却还需被找到并正确读取。本篇把知识访问拆为检索和阅读,希望最终词预测的改善给检索器提供监督,而非只优化词面匹配或独立相关性。
如果检索器只用词面匹配,问题与答案文档的表达差异可能导致漏检。若检索器独立训练,它优化的相关性未必等于阅读器真正需要的信息。REALM 希望让“帮助预测目标”成为检索学习的依据。
二、从文档边缘似然推导后验责任差
设输入为 、目标为 、检索文档为 :
检索器参数为 ,知识增强编码器参数为 。文档得分通常由查询与文档嵌入内积构成,再归一化成检索概率。实际无法遍历全库,使用最大内积近似检索找到较少候选进行计算。
若某文档使正确目标概率高于当前总体水平,其检索权重可获得正向学习信号;没有帮助的文档则相对被压低。直觉上,阅读成功为检索提供弱监督,但这是通过概率目标而非显式“这篇文档相关”标签实现。
文档编码器更新后,索引中的旧向量可能过时。论文通过异步刷新等机制减轻陈旧问题。梯度训练文档表示不等于每次更新后整个大型索引瞬间完全一致,这个系统近似影响训练质量。
检索器收到的是后验责任与先验之差
固定问题或损坏输入 和正确目标 ,令 枚举候选文档。检索概率为 ,文档条件答案概率为 ,边缘概率 。对检索logit 求导得 。第一项正是给定正确答案后的文档后验责任。帮助解释正确答案超过其原有检索份额的文档被抬高,无需人工逐条标注哪篇相关。
教学算例。 两篇文档检索概率各0.5,答案概率分别0.8和0.2,则边缘答案概率0.5,文档后验为0.8和0.2,两个logit梯度为+0.3与−0.3。若正确文档根本没进top-k,这次近似训练不会凭空给它同样梯度;索引召回与刷新频率因此直接影响学习,不仅影响查询速度。
构造问题“某定理由谁提出”,两篇候选分别是相关数学史与无关旅游文章。若相关文档使正确名字概率更高,边缘似然倾向提高它的检索权重。检索器因此可以从预测收益学习,不需要每个问题单独标注文档ID。
文档责任在全部候选同样无用时怎样变化
若所有候选都给正确答案相同概率0.2,则边缘概率也为0.2,正文的后验责任恰等于检索先验,各检索logit梯度为零。检索训练需要阅读器能区分候选对目标的帮助;仅有不同检索分数并不足以产生“哪篇更有用”的信号。这个退化例可用于检查边缘化梯度实现。
教法联系:Lilian Weng的Extrinsic Hallucinations in LLMs。算例为本文自构。
三、在候选近似与异步刷新之间训练检索和阅读
输入:无标签文本、外部文档库、初始化检索与阅读模型
选择有信息的遮盖目标,构造查询输入
用查询嵌入在当前文档索引中检索top-k候选
对每候选文档计算检索概率与目标恢复概率
对候选边缘化,最大化正确目标似然
更新检索器与知识增强编码器
周期或异步重编码文档并刷新索引
下游开放问答微调时继续使用检索与阅读接口
再把知识库文档更新为新事实,但索引向量仍是旧版本。检索可能找不到新内容,或得分不再匹配实际文本。知识可编辑不等于系统即时完成一致更新,文本、向量和缓存都需要版本管理。
四、按配置读取开放问答与陈旧索引消融
它不是仅把搜索结果拼到固定模型前,也不等同于后续 RAG 的所有生成形式。
先保持语料与评估集身份,再读最终EM、检索器替换和索引陈旧消融。
| 项目 | 原文范围 |
|---|---|
| 预训练数据 | 分别使用 Wikipedia 或 CC-News;检索知识库均为 Wikipedia,不能混合两种配置的最好成绩 |
| 知识库规模 | 2018-12-20 英文 Wikipedia 快照,按最多 288 个 BERT wordpiece 切块,超过 1300 万个候选 |
| 训练预算 | 200k 步,batch size 512,学习率 ,使用 64 个 Google Cloud TPU;文档嵌入另在 16 个 TPU 上并行计算 |
| 候选与更新 | 预训练对 8 个候选边缘化,包含空文档;微调及推理考虑 top-5,索引约每 500 步刷新 |
| 下游数据 | 表1 列 NQ 约 79k/4k、WQ 约 3k/2k、CT 约 1k/1k 训练/测试样本 |
| 最直接对照 | ORQA;作者保持微调设置、超参数和训练数据一致,比较预训练机制 |
| 指标 | 最终答案 exact match(EM),以及消融中的零样本检索 Recall@5;两者评价的模块不同 |
| 资源边界 | 330M 参数之外还有外部知识库、索引和重编码;单机 12GB GPU 可执行不等于整个训练只用这些资源 |
这些设置来自原文 §4.3、§4.5 与表 1。独立随机种子次数及统一置信区间在这里未逐项确认,因此下面按原表的点估计解释结果。
证据一,方法中的潜变量定义与检索梯度。它说明最终预测怎样监督检索。候选近似和索引陈旧意味着实现不是精确全库求和。
证据二,表1 的开放问答测试结果。ORQA 的 NQ/WQ/CT EM 为 33.3/36.4/30.1;Wikipedia 预训练的 REALM 为 39.2/40.2/46.8,CC-News 预训练版本为 40.4/40.7/42.9。以 NQ 为例,CC-News 版本比 ORQA 高 7.1 个百分点;但它在 CT 上低于 Wikipedia 版本 3.9 个百分点。数据配方没有在所有任务上同方向改善,不能拼接各列最优值,创造一个并不存在的统一模型结果。原文表 1
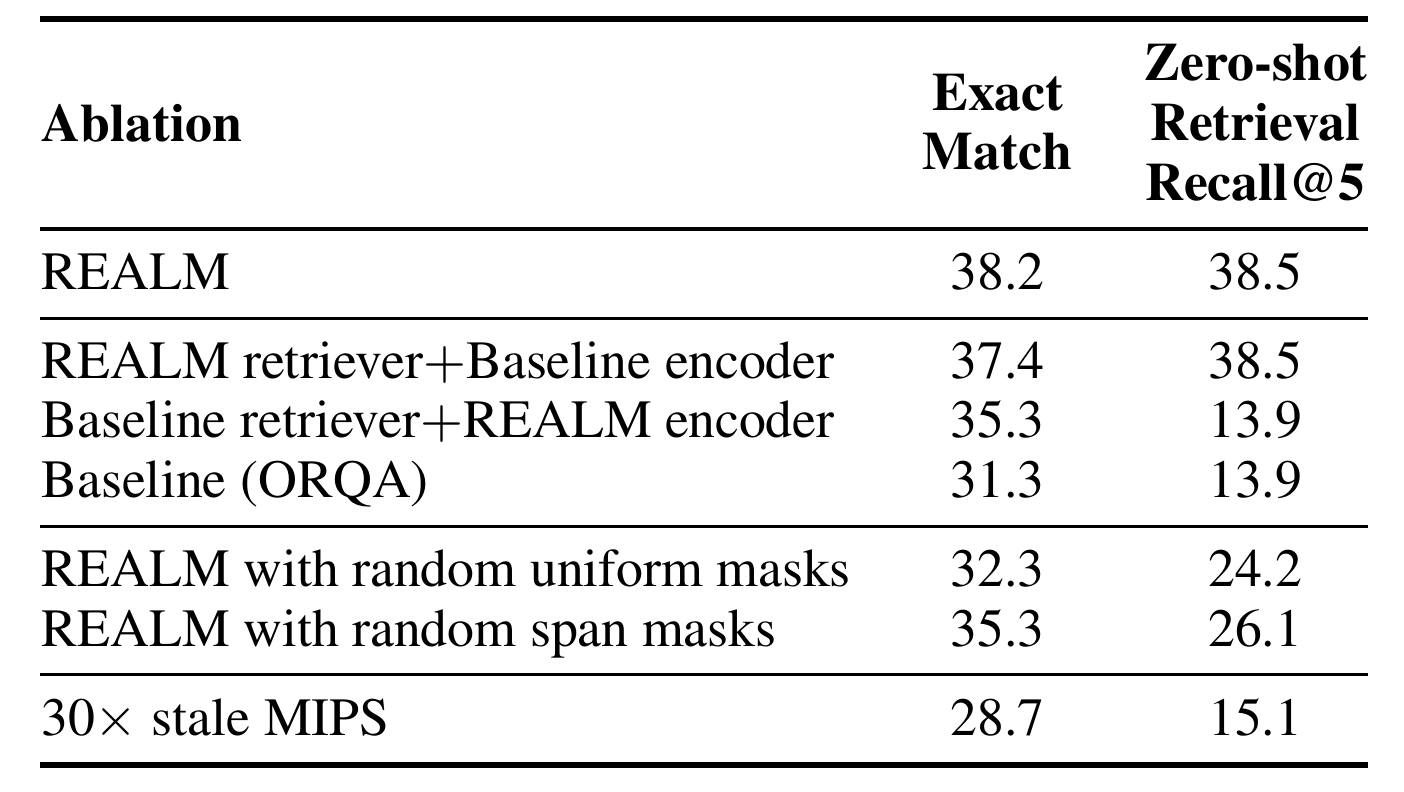
证据三,表2 的 NQ 开发集消融。完整 REALM 的 EM 为 38.2;换回基线检索器后为 35.3;索引陈旧程度增加 30 倍时为 28.7。最后一项比完整模型低 9.5 个百分点,直接支持刷新机制在该训练设置中的重要性。这里是开发集,不能与表1 的测试分数直接相减;消融也没有证明任何系统都应固定每 500 步刷新。原文表 2、§4.5
证据四,表3 的遮盖词例子。相关文档使正确词的条件概率明显提高,但对候选边缘化后的概率仍取决于检索权重。这个例子展示训练机制如何起作用,不能替代全体查询的统计,也没有测量答案对来源的普遍忠实程度。原文表 3
文档库可能包含答案与相近表述,这是检索任务允许的知识来源;但评价问题或标注格式直接泄露进训练又是另一问题。应区分合法知识访问与测试污染,不能把所有答案出现在文档中都称为污染,也不能完全不检查来源。
应分别检查检索召回、阅读条件准确率和最终EM。最终答对可能来自参数记忆,检索正确也可能被阅读器误用;拆开指标才能定位失败。还可以替换相关文档为反事实版本,观察模型是否依赖提供材料,但这种测试不等于真实事实校验。
费用也需要包含建索引与刷新。若只报告一次查询延迟,忽略大规模文档重编码,就低估训练或知识更新成本。检索增加外部资源使用,是性能机制的一部分,应透明记录。
五、答对不证明使用证据,更新文档也不等于更新系统
如果阅读器已经靠参数记住答案,所有文档给出类似概率,检索学习信号可能较弱。反过来,如果检索完全漏掉有用材料,阅读器无法从候选中发现正确证据。这说明两模块训练存在相互依赖,并非联合目标自动解决冷启动。
限制包括候选漏检、索引陈旧、知识库错误、模块耦合和计算。它提供更灵活知识来源,不保证答案有可追踪引用或不会忽略证据。
可以构造四格诊断:相关文档被检索且答案正确、检索正确但答案错误、未检索到相关材料却答对、两者都失败。前两格区分阅读能力,第三格提示参数知识或猜测,第四格需要进一步定位。再限制阅读器只能使用候选证据,并与原模型比较,能够更清楚检验外部知识贡献。所有这些都是教学实验方案,未执行前不能报告比例;其价值是把一个最终EM分数拆成能够行动的误差来源,而不是增加另一项模糊总分。
知识库可更新是一种系统能力;若新文档没有进入索引,或者查询编码器无法召回它,参数之外的最新事实仍无法帮助回答。
六、把本篇机制再推进一步
1. 阅读器不用文档也能答对时,检索器一定获得强监督吗?
参考答案:不一定。若各候选使正确答案概率接近,后验责任与原检索概率接近,检索logit梯度就弱。最终EM高可能掩盖这种情况;可分别看召回、条件阅读和替换证据实验,但未执行前不能把参数记忆比例当作已测结论。
七、对照监督检索,再转向序列生成边缘化
从遮盖目标学习检索之后,还可把阅读输出改为文本生成。RAG沿检索增强发展不同文档混合方式;DPR提供显式正段落监督的平行检索路线,可比较两者如何得到检索梯度。
自测与参考答案
1. 没有文档相关标签,检索器怎样学习?
通过正确目标的边缘似然。能让阅读器更好预测的文档得到相对更有利的梯度,形成任务驱动的弱监督,但候选必须包含有用信息。
2. 文档编码器更新后,为什么索引会成为问题?
索引保存旧向量,与当前模型不一致,可能改变检索排序和训练信号。全库重编码昂贵,因此需要刷新策略并接受一定近似。
3. 最终EM高,是否证明模型忠实使用检索证据?
不能。模型可能靠参数记忆答对,也可能偶然猜中。需要检索与阅读分解、证据替换等额外分析,才能判断实际信息来源。