029|语言模型规模定律:把模型、数据与计算放进同一个预算问题
论文:Jared Kaplan 等,Scaling Laws for Neural Language Models,2020。原文 · PDF。本文讨论特定模型族与训练范围中的经验规律,不把拟合指数当作自然定律;后续 Chinchilla 对资源配比的修订另有专篇。
先接住前作的问题
GPT-2展示任务随规模变化,但尚未回答同一预算下该扩大模型、增加数据还是延长训练。Megatron与ZeRO扩大可训练容量,本篇则研究如何分配这些资源,是经验规律层面的补充,不是新的模型层。
五个前置概念
五个前置概念是幂律、瓶颈、计算前沿、外推和资源约束优化。理解这些,比记住一个指数更能帮助阅读后续大模型训练报告。
一、问题设定:固定训练预算应分给参数、数据还是更新步数
模型太小可能容量不足,数据太少可能过拟合,计算太少又会让大模型尚未学好就停下。预算增加时究竟应扩大参数、增加独立文本还是训练更久?要测其中一项的规律,必须先避免另外两项成为瓶颈,并在固定计算约束下比较学习曲线。
所以“参数增加时损失下降”不是无条件命题。相同参数模型经过不同训练步数,质量可以差很多;固定总算力时,扩大参数又意味着每个样本更贵、可处理样本减少。这些约束共同决定最优点。
论文主要指标是验证或测试文本交叉熵,不是竞赛推理正确率、人类偏好或事实真实性。损失曲线平滑,不意味着每个离散任务指标也按同样幂律变化。
二、由幂律与计算约束推导资源前沿
论文在相应受限条件下使用类似:
是非嵌入参数, 是数据token数, 为按论文方式调整的计算量。比例常数和指数来自实验拟合。它们不是从语言本质严格推导出的恒等式,也不能无限外推到损失为零。
稠密Transformer训练常用近似计算关系 ,其中 是每步token、 是步数;具体忽略项与口径以原文为准。用它可以把“模型更大”和“看到更多token”置于同一预算约束,但上下文、嵌入和硬件效率仍可能影响真实费用。
研究流程不是训练一个最大模型后宣称规律,而是训练多个规模、数据量和长度配置,找到每个预算下损失较低的包络,再拟合可预测关系。若实验点没有覆盖最优附近,前沿估计可能偏向某种配比。
幂律斜率应在对数坐标里读
若某受控范围内损失近似 ,其中N为不含嵌入的参数量、a为尺度常数、α为拟合指数,则 。参数翻倍只把损失乘以 ,不减去固定分值。原文计算预算约为 ,B为每步token数、S为更新步数;独立数据量D与实际见过的BS个token还需区分,多次重复会让二者不同。
教学算例。 取纯教学指数α=0.1,参数扩大10倍,损失只乘 ;从2降至约1.589 nats时,困惑度由 降至 。同一损失改善映射到困惑度是非线性的,更不能直接换算成某知识考试提升多少点。
把幂律比较换成可以直接验算的倍率
若某拟合项为A乘参数量的−α次方,将参数翻4倍,只让这一项乘4的−α次方;不可约损失项不会同倍下降。因而读log图时,斜率对应可下降部分的比例变化,不能把参数四倍直接翻译成困惑度或任务错误率下降四倍。
三、训练多条学习曲线并留出尺度检验预测
定义模型族、数据、分词与损失口径
选择多组参数规模、数据规模、batch和训练步数
训练并记录完整学习曲线及验证损失
在其他因素不构成瓶颈的区域拟合单变量幂律
估计各计算预算下的最优质量前沿
用未参与拟合的规模或预算检查预测误差
输出:经验拟合、适用范围与资源分配建议
合理实验需要多条学习曲线,在相同计算预算处比较,并检查曲线是否覆盖合适停止点。然后将部分规模留作预测验证,而不是所有点都参与拟合后只展示拟合优度。
四、区分实际计算、临界batch修正与拟合外推
它是一篇关于训练规律的研究,伪代码描述实验方法,而非虚构一个新梯度优化器。
图中的实际计算与临界batch修正是不同横轴口径,外推段也不是已训练点。
| 项目 | 原文范围 |
|---|---|
| 模型 | 主要为因果Transformer系列及架构变化研究 |
| 数据 | WebText2等定义下的数据规模与分布比较 |
| 参数口径 | 非嵌入参数,不能直接与所有模型总参数混用 |
| 计算口径 | 估计FLOPs与batch调整后的计算前沿,非直接美元价格 |
| 指标 | 文本预测交叉熵,固定分词与评估语料 |
| 不确定性 | 拟合残差、覆盖范围与外推误差比单个最优值更关键 |
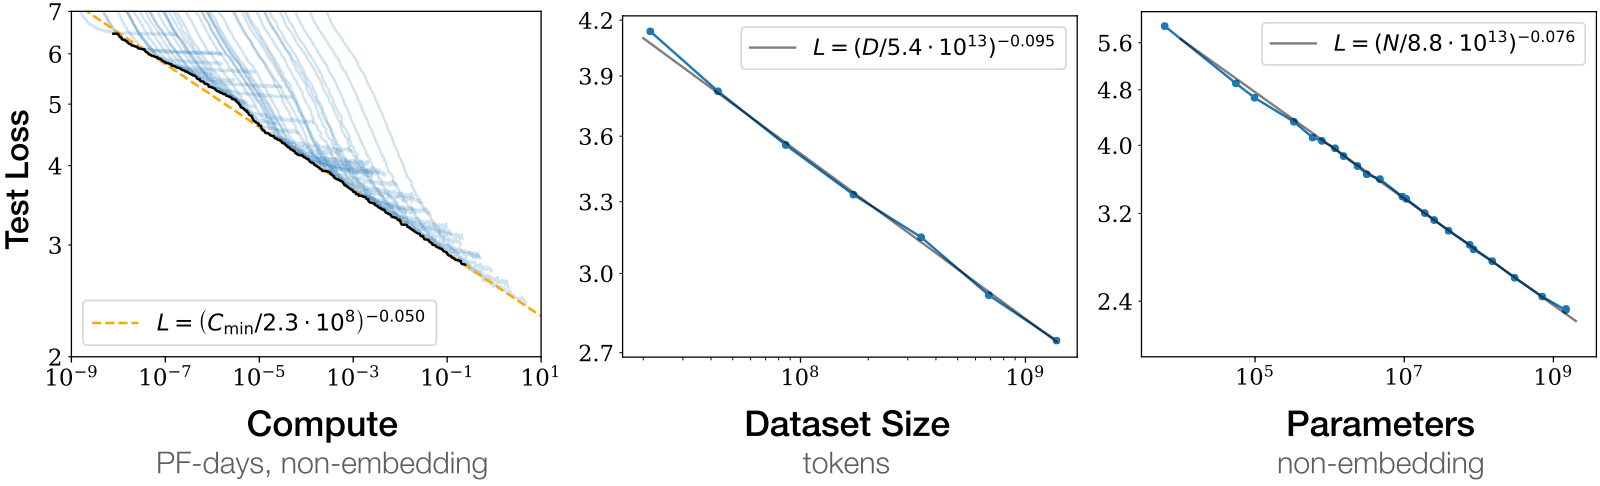
证据一,图1 与第 3 节。参数、数据与计算呈现平滑趋势,但每条曲线有相应非瓶颈条件。不能从一条曲线推出同时任意改变三项也保持相同关系。 图中的计算最优线包含对临界 batch 的修正;后面的纯实验曲线与修正曲线需分开读,不能把外推拟合当成每一点都实际训练过。
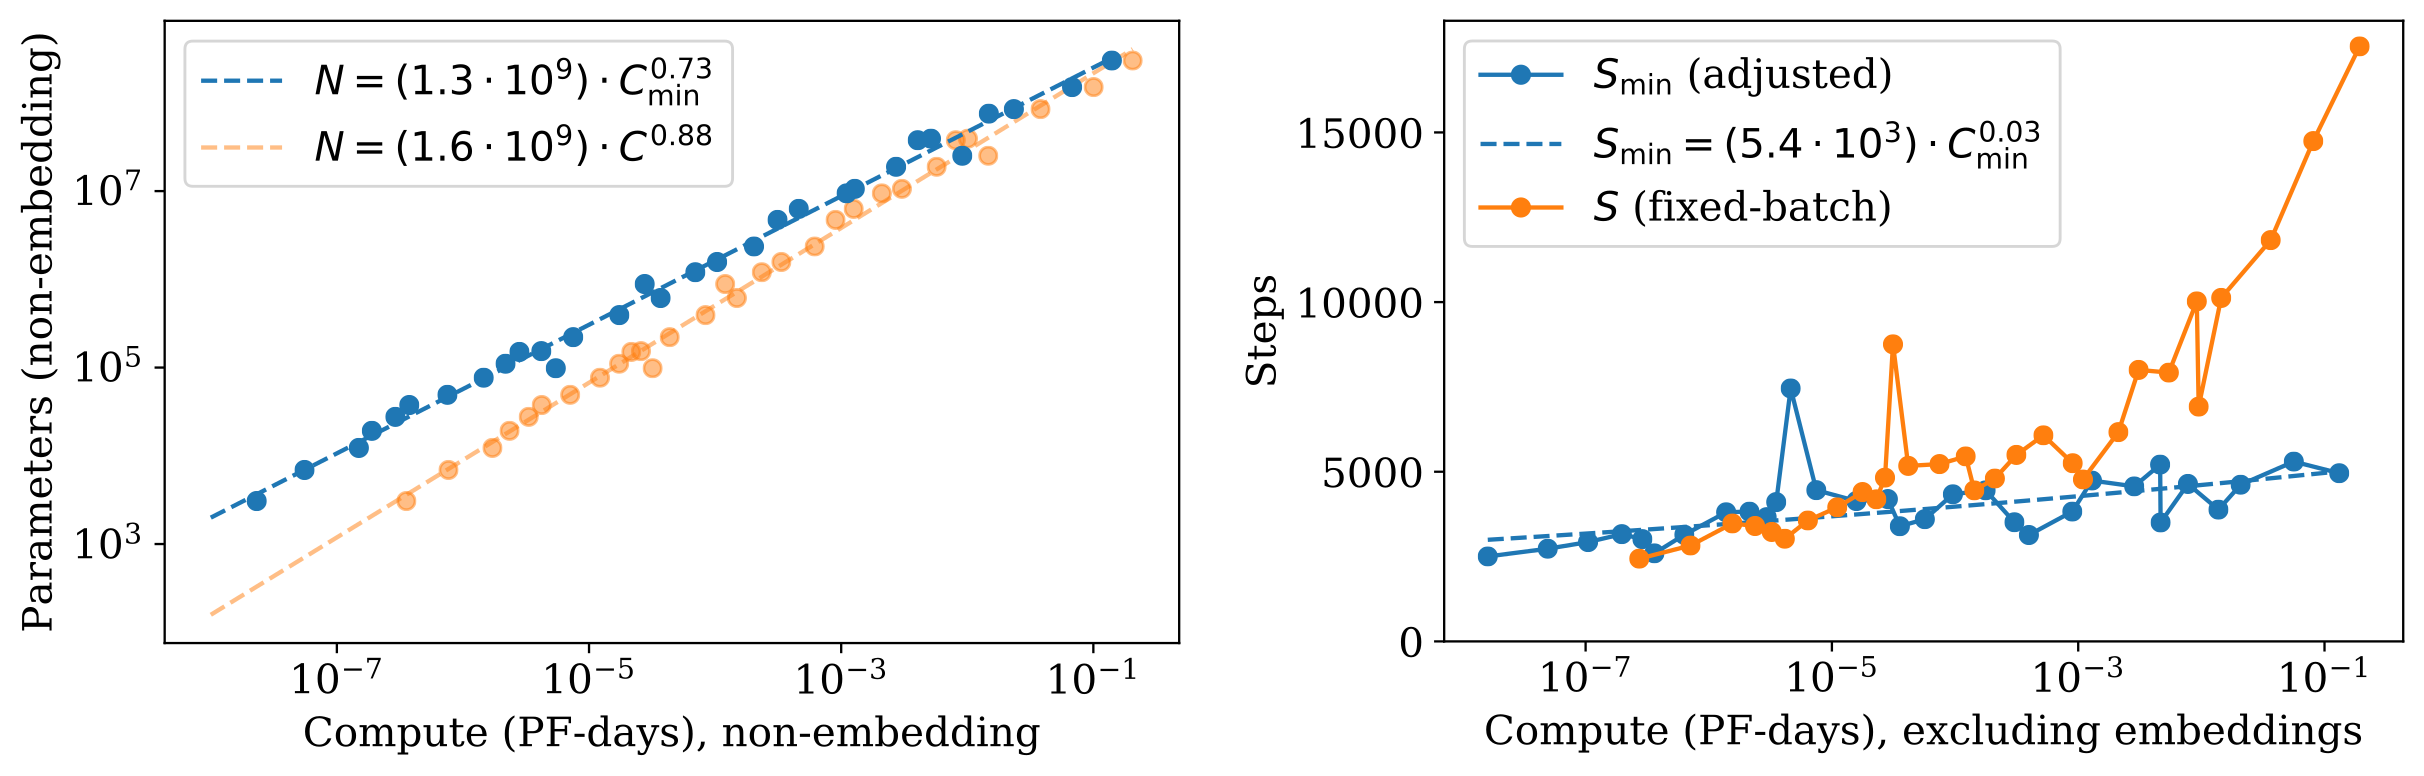
证据二,第 5—6 节、图13、图14。论文调整batch相关效率后估计计算最优前沿,给出 等配比。指数是该实验和拟合的结果,不是任何模型必须遵守的常数。
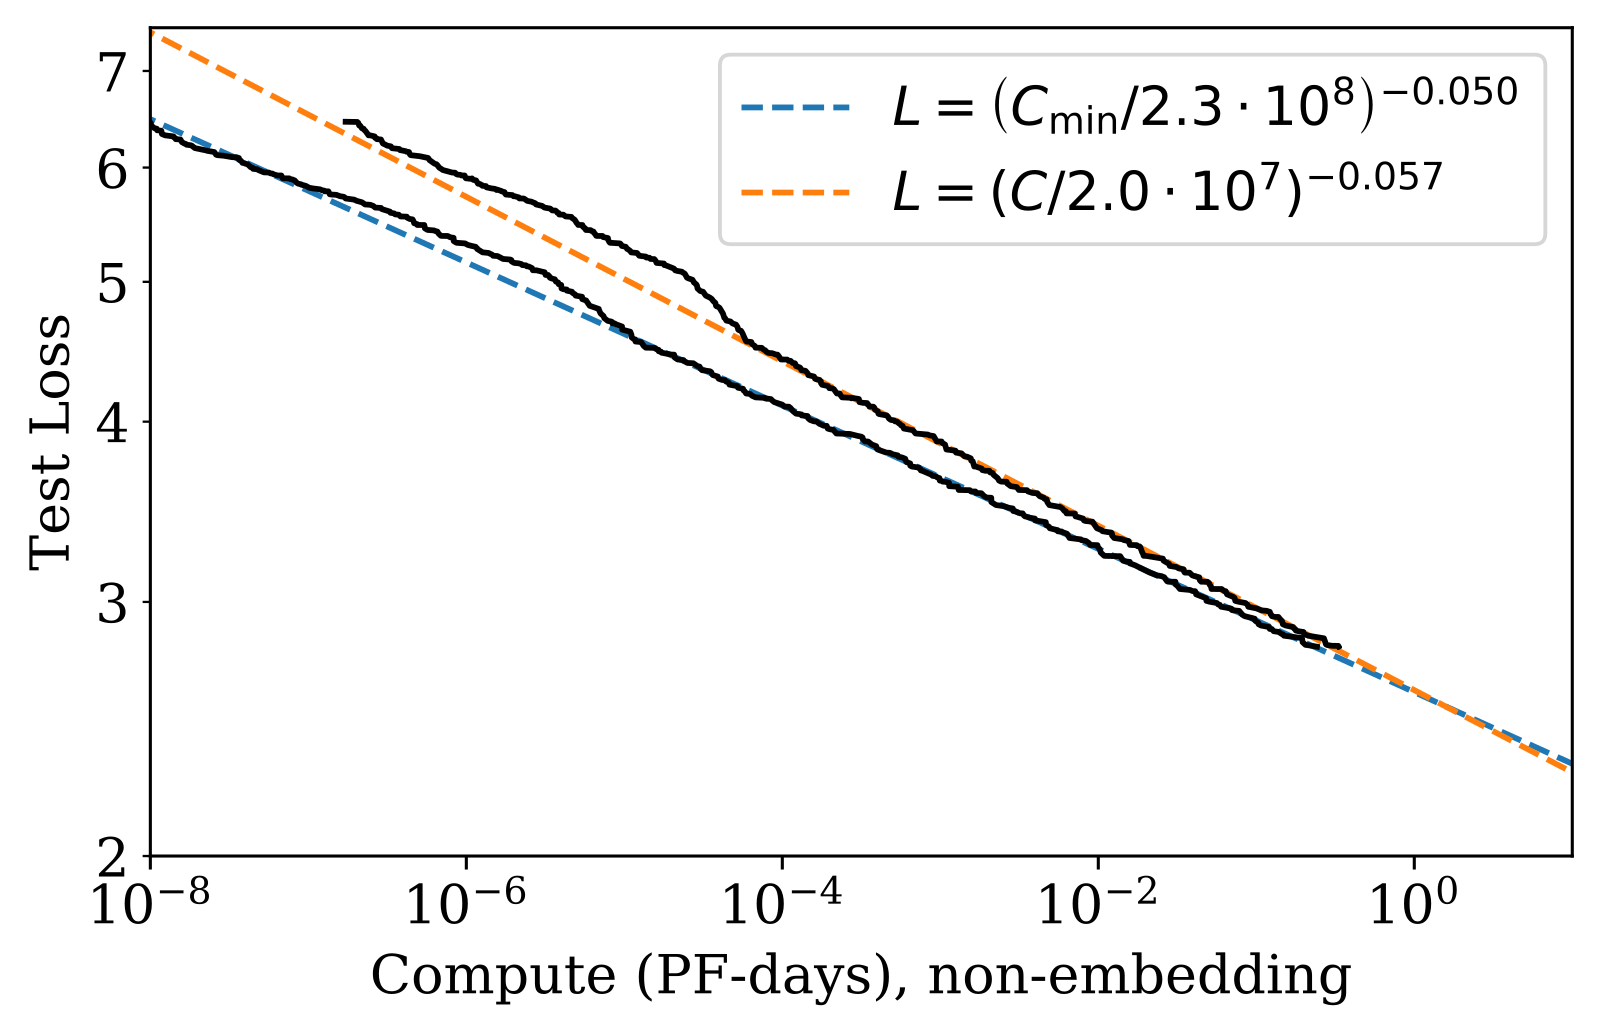
读图13的两条虚线。 横轴是非嵌入计算量,纵轴是测试损失;橙色拟合使用实际计算量C,蓝色拟合使用临界batch修正后的C_min。先分清修正口径再比较斜率,两条线并不是两种模型在完全相同实际训练预算下的随机重复。图中的拟合延长也不等于在所有外推预算上都完成了训练。
证据三,汇总表与数据泛化分析。对参数、数据和步数关系的汇总使预测可检查,也暴露口径要求。跨分布损失变化不能被简化为所有任务同样受益。
按指数作教学计算:预算增加十倍时,,建议参数增长约五倍,剩余资源用于更多样本或更新。这是根据原拟合计算的示例,不是实际新训练结果,更不是部署时的唯一经济最优选择。
构造三组模型,小模型训练到收敛,中模型半程,大模型只训练几步。如果直接画参数对最终损失,可能得到“大模型更差”。这反映训练不足,不是容量规律。反过来,若大模型同时训练更久,也无法隔离参数效应。
五、训练最优配比不等于全生命周期最优
更重要的是,如果指标是准确率,少量损失变化可能让一批样本跨过判定阈值,形成看似突然提升。连续损失规律与离散任务变化并不矛盾,但不能直接互相证明。
若只训练一次却服务数十亿次请求,较小模型训练更久可能在部署阶段节省大量计算。论文主要优化训练预算下损失,并未自动把未来请求量、延迟与内存纳入目标。
因此实际规划应写清 之类成本,其中 为预期调用量。这是本文提出的教学扩展,不是原文同一拟合公式。目标改变后,最优参数与数据配比可能改变。
数据也不是可无限复制的免费资源。重复同一语料与增加新独立文本,可能具有不同信息收益;清洗质量与领域覆盖也影响损失。只用token计数可能掩盖这些差异,后续研究需要更细数据模型。
限制是实验范围、拟合形式、数据质量、计算近似和目标选择。后续不同配方得到不同配比,是经验科学的更新,而非说明所有规模分析都无意义。
拟合时还应检验残差是否随规模系统变化。若大模型持续偏离同一幂律,可能说明新瓶颈或拟合形式不适合,不能只因为总体相关高就继续远距离外推。报告预测区间、留出点和失败预测,比只展示对数坐标上的直线更能证明规律具有决策价值。
损失的平滑变化不保证某项离散任务分数平滑变化;准确率还受到判分规则和样本难度影响。
六、把本篇机制再推进一步
1. 拟合相关很高但大模型残差持续同向,是否应该继续按同一幂律外推?
参考答案:这可能提示新瓶颈或拟合形式不适合。应查看残差随规模的系统变化,使用未参与拟合的尺度检验,并报告预测区间;总体相关高无法替代外推有效性。若目标改成部署总成本,还应重新定义预算约束,而非继续套用训练指数。
七、重估训练前沿,再把预算带到推理阶段
最优配比取决于训练长度如何测量。Chinchilla直接重检参数与数据分配,LLaMA再把累计推理需求放进决策。后继路线改变的是实验和成本目标,不是无条件废除经验幂律。
自测与参考答案
1. 为什么不能把0.73当作通用常数?
它由特定模型、数据、训练与计算口径拟合而来。改变配方或目标可能改变最优前沿,必须用新实验验证。
2. 相同预算下更大模型一定更好吗?
不一定。每步更贵导致可处理token减少,模型可能训练不足。需要比较预算约束下的完整质量曲线,而不是只比较容量。
3. 训练计算最优为何可能不适合大量部署?
大模型每次推理更贵。若调用次数多,额外训练较小模型可能降低总成本。应把训练和服务费用纳入同一目标再选择规模。