057 · Chinchilla:同样的训练算力,该买更多参数还是更多数据?
返回目录 · 上一篇:自一致性 · 下一篇:Flamingo
论文:Jordan Hoffmann等,Training Compute-Optimal Large Language Models,2022。原始论文 · 全文。
先接住前作的问题
Kaplan规模规律给出参数、数据和计算之间的经验关系,但训练长度与学习率调度会影响如何寻找最优点。本篇重新扫描这一配比;LLaMA后续重视推理成本,目标函数又与纯训练预算不同。
五个前置概念
五个前置概念:FLOPs是浮点运算次数估计;交叉熵衡量预测真实token的损失;幂律拟合用尺度指数描述经验关系;等计算量曲线固定预算比较模型选择;学习率调度改变训练各阶段的更新幅度。
一、问题设定:固定训练算力应怎样分给参数与数据
给定一笔训练FLOPs预算,更大的模型必须相应少读数据。问题不是参数能否提高容量,而是在预算约束下哪种参数量和训练token数组合使最终损失最低;后面的400多次扫描将检验这个资源分配问题。
二、由经验损失的边际平衡推导最优配比
令为模型参数量,为训练中处理的token数,为训练计算量。研究问题是
这是资源配置问题,不是强化学习任务。语言模型仍用下一个token的交叉熵训练。论文没有改变每个样本的学习目标,而是改变“选多大模型、训练多久”。
此前扩展规律研究强调较大模型的样本效率,行业模型规模快速上升,训练token却常停留在相近数量级。Chinchilla指出,在固定计算预算下,样本效率与计算效率不是一回事:更大的模型每读一个token也更贵。
是处理过的token数,不自动等于唯一文本数量。附录A显示部分MassiveText子集重复超过一轮。不能把“多训练token”简单等价为“按相同比例增加独立知识”。数据质量、去重、分布与重复次数都会改变有效信息量。
第一种方法在不同模型、不同训练长度的学习曲线中,寻找每个预算下最低损失的位置。关键是针对目标训练长度设置学习率调度,不能从一个很长训练计划的中途检查点直接推断短预算最佳表现。
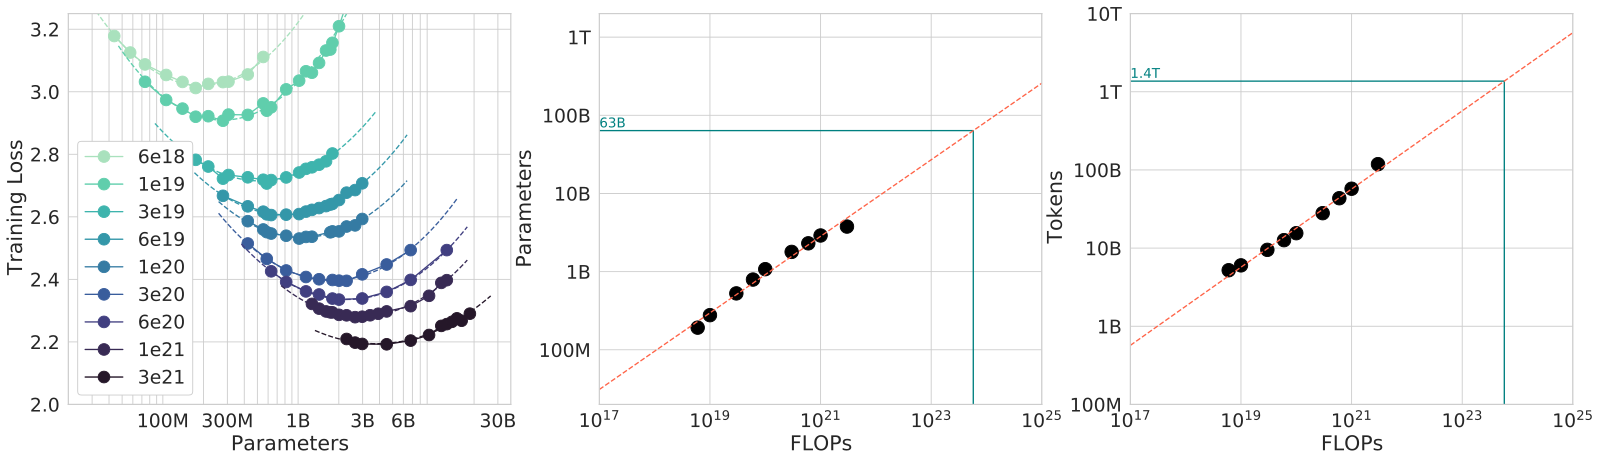
第二种方法固定FLOPs,改变参数量并相应调整训练token,画出IsoFLOP曲线。如果模型过小,容量不足;过大,训练token不够;中间出现谷底。对每个预算拟合谷底,再拟合最佳规模随算力的幂律关系。
第三种方法拟合参数化损失面:
代表无法由有限模型与数据继续消除的基线项,描述有限容量影响,描述有限训练影响。这是经验模型,不是证明自然语言损失必须具有该形式。作者用对数损失上的Huber目标与L-BFGS拟合,降低异常点影响,并尝试多个初始化。
近似计算成本后,可以推导
因为固定乘积时,增加参数必然减少可训练数据。最优点让两种误差的边际改善相互平衡。近似的常数6来自密集Transformer训练成本模型,不应直接套到任意MoE、长上下文或硬件墙钟时间。
最优比例来自两项边际收益相等
设 为参数量与训练 token 数, 为不可约损失项, 是正的拟合常数, 是训练 FLOPs 预算。在经验损失 下,固定 ,代入 得 。令导数为零:。因此最优点平衡的是带指数的边际项,并非无条件要求N=D;在系数与指数对称的简化模型中,可以直接由对称性推出 ;一般情形则应解上式,并检查最优配比怎样随预算改变。
假设预算近似允许个抽象单位,方案A是,方案B是。B容量更大,但只读一半数据。如果损失近似为,A为0.2,B为0.25,因此A更优。这只是对称教学函数,不是论文拟合的实际系数。
从平方根配比反推新增算力怎么花
在参数与训练量指数都近似0.5的那组经验关系下,预算增加16倍对应两者各约4倍,二者乘积才是16。若只把参数扩16倍而训练token不变,虽也增加乘积,却离开拟合的最优配比。这个倍率核对依赖该经验区间,不能变成部署最优或数据无限可得的保证。
三、为每个训练长度匹配调度并扫描预算
输入:数据分布、候选模型规模、多个训练FLOPs预算
对每个预算 C:
    对每个候选规模 N:
        估算可处理token D,使训练FLOPs约为C
        设置与D对应的学习率衰减长度
        完成训练,记录损失、实际FLOPs与下游指标
    拟合该预算下损失最小的规模与token数
跨预算拟合 Nopt(C)、Dopt(C)
选择更大预算上的预测配置,进行独立大模型验证
理论推导解释拟合函数内部的最优分配,实验检验该函数是否足够描述实际训练。不能用“解出了最优公式”跳过函数假设与外推验证。
四、用三种拟合与大模型对照检验配比外推
先读取每条等计算曲线的最低点,再判断拟合外推;70B验证与Gopher还同时改变了优化器和数据配方。
| 项目 | 原文设置与目的 |
|---|---|
| 扩展实验 | 400多个模型,约70M至超过16B参数,训练token跨多个数量级;摘要给约5B—500B范围 |
| 三种分析 | 学习曲线最优包络、固定FLOPs谷底、参数损失面;检查结论是否依赖单一拟合方式 |
| 主要数据 | MassiveText;附录另做C4和GitHub子集分析 |
| 大模型 | Chinchilla70B,1.4T token;Gopher280B,相近训练FLOPs |
| 配置 | 表4:Chinchilla80层、64头、隐藏维8192,最大学习率1e-4,批量1.5M逐步到3M token |
| 非规模变化 | Adam改为AdamW,数据混合比例调整,tokenizer略改;不能将大模型对比视为仅参数与数据两个变量 |
| 评价 | 语言建模、阅读理解、闭卷问答、常识、57个MMLU任务、62个BIG-bench任务 |
| 不确定性 | 表2用80%训练点重采样100次估计幂律系数区间;这不是70B模型重复训练100次 |
最优研究关心训练FLOPs,因此并未完整优化全生命周期成本。若模型将服务极大量请求,更小模型训练更久可能进一步节省推理成本;若数据稀缺或延迟要求不同,优化问题需要改变。Chinchilla本身更小,推理和适配成本随之减少,但不能由参数比直接保证所有部署负载四倍提速。
证据一:图3与表2的分配规律。 曲线包络得到指数约0.50/0.50,IsoFLOP方法0.49/0.51,参数化方法0.46/0.54,区别于表中列出的旧研究0.73/0.27。三种方法共同支持参数与数据大致同步增长,不能把0.5当作跨数据、架构和优化器不变的自然常数。 IsoFLOP 图左侧每条曲线固定最终训练 FLOPs,低谷给出该预算内较合适的模型规模;中、右图再利用这些低谷做外推。
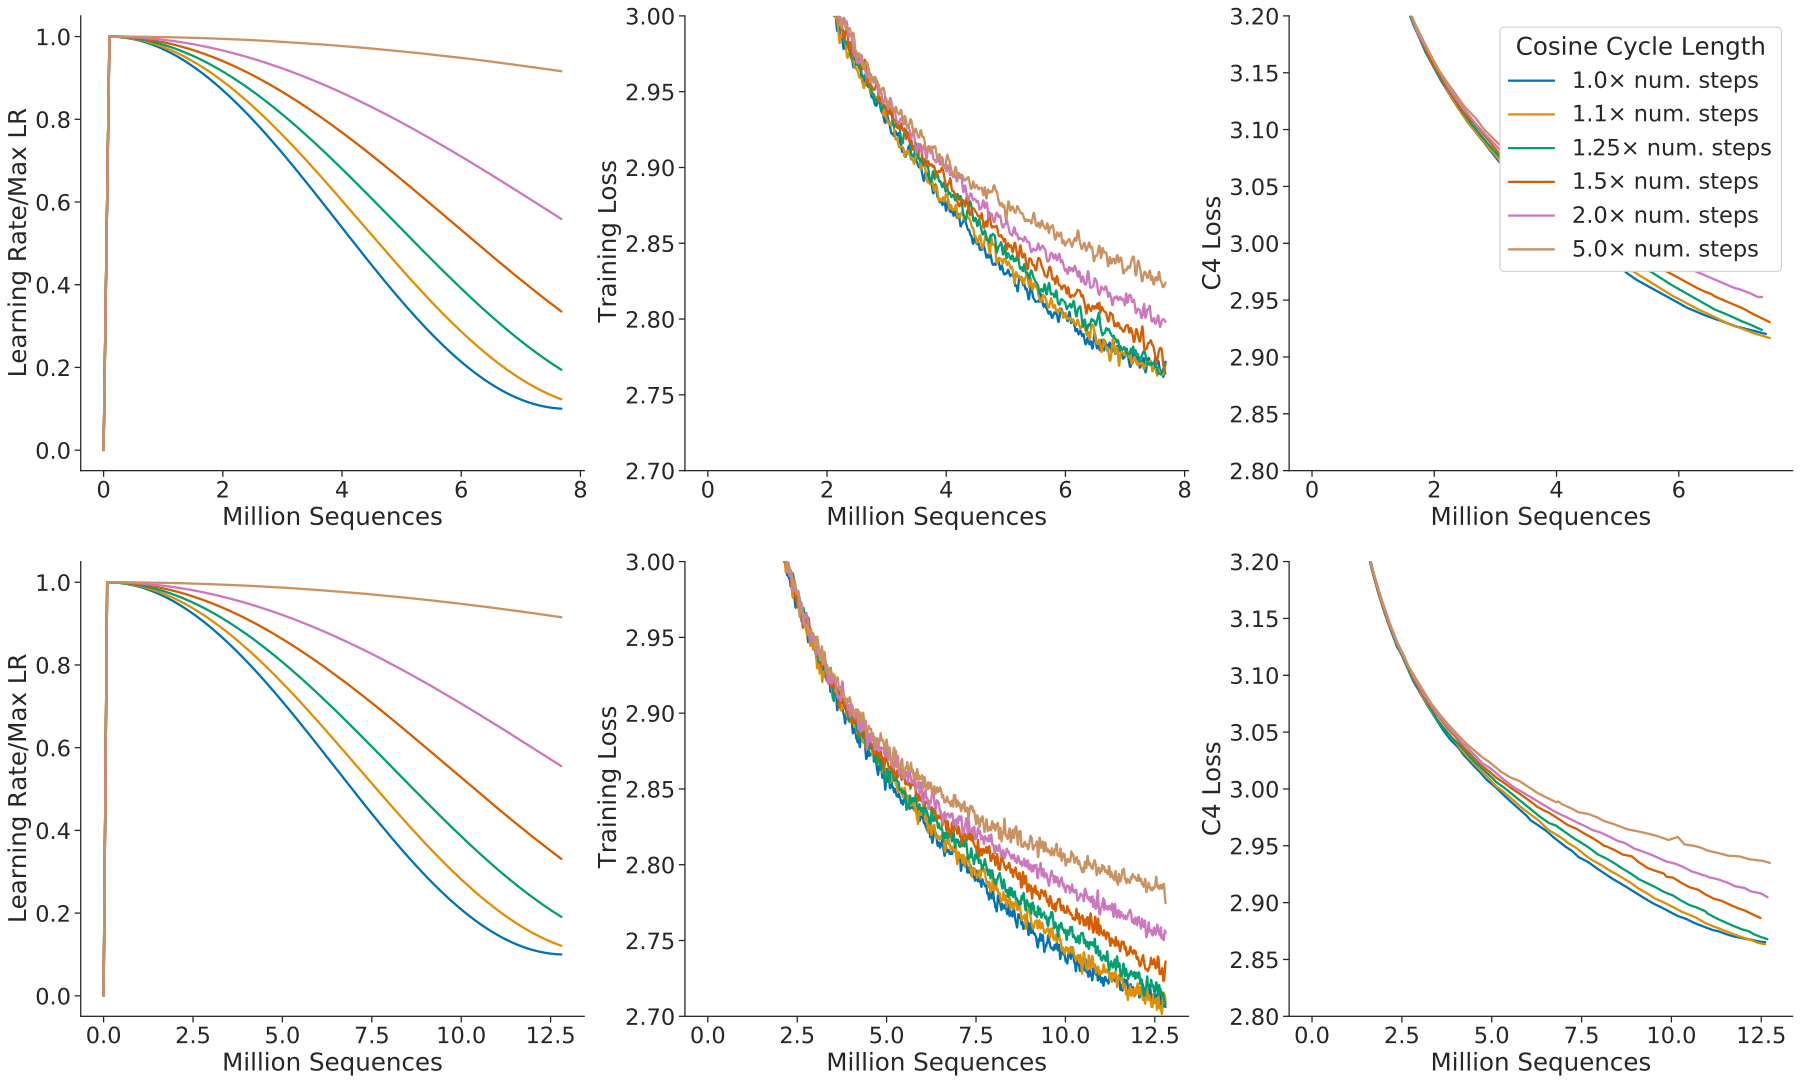
证据二:附录图A1的学习率调度。 衰减周期设得明显长于实际训练,最终损失会变差;超过目标训练长度25%的估计偏差开始出现清晰影响。它说明训练长度实验必须配套优化调度,否则可能把尚未衰减的模型误判为该预算下的最优模型。这里的25%是该消融现象,不是通用工程容差。
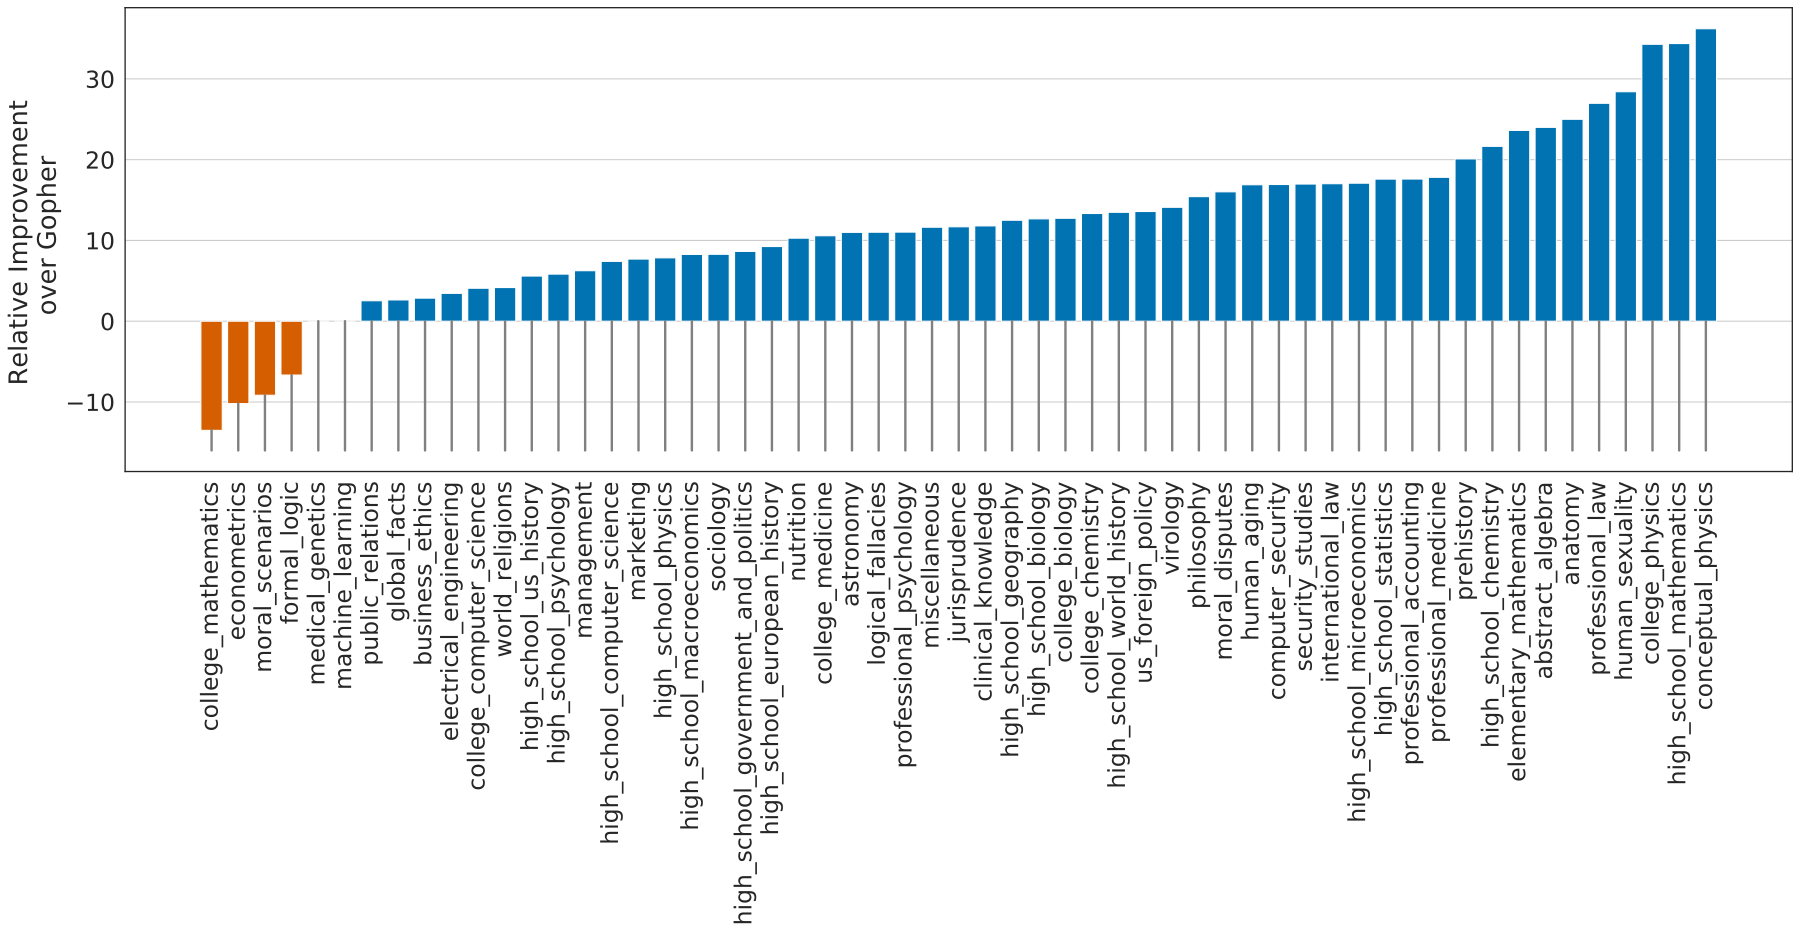
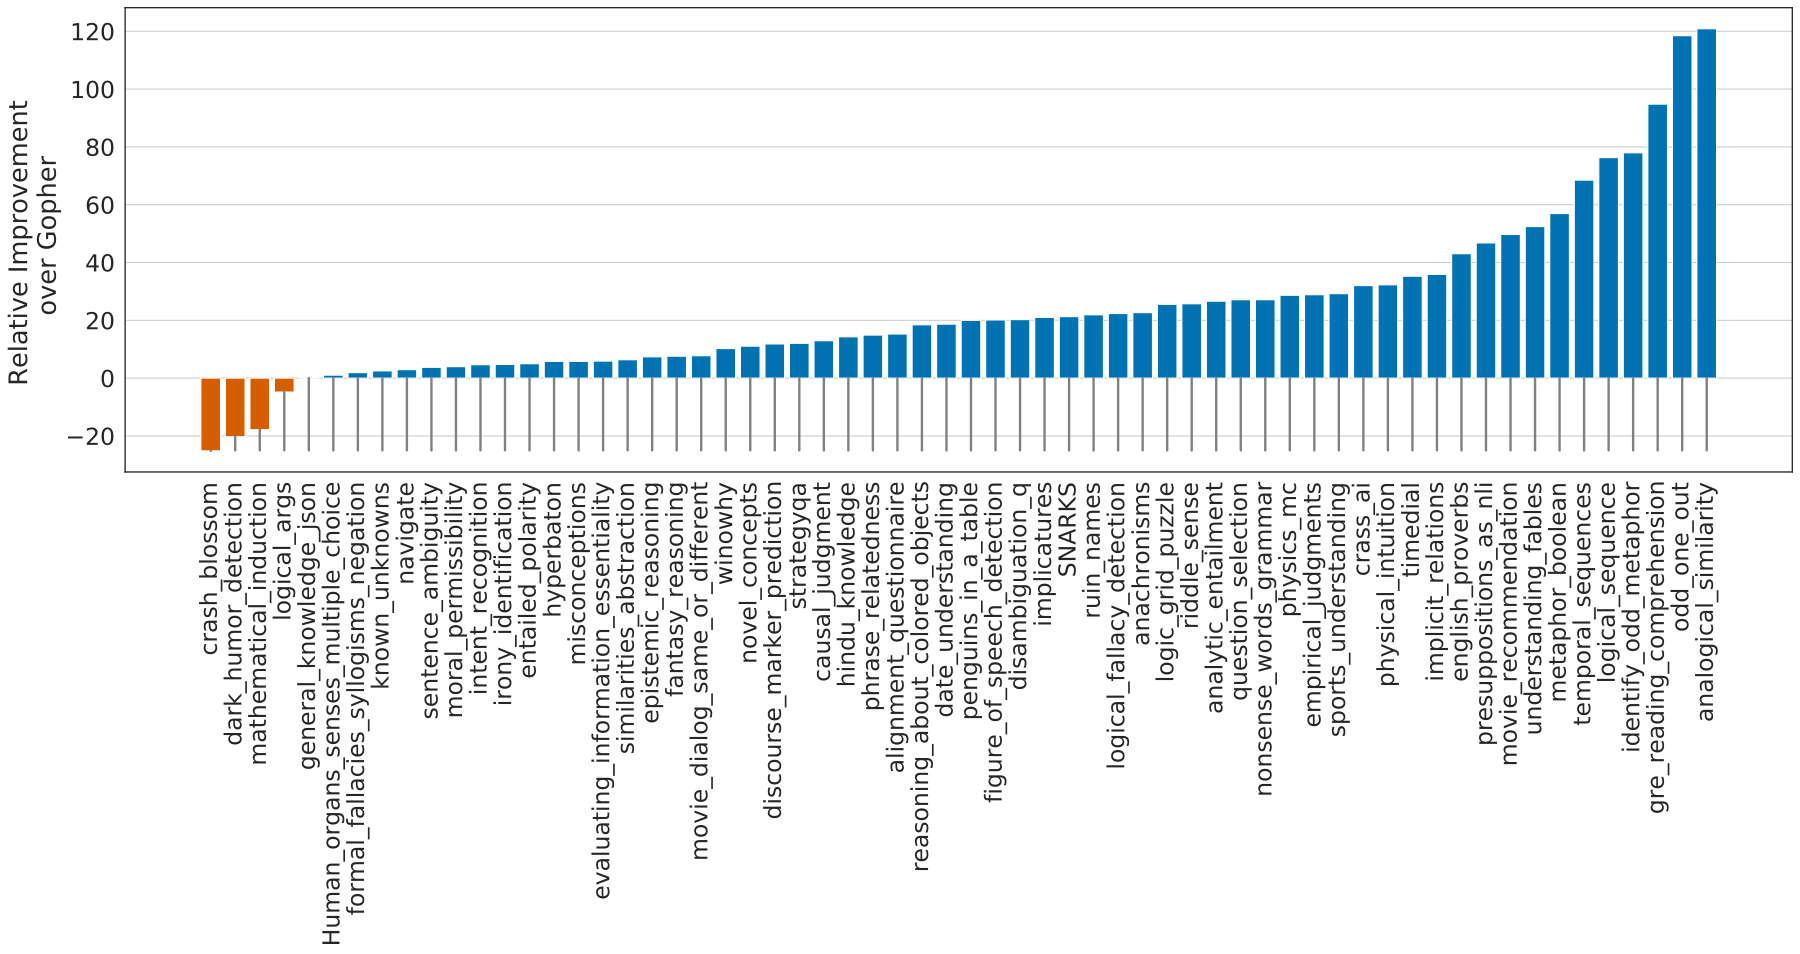
证据三:表6与图6的MMLU。 五样本平均分Gopher60.0%,Chinchilla67.6%,提升7.6个百分点,相对提升约12.7%。四个任务退化,包括大学数学、计量经济学、道德情景和形式逻辑,还有两个任务持平。平均提升不能解释成每种能力都提高。
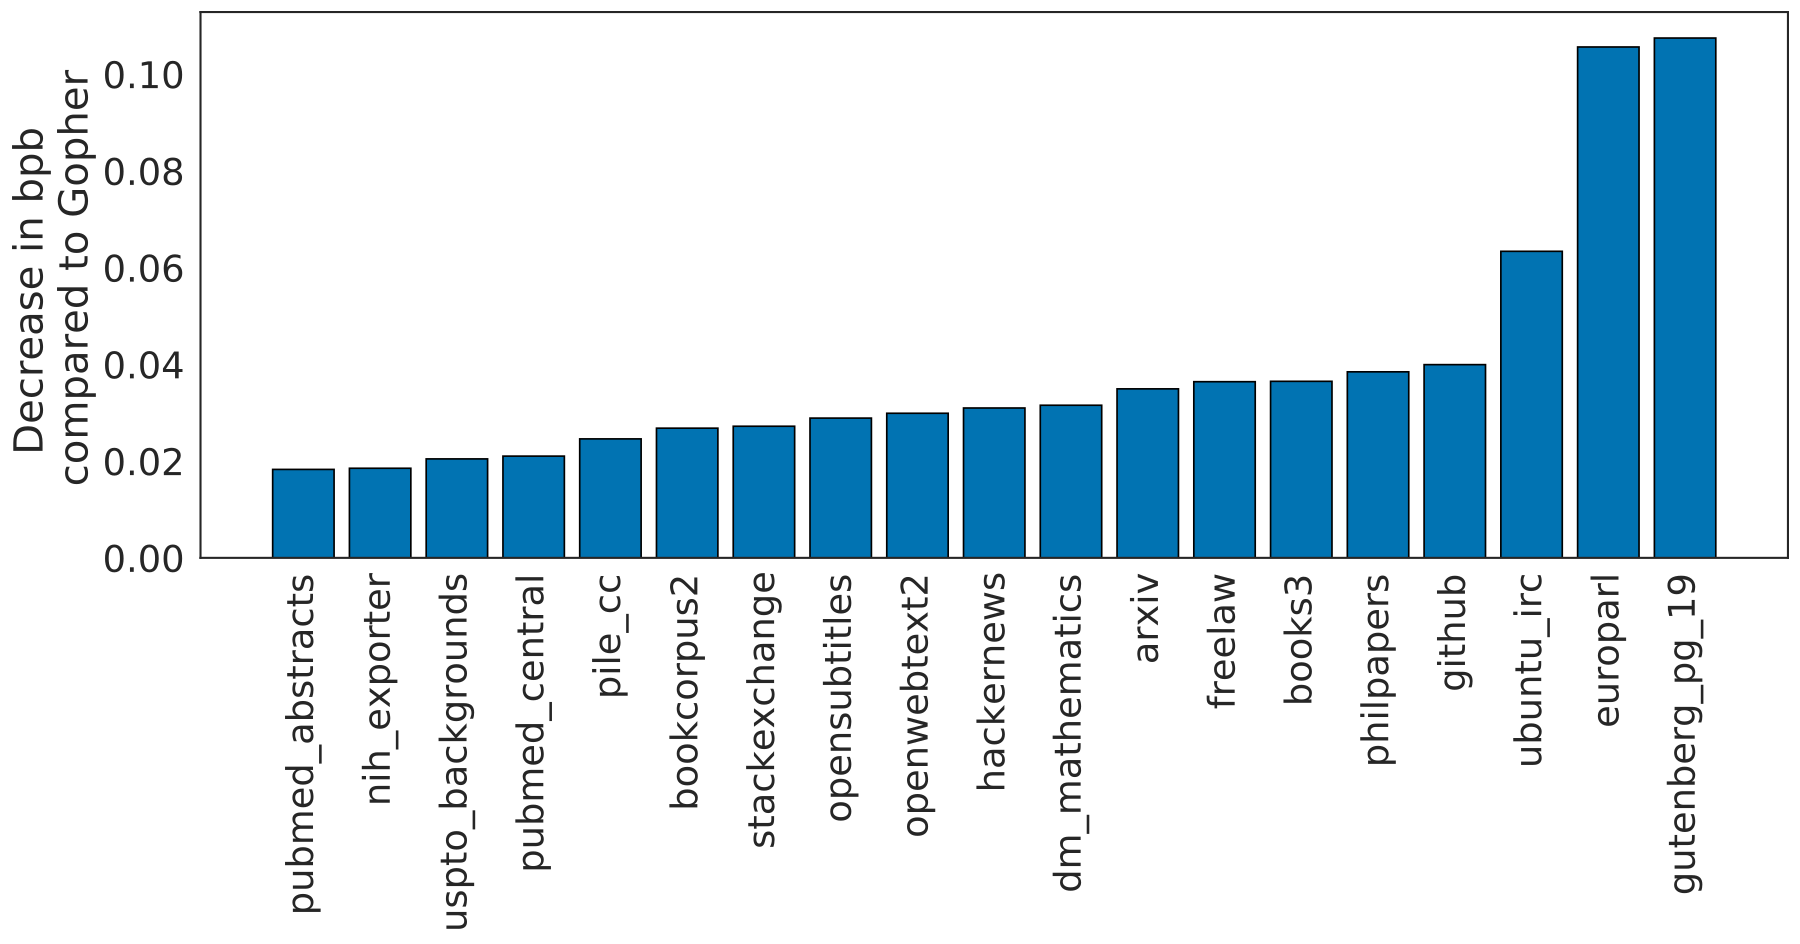
证据四:图5与§4.2.1的语言建模。 Chinchilla在所测Pile子集上优于Gopher,WikiText103困惑度从7.75降到7.16。作者同时提醒,训练数据更多可能增加训练测试重叠,因而不只依赖语言建模评估支持结论。困惑度下降也不是对应百分比的事实准确率提升。
证据五:表8与图7的广泛但非全面收益。 HellaSwag为80.8%对79.2%,Winogrande74.9%对70.1%,BoolQ83.7%对79.3%,PIQA二者同为81.8%。BIG-bench多数任务改善、四项例外。证据说明收益跨任务存在,同时保留了持平和退化的边界。
五、训练最优比例不直接决定长期服务成本
若任务需要更大容量,参数误差项权重增加,最优点也会移动。例子说明应比较边际收益,不能凭“参数多”或“数据多”单独下结论。
70B乘20得到1.4T,恰好是著名训练配置。表3中1B对应约20.2B token、10B对应205.1B,也接近这个比例。但它来源于某组经验拟合与训练目标,不是说每个参数需要读固定20个不同词才能学会。
尤其不能把它用作所有后续模型训练长度上限。更长训练可能改善某个固定大小模型,只是在仅最小化一次预训练成本的目标下未必最优;当推理次数进入总成本时,继续训练较小模型可能合理。这里是对优化问题的分析,而非论文已经验证所有部署策略。
三种拟合方法对Gopher预算的预测范围约40B—70B,也说明最佳规模本身有不确定性。作者选70B还考虑数据与计算效率。表3的极大规模投影距离实测范围很远,不应把几十万亿token需求作为已经实验确认的事实。
新的教学算例。 若损失为 、预算ND=100,导数条件为 ,故N=20、D=5,损失0.4;均分10、10的损失为0.5。容量误差更重时最优模型应更大。再加入大量部署请求的推理成本,约束不再仅为ND,原训练最优结论也应重算。
它改变了“扩大模型即提高效率”的默认看法,也强调数据建设与优化调度的价值。
局限包括拟合函数和计算近似、数据分布依赖、有限大模型验证,以及Chinchilla与Gopher同时改变优化器、tokenizer和混合比例。所有提升都只归因于参数/token分配会过度解释。原始MassiveText也不等同于完整开放可复建的数据,复现需要处理数据可得性。
六、把训练预算继续接到部署预算
训练最优仍不等于长期使用最优。LLaMA更重视小模型反复部署,推理时计算把回答阶段的搜索也放进生命周期账本;先选成本目标,再讨论配比。
自测与参考答案
1. 模型更有样本效率,为什么不一定更有计算效率?
答案:它可能用更少token达到目标损失,但每个token需要更多运算。固定FLOPs时必须同时乘上模型计算成本。样本更少只有在数据极昂贵或算力条件不同的目标下,才可能直接等于更优方案。
2. 为什么不能从长训练计划的中间点直接拟合短预算最优规律?
答案:中间点可能仍处于较高学习率,未经历适合短预算的衰减,损失不是短预算能达到的最低值。应分别校准训练长度和调度,否则实验把优化不足与规模效应混在一起。
3. 20 token/参数能否决定一个服务海量请求的模型应该训练多久?
答案:不能。该近似针对特定分布下的一次训练成本最优。海量推理需要把每次服务成本、延迟和显存加入目标,训练更久的小模型可能更划算。还应考虑数据重复、质量和实际硬件,而不是只用一个比例。