091|Test-Time Scaling:不是一律多想,而是决定把计算花在哪里
论文:Charlie Snell、Jaehoon Lee、Kelvin Xu、Aviral Kumar,Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters,2024。采用原文 v1。主要模型为 PaLM 2-S*,并非公开权重的完整可复现实验;下文不把图上的估计值写成未经报告的精确成绩。
图表来源:Charlie Snell、Jaehoon Lee、Kelvin Xu、Aviral Kumar,2024,原文;CC BY 4.0。本篇展示做了PNG格式转换,图中数据与标签未改动。
先接住前作的问题
Self-Consistency把预算用于独立完整解答,ToT提前搜索部分解。本篇沿测试时多算的问题比较顺序修订与并行探索,追问同样生成数量怎样花更有效,以及选择策略本身是否也耗费预算。
五个前置概念
五个前置概念:proposal distribution决定候选从哪里来;PRM评估中间推理前缀;beam search按分数保留有限前缀;交叉验证把配置选择与效果测量分开;生命周期 FLOPs同时考虑一次训练和累计推理需求。
一、问题设定:相同生成预算怎样分给搜索、修订与不同难度题
生成器首先要有机会提出有用路径,选择器还要把它留下。若前者缺少核心方法,增加尝试可能只有更多错解;若后者有漏洞,搜索可能更快找到高分错误。本篇因此同时比较候选分布、选择方式和题目难度。
这里要分清 proposer 与 verifier。前者生成候选,后者评价候选;修订模型通过把历史答案放进输入来改变生成分布,搜索算法通过筛选和扩展来改变最终输出分布。测试时没有为每个问题重新训练所有权重,但前期专门训练了修订和验证能力。
题目难度也是相对模型定义的。人类标成难题,不代表某模型不会;人类觉得简单,也可能是模型的盲点。作者因此用该模型的成功概率分组,而不单靠 MATH 的人工难度等级。
二、定义前缀价值、修订分布和难度条件策略
PRM 预测的是后续成功,不只是本步逻辑对错
作者从解答中间前缀继续做 Monte Carlo rollout,以最终正确比例训练过程奖励模型。因而某一步的分数近似:
是当前推理前缀, 是生成器。它取决于生成器后续能力,不完全等于“这一步数学推理本身正确”的标签。使用其他模型产生的过程标签可能引入分布偏移。
基线 best-of-N weighted 生成多条完整解答,以最终步骤的 PRM 分数给整条解答评分,再把相同最终答案的分数相加:
这不同于单纯挑最高分的一条,也不同于一票一权的多数投票。最后一步评分优于最小值和分数乘积,是此处软 rollout 标签下的实验结论,不能复制成所有 PRM 的固定规则。
搜索选择继续哪些前缀
Beam search 在每层生成候选,保留高分前缀,再从保留项扩展。论文用 表示该轮候选预算、 表示每个保留项的扩展数,保留 项;不要套用其他代码库的 beam-width 命名后改变原算法。
Lookahead 在评分前再向前模拟若干步,用更晚的价值估计评价当前前缀。它可能看得更远,也消耗更多生成;本文不能作为所有 MCTS 变体的穷尽比较。
作者并非只加一句“请检查”。先每题采样 64 个答案,将正确答案与若干错误答案组成训练序列,优先使最后一个错误答案在字符编辑距离上接近正确答案。模型学习在错误历史条件下生成正确回答。
训练最多放入四个错误尝试;测试时可运行更长链,但仅保留最近四次回答。多条链还可以并行运行,最后用验证器或多数投票选答案。
这里存在分布变化:训练历史都是错误答案,测试历史可能已经正确。论文观察到朴素修订会把约 38% 的正确答案改错,因此“最后一版最好”不是可靠选择规则。候选保存和答案选择是完整方法的一部分。
令 表示搜索宽度、前瞻长度或顺序与并行比例,预算为 。理想目标是:
部署不知道真实答案,不能直接计算这个最优值。论文用五个难度分组近似,对每个组选择较好的配置。Oracle 难度来自 2048 次采样的真实正确率;predicted 难度来自同样规模采样的验证器平均分。
两者都要花计算,后者只是去掉真实答案依赖,没有去掉费用。原文 §3.2 与附录 C 明确未计这部分成本,并用分组内两折交叉验证减少“同一数据既挑配置又测配置”的偏差。这不等于已证明难度是严格统计意义上的充分统计量。
自适应方法多了一个分类器,它错到什么程度还值得用?
理想难度已知时,每组挑最优策略自然不会差于固定同一策略;难点是实际路由错误与路由成本。下面用可核算例子拆开这两项,而不把论文的理想分组当作免费的部署能力。
原创教学例。 问题各有一半属于甲、乙两类。在同一生成预算下,修订对甲、乙的成功率分别为0.9、0.3,搜索分别为0.7、0.6。全部修订的平均为0.6,全部搜索为0.65;完美路由给甲修订、给乙搜索,平均为0.75。如果两类的分类正确率同为 ,且错分就选相反策略,平均成功率为
因此只在 时超过固定搜索的0.65。 时为0.70,而非理想0.75。这里假设分类误差在每类内不额外偏向更难的实例;现实中若错分集中在最难题,平均分类准确率还不足以推得这个收益。
以上仍没有扣难度估计费用。若总预算为 、估计难度花 ,真正供所选策略使用的是 ,必须重新测这个较小预算下的四个成功率,不能在原曲线上只减一个固定百分点。论文两折验证控制了选配置的部分乐观偏差,却没有自动解决 ;附录C明确留下了这一部署问题。
假设 16 次尝试预算。一道题模型总能列出正确方程,只在末尾加减出错,4 条路线各修订 4 次可能比 16 条从头解答更经济。另一道题必须想到特殊几何构造,反复修改同一错误方程可能没有帮助,独立探索更有价值。
前缀价值依赖的是哪个继续生成策略
同一前缀交给两个后续策略,一个有0.8概率完成,另一个只有0.2,其rollout标签就不同。PRM所估的是指定生成器继续时的成功机会,不是脱离策略的数学真理分数。若换生成模型、温度或修订方式,验证器分数是否仍可排序必须再测,不能沿用旧校准自动解释新搜索。
三、在预算中记录选择、前瞻与难度估计的成本
离线:训练生成器所需的修订能力与验证器
研究阶段:估计每题难度,分为五组
对每组和预算,在一折数据上选择搜索或修订配置
在另一折测效果,再交换两折

部署式流程(需额外实现廉价难度判断):
    输入问题与完整计算预算
    估计难度,并扣除该步骤的成本
    选择独立采样、搜索、修订或混合比例
    保留所有候选及验证分数
    按预定规则选答案,而非默认最后一条
    记录生成、验证、难度判断和延迟
后半段是面向实现的建议,不是论文已经验证的廉价端到端算法。研究目标、近似机制和未来可部署版本需要明确分层。
四、按难度、预算和生命周期FLOPs比较前沿
先在同一生成预算内读搜索与修订,再把2048次难度估计等成本加回;局部曲线节省不等于部署总费用节省。
| 项目 | 设置与预算 | 解释 |
|---|---|---|
| 数据与模型 | MATH 的 12K 训练、500 测试划分;PaLM 2-S* Codey | 以数学推理为对象,不能自动推广所有知识任务 |
| PRM 数据 | 每题 16 条解答;每步 16 次 rollout;按换行分步 | 软成功率标签,数据生成本身昂贵 |
| PRM 训练 | AdamW,学习率 、批量 128、dropout 0.05;保留 10% 问题验证 | 根据验证损失早停 |
| 修订训练 | 每题 64 候选;0–4 个错误历史;学习率 、批量 128 | 正确答案作为监督目标;训练步数与总 GPU 时数未明确列出 |
| 搜索 | 最大预算 256;最大扩展 40 轮;前瞻 1 或 3 步等 | 前瞻预算按 近似计,不是直接墙钟 |
| 难度与验证 | 每题 2048 候选估计难度;五组、两折验证 | 主要效率曲线不包含此难度估计成本 |
| 大模型对照 | 参数约大 14 倍,固定预训练 token 数,比较近似生命周期 FLOPs | 没有同时优化更大模型的数据与参数比例 |
设置依据 §3–7、附录 D–J。修订阶段使用适配其输出分布的 ORM;不能把搜索实验的 PRM 原封不动写成所有实验的统一验证器。作者没有报告覆盖所有配置的多随机种子置信区间,500 道题的分组结果也存在有限样本波动。
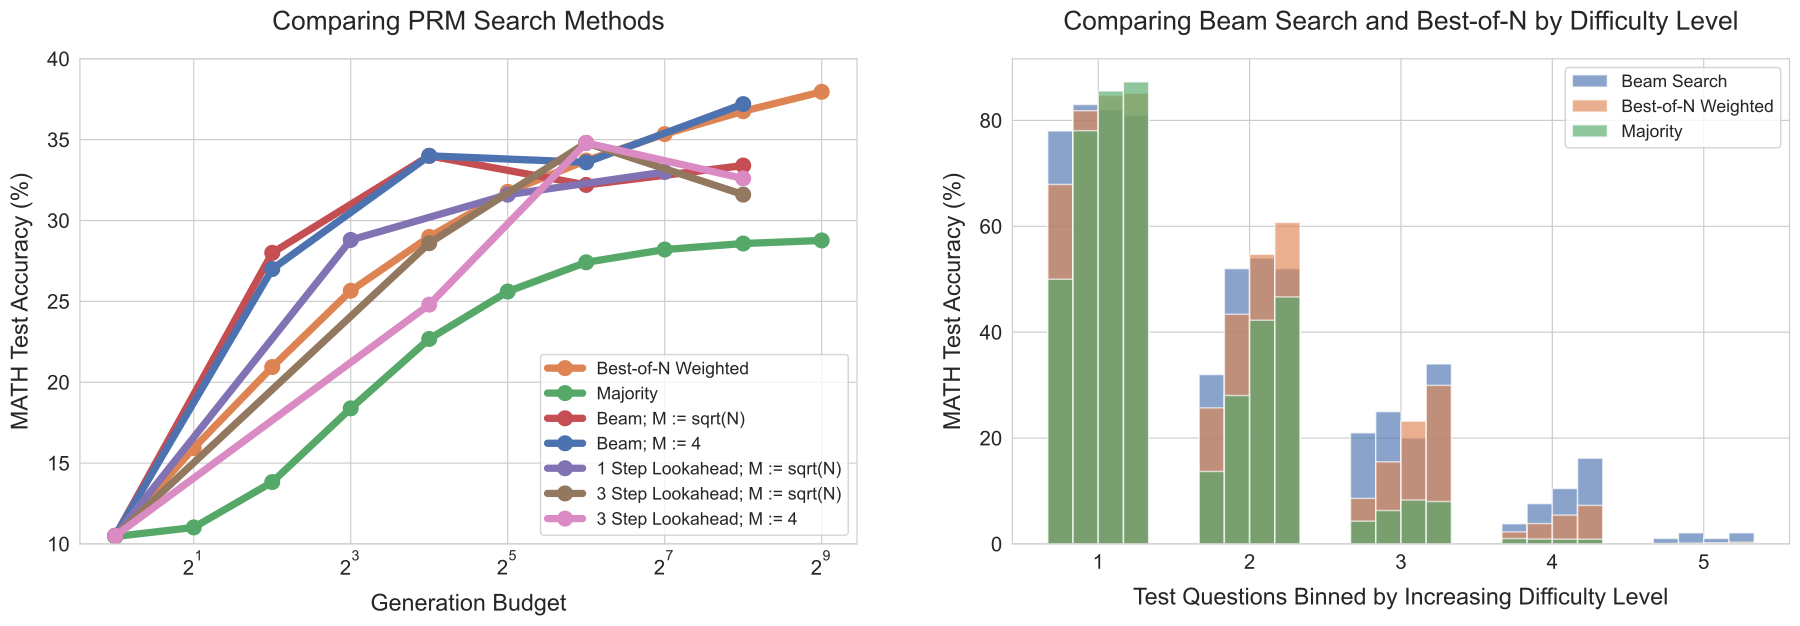
证据一:图3,最强搜索不一定最划算。 小预算时 beam search 优于 best-of-N,预算增大后优势缩小甚至反转;lookahead 在匹配生成预算下通常更差。简单组容易过度优化评分器,中等难度组更受益,最难组各方法进展有限。这支持因题选择算法,而非一律加深搜索。 难度分组柱状图内部又区分生成预算;oracle 难度使用正确标签,predicted 难度使用验证器估计。两者曲线接近不能抹去难度估计本身的费用。
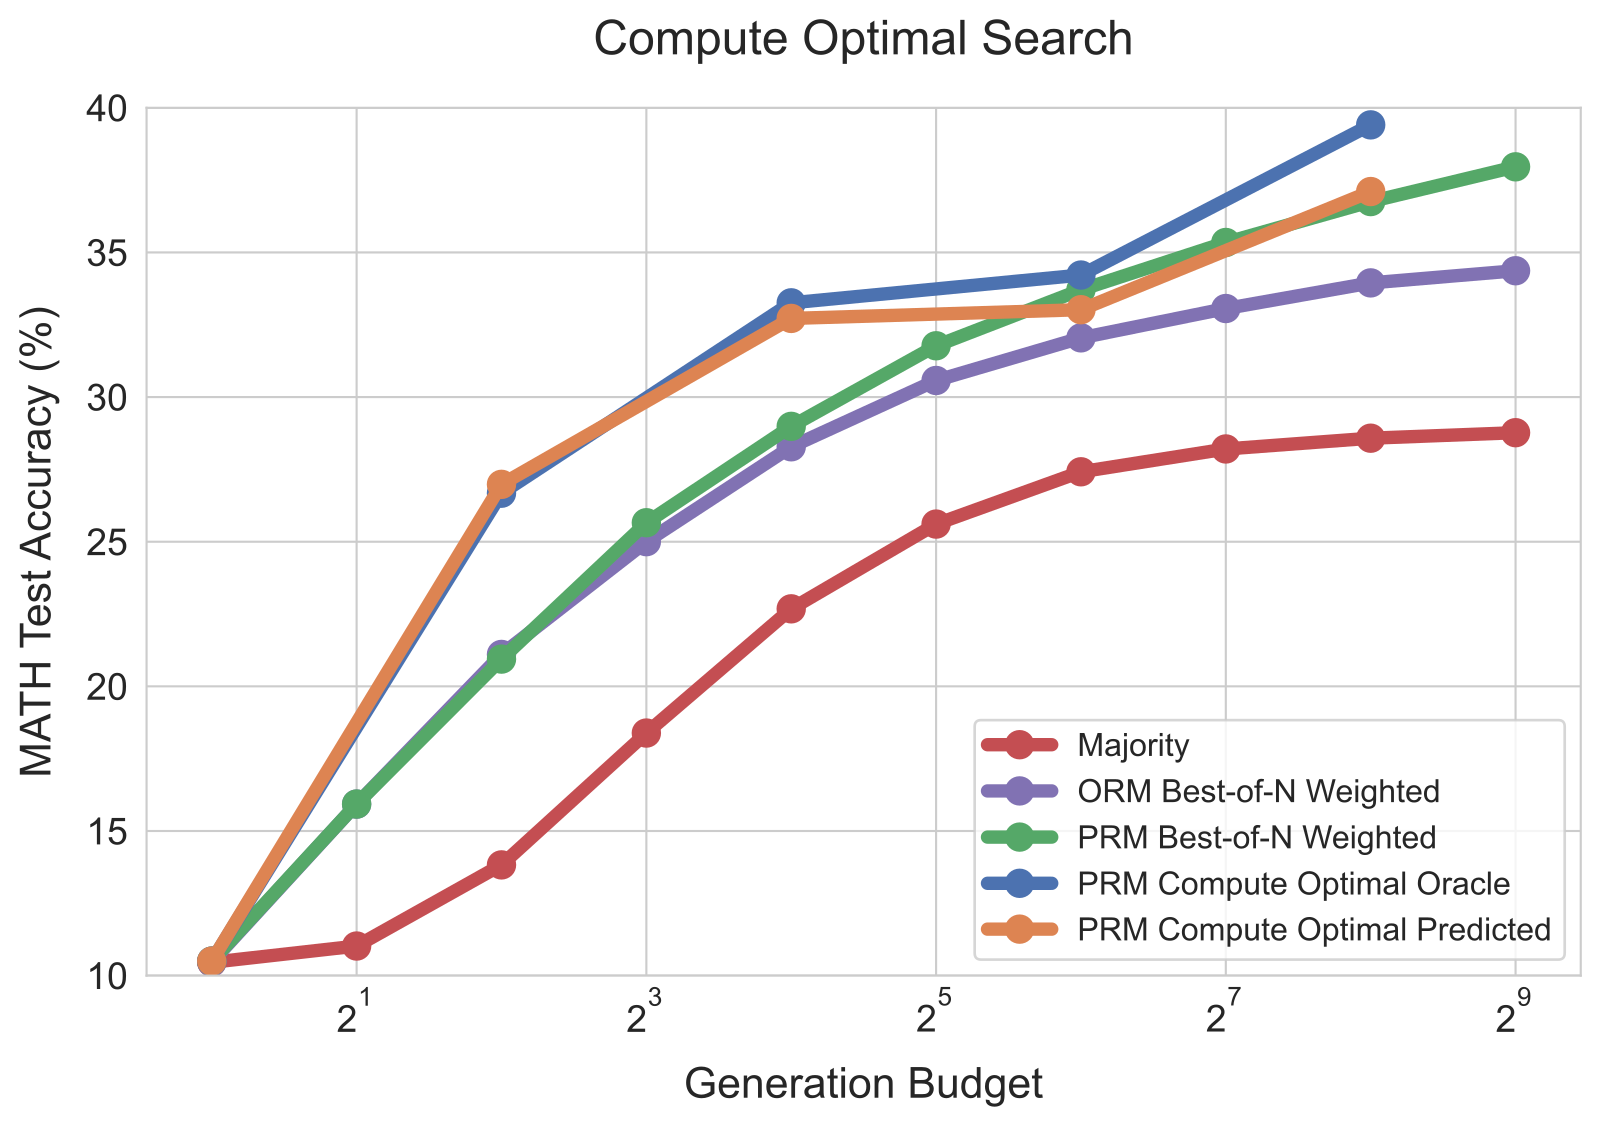
证据二:图4,难度分配可以提高局部预算效率。 在部分比较点,约 16 次生成的自适应策略接近或超过 64 次 best-of-N 的水平。准确表述是给定所用难度估计与预算口径下的曲线结果;若再加 2048 次难度采样,就不是完整流程节省四倍。
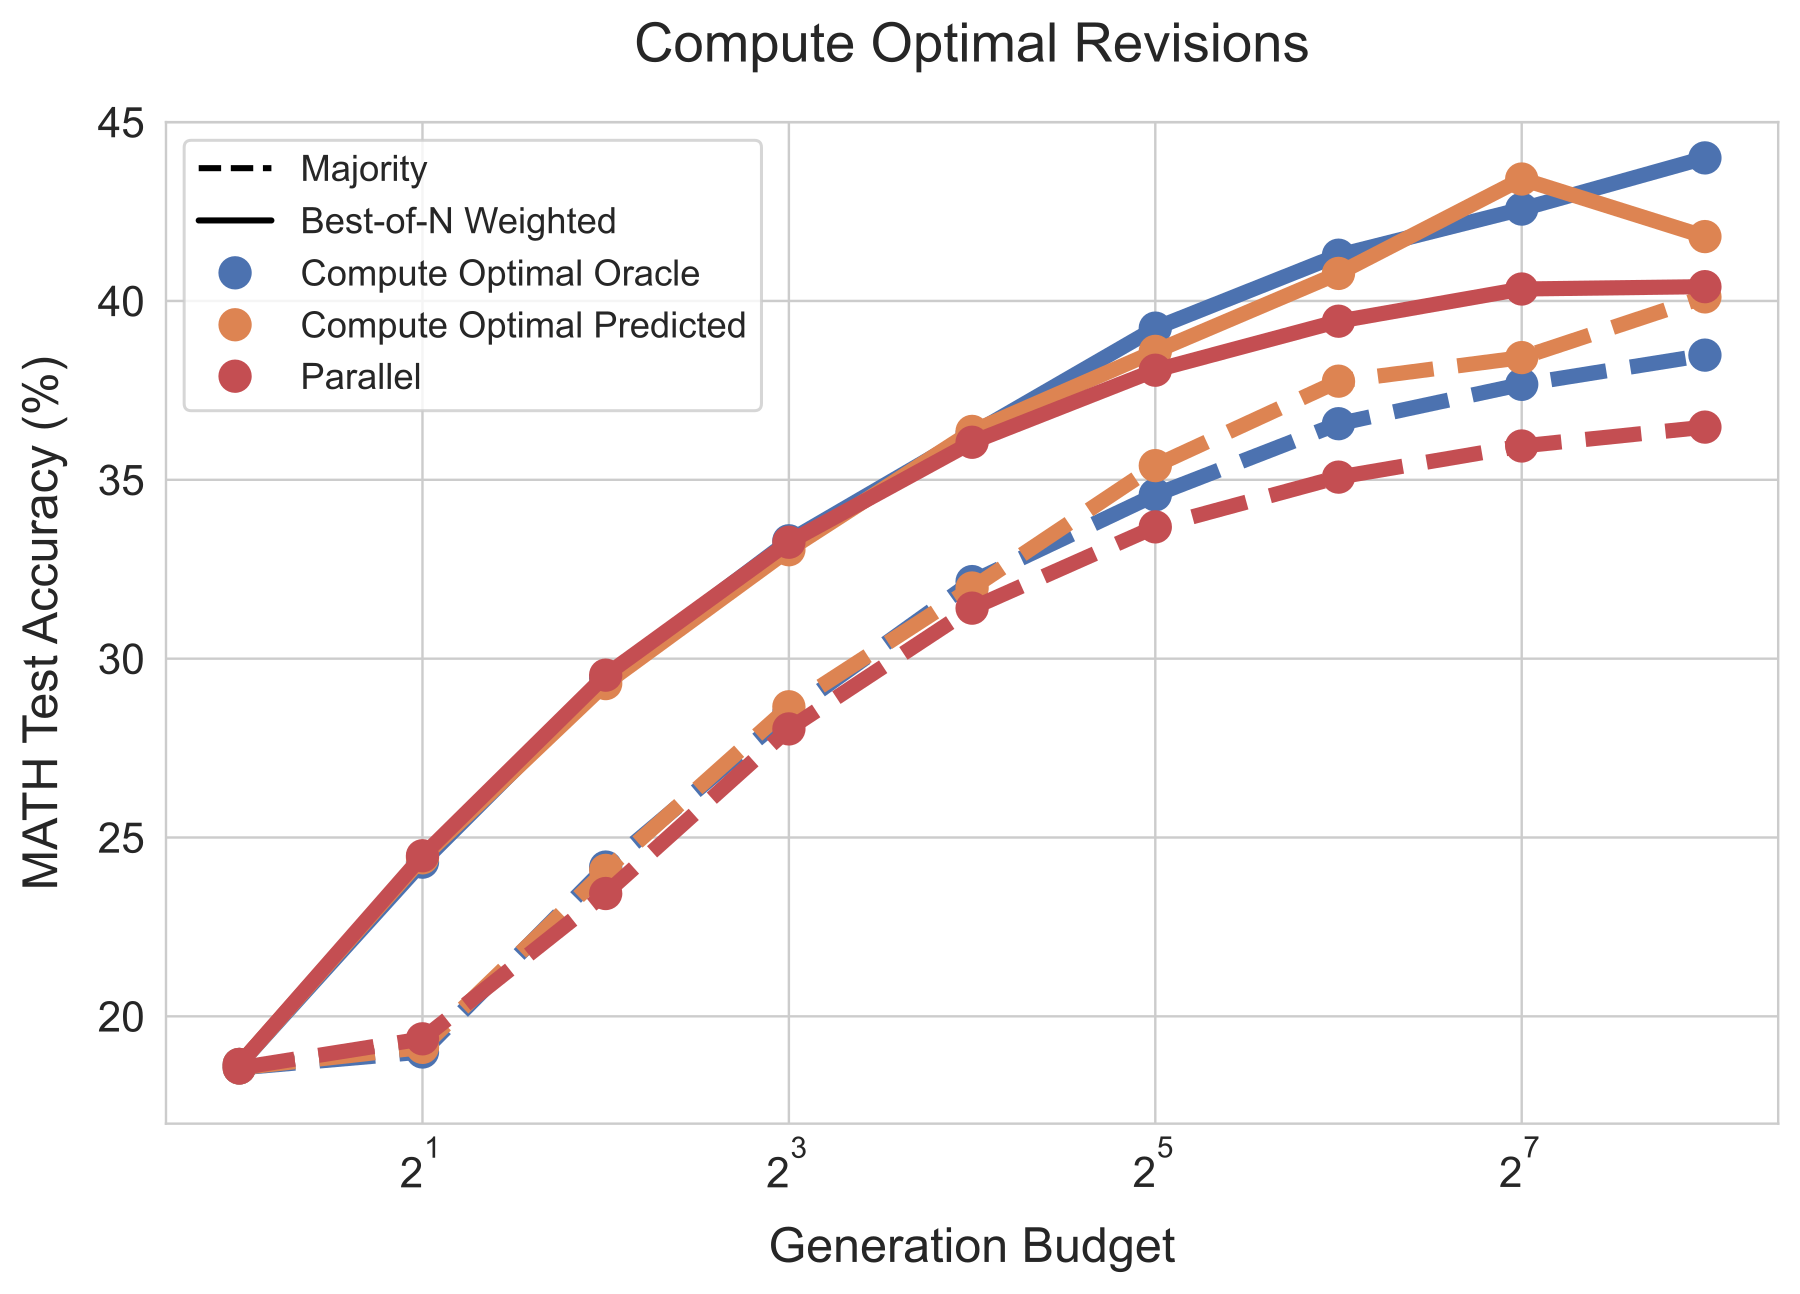
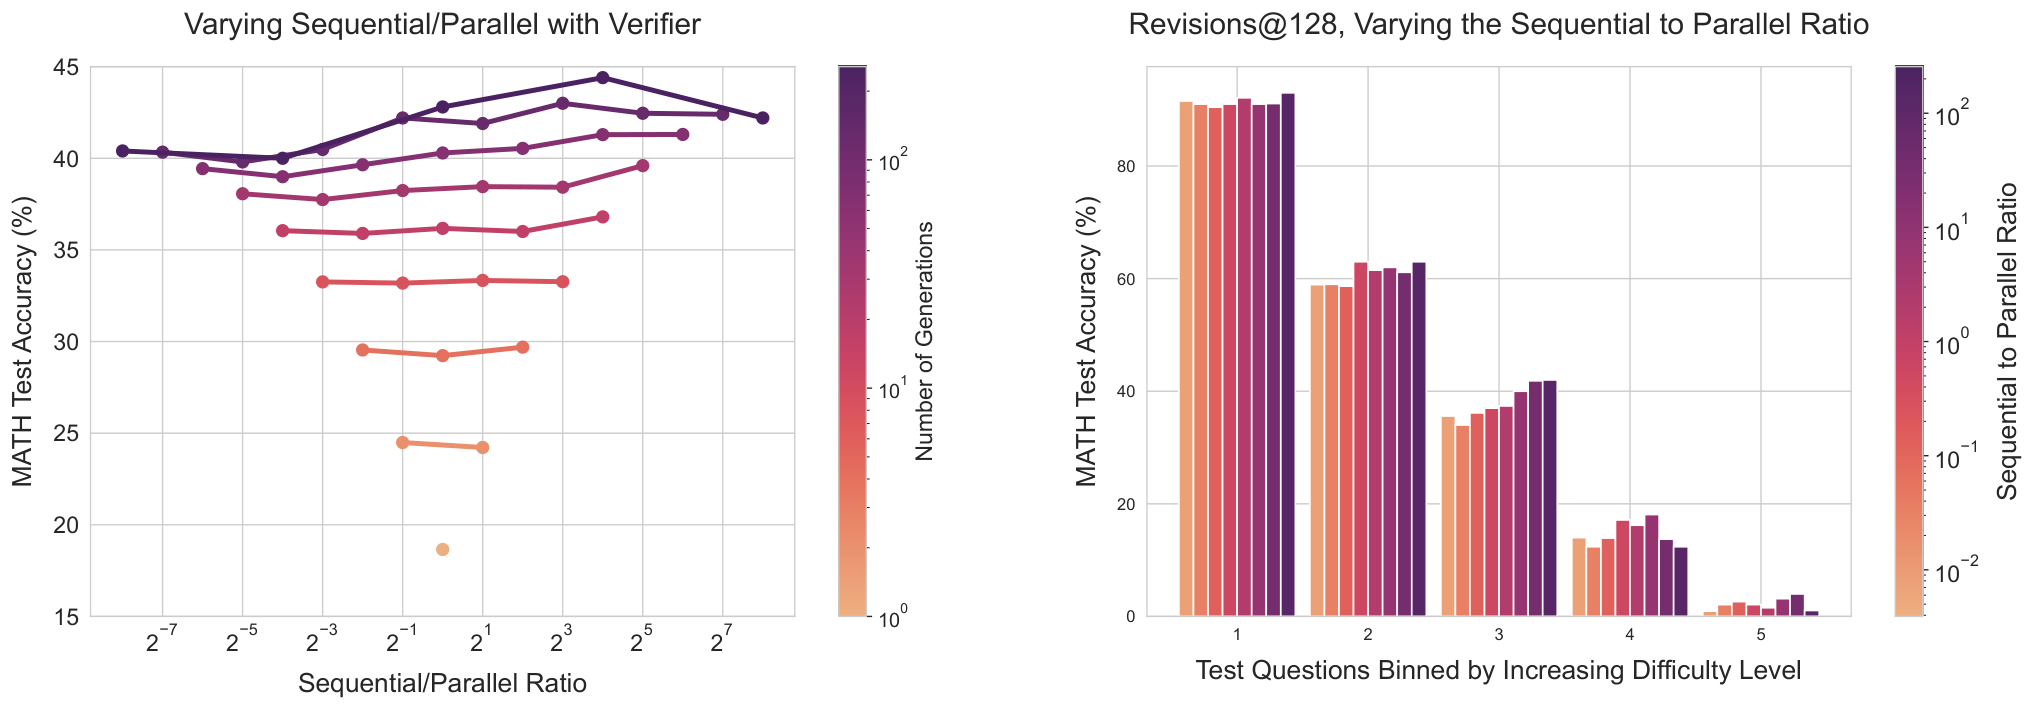
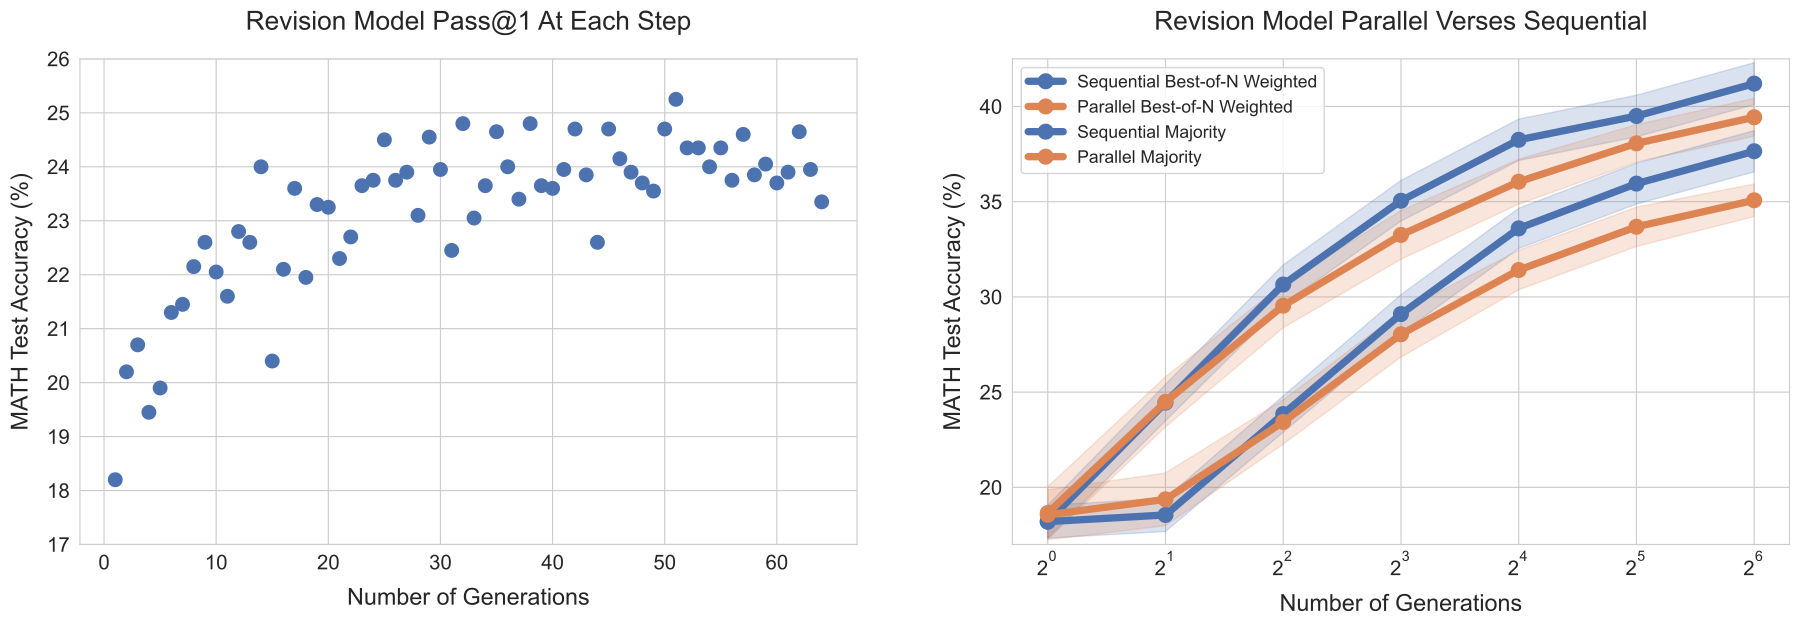
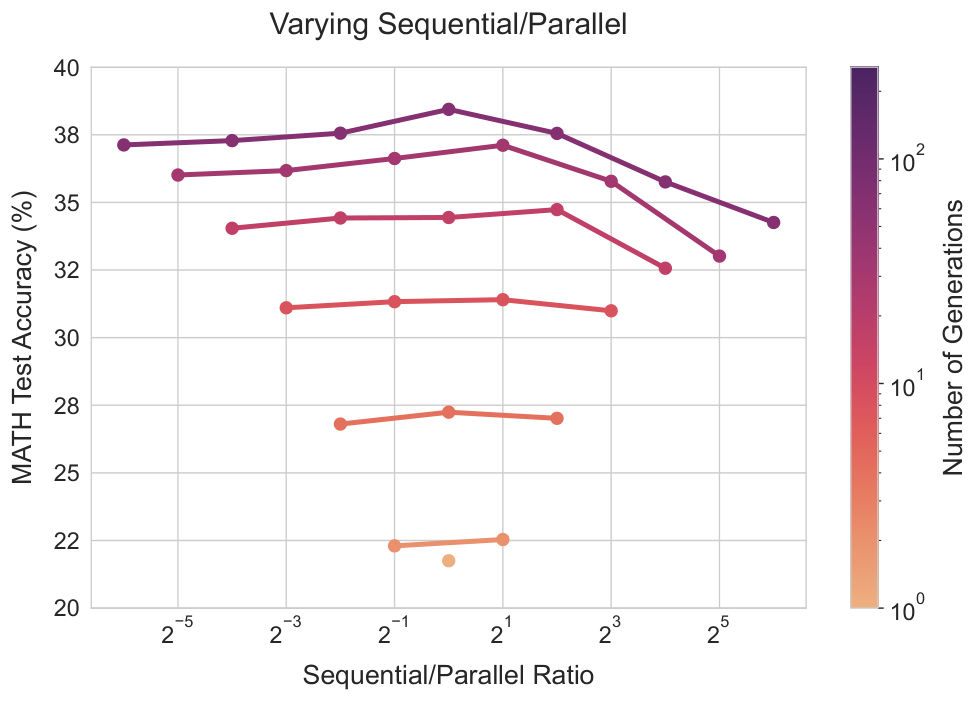
证据三:图6、图7、图8,顺序与并行互补。 单条修订链的逐步成功率能提高,但过度坚持一条路线不总是最好。高预算和较难题存在更合适的混合比例;图8 给出 64 对 256 次生成的效率例子。验证器或投票选择不可省略,因为修订也会破坏正确答案。
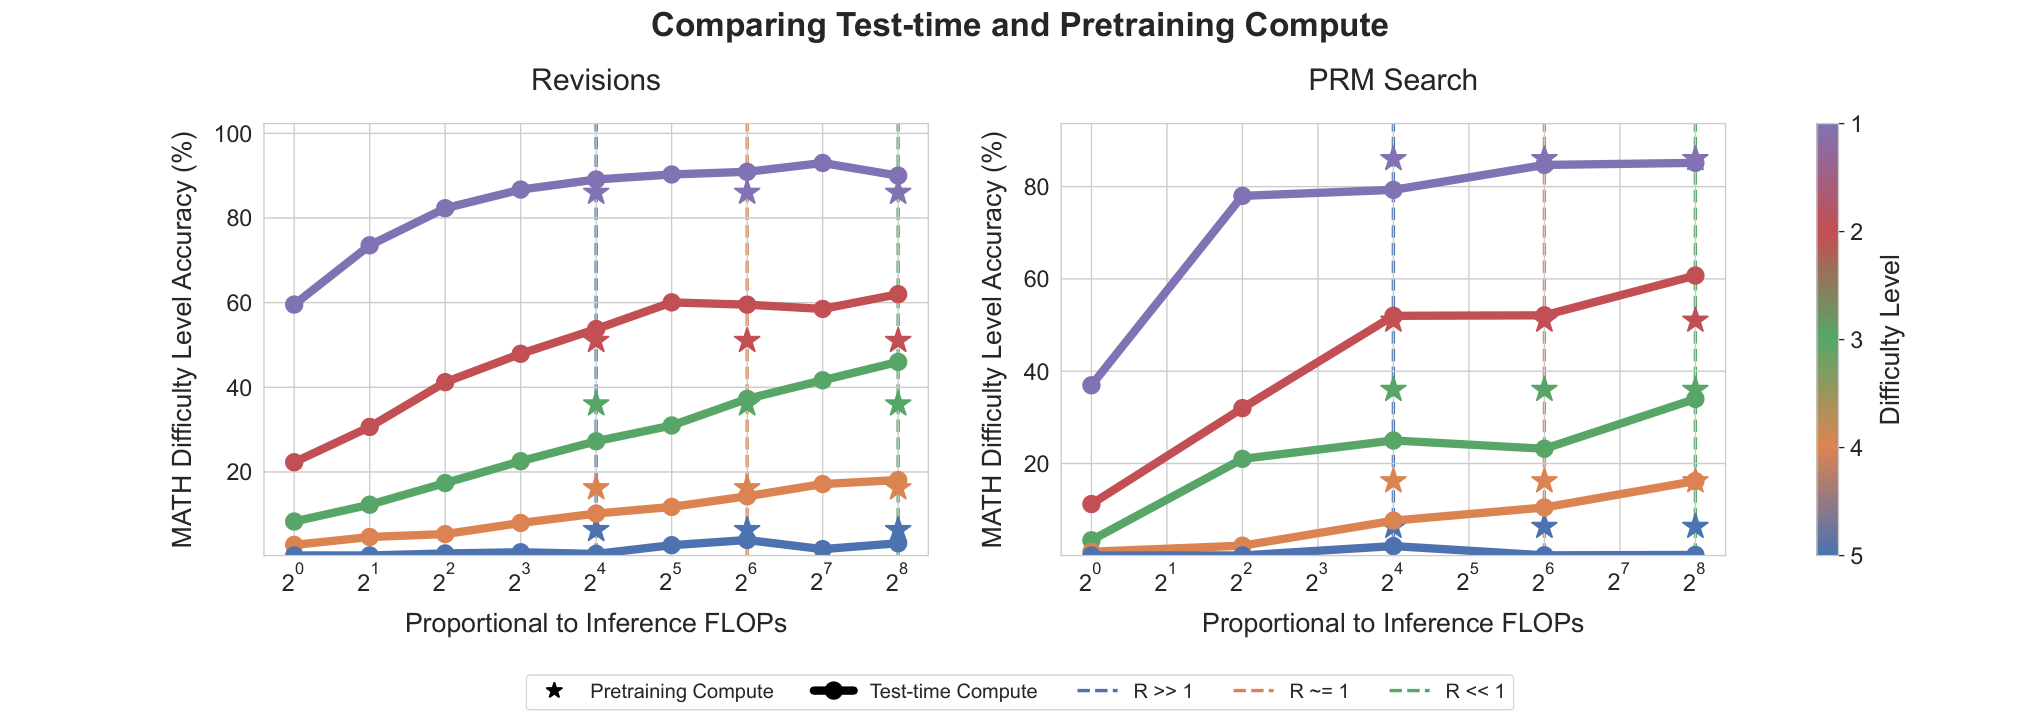
证据四:图9,大模型与多次推理的交换依赖工作负载。 论文分别分析推理与预训练 token 比例 。简单题或较少推理需求下,小模型加推理更有吸引力;很难的题或很大的推理负载下,增加模型规模更有利。标题中的“can”是条件判断,不是取代预训练的普遍定律。
证据五:附录 K、图16,更多自训练也可能损害修订。 使用 ReST-EM 式数据再训练后,增加顺序修订反而显著变差。作者推测数据中的伪相关被强化。这个反例说明生成训练数据、验证和修订能力之间存在闭环偏差,不能用“自我改进”一词跳过验证。
五、理想难度分组与验证器误差仍限制部署收益
但系统不知道属于哪种题。若为了判断先生成 200 次,就已经超出预算。这个例子显示调度器本身也是算法,必须计算自己的代价。
用 表示参数数, 表示预训练 token, 表示推理 token,论文近似总 FLOPs 为:
若大模型参数为小模型的 倍,要给小模型等量总 FLOPs,可把其推理预算乘以:
当推理请求很少,省下的预训练可摊到每题的大量搜索;当请求极多,这种每题额外预算就缩小。公式未完整覆盖注意力长度效应、服务系统效率、串行延迟和难度估计;它是比较尺度,不是发票。
本文真正的新意是系统分析预算分配和问题难度,而非首次提出采样、beam search 或修订。其主要限制是特定模型、数学数据和不完整端到端成本。过程评分过度优化可生成重复低信息步骤,或极短但高分答案,说明奖励投机也会发生在冻结模型的推理搜索中。
六、将预算选择具体化为停止干预和可执行控制器
s1把停止干预缩成可检查实验,AutoTTS搜索分支与停止控制程序。它们提供不同后续方向;本篇昂贵难度估计并不是这些系统已经免费获得的能力。
自测:能否把论文标题讲完整
1. 为什么 predicted difficulty 不需要正确答案,却仍然不能算免费部署?
它通过验证器给大量采样评分估计难度,避免使用真实标签,但论文仍用每题 2048 个样本。生成和评分都要付费,而主要效率曲线未计这部分。真实部署需要廉价预测、在线复用探索结果,或把完整开销加入预算重新比较。
2. 为什么更深搜索可能降低真实准确率?
验证器只是近似评分函数,搜索越强越可能找到高分但错误的输出。简单题已有较好候选时,继续追分可能偏向重复步骤或其他伪特征。增加预算的价值受生成器覆盖与验证器可靠性共同限制,不具有必然单调性。
3. 小模型加推理超过 14 倍大模型,是否说明可以停止扩大预训练?
不能。结果依赖题目难度、累计推理负载、固定预训练数据量和所计 FLOPs。最难题上小模型往往没有足够候选能力,大推理负载也削弱逐题搜索的成本优势。论文说明两类计算可以部分交换,并指出交换不是一比一和无条件成立。