072|Tree of Thoughts:让语言模型保留岔路,而不是一路写到底
论文:Shunyu Yao 等,Tree of Thoughts: Deliberate Problem Solving with Large Language Models,2023。论文、正文 v2、官方代码与提示。以下 ToT 指外部控制的搜索过程,不是仅在提示词里写一句“请使用思维树”。
图表来源:Shunyu Yao 等,2023,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
CoT沿一条过程继续,Self-Consistency等完整路径产生后再投票。本篇把选择提前到中间状态:若早期方向错误,能否通过比较候选、剪枝和回溯把预算转给其它路线?
五个前置概念
五个概念:搜索状态保存当前部分解;分支宽度限制同时保留的候选数;启发式估计状态是否值得继续而非保证正确;回溯撤销部分决策后探索替代路线;oracle选择借助真实答案挑选候选,通常只是能力上界而非部署策略。
一、问题设定:完整轨迹投票之外,怎样在错误前缀上提前止损
ToT使用固定预训练模型在推理时搜索,没有新增参数训练。模型提出和评价部分解,搜索控制器组织尝试;关键条件是任务能拆成可比较的中间状态,而不是仅在提示里要求“多想几种办法”。
论文有三种状态表示。24点的状态包含剩余数字与已执行算式,动作是再组合两个数字,成功要求每个输入恰好使用一次且结果为24。创意写作的状态包含计划或候选文章,目标是在四个段落末尾分别放入指定句子并保持连贯。填字游戏的状态是部分填好的网格,动作是填入一个符合线索的词,目标同时满足横向与纵向约束。
这种表示不是免费的。想法过小,就退回 token 搜索,评价难以判断意义;想法过大,一次错误会覆盖太多决策,失去局部修正机会。作者将“想法粒度、候选生成、状态评价、搜索策略”作为四个独立设计问题。
与 Self-Consistency 的主要区别在于选择位置:后者通常在完整答案间投票,ToT 可以在中间状态间选择。与 Reflexion 的区别是,ToT 显式保留和探索不同部分解,而 Reflexion 主要把一次尝试的反馈压缩成下一次尝试的记忆;实际系统可以组合这两种机制。
二、定义想法状态、启发式评价与宽深预算
设输入为 ,前 个想法为 ,状态为 。生成器 产生下一步候选;评价器 对状态的前景给分。宽度限制为 的层次搜索可写成:
是保留的前沿, 是追加想法。这里的 是模型提示产生的启发式评分,不是经过 Bellman 训练的价值函数,也没有可采纳启发式所需的误差保证。论文称其 BFS,但加入宽度裁剪后,不是遍历所有同层节点的完整广度优先搜索。
候选有两种生成方式:开放写作可以独立采样多个计划;24点这类受约束任务可以在一次上下文中顺序列出多个后续算式,减少重复。评价也有两类:逐项判断有希望与否,或者比较候选并投票。
搜索预算先由分支与剪枝决定
设搜索深度为 ,每个保留状态生成 个候选,束宽为 。在首层足够填满束且之后不提前终止的简化条件下,BFS 需要评价约 个新状态;这是状态数,不是 API 调用数,因为一次调用可以产生多个候选,每次评价也可能多次采样。生成器、评价器和最终答案的 token 都应计入预算。
束搜索只保存评价器眼下喜欢的状态。如果正确解的唯一前缀已经被裁掉,提高后续深度无法让它重新出现。因而增加 主要降低早期误剪风险,增加 主要扩展推演长度;两者不能互相替代。论文中的 BFS 与有阈值和回溯的 DFS 也应分别理解,不能把一个搜索器的成功率直接归功于所有“树搜索”。
自构剪枝反例。 第一层生成 A、B、C 三个思路,评估分数为 0.9、0.8、0.4;A、B 实际都无法完成,C 才能解题。束宽 永远丢掉 C,哪怕之后给剩余分支一百步。把束宽改为 3 可以保留 C,但生成和评价的成本也增加。若 ,上述预算式在 时给出 21 个状态,在 时给出 30 个状态。它是教学计数,不是论文测得的调用量;真实复现还须记录候选是否去重、无效状态是否重试,以及评价采样数。
自构例子,未运行: 用3、3、8、8凑24,解之一是 。如果评价器用“先算出分数不太合理”这样的经验剪枝,就可能删除正确路线。保留更多分支只有在这条路线仍有机会存活时才有效;将分数运算规则交给确定性的检查器,可能比单纯增加自然语言评价次数更有价值。
把状态数量再展开为评价预算
若当前保留2个状态,各提出3个候选,共产生6个新状态;若每个状态用5次采样自评,就有30次评价采样,还未算候选生成与最后作答。将“束宽2”报告成“两次推理”会严重漏账。一次API批量返回多个候选也不抹掉其输出token成本。
教法联系:Lilian Weng的LLM Powered Autonomous Agents。算例为本文自构。
三、用搜索控制器生成、剪枝和回溯部分解
输入:任务 x、生成器 G、评价器 V、最大深度 T、宽度 b
frontier = [initial_state(x)]
for depth in 1..T:
    candidates = []
    for state in frontier:
        candidates += expand(state, G(state))
    if candidates is empty:
        return failure_under_budget
    scores = evaluate_with_optional_repeated_votes(V, candidates)
    frontier = retain_top_b(candidates, scores)
return render_and_select_final_answer(frontier)
这是教学版层次搜索。填字实验改用深度优先:先探索最有希望的词,遇到后续线索不可满足时剪枝并回溯。真正执行时,还必须保留总调用与 token 预算;深度不大也可能产生很多候选评价。
论文没有新的可微损失函数。它优化的是推理过程中的候选选择,实测目标是解题正确率或文本连贯性。为什么可能有效?中间检查可以阻止把所有预算消耗在明显错误的前缀上;但若评价器误判,剪枝同样会阻止找到正确答案。这是经验支持的机制,不是最优性证明。
四、按任务成功口径与调用预算解释搜索收益
先看错误发生在哪层,再比较宽度与完整轨迹oracle;更多状态、更多调用和更多token是三个不同预算。
| 项目 | 设置与验证目的 |
|---|---|
| 模型 | 主实验为2023年5月5—16日期间的 GPT-4 Chat Completion,通常温度0.7;不应默认等同于后来的同名服务 |
| 24点数据 | 1362题中按人类解题时间排序的第901—1000题,共100道较难题 |
| 24点预算 | 3步想法;ToT保留1或5个状态;每候选评价采样3次;CoT、直接回答各采样100次形成比较 |
| 写作 | 100组输入,各含4句指定段末句;每阶段5个候选和5次投票;自动连贯性评分与人类盲评 |
| 填字 | 156个5×5游戏中间隔选择20个测试、另5个作提示;最多100个 DFS 搜索步骤 |
| 填字指标 | 字母、词和整盘正确率分别计算;整盘率不能由字母率替代 |
| 人类评价 | 部分作者进行100对文章的随机顺序盲评;不是独立的大规模普通读者调查 |
| 成本 | 附录B.3记录历史 API token 与费用;并非当前价格,且节点数、token数和墙钟时间不等价 |
| 泛化 | 附录B包含100道 GSM8K 测试题和100道 StrategyQA 开发题的补充实验,以及 GPT-3.5 替换 |
24点可以用程序检查最终等式,因此最佳样本 oracle 是可构造的。写作没有唯一答案,评价更依赖偏好与评分器。用同一个“成功”概念描述这两者,会遮蔽证据强度的差别。
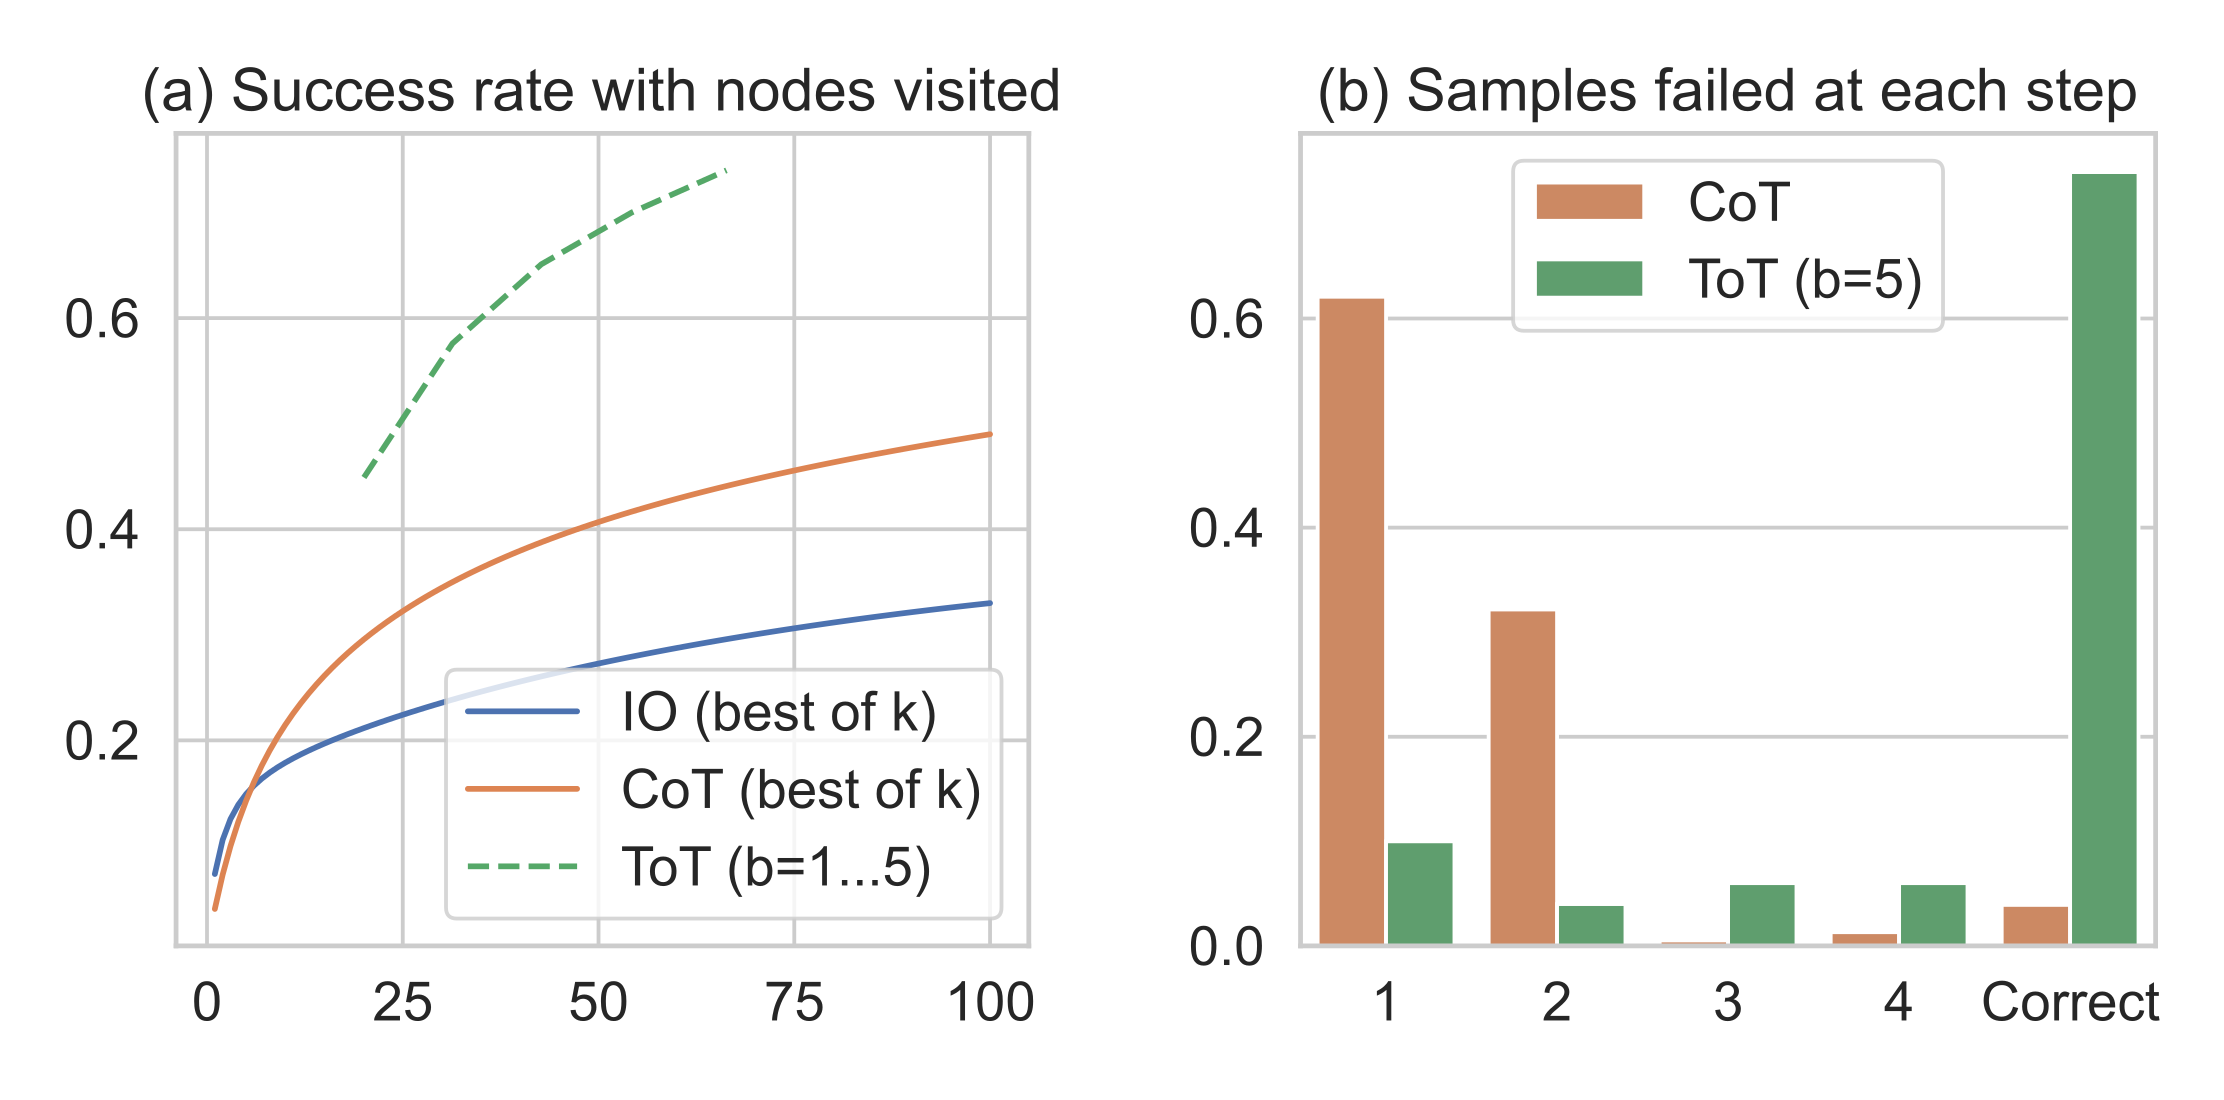
证据一:表2,24点。 ToT 宽度1为45%,宽度5为74%;CoT-SC 的100样本多数选择为9%,正确性 oracle 从100条 CoT 中挑选为49%。它支持中间搜索优于这组完整轨迹采样方案,同时说明答案多数票与“至少出现过正确解”相差很大。74%是100道题上的系统结果,不是统计上精确的总体成功概率。
证据二:图3,失败位置。 作者观察到约60%的 CoT 轨迹第一步之后已经不能完成任务。这个分析解释了为什么前缀选择值得改进;它没有证明所有推理任务都在第一步损失最多,也没有把错误都归因于解码算法,模型的候选质量同样参与。 24点图同时检查搜索规模和错误类别;创作图采用不同质量评价。增加搜索的效果不能跨两种任务用同一个“正确率”解释。
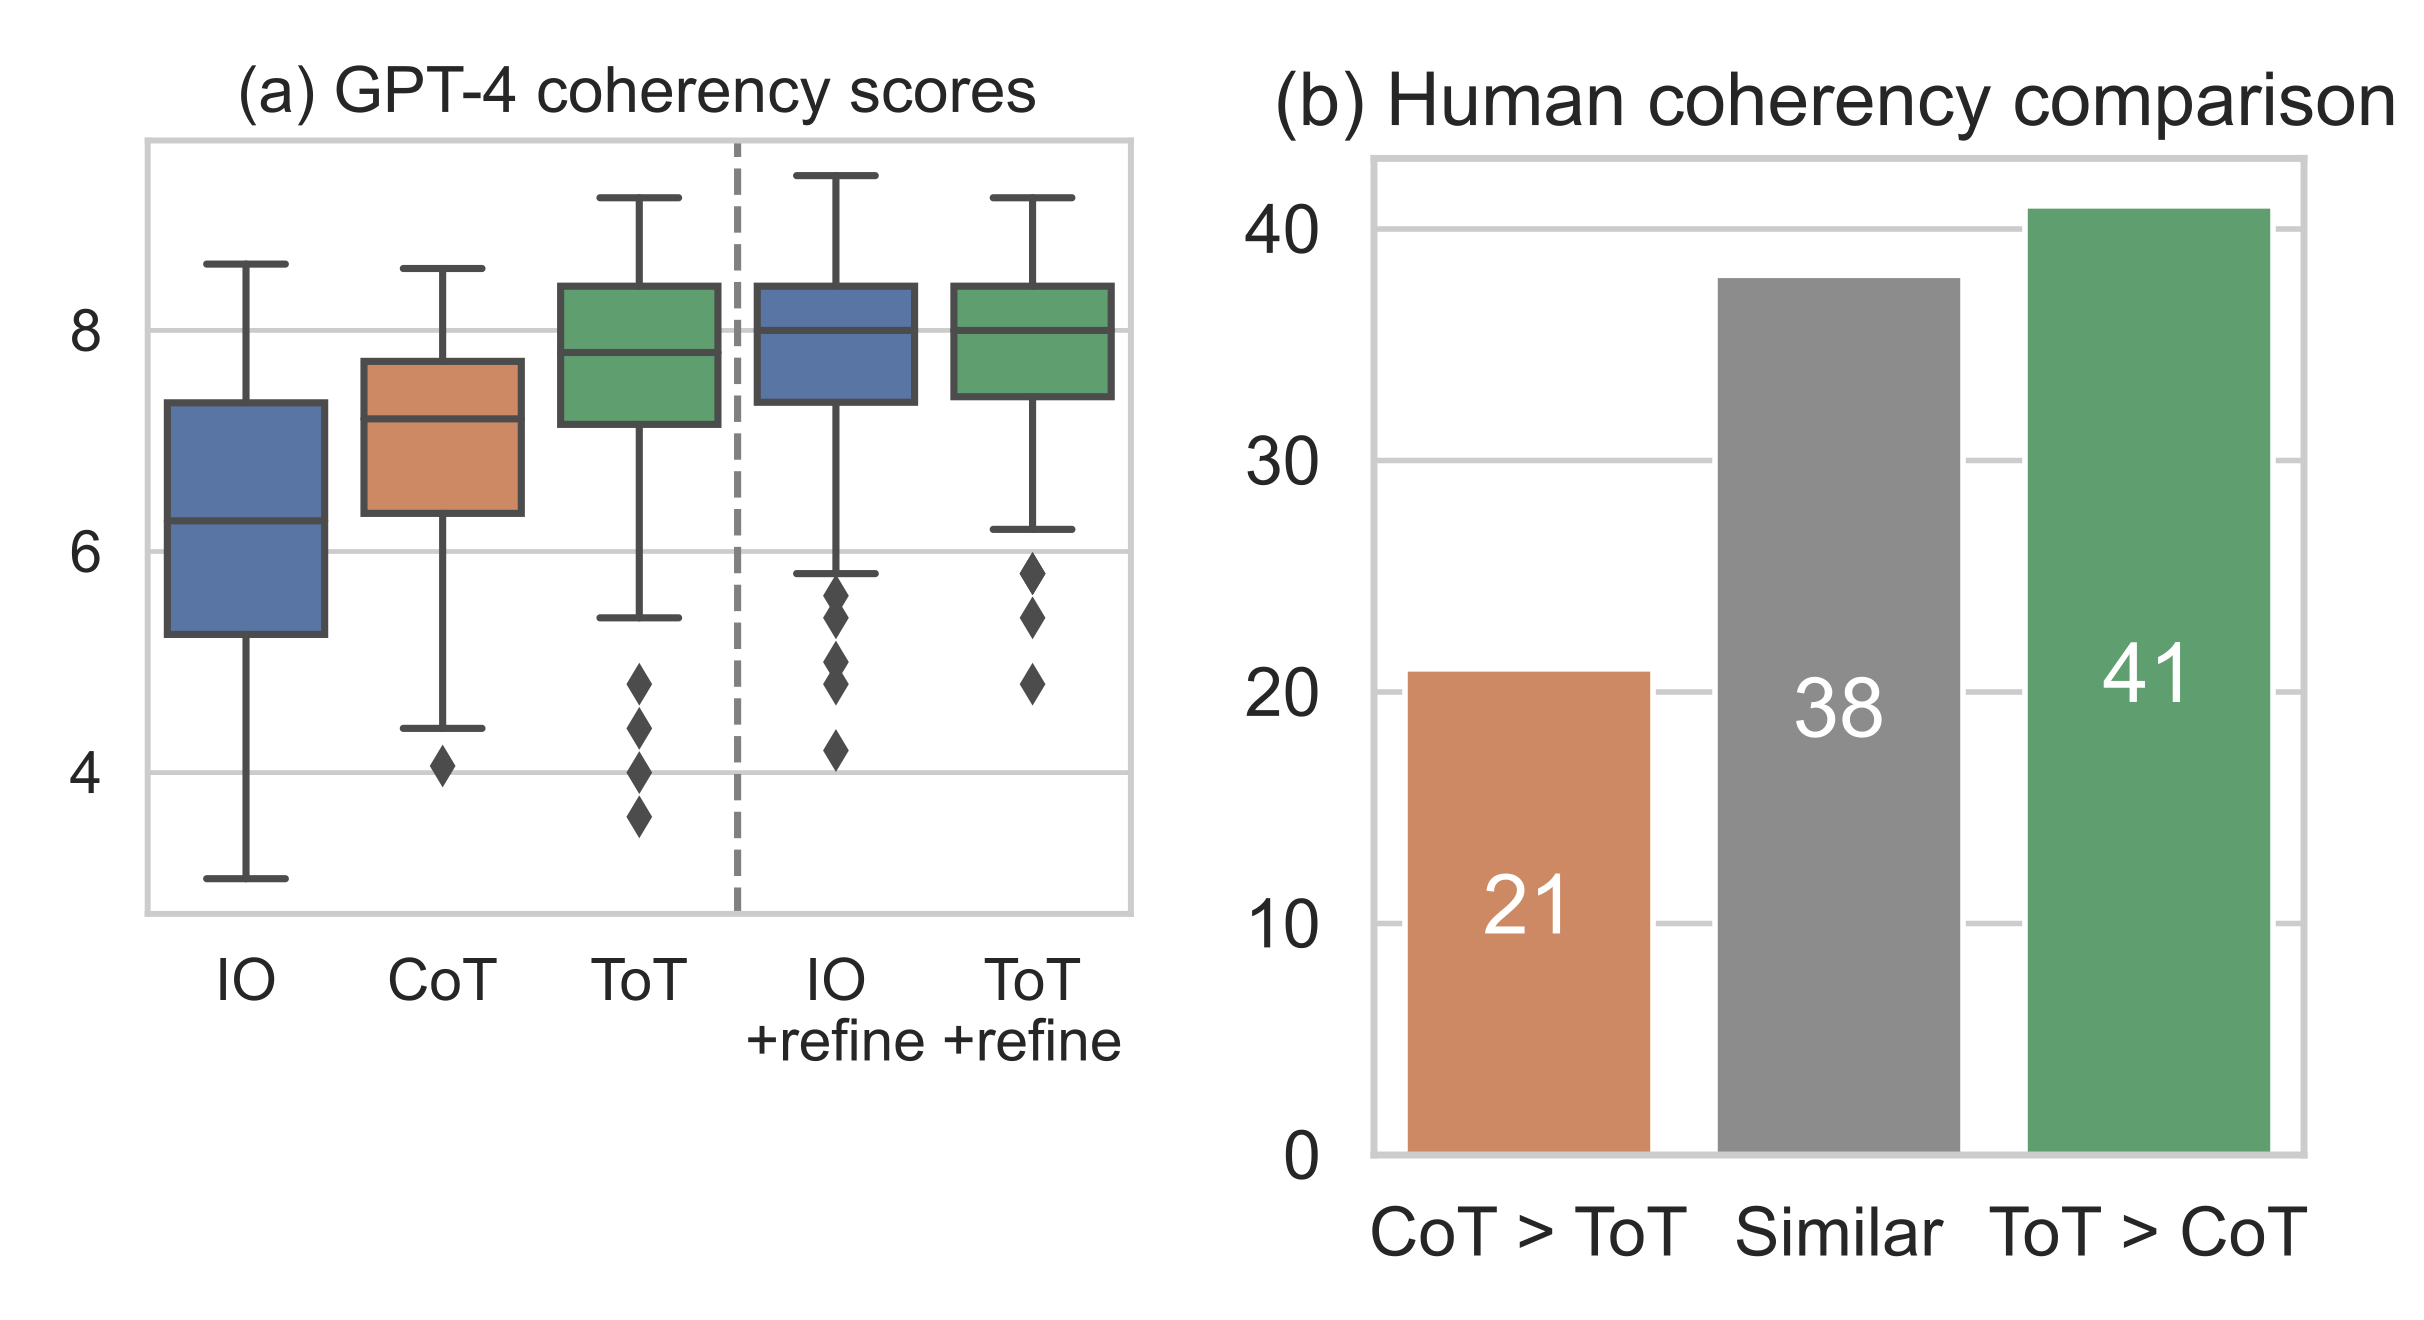
证据三:图5,写作与自修正。 自动评分 ToT 为7.56,CoT 为6.93,直接回答6.19;人工比较41对偏好 ToT,21对偏好 CoT,38对相近。直接回答加迭代修正达到7.67,高于不加修正的 ToT;ToT 加修正为7.91。因此更准确的结论是多种推理程序可以互补,不能说树搜索在所有比较中最好。
证据四:表3,填字搜索与答案选择。 ToT 词正确率60%、整盘20%,即4/20;oracle 选择已访问过的最佳状态可达到35%,即7/20。省去剪枝或回溯时整盘率均为5%,但这些消融并非完全相同的轨迹和控制流程。正文还记录正确生僻词被误判后剪去:搜索曾经找到正确状态,不等于最终系统能够认出并输出它。
证据五:附录B,能力与预算边界。 GSM8K 的 CoT/ToT 为86/90,StrategyQA 为82/83,增益远小于24点。24点中 GPT-4 生成、GPT-3.5 评价为64%;反过来为31%,提示这组实验的候选生成是重要瓶颈。表7记录 ToT 历史费用每题0.74美元,对比 CoT best-of-100 的0.47美元,准确率比较并非同费用实验。
费用表中的汇总 token 与费用不宜重新套用今日单价反算;其统计口径并未足够细化为统一部署成本模型。可以采用它们作为“搜索额外消耗显著”的原文记录,但若要估算自己的任务,需要重新测量每次输入、输出、缓存和串行等待。
五、错误剪枝和不可撤销行动限制迁移
经典 BFS、DFS 本身不是新发明;创新集中在想法粒度、语言自评和模块组合,并用可控任务展示效果。
作者承认任务范围较窄、额外推理成本较高,已有模型擅长的简单题可能不值得搜索。进一步分析还包括:相同模型的生成和评价可能共享偏差;知识缺失不能单靠增加分支补足;高分不一定是高正确率;候选越多,越有可能出现迎合评价器的错误答案。
在真实交互任务中,回溯也不一定可行。删除一个文本分支很容易,撤销一个已经作用到外部环境的动作却可能需要额外机制。因此要先区分“在纸上搜索方案”和“执行动作后回退环境”,不能把论文的纯推理实验直接等同于机器人行动可靠性。
六、让搜索选择与题目难度、剩余预算一起决策
搜索是否值得,还取决于题目难度与预算。推理时计算继续比较搜索、修订和独立采样;在真实不可撤销环境中,先确认“回溯”是否真的可执行。
自测与答案
1. 在提示词中写“请提出三个想法并选最好的”,是否就实现了论文的 ToT?
答案:它可以是很浅的特例,但不自动具有显式状态、逐层扩展、预算控制和回溯。论文的核心是可执行的搜索过程;必须看控制器实际保存了哪些候选、何时评价、怎样继续,不能只看输出是否画成树形。
2. 为什么 best-of-100 与100次多数投票的24点成绩差这么多?
答案:best-of-100 利用正确性检查,只需100个答案中有一个正确;多数投票要求正确答案出现得足够集中。不同正确等式还可能分散票数。前者衡量生成覆盖加理想选择,后者衡量实际聚合规则,不能当作同一指标。
3. 如果增加搜索宽度没有改善,该优先检查什么?
答案:检查生成器是否产生正确方向、评价器是否误剪正确前缀,以及最终选择器是否丢掉已经找到的解。可以记录 oracle 候选覆盖率、剪枝后的覆盖率与最终准确率逐级定位,再比较同 token 预算的独立采样。只有这样才能知道问题出在探索不足还是选择失真。