056 · 自一致性:对多条推导的最终答案投票
返回目录 · 上一篇:STaR · 下一篇:Chinchilla
论文:Xuezhi Wang等,Self-Consistency Improves Chain of Thought Reasoning in Language Models,2022年公开,ICLR 2023。原始论文 · v4全文。
图表来源:Xuezhi Wang等,2022,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
CoT通常只生成一条推导,其局部贪心选择可能忽略分散在其它路径的答案质量。本篇直接承接这一缺口,用同模型多路径采样聚合答案;它既不训练GSM8K式裁判,也不执行STaR权重更新。
五个前置概念
五个前置概念:蒙特卡洛估计用样本近似分布统计量;边缘化汇总不关心的中间变量;温度采样改变概率集中程度;众数是概率或票数最高的取值;校准研究置信度是否对应真实正确率。
一、问题设定:概率分散在不同推导时,怎样按最终答案汇总
一条完整推导的概率与一个答案的总概率不是同一对象。正确答案可能由多种表达和计算路径支持;本篇保持模型与提示不变,尝试汇总这些路径,而不是让多个独立训练模型讨论。
设问题为,推导为,答案为。希望比较的答案概率是
这里对推导求和体现“不同过程可以支持同一结论”。实际无法枚举所有推导,作者从解码分布抽取条,选择
这通常称为多数投票,但严格说是取票数最多的答案,不要求超过50%。数值答案可能有很多种,正确选项只要比每个错误选项更集中,就可能胜出。
如果采样采用温度或top-k,计票近似的是被这些操作改变后的采样分布,不是严格恢复原始模型未修改概率。这个细节不会否定经验收益,却提醒我们不要把有限采样加启发式解码描述为精确贝叶斯推断。
二、由答案边缘化推导投票及其相关性条件
投票收益依赖独立性与正确答案是否为众数
在简化的二分类、独立采样、每次正确概率p条件下,3票多数正确概率是 。只有p>1/2才高于p;完全相关的三次输出则仍只有p。真实多答案问题中更关键的是正确答案相对于每个错误答案的概率,而非是否超过一半。这些条件解释为何多样采样有时比重复贪心更有价值。
教学算例。 p=0.6时三票正确率为0.648;p=0.4时降到0.352。若正确答案占0.4,两个不同错误各占0.3,大样本众数仍可能选对;若把正确的“1/2”和“0.5”分开计票,则人为拆散正确质量。归并规则属于算法,必须在看测试结果前确定。
问题是“原有20颗糖,送出5颗,再买入3颗,剩多少”。五次采样给出18、18、15、18、23。三条正确路径可能分别先减后加、算净变化或列方程,计票选18。无需选出概率最大的那一句完整文字。
答案归并也需要预先固定等价关系
若四条候选写“0.5”“1/2”“0.50”“2”,直接按字符串计票会四项平票;按数值等价归并则前三项合成三票。反过来,带不同单位的“1”不应无条件合并。规范化器改变投票事件,必须在看测试答案前固定并记录解析失败,否则结果可被事后规则人为改善。
教法联系:Lilian Weng的Prompt Engineering。算例为本文自构。
三、采样、解析和归并后再选择答案
输入:冻结语言模型 M、思维链示例、问题 x、采样数 m
候选答案列表 A ← 空集
重复 m 次:
    从 M 随机生成一份推导与最终答案
    按任务规则解析最终答案
    规范化等价形式,加入 A
统计每种答案出现次数
返回出现次数最多的答案
若要展示解释,从获胜答案对应候选中另选一条并检查
最后一行是教学性输出处理建议,原论文核心评价针对最终答案,不保证展示的某条推导最可信。答案归并也必须预先定义:例如“0.5”和“1/2”是否等价,单位是否一致,选择题标签如何提取。作者按任务解析“The answer is”之后的数值或文本,而不是对任意长文都能直接投票。
这不是GSM8K验证器的同义词。验证器依靠额外训练模型对完整候选排序;自一致性只依赖候选答案频率。它也不同于STaR:STaR把筛选结果写回权重,自一致性只在当前测试题增加计算。
论文还比较按序列概率加权。未归一化概率是许多token概率的乘积,会显著受长度影响;长度归一化后近似几何平均,但那已不是完整序列概率。对已经按模型分布抽取的样本再次按概率加权,也会改变估计量。作者最终采用简单计票,是基于实验效果和实现便利,并非证明所有加权方案都没有价值。
四、比较采样数、加权方式与没有收益的任务
先用本论文自己的单路径基线,再对照聚合和搜索;相同候选条数并不自动等于相同token或时延。
| 项目 | 原文设置与检查内容 |
|---|---|
| 算术任务 | AddSub、MultiArith、ASDiv、AQuA、SVAMP、GSM8K |
| 常识与符号 | CommonsenseQA、StrategyQA、ARC、末字母拼接、硬币翻转 |
| 数据划分 | 可得标签时默认测试集;CommonsenseQA开发集,StrategyQA采用BIG-bench问题集 |
| 模型 | UL2 20B、LaMDA 137B、PaLM 540B,以及code-davinci-001/002端点;保留端点避免混淆模型版本 |
| 采样 | 主结果每次40条,重复十次;UL2/LaMDA温度0.5、top-k40,PaLM温度0.7、top-k40,API温度0.7 |
| 提示与训练 | 少量手写思维链示例;无微调、无额外奖励模型;AQuA具体示例以附录为准 |
| 资源 | 附录A.2报告TPU或API;约千题任务UL2/LaMDA多数1—4小时,PaLM多数2—12小时,部分更长 |
| 统计 | 主表自一致性为十次均值,标准差通常不超过0.5个百分点;不同采样数另画均值与标准差 |
API实验的最大生成长度为128token,不能把它的结果与不限长度的后续系统直接当作同预算比较。40条采样可并行降低墙钟延迟,但总生成量仍增加;同样的候选数也不意味着束搜索与独立采样的硬件时间严格相同。
证据一:表2的算术成绩。 PaLM GSM8K从56.5%到74.4%,增加17.9个百分点,相对提升约31.7%;code-davinci-002从60.1%到78.0%,也是17.9个百分点。本文应使用这篇论文自己的基线,不能直接减去上一篇思维链版本中的56.9%,因为评估设置和版本不完全相同。
证据二:表1的聚合消融。 PaLM GSM8K简单计票74.4±0.1,长度归一化加权和74.1,未归一化加权和59.9,归一化加权平均22.1。将同答案支持数量除掉会损失关键的集中性信息。这支持该组任务上的计票设计,不能推广为任意候选评分任务都应无条件忽略置信度。
证据三:表5修复思维链退化。 PaLM在RTE的标准提示为84.8%,单条思维链79.1%,自一致性86.3%;e-SNLI为85.8、81.0、88.4。它表明多路径聚合能够抵消部分单条推导错误,但并非每个任务都值得花40倍级别生成量。部署仍需准确率与成本共同决策。
证据四:图3与表6的搜索比较。 图3在相同采样数下优于按生成概率排序。表6中UL2的AQuA在40条随机路径计票下为26.9±0.5,而取束搜索最高序列为10.2,束内计票24.2±0.5。它支持候选多样性的价值;相同候选条数并未严格控制总token、共享前缀和硬件效率。
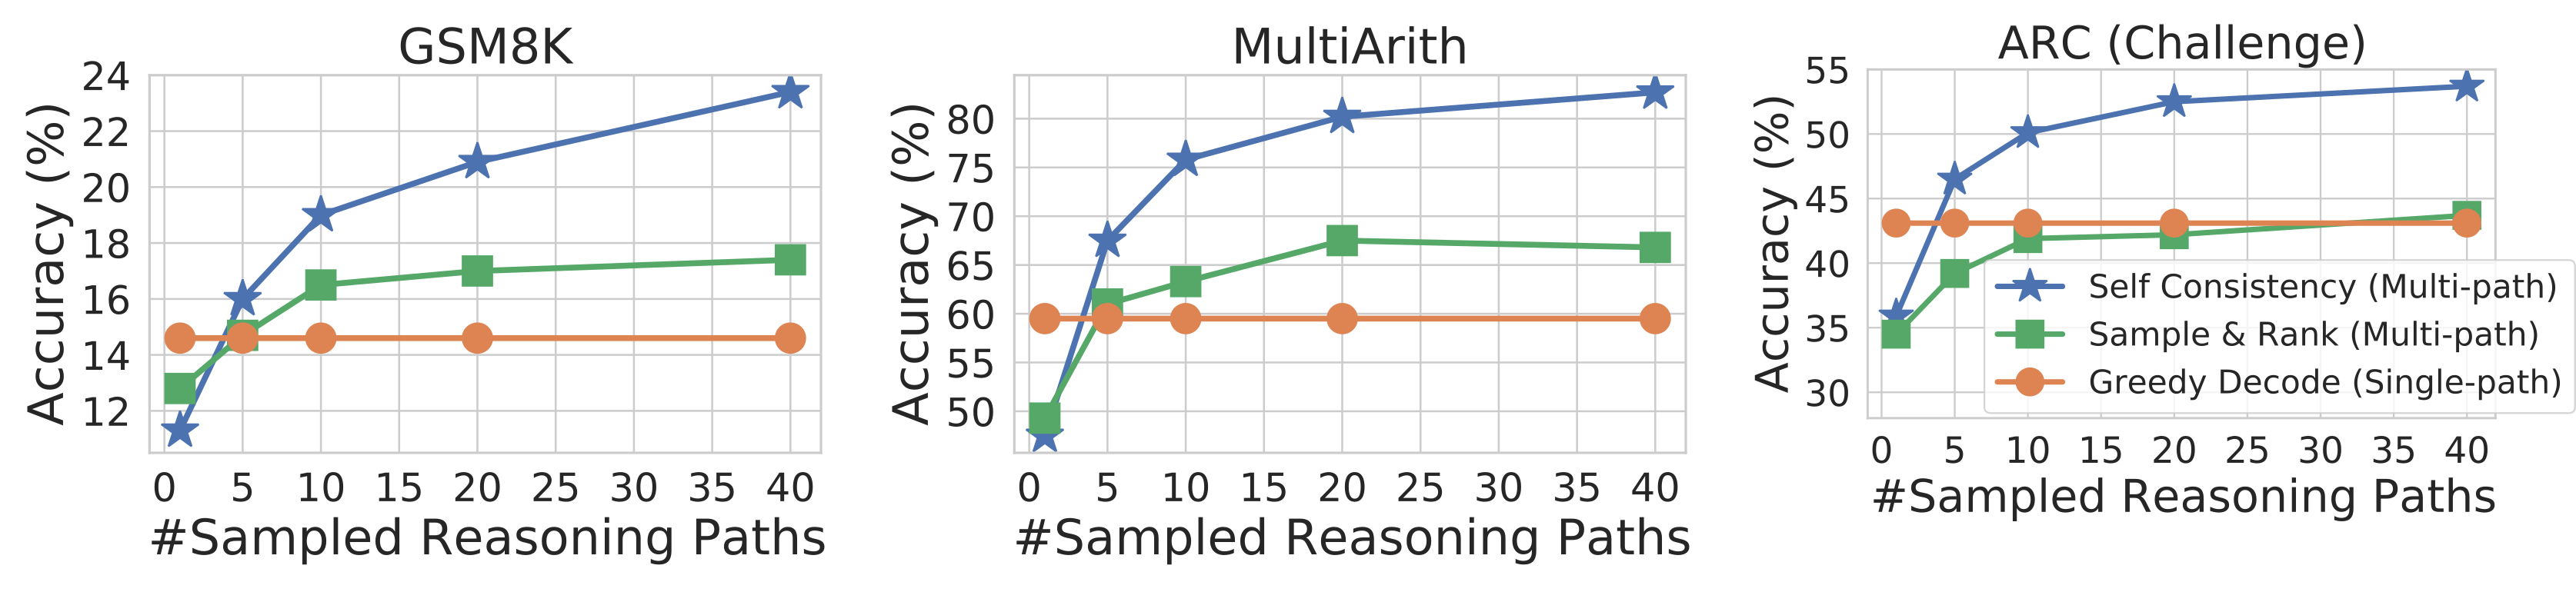
证据五:表3的无效场景与表9提示稳健性。 UL2四字母拼接从0.0到0.0,LaMDA同任务8.2到8.2,说明缺少可用能力时投票可能毫无帮助。另一方面PaLM三套GSM8K提示分别由56.5/54.6/54.0提高到74.4/72.1/70.4,收益跨提示存在,但提示之间的差距仍保留。
五、一致错误与答案归并失误仍会放大偏差
如果把问题中的“再买入”误读成“再送出”,模型可能多数回答12。此时一致性很高但事实错误。可设计反事实措辞对照,记录每题的票数集中度与正确性,研究高一致错误;这是一项未运行的教学实验。
一种直觉是,错误路径可能分散到许多答案,而正确路径共享唯一答案。投票把分散的正确过程汇聚起来。这个假设比“每条采样超过50%正确”更弱,却仍要求正确答案是采样分布中较强的众数。
如果模型系统性误解“增加了20%”与“增加到20%”,多数路径可能复制同一种概念错误。采样随机性不等于知识来源独立性,四十次同模型生成不能当作四十位独立专家。增加样本最终可能更稳定地选出错误众数,而非逼近真理。
论文附录表13本身提供很好的阅读提醒:有些得到正确季节选项的生成解释仍把原因归为地球距太阳更近。作者展示的是修复最终答案,不是逐条科学解释已经正确。判断投票效果时,最终答案与过程有效性必须分别计量。
原创性在于把推导看成待边缘化的中间路径,并以简单采样聚合展示广泛效果。没有新增网络结构、损失或参数学习。主要代价是推理成本和任务特定答案解析,开放写作或多种合法答案任务需要更复杂的语义归并,原方法不能直接照搬。
六、从固定票数接到何时停止与怎样换策略
固定采样数未必适合每题。推理时计算研究难度相关分配,AutoTTS搜索停止和分支程序。票数节省只有连同解析、验证与控制开销核算,才是系统收益。
自测与参考答案
1. 最高概率推导与最高概率答案为何可能不同?
答案:一个答案可以对应很多推导。错误答案可能有一条特别常见的表达,正确答案则由许多不同路径共同支持。选择单条最大值忽略了这些路径的总质量,答案聚合试图保留它。
2. 投票是否要求单条正确率超过50%?
答案:二元答案的简单多数通常需要正确类超过一半才能随样本增加稳定获胜。多类答案下只需正确答案概率高于每一个错误答案,未必超过50%。有限样本、相关生成与解析错误仍会影响实际结果。
3. 40条解答完全一致,是否可以不再验证?
答案:不能。一致性衡量模型分布内的共识,不是独立事实证据。训练偏差或共同误解能产生高一致错误。应结合外部计算、可执行测试、来源核对或独立评估,并用高一致错误比例检查这种风险。