099|AutoTTS:让 Agent 搜索怎样分配推理计算
论文:Zheng 等,LLMs Improving LLMs: Agentic Discovery for Test-Time Scaling,2026。原文 · 正文 v1 · 作者代码入口。
先接住前作的问题
推理时计算表明预算分配依题而异,本篇进一步搜索可执行控制程序。s1延长单条轨迹,这里同时研究分支、探测、剪枝和停止;未解问题是离线回放的节省怎样转成在线系统收益。
五个前置概念
五个前置概念:控制器合成 搜索执行决策的程序;离线回放 用预存路径模拟行动结果;探针 查询当前前缀的暂定答案;Pareto 前沿 表示没有另一方案同时更准又更省;指数滑动平均 平滑信号并保留近期变化。
一、问题设定:预算分配规则怎样在有限轨迹池中被搜索出来
推理分支切成固定长度片段,控制器只知道已建分支、已读深度、已探测答案与剩余预算。正确标签用于评估,未观察答案即使预存在文件中也不可提前读取;这里搜索的是控制规则,不训练基础模型参数。
动作有五类:BRANCH 新建分支,CONTINUE 延长某条分支,PROBE 读取当前位置的暂定答案,PRUNE 放弃分支,ANSWER 聚合已见信号并提交。新分支从原问题开始,并非自动在任意中间前缀长出搜索树。因此作者的宽度—深度空间覆盖若干常见方法,但没有涵盖所有工具调用或树搜索。
程序发现可以表达成策略搜索,环境也有状态和动作,却不意味着本文使用 PPO 或 GRPO 训练这个控制器。实际方法是编码 Agent 改代码、运行评估、读历史、继续改代码。
二、定义可见状态、控制动作与趋势反馈
回放环境
每个模型与问题组合预先生成 128 条推理轨迹,按 500 token 间隔获取探针信号。候选控制器采取动作时,只读取已经存储的对应片段或答案。相同数据与动作路径可以重复评估,便于比较程序变化。
成本模型是:
是第 条分支已消耗的片段数, 是已读取探针的集合, 表示一次探针的相对成本。被剪掉的分支已经生成的片段仍须计入,不能事后抹掉沉没成本。回放实例中读取预存探针不触发新的生成;在线系统获取探针的费用需要另算。
单参数控制搜索复杂度
每个程序只向外暴露一个 ,内部阈值由编码 Agent 写出的函数映射得到。作者要求更大的 对应更大的预算倾向,防止候选程序出现十几个任意可调参数,使有限搜索轮次难以比较。
这是一种限制搜索空间的设计,并不能在数学上消灭过拟合。程序结构和映射函数本身仍然复杂,单个标量的存在也不自动保证实际路径消耗严格单调。
论文的概括目标为:
是代码控制器, 表示成本偏好。要区分目标阐述与实际选择:§3.2、§4 明确说最终按搜索集最高准确率选择控制器,再展示预算曲线,不应把它说成已经求出了该拉格朗日目标的全局最优解。
发现出的控制器做了什么
附录 D 描述 Confidence Momentum Controller:它追踪候选池置信度的指数滑动平均,不只看当前瞬时值;只有平均水平高且趋势没有恶化时才考虑停止。若信心持续改善,减少新增分支;若停滞或下降,倾向拓宽搜索。
与当前共识一致的分支获得更多延长机会,持续偏离的分支经过耐心窗口才放弃,并至少保留两条活跃分支。其直觉是兼顾已有证据与异议,但共识本身可能错误,不能把分支一致性当成外部验证。
把一个控制器走三步,比只看名称更容易理解
为演示附录D的趋势思想,令当前候选池信心为 ,其平滑值为 ,其中 是教学选用的平滑系数,变化量为 。实际程序的参数映射需要以发布实现为准,以下不声称抄录作者阈值。
原创教学轨迹。 取 ,观察到的三轮信心为0.60、0.90、0.55,平滑值依次为0.60、0.75、0.65。若只凭瞬时信心超过0.8就停止,会在第二轮提交;若要求平滑值超过0.8且趋势非负,则不会因一次尖峰退出。第三轮的负趋势提供拓宽分支的理由,却不证明少数答案一定正确,所有分支仍可能共享同一错误。
同时核对行动账本。假设三条分支已读深度为 ,每段500token,一共做4次探测。即便剪掉第三条,已生成成本仍是3000token。若教学上设每次探测成本等价125token,总成本为3500;若回放把探针读取视为零生成成本,则账面只有3000。两者差值来自所声明的测量模型,不是控制程序凭空少做了工作。
所以回放必须同时管住两件事:未来探针虽然存在文件中,也只能在采取PROBE之后暴露;已剪枝分支虽然不再活跃,也不能从累计费用中删去。前者保证信息因果顺序,后者保证成本不被事后美化。若新策略改写了生成提示,旧轨迹连反事实后续都可能失效,需要重新采样而非继续查表。
自构例子。 三条轨迹暂时给出答案 A、A、B。普通投票立即选 A;控制器发现 A 的信心正在下降,而 B 仍在快速取得新信息,可能继续观察而非剪掉 B。若三条路径都共享同一错误公式,任何内部共识规则都可能失败,必须另引入验证信号。
三、因果回放分支和探针并累计已耗费用
输入:预采样轨迹与探针、搜索任务、保留评估任务
初始化候选历史 H
重复五轮:
    编码 Agent 阅读候选代码、准确率/成本与执行轨迹
    提出只暴露一个 beta 的新控制程序
    对若干 beta 在搜索环境回放
    记录分支、继续、探测、剪枝、停止的具体路径
    将评估结果与失败轨迹加入 H
依据搜索集选择控制器并冻结代码
在未参与搜索的任务环境评估准确率与总 token
输出:一个推理控制程序及其预算曲线
四、按保留任务、模型规模和Pareto取舍读结果
先看哪个模型和beta真正同时更准更省,再核对保留任务而非未见规模;回放计费与真实探针生成需要另行对齐。
| 项目 | 原文配置及含义 |
|---|---|
| 主要基础模型 | Qwen3 0.6B、1.7B、4B、8B;基础模型参数不在搜索中更新 |
| 轨迹池 | 每模型每题 128 条,温度 0.7,探针间隔 500 token |
| 重复评估 | 从固定池随机抽子集,控制器评估 64 次取平均;不是 64 次独立生成全新池 |
| 搜索数据 | AIME24,联合四个模型环境;这些模型规模均参与了搜索 |
| 保留数据 | AIME25 与 HMMT25 未参与发现和选择 |
| 发现过程 | Claude Code 编码 Agent,五轮;原文没有在该配置描述中明确底层模型精确版本 |
| 对照 | SC@64、ASC、ESC、Parallel-Probe,比较总 token 与准确率 |
| 额外泛化 | R1-Distill-Llama-8B 的 HMMT25、Qwen3-1.7B 的 GPQA Diamond |
| 发现费用 | 作者报告约 39.9 美元、160 分钟;属于已有回放环境上的发现开销 |
| 证据限制 | 实验全部采用离线回放,未提供充分在线吞吐、工具延迟或完整预采集费用对照 |
证据 1:表1,1.7B 的明显收益。 两个保留任务平均,SC@64 为 34.3、1093.5K token;AutoTTS 在 时为 38.6、343.5K,在 时为 40.6、646.1K。它在这一设置下同时改善质量和 token 消耗,支持控制规则比固定全预算投票更有效。
证据 2:表1,8B 的反例。 保留任务平均,ASC 为 62.8、485.7K;AutoTTS 的 为 62.7、710.8K,质量略低而 token 更多。较低预算的 AutoTTS 为 61.1、379.0K。由此不能说自动发现程序在所有模型上支配所有人工规则;选择何种基线会改变结论。
证据 3:表2,跨模型和任务。 Llama 系蒸馏模型 HMMT25,SC@64 为 26.7、985.7K,AutoTTS 为 27.2、533.9K;GPQA 上低预算 AutoTTS 为 41.6、151.0K,对照 ASC 为 41.0、186.3K。它提供额外迁移实例,但任务与模型组合仍很少,不能概括所有领域。
证据 4:表3,搜索约束与反馈。 完整方法表中平均准确率 53.1、575.5K token;无单参数约束为 49.0、93.3K;无执行轨迹反馈为 51.6、824.3K。第一组是大幅省计算同时降分,不能只凭降分证明过拟合;应进一步做预算配平。表的平均包括搜索集 AIME24,正文将 53.1→49.0 称为保留集结果并不准确,引用时保留表格范围。
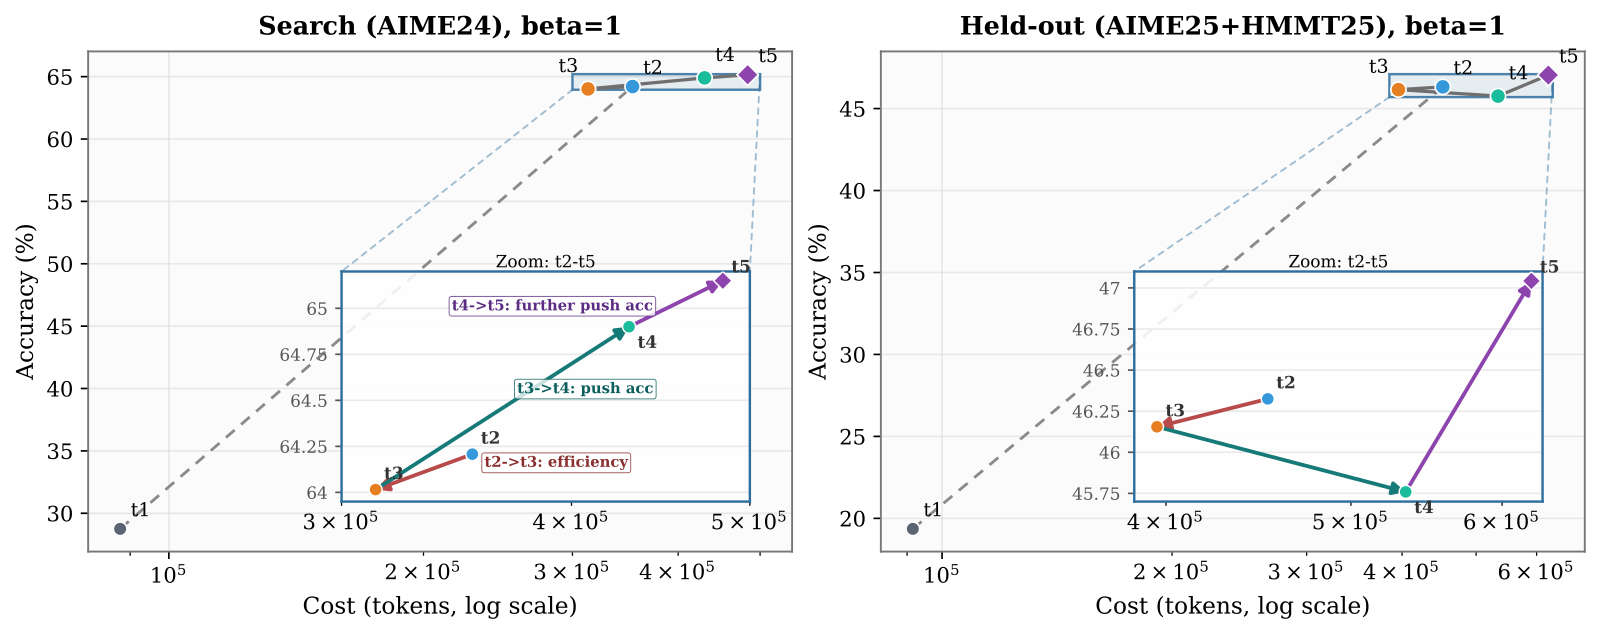
证据 5:图4、§5.6,发现过程。 左图是搜索集AIME24,右图是保留集AIME25与HMMT25,两侧均固定beta=1;横轴为token费用的对数刻度,纵轴为准确率百分数。t1—t5表示五轮控制程序版本,内嵌窗放大t2—t5的细微差异,不是语言模型权重的训练曲线。t2→t3主要减少费用,右图t3→t4却在费用上升时准确率下降:搜索集上推动准确率的修改,并不保证保留集同步受益。t5再提高正确率也花了更多token,因此应按两轴取舍读取,不能说每轮都同时改善两项指标。
§5.5另报告约39.9美元、160分钟,这是已有回放环境上的发现开销;首次生成128条轨迹及探针的成本并未因此消失,不能视为搭建整个实验的总价。
五、轨迹覆盖与改写提示限制离线反事实
论文将研究对象从一条手写启发式提升为可重复使用的控制空间与反馈环境。执行轨迹比单一总分更能告诉编码 Agent 何时剪枝过早、何时延长无效,这是可迁移的工程思路。
作者承认当前动作空间有限,也依赖强编码 Agent。本文进一步分析:离线回放的可信度依赖控制器动作不改变原轨迹后续生成分布。若未来动作会加入新提示、交换分支信息或调用工具,预先录好的路径就未必代表真实在线行为。
四种 Qwen 规模全部参与搜索,因此主表是跨保留任务泛化,不是这四种规模均从未见过。64 次抽样也共享同一 128 轨迹池,不能当成对所有可能随机生成的无界保证。实际部署前需要测试新轨迹、真实探针成本与不同提示版本。
六、把固定响应库诊断接到独立在线复现
Test-Time Scaling 先表明预算分配依赖题目,本篇把这一问题改写为可搜索控制程序,属于后续研究联系;与 s1 的单轨迹延长相比,它是并行分支、探测和停止的另一条路线。最后接上 推理评估协议,重点检查固定回放能回答什么、不能证明什么。
七、自测与答案
1. AutoTTS 是在训练一个新语言模型吗?
答:主要不是。基础模型提供预生成轨迹,编码 Agent 修改推理控制程序。搜索改变何时使用哪些计算,语言模型权重保持不变;它与使用策略梯度更新基础模型的 RL 是不同路径。
2. 为什么预存了所有探针,不应允许控制器随便读取?
答:在线系统只有采取探测动作后才获得相应信息。若回放直接泄漏未来答案或正确标签,就给予部署时不存在的特权,测到的是作弊选择而非可实现的控制策略。
3. 单个 beta 是否足以证明控制器不会过拟合?
答:不能。程序逻辑和 beta 到阈值的映射仍可能非常复杂,也可能针对搜索题特征设计。必须冻结程序后在未参与搜索的新题、新轨迹和模型上评估,且使用完整预算口径。