026|ZeRO:数据并行中,没必要让每张卡保存全部训练状态
论文:Samyam Rajbhandari 等,ZeRO: Memory Optimizations Toward Training Trillion Parameter Models,2019 年预印本。原文 · PDF。本文区分状态分片理论、实现实验与容量推算;标题中的万亿参数方向不等于文中每个推算规模都已完整训练验证。
先接住前作的问题
Adam让训练除权重外还保存两个矩和步数,Megatron处理单层计算的跨卡切分。未解决的另一份浪费是数据并行卡上的状态副本;本篇直接改变这些状态的所有权与生命周期,可与张量并行组合而不改变任务目标。
五个前置概念
五个前置概念是优化器状态、reduce-scatter、all-gather、常驻与峰值显存、数据并行语义。理解这些,就能判断一个训练配置到底节省了什么,而不只凭阶段数字猜测性能。
一、问题设定:每张数据并行卡是否必须保存全部训练状态
混合精度Adam训练不仅有低精度权重,还可能有主权重、梯度和两个高精度矩。只用参数量乘两字节会严重低估需求;普通数据并行又在每张卡重复保存它们。本篇追问更新参数是否真的要求每卡永久持有全部状态。
二、逐项拆开16字节账本,再推分片阶段
设参数数为 、数据并行卡数为 。在论文采用的具体混合精度状态口径下,普通状态约为 字节。只分片优化器状态时约为 ;再分片梯度时约为 ;全部分片时理想常驻状态约为 。
这些式子描述特定精度和状态集合,不是所有框架永远固定的字节数。激活、通信 bucket、临时参数聚合和碎片还需要另外计入。理解口径比背诵 16 这个常数更重要。
第一阶段每卡只更新自己负责的参数分片,再同步更新后权重;第二阶段梯度也按所有者聚合,减少完整梯度常驻;第三阶段连参数都分片,在计算需要时收集相关层,使用后再释放或重新分片。释放时机与预取策略影响峰值与吞吐。
先把16字节一参数拆清楚
在论文混合精度Adam模型中,每参数包含FP16权重2字节、梯度2字节,以及FP32主权重和两个矩各4字节,共16字节。设参数量为P、数据并行设备数为n:只分片优化器状态约为 ;再分片梯度为 ;三类全分片为 。这些是模型状态下界式账本,暂未算激活、临时全收集和通信缓冲。
教学算例。 P=10亿、n=8,以十进制GB计,基线状态16GB,三个阶段分别约5.5、3.75、2GB。若峰值仍有6GB激活与缓冲,最后并不是每卡2GB即可训练。一次按层all-gather形成的临时完整权重还可能成为峰值;容量和运行时峰值必须分别测。
把一个分片状态的生命周期列出来
以四个数据并行rank为例,某参数的优化器状态只由所属rank保存;需要执行该层时,各rank仍须取得相应参数值,反向后再把梯度归约到正确所有者。容量减少来自“不长期重复驻留”,并不意味着其余rank从不接触这些字节。核算峰值时应记录收集中的临时参数与当前激活。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、让全局梯度到达状态所有者,并管理临时聚合
划分参数索引,给每个数据并行进程分配所有权
按阶段决定分片优化器状态、梯度和参数
每个batch:
    按需要聚合当前层参数并执行前向
    反向计算梯度,将分片梯度聚合到对应所有者
    每卡用本地优化器状态更新自己的参数分片
    按下一计算需要同步或收集更新参数
记录峰值显存、通信量、吞吐与数值一致性
构造四张卡和四个参数块。每卡仍处理自己的样本,所有样本梯度最终都应影响所有参数;只是第一卡保存并更新块一的 Adam 状态,第二卡负责块二,以此类推。所有权分片不等于数据对参数影响被隔离。
若错误地让每卡只用自己的局部梯度更新其块,而不聚合其他样本贡献,就改变了训练算法。正确通信必须保持相应全局梯度语义。这也是验证分布式实现时应检查的小模型数值对照。
四、把容量推算与实测峰值、吞吐分开读
没有参数被删除,所以 ZeRO 不是量化或剪枝;也不能说每卡只训练自己样本对应的一部分模型。
理论常驻账本与运行峰值不同,图1和表1的估算应接着实测吞吐读。
| 项目 | 原文范围 |
|---|---|
| 理论对象 | 模型状态冗余与通信量分析 |
| 分片阶段 | 优化器、梯度、参数逐步加入 |
| 容量表 | 多个模型规模与并行度的每卡状态推算,需与实测区分 |
| 实际系统 | 具体硬件上展示可训练模型规模与效率 |
| 未覆盖内存 | 激活、临时缓冲及碎片属于额外分析和优化对象 |
| 比较要求 | 相同精度、batch、模型和硬件下比较峰值与吞吐 |
证据一,图1。清晰分解不同状态的冗余,解释各阶段节省来自哪里。图中模型状态不是全部训练峰值。 内存示意图只统计模型状态:示例固定 7.5B 参数、64 路数据并行和混合精度 Adam。它不是包含激活、缓存及碎片的实际峰值显存截图。
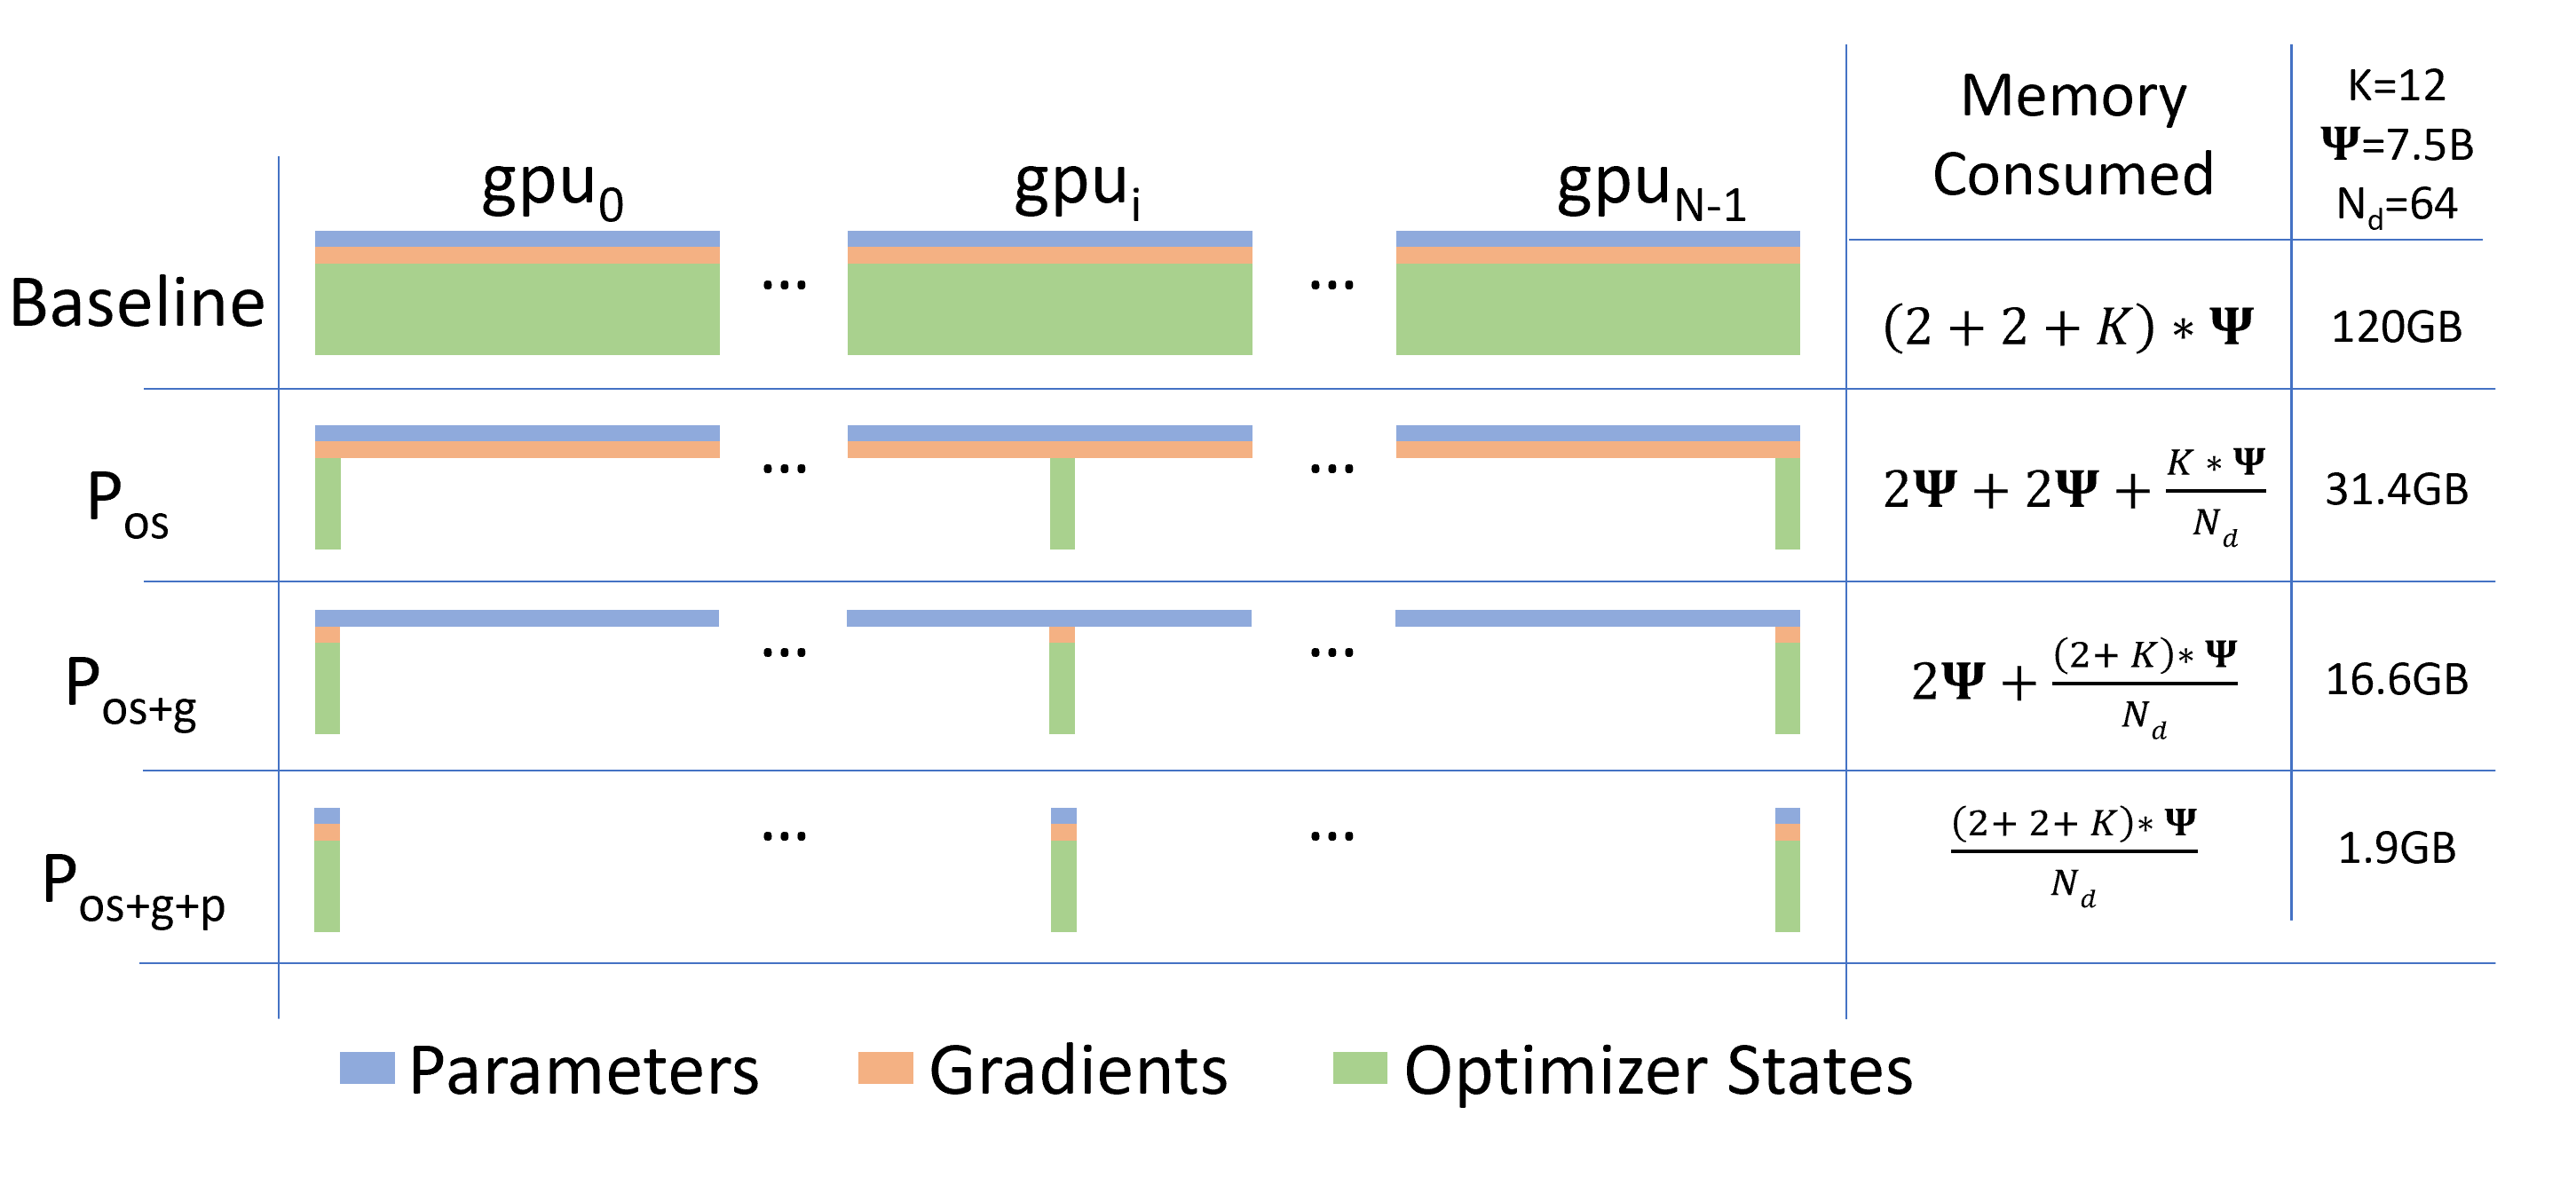
证据二,表1。例如 7.5B 模型在 64 路条件下,完全分片的模型状态约 1.88GB,而普通状态约 120GB。这是论文口径的计算结果,不是说一张两GB卡便能完整训练该模型。
从内存账本走到实测。 原图2横轴改变模型规模,点表示单GPU吞吐,灰柱按右轴表示相对基线的加速。ZeRO与基线的模型并行放置不同;节省状态内存能够改变可训练规模与通信布局,但某一个柱高不是所有模型、硬件的固定加速倍数。
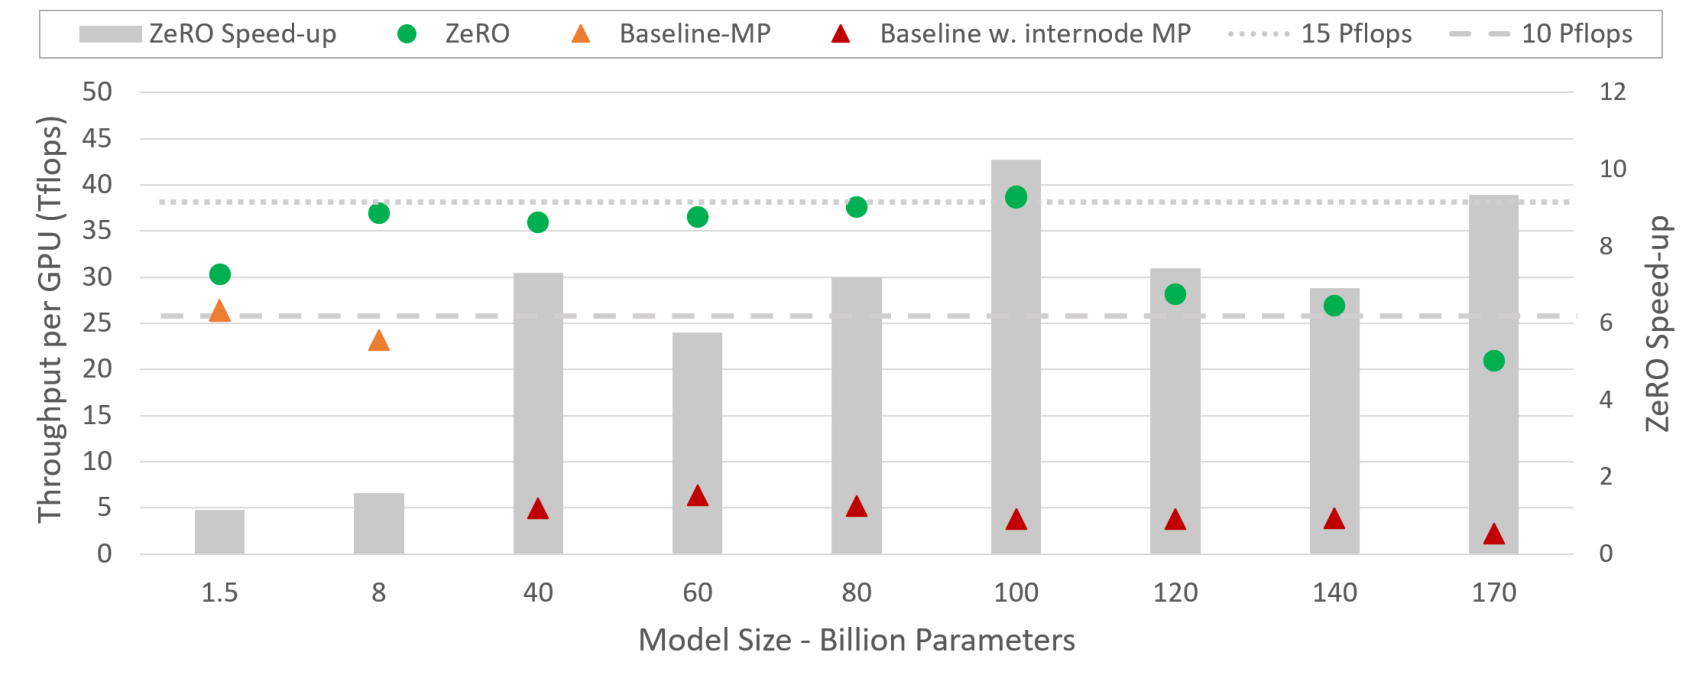
证据三,分片算法与通信量分析章节,以及实测扩展部分。理论给出不同阶段的通信取舍,实测验证系统可运行。通信总量、通信关键路径和实际等待时间仍不相同,不能只凭字节总数预测速度。
标题强调面向万亿模型的扩展方向,阅读时应逐项识别哪些是分析推算、哪些是已运行实验。容量推算有价值,但不能被改写成完整训练已经完成并达到某个任务质量。
先用小模型对照未分片训练,固定随机性,检查一两步参数变化与损失在浮点容差内一致。再测峰值内存,区分参数、优化器、激活和通信缓冲,最后比较达到相同质量所需时间。
只报告“没有 OOM”不足以说明方案好。一个配置可能靠过度通信勉强运行,却吞吐很低;另一个可能内存稍高但总体训练成本更低。分片阶段越高并不自动越优,应由模型规模、互联和batch决定。
五、常驻状态减少仍留下激活、预取和恢复问题
第三阶段在执行某层时可能临时取得较完整参数,因此瞬时显存高于常驻分片值。若通信预取多层,吞吐可能改善,峰值却增加。内存与速度需要在同一时间线上分析,而不是两个独立最大化目标。
限制包括通信、调度复杂性、故障恢复、检查点重组以及激活内存。它提供资源管理能力,不直接提高语言建模目标的统计效率。
检查点保存也是状态分片带来的真实工程问题。每个进程可能只持有局部权重和优化器状态,恢复到不同并行度时必须重新组织所有权,并保持参数顺序和矩状态对应。若只合并权重做推理,这是合法导出,却不等于可无缝恢复原训练。可以用一个保存前后单步对照检验恢复语义,再测试改变设备数的重分片。这个实验方案还应模拟一个进程缺失文件,确认系统会明确失败,而不是静默生成不完整模型。它关注可靠性,与论文的理想内存公式是不同但相关的要求。
分片后的模型状态估算不包含激活、临时通信缓冲和内存碎片,因此容量公式不能直接当作运行时显存峰值;实际最大批量仍需测量。
六、把本篇机制再推进一步
1. 改变并行卡数后只合并权重,能否无缝恢复训练?
参考答案:不能据此保证。恢复还需要让优化器矩状态与正确参数重新对应,并重组状态所有权;只合并权重是合法推理导出,却不是完整训练检查点。可比对保存前后的一步更新,再检查缺失分片是否明确报错,而非静默得到不完整模型。
七、按计算分片与精度/增量两条轴继续优化
分片后还要处理具体算子与请求状态。Megatron是可组合的张量轴,vLLM研究推理KV生命周期。继续比较时先明确保存对象,避免把训练优化器状态与生成缓存混为一类。
自测与参考答案
1. 每卡只拥有部分优化器状态,是否意味着只训练部分参数?
全局仍更新全部参数,每卡负责一部分所有权,梯度需要正确聚合。所有权和学习范围不同,不能把分片误读成冻结其余参数。
2. 为什么 不等于实际峰值显存?
它只描述特定状态与精度口径。激活、临时聚合参数、通信缓冲和碎片仍占空间,峰值还取决于调度。
3. 为什么最高分片阶段不一定最快?
更多分片减少常驻内存,却增加按需参数通信和调度。如果原模型已能放下,较低阶段可能有更好吞吐。需要在相同任务质量与硬件下实测。