024|Megatron-LM:按矩阵结构切分 Transformer,减少模型并行通信
论文:Mohammad Shoeybi 等,Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism,2019。原文 · PDF。本文讨论早期张量模型并行,不把后续流水线、序列并行或整个现代 Megatron 生态当作原文已实现内容。
先接住前作的问题
Transformer让训练位置可并行,但大模型参数与计算仍可能超过单卡容量。普通数据并行只复制完整模型,不能解决这一问题;本篇按其前馈与注意力算子结构直接设计张量切分。它与随后ZeRO的状态所有权分片可组合,处理的轴不同。
五个前置概念
五个前置概念是数据并行、张量并行、all-reduce、强弱扩展和非线性可分性。理解它们,才能从一张训练速度表判断方法究竟扩展了什么。
一、问题设定:单卡放不下模型时,怎样分片而不在每个算子间同步
数据并行把不同batch交给各卡,却让每张卡保存并执行完整模型,不能让超出单卡容量的模型直接训练。模型并行可拆开同一计算,但随意切矩阵会在非线性和投影间频繁通信;本篇要找能让局部计算连续进行的切分方向。
系统论文的正确目标不是只展示“用了很多卡”,而是说明更多设备带来了多少有效工作,以及与足够强的单卡基线相比损失多少效率。理论峰值、实际吞吐和端到端训练进度必须分别测量。
二、沿非线性前后推导互补矩阵切分和输入梯度归约
考虑前馈层 。先把 按列切成 ,各设备可独立计算 ;再把 按行切成对应块 :
因为非线性作用于各自输出块,不必在两次乘法之间先拼回完整隐藏向量。最后再求和形成输出。若第一层按不合适方向切分,非线性前可能就需要同步,通信更多。
注意力头也能分组放在不同设备,各自完成相应头计算,再在输出投影处组合。原论文用成对的通信算子安排前向与反向的 all-reduce:一个前向恒等、反向同步,另一个前向同步、反向恒等。
这些算子不是新的学习损失,而是保证分布式计算与原数学图对应的执行机制。数值精度与浮点求和顺序可能造成微小差异,但不能允许因切分漏掉某个梯度项。
前向少通信,反向为何仍要一次归约?
设输入 ,第一权重 按列分片为 ,第二权重 按相应行分片为 ; 是 token 数、 是模型宽度、 是中间宽度。第 张卡计算 、,前向输出为 。若上游输出梯度为 ,则各卡可本地计算
是对本地第一投影的梯度, 是损失, 为逐元素乘。权重梯度各归各卡,但传回共享输入的梯度是 ,还需一次归约。因而“两个 GEMM 之间不通信”不等于整层前反向都不通信;原文成对算子恰好把同步放在这些必要位置。
教学算例。 用ReLU代替论文GeLU便于手算: 时,,而 。局部激活后再求和会算错原函数。
假设第一层输出四个通道,两张卡各算两个,再各自应用 GELU,彼此无需交流。第二层的输出是这些中间通道贡献的和,各卡算部分贡献后相加即可。这个局部独立结构正适合减少一次中间通信。
若先把输入通道拆开,两张卡各得到第一层的部分和,必须先合并才能正确计算 GELU,因为 一般不等于 。这说明并行设计受非线性位置约束,不能仅靠“矩阵可切”推断任意切法等价。
给两次投影标上跨卡尺寸
自构输入为3×4,第一权重为4×8,第二权重为8×4。两卡各持第一权重的4×4列块,得到3×4局部激活;各持第二权重的4×4行块,各自产生3×4输出贡献,求和后仍为3×4。前向归约的对象不是8维隐藏拼接,而是两个同形输出贡献;反向对输入也要汇总两条路径的贡献。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、先对齐单卡数值,再部署张量与数据并行
先做一个自构正确性检查:把同一小矩阵分别按单卡和两卡分片计算,比较前向结果、输入梯度及两个权重梯度。只检查最终loss相近可能遗漏梯度缩放错误;在数据并行与模型并行同时存在时,还要确认没有重复除以组大小。系统优化的数值语义应先验证,再扩大设备数。
将一个模型并行组中的设备分配给矩阵块和注意力头
前馈子层:
    各卡计算列分片第一投影及本地非线性
    各卡计算对应行分片第二投影的部分结果
    all-reduce 求和得到完整输出
注意力子层:
    各卡处理自己的头与相关投影
    在输出组合处同步需要的量
反向按共轭通信规则汇总输入梯度
多个模型并行组再以数据并行同步参数梯度
四、区分弱扩展效率、实际吞吐与模型质量
扩展效率也需同时报设备数与单卡吞吐;更多卡能容纳更大模型,不等于固定模型达到同倍加速。
数值语义通过后再看扩展曲线,注意模型规模和设备数是否同时增长。
| 项目 | 原文范围 |
|---|---|
| 硬件 | V100 等明确互联配置,模型并行与数据并行组合 |
| 规模 | 约 1.2B 到 8.3B 的扩展研究配置 |
| 口径 | 弱扩展随模型规模增长,不是固定模型的纯强扩展 |
| 指标 | 实际 FLOPs/s、扩展效率、训练时间与语言任务表现 |
| 质量任务 | GPT 类语言建模与 BERT 类任务,具体配置不同 |
| 复现条件 | 卡间互联、每头维度、精度和batch均影响结果 |
证据一,图3 与 Code 1。矩阵分片和前反向通信算子给出核心实现。它说明减少通信的逻辑,不只是报告最终速度。 模型并行图中的 f 与 g 分别在反向或前向执行 all-reduce。把一对前馈矩阵连着看,才能看清通信为何可以跨过中间非线性。
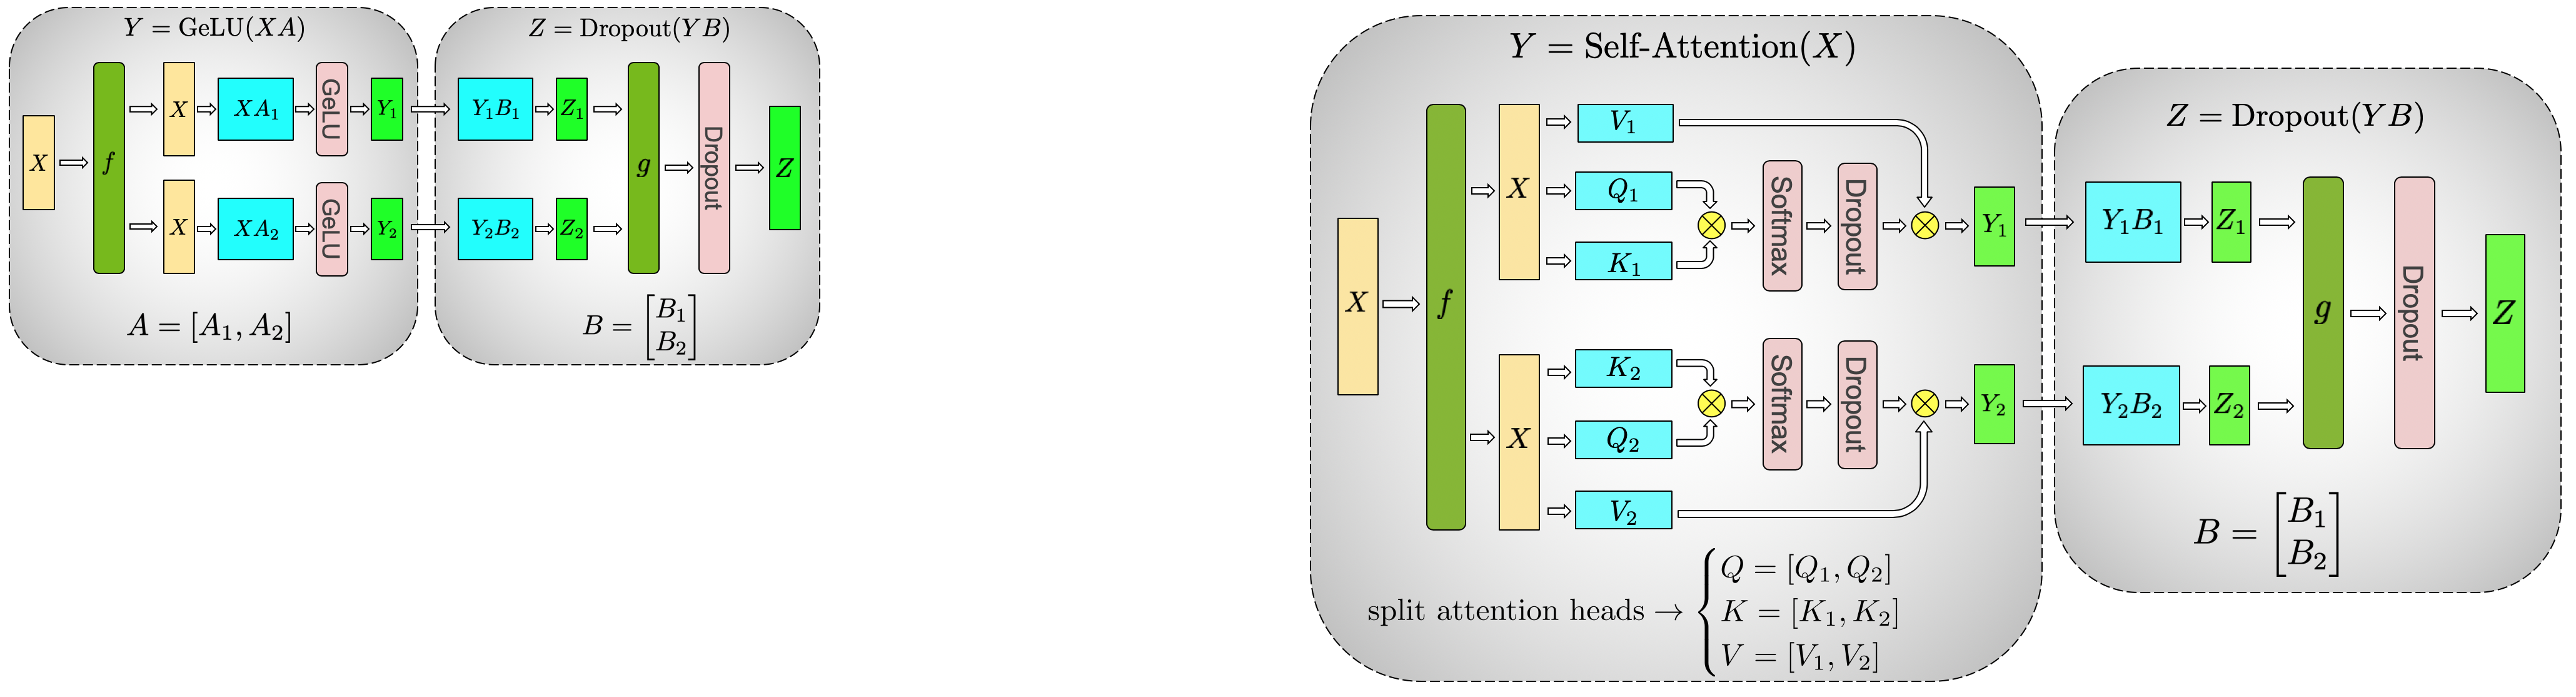
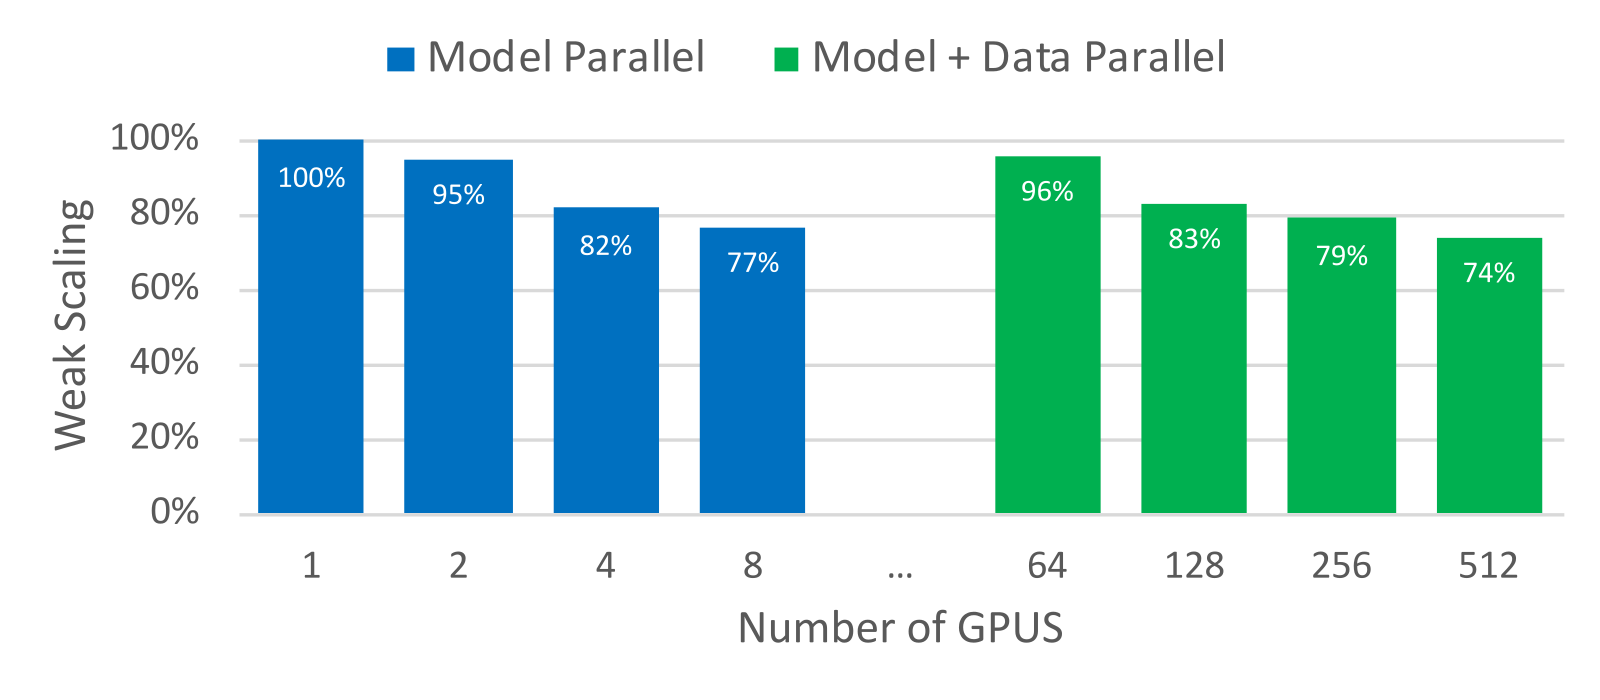
证据二,表1 与图5。模型从约 1.2B 到 8.3B、设备增加,检验弱扩展。摘要与引言报告512卡运行约76%扩展效率;下方图5及§5.1.1的这组弱扩展实验标为74%。正文说明后续8.3B训练配置的注意力头数不同,不宜把两个实验口径强行合成同一个数,更不能说512卡对任何任务都达到同一效率。
读图5。 横轴是GPU数量,纵轴是相对于单GPU基线的弱扩展效率;蓝柱仅用模型并行,绿柱再叠加数据并行。模型大小随设备数变化,100%表示按该基线理想扩展,不是GPU理论峰值利用率,也不是固定模型的强扩展加速比。
证据三,表3。8.3B 模型在对应零样本设置下 WikiText-103 PPL 为 10.81、LAMBADA 准确率 66.51%。它证明系统能训练出有效大模型,但与更小模型的差异同时包含容量和训练资源,不能归因于并行本身提高语义能力。
论文指出扩展实验与最终质量模型的部分头数配置不同。读者不应把两个表所有字段拼成一个不存在的模型。系统数据与质量数据各自准确,合并时仍需核对配置身份。
强扩展固定模型和总工作量,观察增加设备能否缩短时间;弱扩展增加设备时也增加工作量,观察效率保持。两者回答不同问题。把弱扩展曲线称为“同一模型加速 512 倍”是不正确的。
还应报告端到端吞吐,包含优化器和通信,而不是只计最快矩阵核。若只用理论峰值估 FLOPs,可能忽略数据等待和同步。质量达到相同阈值所需时间,也比单步最快更接近训练目标。
五、减少通信次数仍受互联、尺寸和布局约束
再假设网络互联很慢,最终 all-reduce 仍可能成为主要瓶颈。方法减少通信次数,却没有消除通信。更强互联和更大本地矩阵能够改善计算通信比,这也是迁移硬件时必须重新测量的原因。
局限包括同步通信、设备布局依赖、小矩阵效率和总训练成本。它与 ZeRO 分片优化器状态解决的瓶颈不同,后续可以组合而非相互替代。
六、把本篇机制再推进一步
1. 两卡前向完全一致,为什么仍不能宣布张量并行实现正确?
参考答案:输入梯度需要汇总各分片贡献,前向一致不排除漏归约或重复按组大小缩放。应分别比较输入梯度和两个权重梯度,组合数据并行时再检查平均次数。浮点容差可允许求和顺序差异,不能掩盖系统性缩放错误。
七、把算子切分与状态分片、专家通信组合
本篇为 Transformer 计算图设计张量切分;ZeRO 则拆数据并行副本的状态,属于可组合的另一轴。GShard 进一步把分片与专家通信交给编译和系统设计。
自测与参考答案
1. 为什么数据并行不能让放不进单卡的模型直接训练?
典型数据并行仍在每卡保存完整模型,只分样本。模型并行或状态分片才改变单设备需要保存或计算的模型部分。
2. 为什么前馈第一矩阵按列切能减少中间通信?
输出通道块可以独立做逐元素非线性,再通过第二矩阵对应行块计算贡献,最后求和。若非线性前只有部分和,则必须先通信恢复正确输入。
3. 扩展效率 76% 是否等于 GPU 达到 76% 理论峰值?
不是。它相对于选定扩展基线衡量效率保持;硬件峰值利用率是另一分母。两者应分别报告,不能混用百分比。