035 · GPT-3:示例可以成为模型的临时任务接口
论文:Tom B. Brown 等,Language Models are Few-Shot Learners,NeurIPS 2020。原始论文。
先接住前作的问题
GPT-2检验不微调的条件续写,但提示中的任务说明仍可能含糊。本篇直接延续该问题,在前缀中加入少量成对示例并系统比较规模;它改变的是评估时的条件输入,而不是每个任务重新训练模型。
五个前置概念
五个前置概念是:自回归预测下一词,上下文学习使用输入示例改变条件行为,few-shot提供少量标注,闭卷问答不检索外部材料,数据污染指评估内容进入训练。掌握它们,才能继续理解指令微调、思维链和测试时计算分别改动了哪一层。
一、问题设定:少量上下文示例能否替代任务参数更新
适配任务通常要收集标签并更新权重;另一种接口是先给几个输入—输出示范,再要求模型处理新输入。这里要测的是冻结参数后示例是否改变行为、不同规模是否更善于利用它们,以及变化到底来自规则、格式还是已有知识。
二、把示例条件与模型参数分开定义
预训练仍然预测下一个词。给定分词序列 ,最小化:
到了任务阶段,把示例集合 序列化成文本,预测新输入 的输出:
保持固定;发生变化的是条件输入与内部激活。称它“学习”描述的是根据示例调整行为,不代表执行了梯度下降,更不保证获得了人类意义上的抽象规则。可能同时存在任务识别、格式模仿、知识调用与局部模式归纳。
零样本只给任务说明或任务格式,单样本给一个示范,少样本给若干示范。因任务和上下文长度而异,不能把论文所有few-shot都记成固定数量。少样本也不是完全无监督:输入里明确提供了少量成对标签,只是没有用于参数更新。
示例改变条件,而不是偷偷更新参数
少样本预测为 ,其中 为当前输入、 为输出、 为提示中的示例,模型参数 在评估中固定。把它看作任务推断是一种有用解释,但原论文的行为结果并不证明内部必然实现某种贝叶斯算法或梯度下降。示例同时给出标签语义、格式、任务分布和可模仿的表面规律,性能提高不能只归因于学会了一条抽象规则。
自构提示:“苹果→水果;胡萝卜→蔬菜;梨→”。模型输出“水果”可能只是调用既有知识。若要检验临时规则学习,可以把标签替换为无意义符号,如水果映射“甲”、蔬菜映射“乙”,并改变映射。这能削弱先验标签语义,但仍可能受示例顺序或重复影响。
把评测查询的标签从示范池隔离
若示范A、B的标签已经放入前缀,模型可利用它们推断输出格式;待测C的标签只能用于最后评分。按C答得是否正确反复挑A、B,就把评测反馈放进了提示选择。应在开发集选择示范策略,再冻结到测试题;没有梯度更新并不能自动排除测试泄漏。
教法联系:Lilian Weng的Prompt Engineering。算例为本文自构。
三、固定示例池、顺序、格式和答案评分协议
预训练输入:按指定权重混合的清洗文本
    初始化自回归Transformer
    对文本批次计算下一词交叉熵
    按预算更新参数,保存模型
任务评价输入:固定模型、任务说明、示例池、测试输入
    从允许的训练示例中选择k个示例
    按论文任务模板拼接示例和待答输入
    若是生成任务:解码后按任务规则提取答案
    若是选项任务:按规定的条件概率评分选择候选
    不使用测试标签改写提示或更新权重
    记录任务分数、提示长度与示例选择规则
输出:零样本/单样本/少样本分别统计的表现
GPT-3 沿用 GPT-2 风格的自回归骨干,并在注意力模式等处采用相应设置。核心实验变量是模型规模与上下文示例,不宜把所有收益归因于某个结构小改动。任务评分也并非一律自由生成:多选题可以比较候选文本概率,答案长度与归一化规则会改变选择。
一个常见误读是“预训练样本越多,示例就不再重要”。论文恰好研究两者的交互:较大模型往往更能利用上下文示例,但单样本有时不如零样本,说明格式转变和示例数量可能引入额外难度。
另一个重要变量是输出协议。模型可能知道答案却多写解释,导致精确匹配失败;也可能通过常见标签频率获得貌似不错的准确率。评价必须同时核对内容能力、输出格式和类别分布,不能只观察几个成功续写样例。
四、分别读规模、示例数量、失败任务与污染审查
多示例收益并非单调规则,开发曲线、测试参考和不同任务失败需要分别解释。
| 项目 | 原文设置与判断口径 |
|---|---|
| 规模 | 表2.1包含8种模型,最大175B、96层、隐藏维12288;不能把全部曲线只叫一个175B模型 |
| 训练量 | 表2.1说明每种模型均训练300B tokens;相同token量不意味着相同计算量 |
| 最大模型批量 | 3.2M tokens,最大学习率;模型规模对应不同配置 |
| 语料 | 过滤Common Crawl、WebText2、Books1/2、Wikipedia;表2.2混合比例不与原始规模成正比 |
| 评价 | 语言建模、闭卷问答、翻译、阅读理解、SuperGLUE、合成任务等;分别报告zero/one/few-shot |
| 对照 | 不同GPT-3规模及既有任务系统;后者包含微调、开卷或其他资源,比较条件要保留 |
| 重复与污染 | 任务协议和完整分数见附录G/H;未对全部主表提供统一提示采样置信区间;§4专门检查训练重叠 |
表2.2里,过滤Common Crawl有410B tokens,却只占训练混合约60%;WebText2约19B,占22%。有些小语料会重复读取,大语料则不到一遍。这里区分“可用语料池大小”和“实际训练token量”极其重要,否则会把模型训练数据描述成一组错误数字。
不同规模使用同样300B tokens,适合研究该配方中的规模趋势,却不等于每种规模都已处在计算最优点。后续Chinchilla正会重新研究参数与训练数据如何配比。因此应把这篇的规模经验放在具体预算制度下理解。
教学诊断。 假设两类原标签为“好/坏”,在演示中改名为“K/J”,测试时也只允许这两个输出。对照保持格式但打乱示例标签,再对照移除示例:三者分别检查映射利用、标签监督与纯格式收益。例子顺序也应打乱重复;一个精心挑选的提示不能代表few-shot协议的平均效果。
一个未执行实验应比较正确示例、标签打乱示例、仅格式示例和无示例,同时固定长度预算并多次重采样。若标签打乱后表现仍好,模型可能主要识别任务而非学习映射;若顺序变化造成大幅波动,需要报告分布而非挑一个好提示。它们是进一步研究方案,不是原论文已经完成的所有结论。
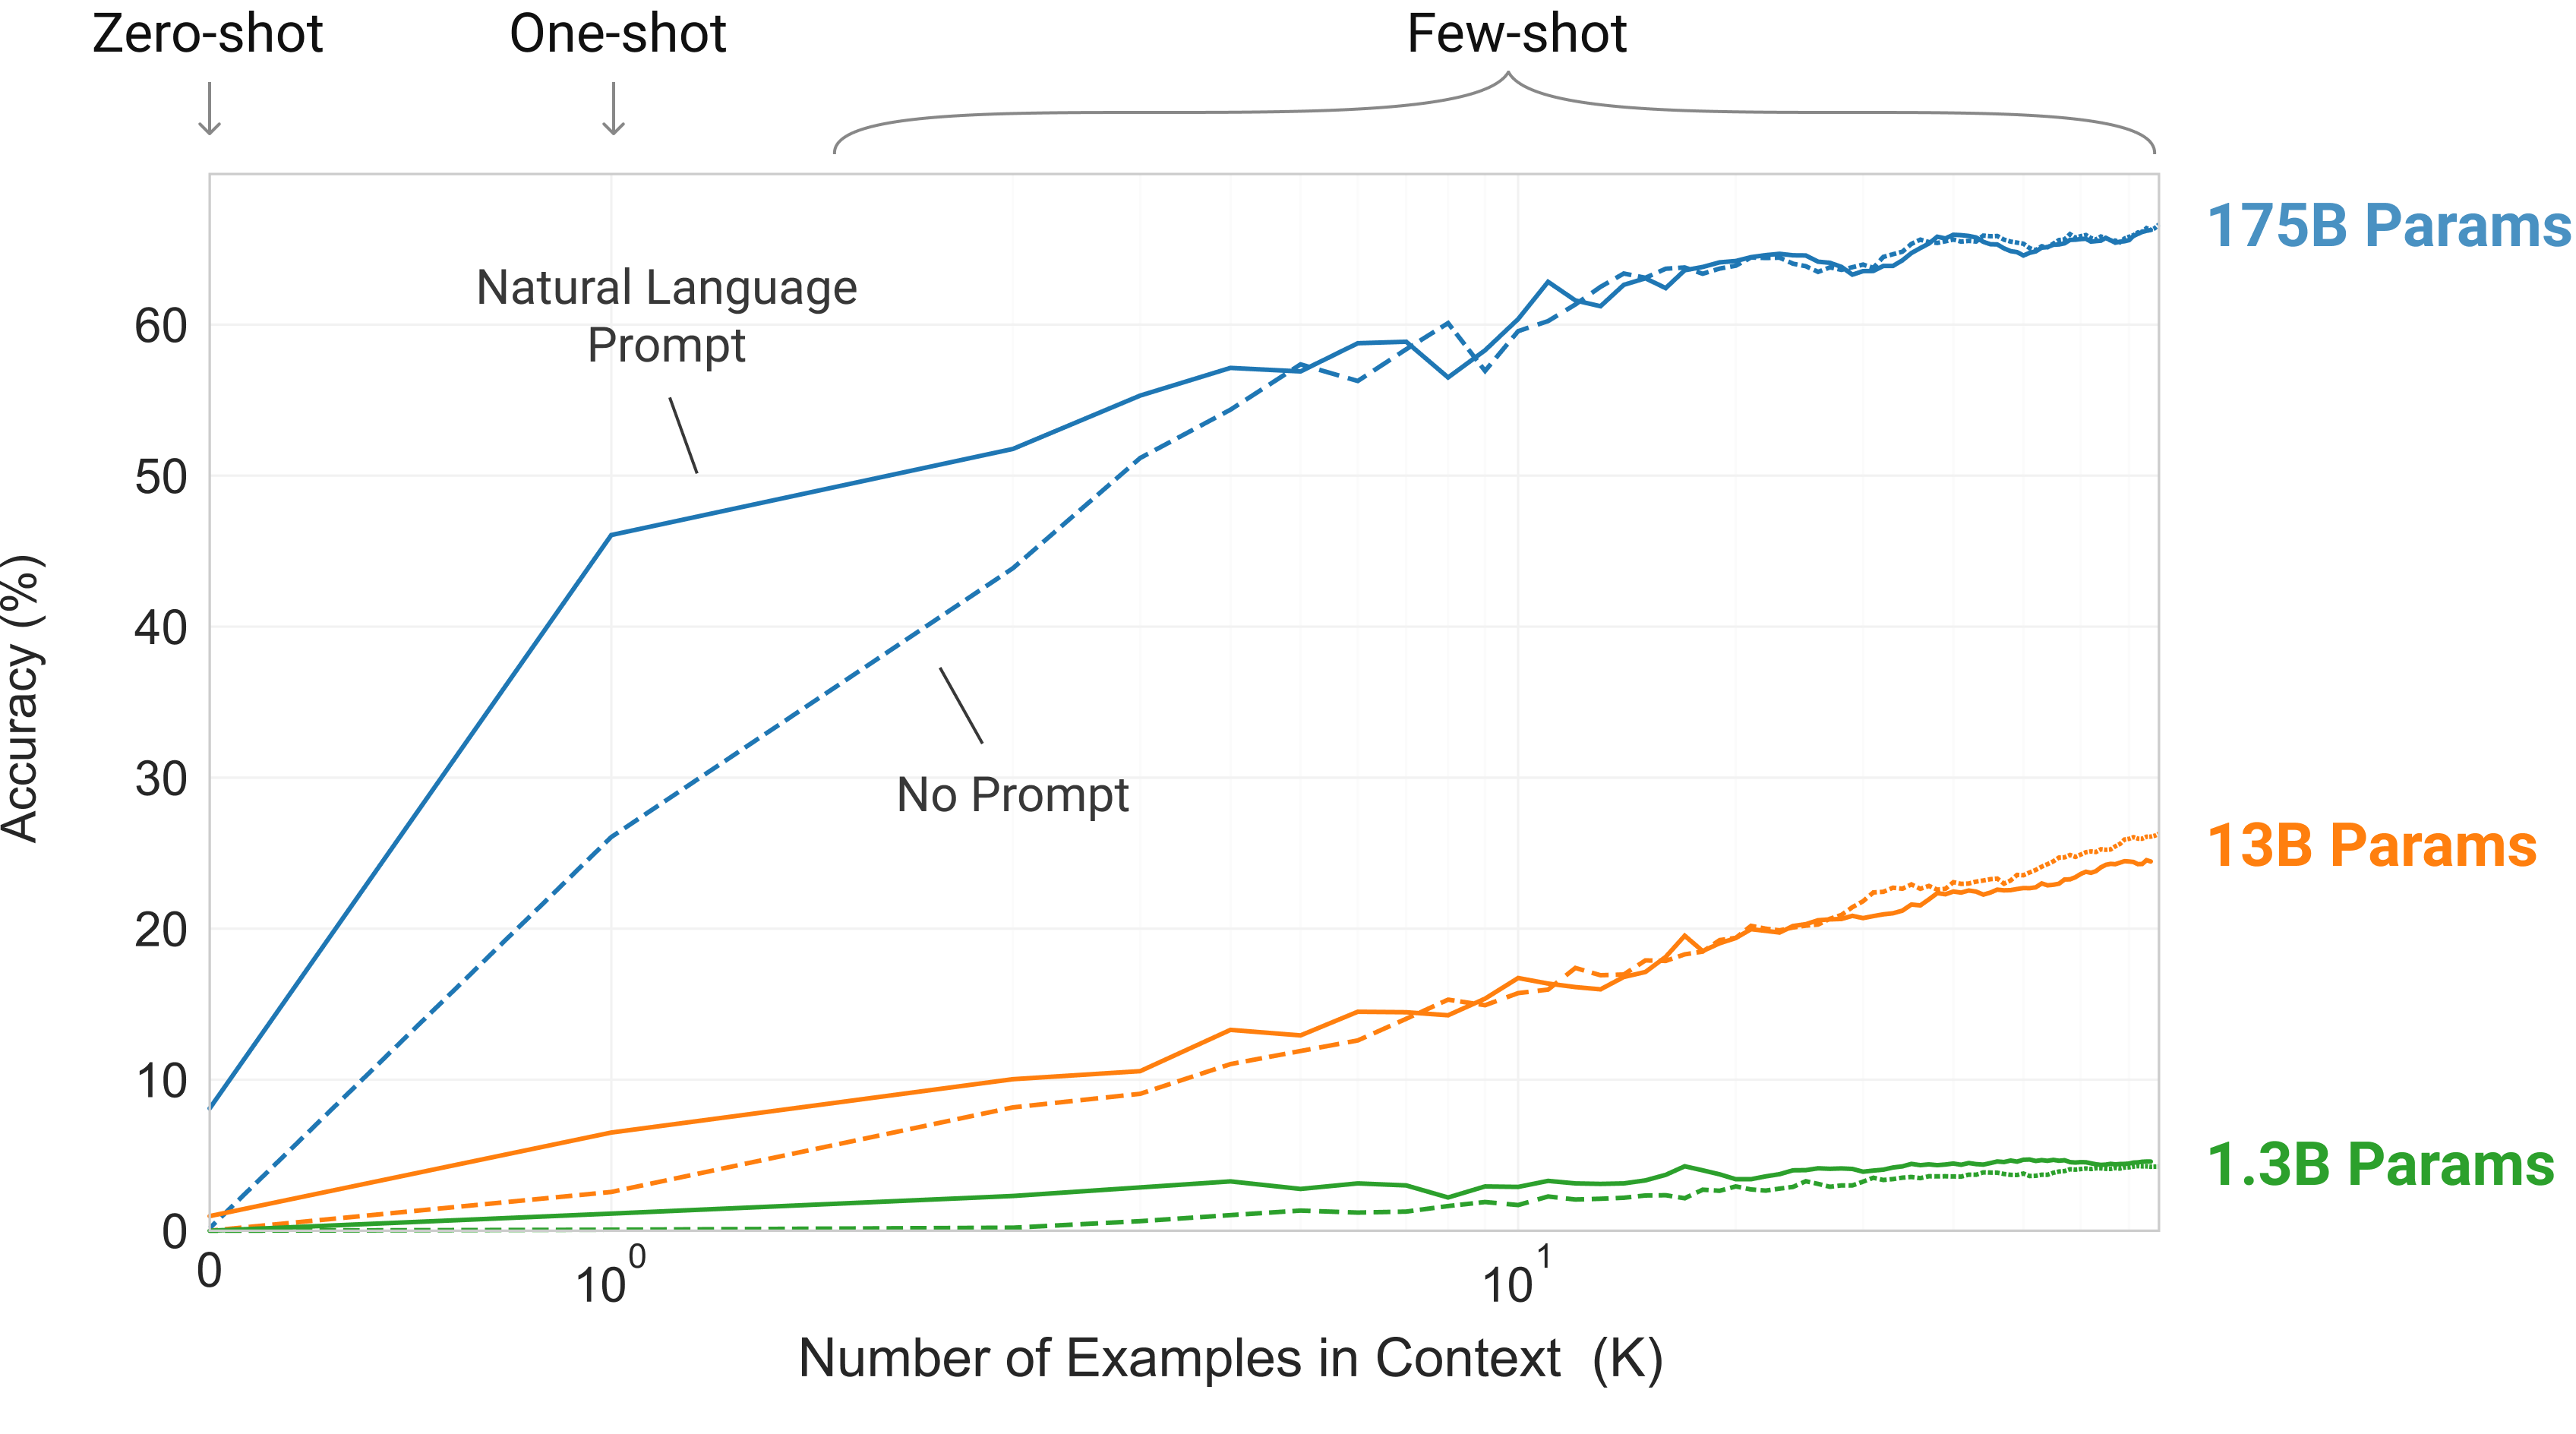
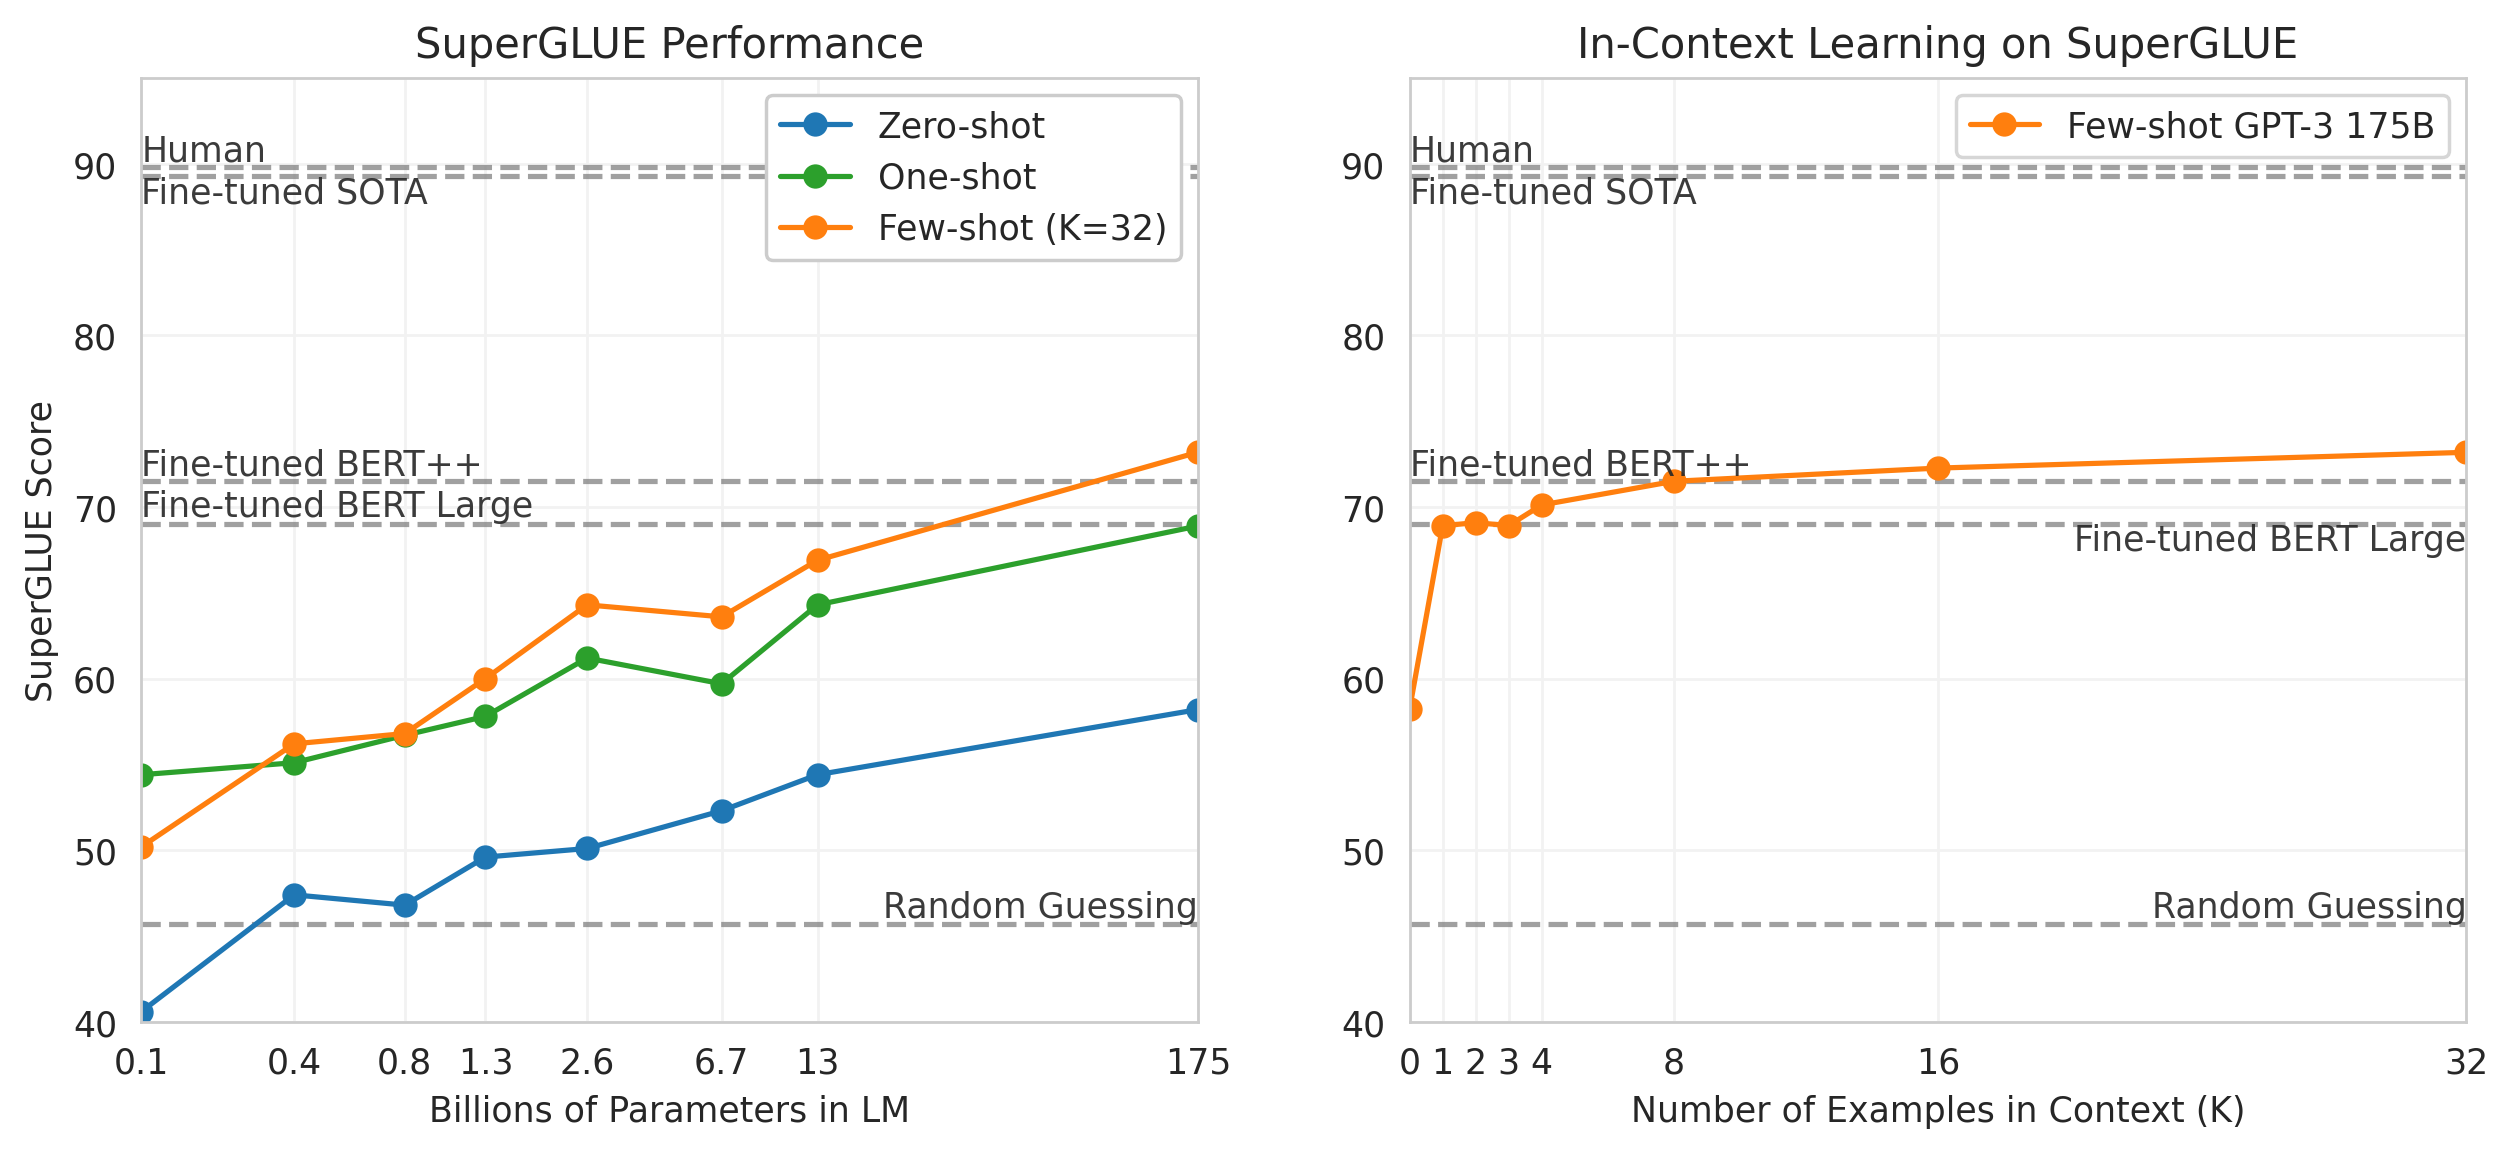
证据一:图1.2与图3.8,上下文的作用随规模变化。 图1.2用构造的符号去除任务展示大模型更会利用示例;图3.8在SuperGLUE开发集考察规模和示例数。它们支持上下文适配能力增强,但开发集曲线不能直接与测试集参考线差值混算,也不能单凭曲线证明内部执行了哪一种学习算法。 符号去除任务展示的是示例数量变化下的行为;SuperGLUE 图另给开发集曲线。两张图不能合并成一个统一任务的学习曲线。
证据二:表3.2,少样本收益不是单调公式。 LAMBADA准确率零样本76.2、单样本72.5、少样本86.4。少样本比零样本高10.2个百分点,单样本却下降。正文指出填空格式与普通续写不同,因此这不是仅改变示例个数而保持所有输入完全一致的纯对照。
证据三:表3.7与表3.8,保留失败边界。 CoQA F1由零样本81.5升到少样本85.0;但DROP少样本只有36.5,对照微调系统89.1。SuperGLUE的WiC少样本准确率49.4,接近二分类随机水平。这些结果说明“许多任务有进步”不能变成“通用理解问题已经解决”。
证据四:§4与附录C,评价污染无法一句排除。 作者发现过滤程序遗漏部分重叠,并因训练成本没有重训,转而比较清洁子集与整体表现。该分析帮助估计影响,但近似字符串检测可能漏掉改写,清洁子集也可能难度不同。因此正确表述是进行了污染审查,而非证明所有任务完全无泄漏。
表3.3的闭卷TriviaQA少样本结果很强,但NQ仍落后于开卷RAG。两者反映知识分布和信息访问方式差异,不能用一个数据集决定是否永远需要检索。
五、格式模仿和知识调用不能单独证明新规则学习
GPT-3 的贡献在于以广泛任务和规模对照,把上下文示例确立为通用模型的重要使用接口。它没有消除训练成本,而是把大量任务适配成本前置到预训练,同时增加了每次提示中的输入开销。模型也没有经过后来意义上的指令对齐,不能把后续聊天产品行为倒灌到原模型。
六、扩展跨学科测量,并把过程写入提示
上下文示范不改权重,仍需挑选和占据窗口。FLAN把任务说明放入训练,CoT把过程放进示例。比较这两条路线,应分别核对训练监督与测试时新增token。
自测与参考答案
1. 上下文学习没有更新权重,为什么还能改变行为?
示例改变条件输入,注意力与隐藏状态随之变化,模型按新的文本上下文预测。行为适配不必等于参数学习;具体内部机制需要额外研究。
2. 300B训练tokens等于模型只看过300B个不同tokens吗?
不等于。混合采样会重复小语料,部分大语料只读取一部分;累计处理量、语料池规模与独特内容量是三种统计。
3. 少样本结果高于零样本,能否证明模型学会新规则?
不能单独证明。示例也能揭示输出格式、标签集合和已有任务身份。需要控制标签语义、示例顺序及任务新颖性,才能区分规则归纳与已有能力调用。