050 · FLAN:从会续写文本,到能按说明执行新任务
返回目录 · 上一篇:TruthfulQA · 下一篇:T0
论文:Jason Wei等,Finetuned Language Models Are Zero-Shot Learners,2021年公开,ICLR 2022。原始论文。本篇是原始FLAN,不将后来的FLAN-T5、Flan Collection等结果混为同一论文。
先接住前作的问题
GPT-3用提示示例说明任务,却仍依赖测试时选择示范。本篇把指令—回答关系显式放进训练,追问只给说明能否迁移未见任务簇;T0是同期路线,偏好优化则是后续另一阶段。
五个前置概念
五个前置概念:指令微调用自然语言说明组织监督训练;任务簇留出排除整类训练任务;数据混合决定哪些任务获得多少训练概率;模板敏感性衡量同任务不同措辞造成的变化;零样本迁移是不为目标任务额外示范或微调,不等于从未接受其他监督。
一、问题设定:只给自然语言说明,模型能否迁移到未训练任务簇
通用续写不系统保证任务说明对应正确执行。逐任务微调要新训练,few-shot又消耗示例选择与上下文;本篇将已有监督数据包装成自然语言指令,尝试在训练阶段学会可复用接口,再对整类未参与训练的任务评估。
输入是模板化指令与任务样本,输出为目标文本。基础模型LaMDA-PT是137B稠密decoder-only Transformer,只有语言模型预训练,不是已经完成对话微调的LaMDA。FLAN进行全参数监督微调;它与前面的Prompt Tuning不同,并非只学习几个连续提示向量。
任务之间可能共享内容和格式,所以“没见过这个数据集”还不够。§2.2规定,评估某数据集时,与它同任务簇的其他数据集也不能用于该轮指令训练。例如测自然语言推断,就排除所有相关推断训练集。
因此主结果不是一个同时在全部任务上留出的统一检查点:评估多个任务簇需要分别训练多个模型,每个模型留出不同簇。这一点决定了复现成本,也决定如何理解“FLAN的平均成绩”。
二、把监督任务改写为指令条件下的生成目标
作者整理62个文本数据集,分成12个任务簇,每个数据集人工编写约10种模板。多数模板描述原任务,最多3种反转任务方向,例如从情感分类改成按给定情感生成评论,以增加训练形式多样性。
设任务索引为 ,模板为 ,原样本 被映射为输入 和输出 ,目标仍为:
这里期望包含数据集抽样、样本抽样与模板抽样。没有新的奖励模型或策略梯度,改变的是监督任务的组织和呈现方式。对分类任务,还把候选类别作为OPTIONS附在输入,降低模型在“是”“确实”“正确”等表达间分散概率的影响。
零样本的“零”落在评估任务
设训练任务集合为 ,指令模板把样本映为 ,损失是任务混合下的 。这里 为任务编号, 为指令, 为输入与目标输出, 为模型参数。评估时不给该目标任务演示,不代表模型未接受任何任务监督。FLAN按任务类型簇留出而非只留出数据集,减少同类任务换数据集却被误称新能力的情况;广泛预训练中是否见过相关知识是另一项污染问题。
自构例子: 训练只给翻译、摘要和情感任务,测试要求判断“所有猫是动物,因此这只猫是动物”是否可由前提推出。如果模型正确输出类别,说明某些说明执行模式可能跨任务迁移;仍需大量未见推断样例来排除仅靠措辞线索。再把说明改成相反标签顺序,能检验它是否读了OPTIONS,而不是总输出某个高频词。
留出任务簇时先按原始样本分组
同一问答数据可被改写成“回答问题”和“根据答案生成问题”。若只按提示文字分训练测试,两种模板可能把同一原样本分到两边。要检验未见任务迁移,应先固定数据与任务簇的划分,再渲染模板,记录反转形式是否属于训练集合;模板名字不同不自动制造新的独立任务。
教法联系:Lilian Weng的Prompt Engineering。算例为本文自构。
三、记录模板、反转任务和整簇留出的训练流程
输入:预训练LaMDA-PT、数据集集合、任务簇映射、指令模板
对目标评估簇 C:
  移除属于 C 及规定相关簇的训练数据
  对其余每个数据集最多保留30K训练样例
  按论文的有上限混合权重抽取数据集
  抽取样例,并随机选择该数据集的指令模板
  形成“指令+输入+候选项 → 目标回答”
  用目标序列似然更新完整语言模型
  训练30K步后固定检查点
  在 C 的每个任务上测试多种说明,报告模板平均与开发集选模板结果
输出:该留出簇对应的零样本迁移表现
方法直觉是任务间共享“遵循说明”的规律。实验可以支持这种组合有用,但不能直接证明模型形成了独立可解释的“指令理解模块”;参数、数据内容和输出格式的效果仍交织在一起。
四、按模板敏感性、任务数量和负结果检验迁移
模板波动不同于训练种子方差;同时看留出簇和原本就接近续写的负结果,才能界定指令训练收益。
| 项目 | 原始论文设置 |
|---|---|
| 预训练基础 | 137B LaMDA-PT,语料token化后2.49T BPE token、32K词表,约10%非英语数据 |
| 指令来源 | 62数据集、12任务簇,人工模板约10种/数据集;每轮排除目标簇 |
| 混合规则 | 每数据集至多30K训练样例,按样例量比例混合并设3K混合率上限 |
| 微调预算 | 30K梯度步,批量8192 token,Adafactor学习率3×10⁻⁵;输入1024、目标256,使用packing |
| 算力 | 指令微调约60小时,TPUv3 128核;这是一个训练配置的成本,不含所有留出模型与消融 |
| 检查点 | 统一取30K步最终检查点,不逐测试任务选训练步数 |
| 评价口径 | 每任务多个模板平均;另报告用开发集选择的模板在测试集表现 |
| 对照 | 同基础LaMDA-PT、GPT-3 175B、GLaM及任务监督模型;跨模型数据和预训练预算不同 |
表格中的模板标准差表示措辞敏感性,不能当作多个训练随机种子的误差条。不同任务还可能以TFDS验证集作为测试,具体划分在附录G;不能仅看到“test”一词便假定所有来源都有同样的隐藏集。
教学划分。 若训练包含英文情感分类,测试改成另一套英文影评,只能较强支持新数据集泛化;若整个情感任务簇都未参与指令训练,才能更直接研究新任务类型迁移。把“请判断评价正负”换成“情绪是什么”则主要是模板变化,三种泛化层级不应合并为一个zero-shot数字。
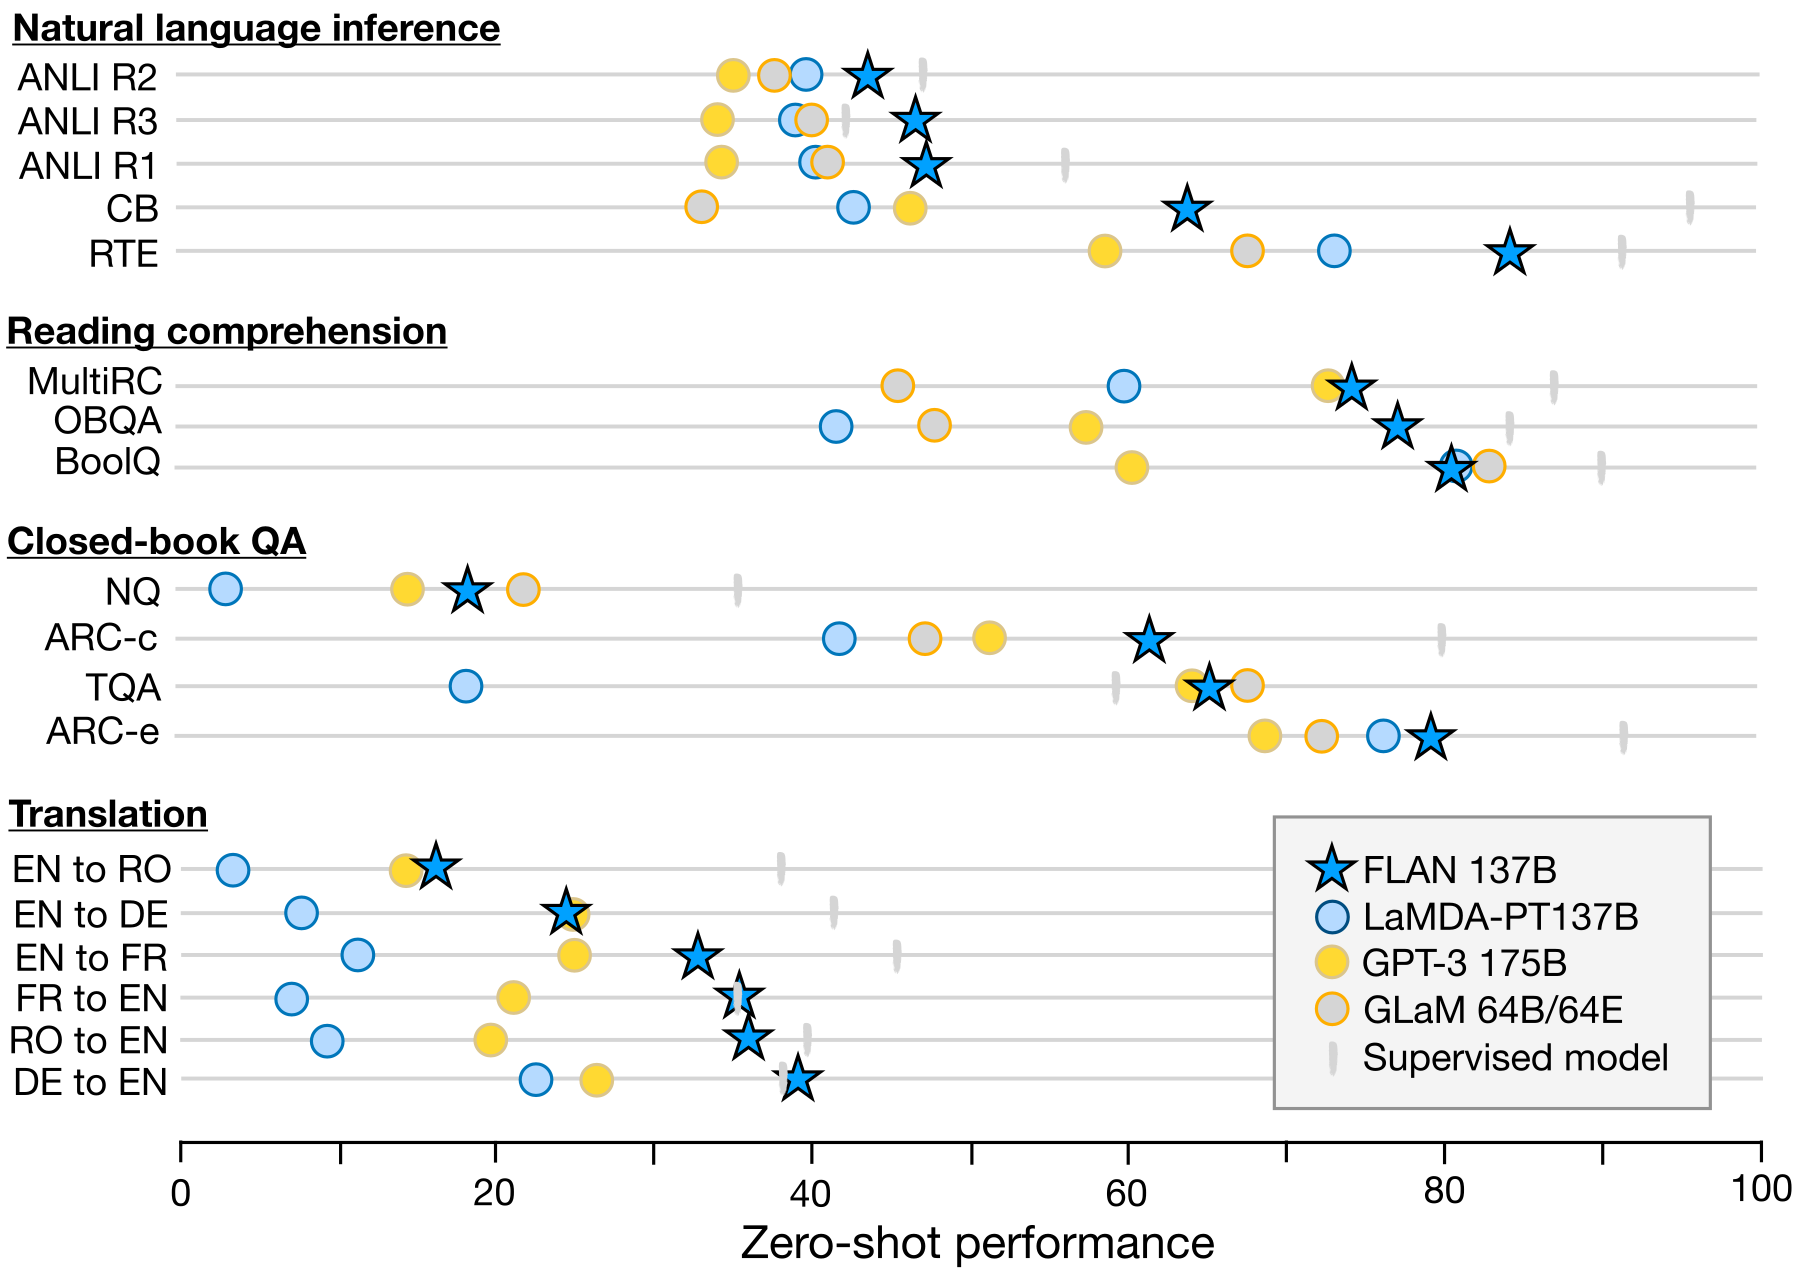
证据一:图5与附录表2,基础模型前后比较。 RTE上LaMDA-PT零样本73.3%,FLAN模板平均78.3±7.9%;BoolQ为81.0%对80.2±3.1%,并非提升。NQ则从3.2到18.6±2.7,变化明显。指令训练对需要明确任务格式的部分任务帮助很大,但不能把平均收益写成每个任务都进步。
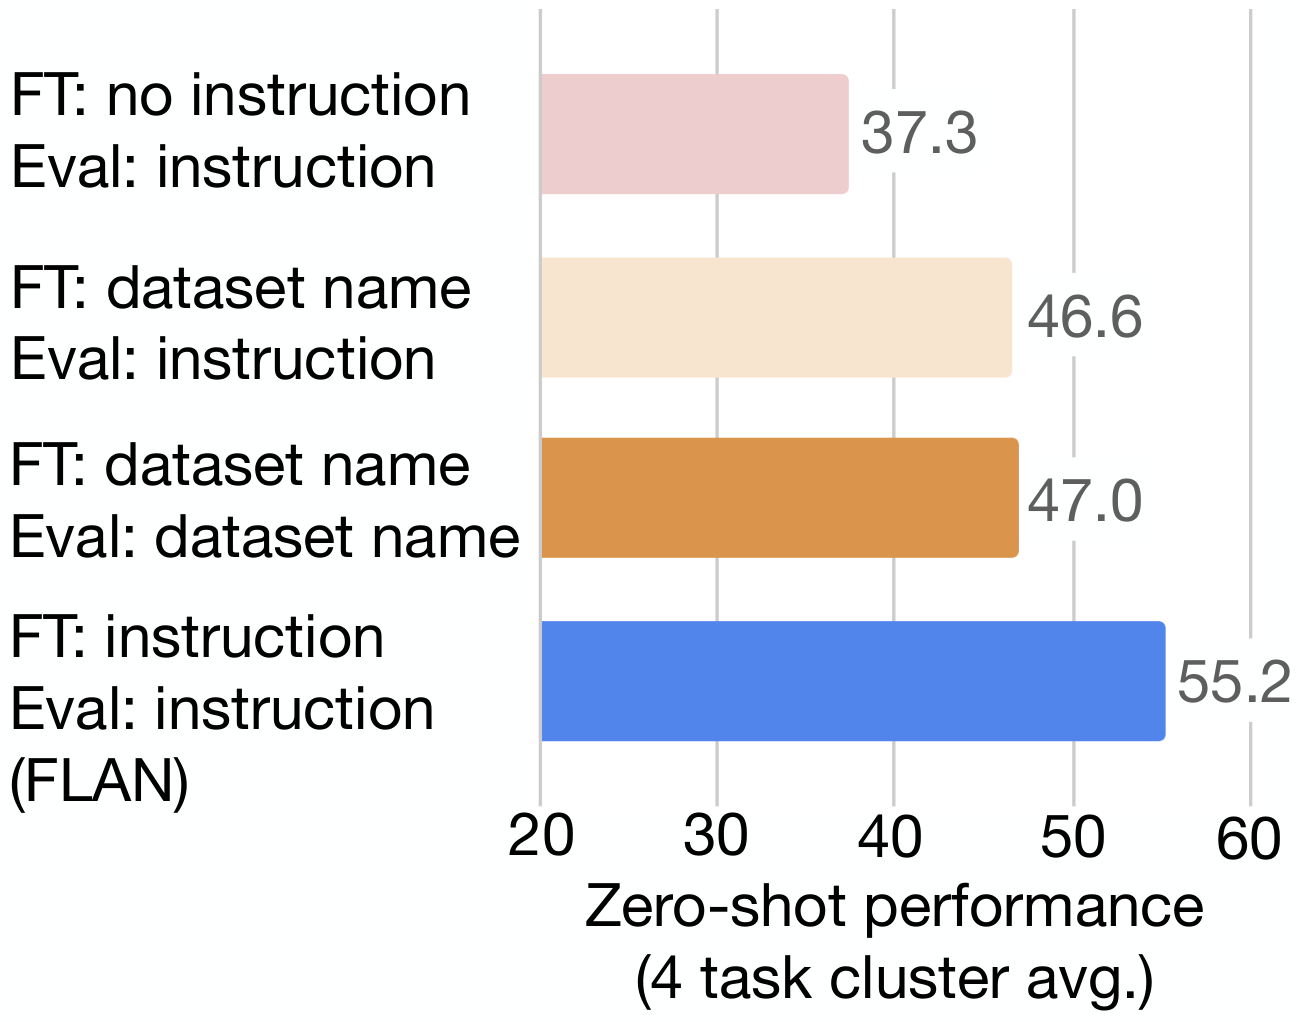
证据二:附录表3与图8,去掉指令的消融。 四类任务平均,正常指令训练与指令评估为55.2,无模板训练后用指令评估为37.3;训练仅用数据集名后用自然指令评估为46.6,同样用数据集名评估为47.0。支持自然语言指令不只是装饰。但无模板对照同时带来训练—测试接口差异,所以更有解释力的是同时看多个对照,而不是仅引用最弱一项。
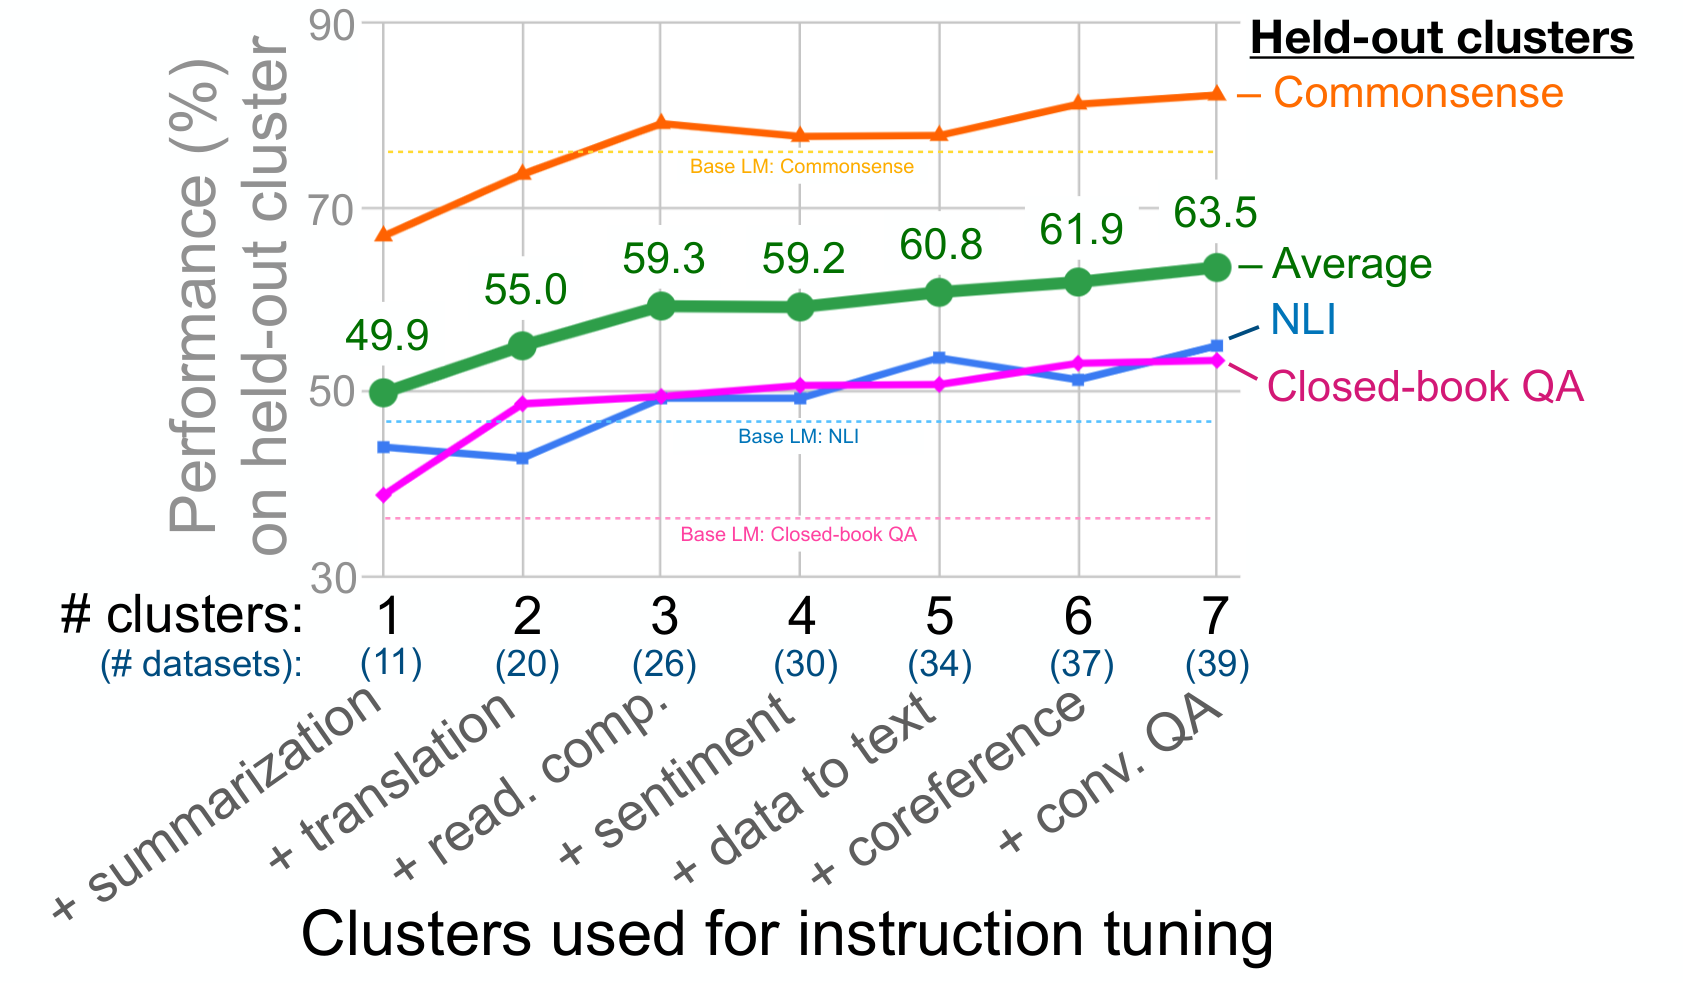
证据三:图6,任务簇数量。 在固定留出簇下,从1个训练簇增加至7个,平均分由49.9增至63.5,中途也有59.3到59.2的小降。表明更多任务覆盖在该加入顺序中有益,但簇数量、数据内容和任务相关性同时变化,不能据此给各个簇作独立贡献排名。
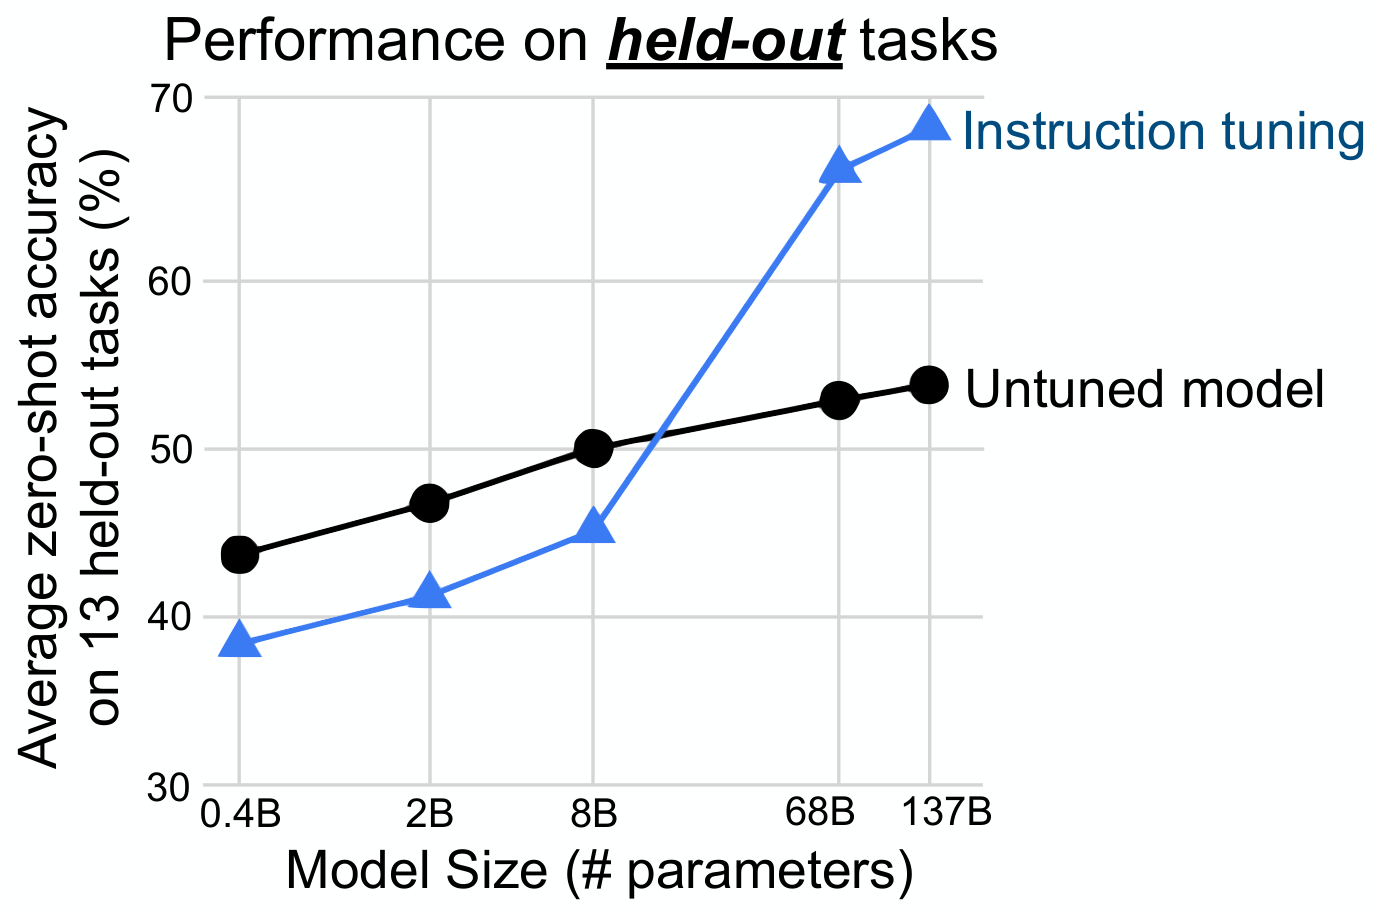
证据四:图7,模型规模。 小规模配置中指令微调可能伤害未见任务,大规模配置获益。作者提出小模型容量被训练任务占据的可能解释,但没有直接测出一个“容量耗尽”变量;应把它保留为解释假设,不能当作已证明机理,更不能转成小模型永远不适合指令训练的结论。
证据五:§3负结果及附录表2。 七个常识与指代任务中仅三个超过LaMDA-PT。HellaSwag平均56.4对基础57.0,表明原先就接近文本补全的任务未必受益。论文也报告对非英语方向翻译相对较弱,可能涉及语料比例和分词器,但缺少完全独立控制这些因素的因果实验。
“超过GPT-3的25项中的20项”使用开发集选择模板的口径。模板平均更接近随手给一条合理说明的预期,最佳开发模板则包含额外选择信息;两类数字都可有价值,但需要明确标注。
五、未见任务的零样本不等于从未接受监督
FLAN把跨任务泛化从提示工程问题推进到训练数据设计问题:不仅问“提示怎么写”,还问“模型是否在训练中系统学过执行说明”。它展示了数据转换与任务混合可以改变零样本接口,不需要首先发明新网络结构。
“未见任务簇”仍依赖人工聚类。比如问答、推断、阅读理解之间存在共享推理步骤,簇边界不可能完全切断知识迁移。预训练文本也可能与评估样本重叠,附录污染分析降低疑虑但不能证明所有可疑来源都被排除。
六、对照多任务提示训练,再加入人类偏好
多任务监督之后,T0作为同期路线检验多模板稳健性,InstructGPT再引入同请求下的偏好比较。提示分布、训练数据与反馈类型应分别作为控制轴。
自测与答案
1. 为什么FLAN用监督数据训练,还能称为零样本学习?
零样本是针对评估的留出任务簇。模型用其他任务训练,但评估时没有该簇指令训练数据,也不依赖该任务的上下文示例。它不是完全无监督模型,必须交代迁移粒度。
2. 论文所有任务成绩是否来自同一个FLAN检查点?
不是。为严格留出不同任务簇,作者分别训练相应模型,再评估各自留出的任务。把成绩拼起来当作单一部署模型同时具备的纯留出表现,会误解评估设计,也低估复现预算。
3. 若增加数据集后效果提高,为什么还不能说任务多样性是唯一原因?
任务数量增加时,数据内容、相关性、混合比例和覆盖范围也改变。图6支持该顺序下加入任务有益,要隔离多样性,还需固定总数据和更新预算,比较相同数量的重复任务与不同任务,以及多个加入顺序。