054 · InstructGPT:让语言模型学习人更愿意接受的回答
论文:Long Ouyang等,Training language models to follow instructions with human feedback,2022。原始论文 · 全文。本文讨论论文中的模型与流程,不以此推断后续产品的内部实现。
先接住前作的问题
FLAN和T0学习指令的监督答案,却没有直接学习同一请求下人更喜欢哪份回答。本篇引入排序数据与奖励代理,再组合已有PPO更新策略;它不是新PPO,也未定义所有人的统一价值。
五个前置概念
五个前置概念:SFT用正确回答做监督学习;偏好模型预测两个回答谁更受欢迎;策略梯度提高高回报动作概率;KL散度衡量分布偏移;优势估计比较实际回报与价值基线,减少梯度噪声。
一、问题设定:续写能力怎样转成特定用户群体偏好的回答
输入是客户的摘要、问答、改写等指令,输出整段回答。对齐对象是约40位标注者及研究者通过筛选和指导规则表达的偏好,数据超过96%为英文;因此要检验的是这个使用分布上的回答改进,以及它对其它能力造成的代价。
在序列建模视角下,状态是题目及已生成前缀,动作是下一个token,结束标记或生成终止构成回合结束。论文从任务层面称其为上下文赌博机:给定提示,完成整段回答,得到一个最终奖励,没有长期外部环境交互。PPO实现仍需处理token级概率与价值估计。
与FLAN/T0的主要区别不是有没有自然语言指令,而是反馈形式和分布。SFT拟合人写的好回答,奖励模型学习相对排序,PPO则在当前策略会生成的回答上优化。它依赖一个关键假设:学到的排序信号在策略更新后仍能代表人的评价。这个假设只近似成立,正是KL约束和独立人工评估不可少的原因。
二、拆开示范、成对奖励与受约束策略目标
示范学习与偏好学习
第一阶段用人工示范做最大似然训练,得到SFT策略。第二阶段对同一提示收集4—9份回答的排序,把优选回答与较差回答组成比较。奖励模型输出标量,核心损失为
为sigmoid,分数差决定人偏好前者的预测概率。奖励的绝对零点不能由这种损失确定;两份回答同时加常数不改变排序。因此高分不是经过校准的事实正确率,也不等于人类满意度百分数。
同一提示产生的多对比较高度相关。作者把该提示下全部比较放在一个批次元素内处理,避免将重复回答当作独立新数据反复更新。这既减少前向计算,也缓解过拟合。
PPO、KL与预训练混合
设当前策略为,固定参考为,PPO-ptx追求的目标可写作
第一项提高奖励,第二项的期望构成对参考策略的KL惩罚,第三项继续拟合预训练文本。控制偏移,控制预训练保持。普通PPO变体令,文中默认InstructGPT通常指PPO-ptx。
策略负责生成;固定参考模型给出KL基准;固定奖励模型评价完整回答;价值模型预测回报以构造优势、降低策略梯度方差。奖励模型和价值模型不是一个持续共享所有参数的角色:价值模型从奖励模型初始化后参与PPO训练,奖励模型保持作为反馈函数。
PPO的裁剪限制一次更新中相对于采样策略的概率比变化,KL项限制相对于SFT参考的偏移,二者不能混为同一约束。这里没有声称KL能够证明模型绝不钻奖励漏洞。
单条样本的KL惩罚可以为负
固定提示 ,记当前策略为 、参考策略为 、生成的整条响应为 ,且相关概率为正。采样项为 ;只有按当前策略π取期望才得到非负的 。自回归下该log比可分解为各token log比之和,所以能形成逐token惩罚。reference通常是冻结SFT策略;PPO比率中的old policy则用于限制一次策略更新,两者职责不同,不能合成一个“旧模型”。
以下为自构例子:要求“将这段通知压缩为两句话,不增加信息”。SFT展示一份合格摘要;偏好数据把准确两句话排在流畅但添加日期的回答前面;奖励模型学到这种区别;PPO提高生成前者的倾向。
一条负KL采样项怎样仍组成正散度
自构当前两答案分布为(0.8,0.2),参考为(0.5,0.5)。第二答案的log比为log 0.4,约−0.916;第一答案约为0.470。按当前策略加权,期望约0.8×0.470−0.2×0.916=0.193,仍为正。实现检查应对同一采样回答重算参考概率,而不是让参考另抽一句再相减。
教法联系:Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla的Illustrating Reinforcement Learning from Human Feedback。算例为本文自构。
三、追踪策略、参考、奖励和价值四个模型的更新
输入:预训练模型、人工示范、同题回答排序、未标注指令
SFT策略 ← 拟合示范回答
奖励模型 ← 用成对排序损失训练
当前策略、固定参考 ← SFT初始化
价值模型 ← 奖励模型初始化
重复PPO更新:
    从指令池抽取提示,用当前策略生成回答
    计算最终奖励和每token相对参考的KL惩罚
    用价值模型估计优势
    对策略执行裁剪PPO更新,对价值模型回归回报
    PPO-ptx同时累积预训练语言建模梯度
在留出客户提示上收集独立人类偏好评价
四、把偏好胜率、事实错误与能力退化分轴读图
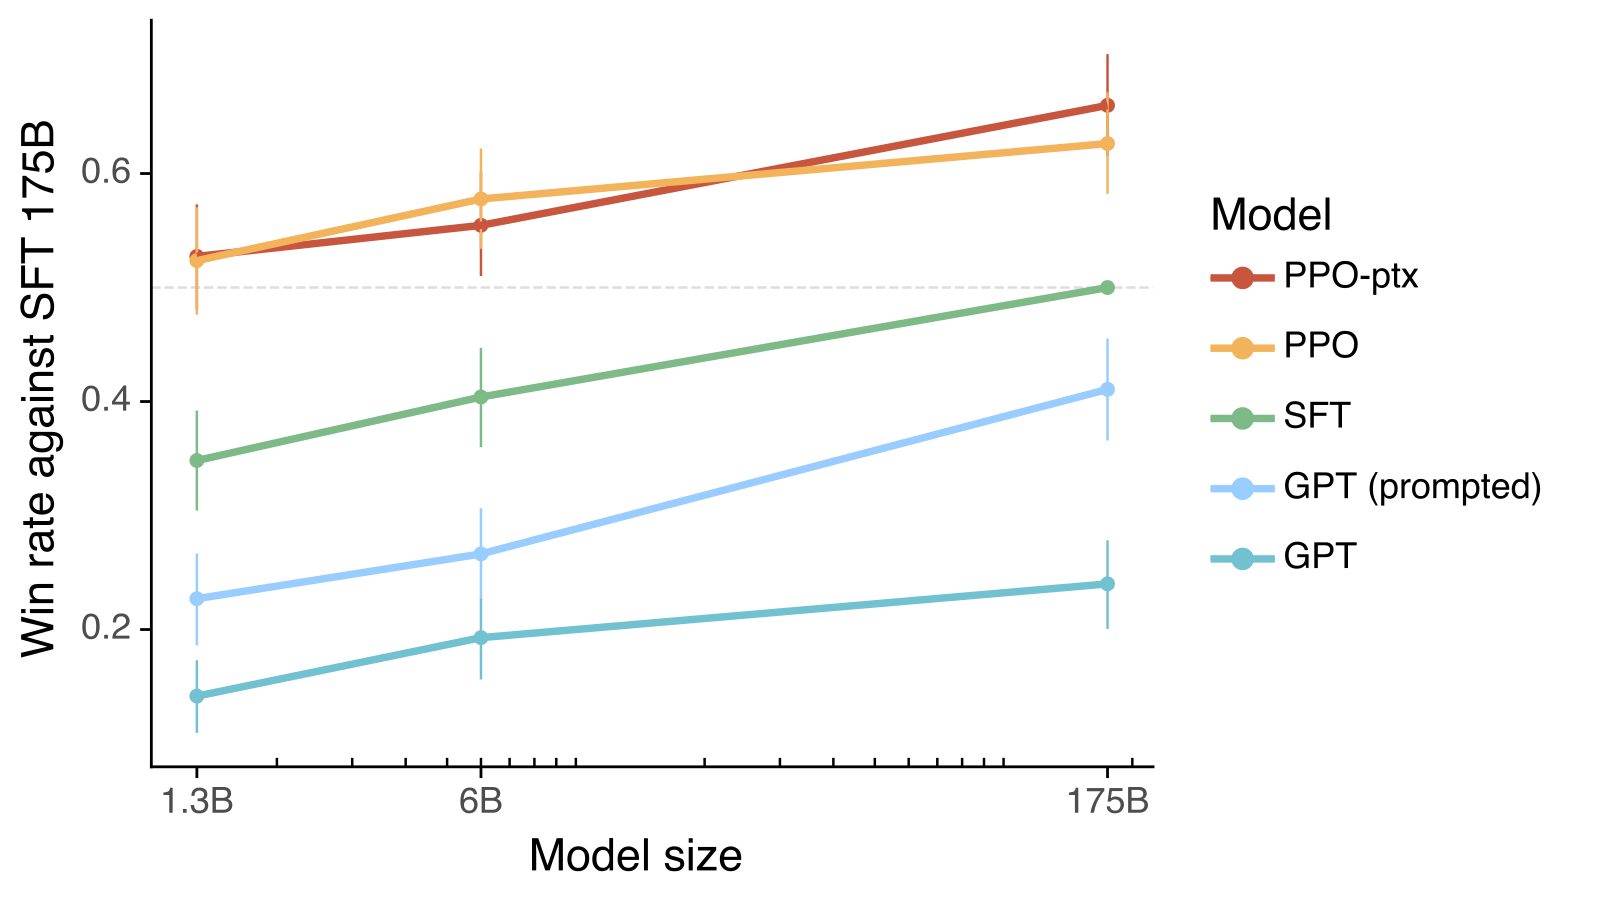
图1的统一对手是175B SFT;把直接成对胜率另列,再读幻觉、留出标注者与公开任务,避免把偏好当正确率。
| 项目 | 原文设置及含义 |
|---|---|
| SFT数据 | 表6:11,295条标注者提示、1,430条客户提示,共12,725;不是所有数据都直接来自客户 |
| 偏好数据 | 6,623加26,584,共33,207个提示;每题4—9回答,比较对数大于提示数 |
| PPO提示 | 31,144个训练提示,无逐条人工目标回答;奖励由已训练RM产生 |
| 模型规模 | 策略1.3B、6B、175B;各策略使用6B奖励模型及6B价值模型 |
| SFT配置区别 | 报告的SFT基线训练16轮;PPO初始化模型按附录C.3训练两轮并混入10%预训练数据,不能合并成一个检查点 |
| RM训练 | 附录C.2:一轮,64个提示/批,学习率9e-6;多轮容易过拟合 |
| PPO预算 | 附录C.4:256K回合,512回合/批、64小批、一次内部轮;温度1,裁剪0.2,KL系数0.02 |
| PPO-ptx | 使用比RL回合多八倍的预训练样本,梯度系数27.8;增加训练工作量 |
| 评价与区间 | 留出客户提示、人类偏好、指令约束、TruthfulQA及公开NLP指标;论文误差条为95%置信区间 |
客户划分降低同一用户提示跨训练测试的泄漏;留出标注者检验部分评价迁移,但仍来自相同供应商,不能代表全球用户群。训练与最终评价对帮助性、真实性、无害性的优先级也不完全相同,需保留原文§3.4的这一设计边界。
证据一:图1与§4.1的直接偏好。 175B InstructGPT相对175B GPT-3获偏好85±3%,相对经过少样本提示的GPT-3为71±4%。这些是同一提示上成对评价的胜率,不是回答正确率。图1常用175B SFT作为统一对手,不能把图上纵轴与85%的直接比较混用。 偏好曲线的参照是175B SFT,误差条为95%置信区间。纵轴是相对该参照的偏好胜率,不能读成事实正确率。
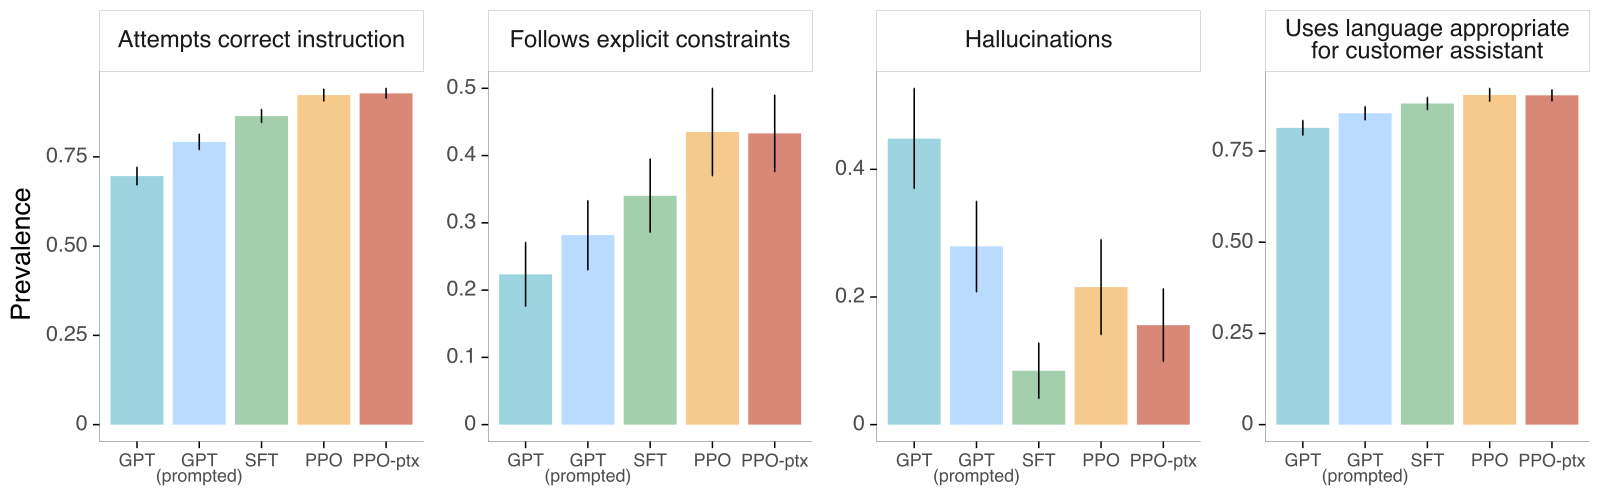
证据二:图4的行为指标。 封闭领域任务中,编造输入未给信息的比例约从41%降到21%,降低20个百分点,按原值计算相对下降约49%。图4汇总不同模型规模,且“幻觉”限定于摘要、闭域问答等场景,不能宣称所有开放知识问答幻觉减半。
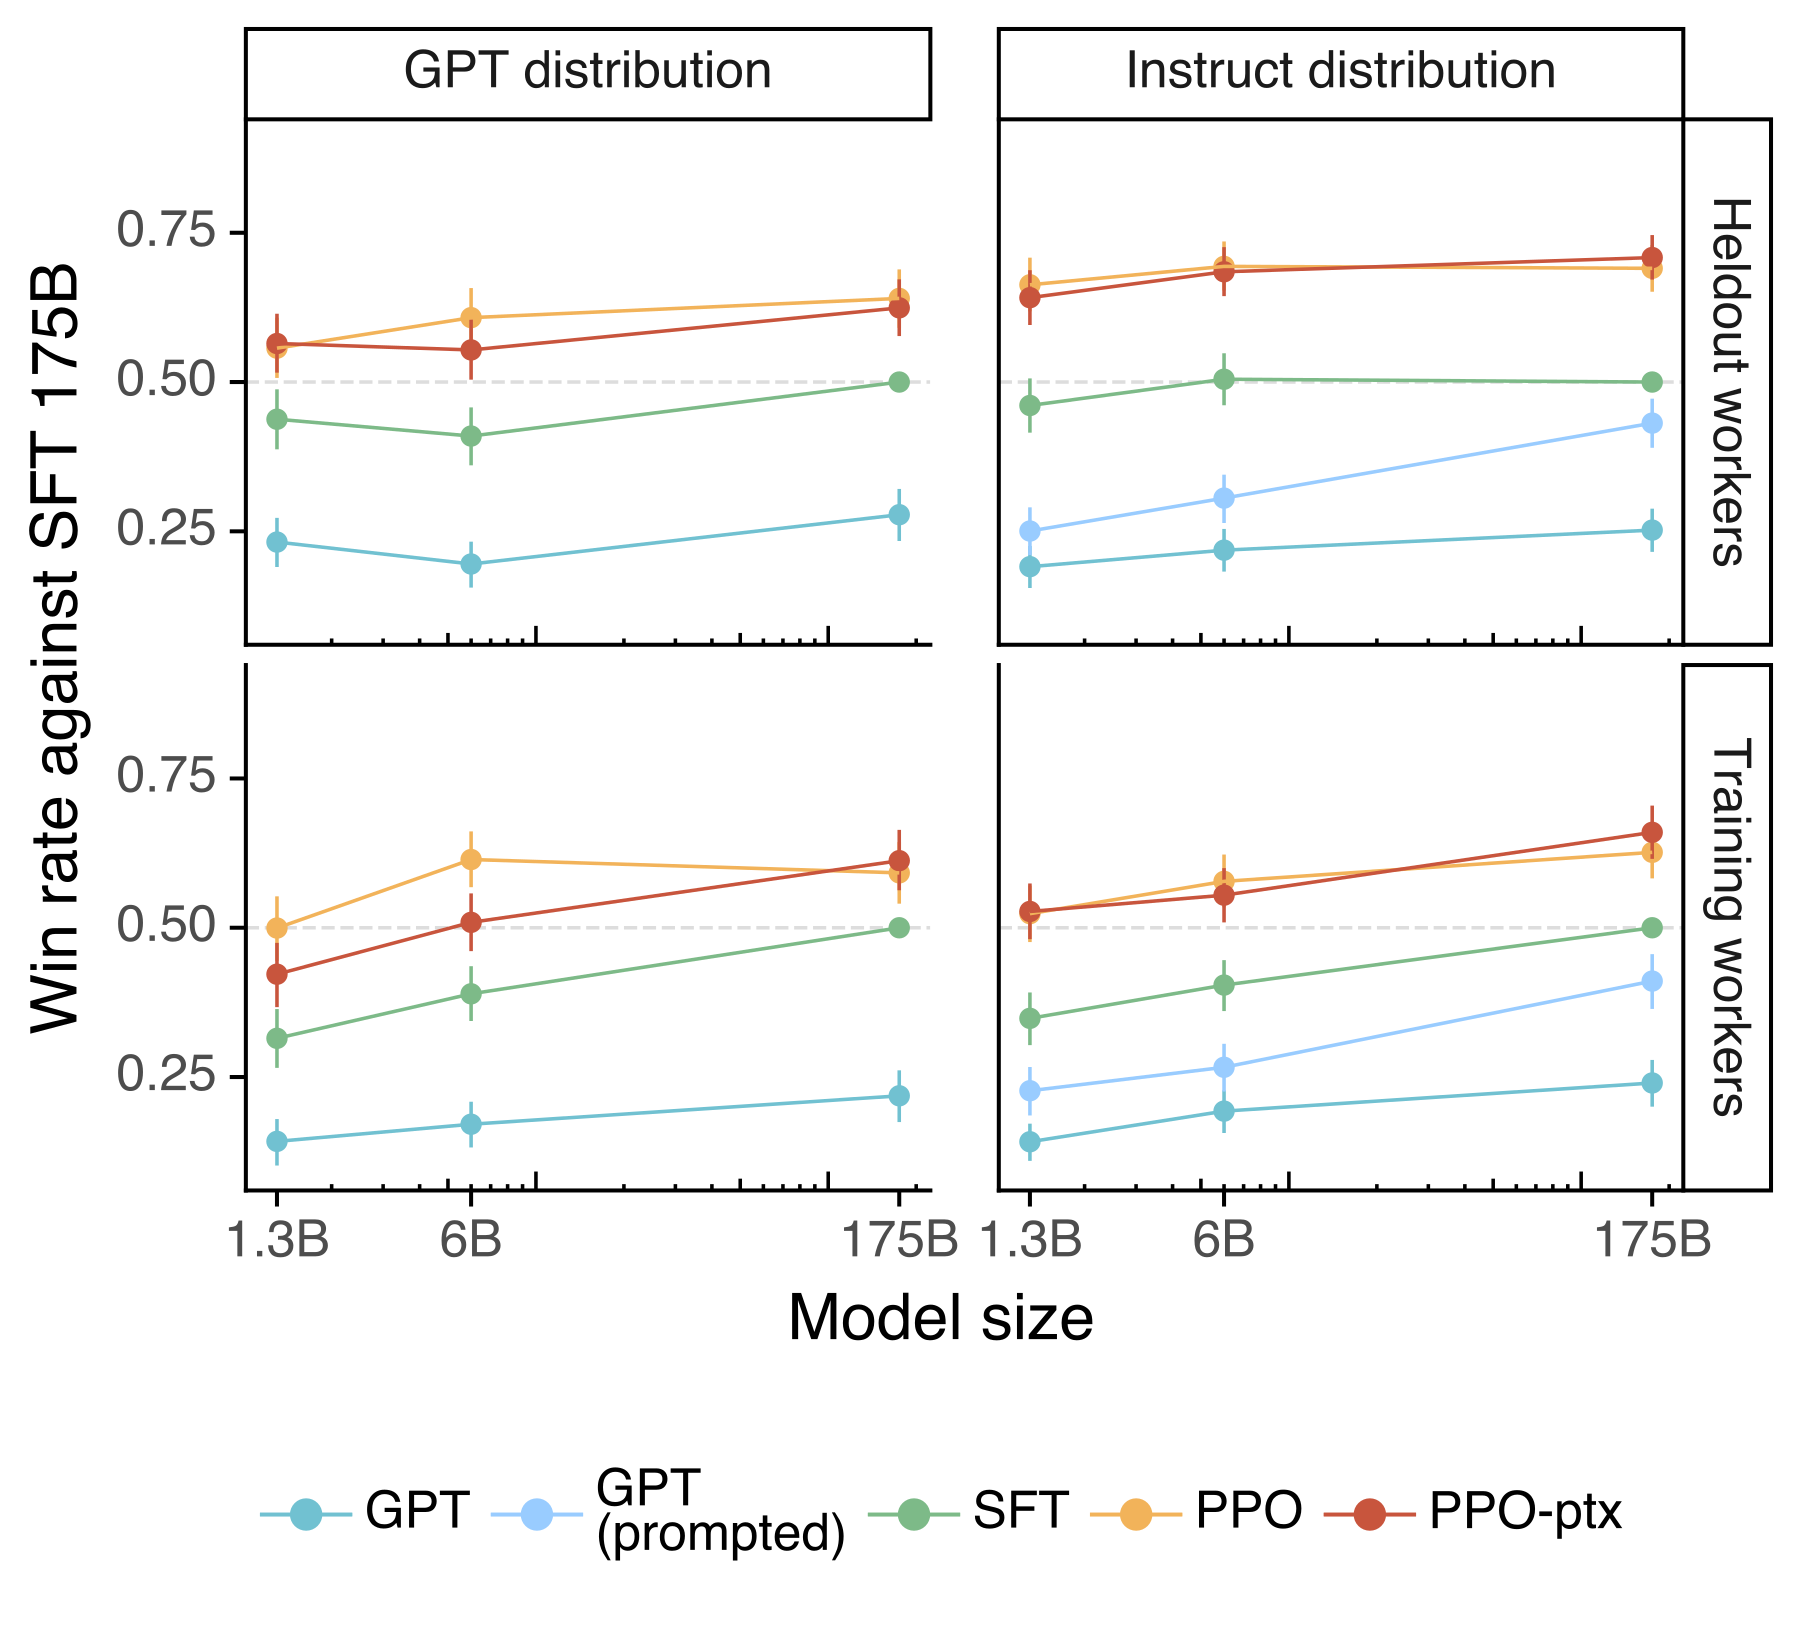
证据三:图3及§4.1的评价者迁移。 留出评价者仍偏好InstructGPT;五折评价者划分中的奖励模型,在留出组预测准确率69.6±0.9%,训练来源组为72.4±0.4%。这支持有限群体迁移,同时说明偏好预测远非完美。它不能排除更大文化、语言或专业群体上的分歧。
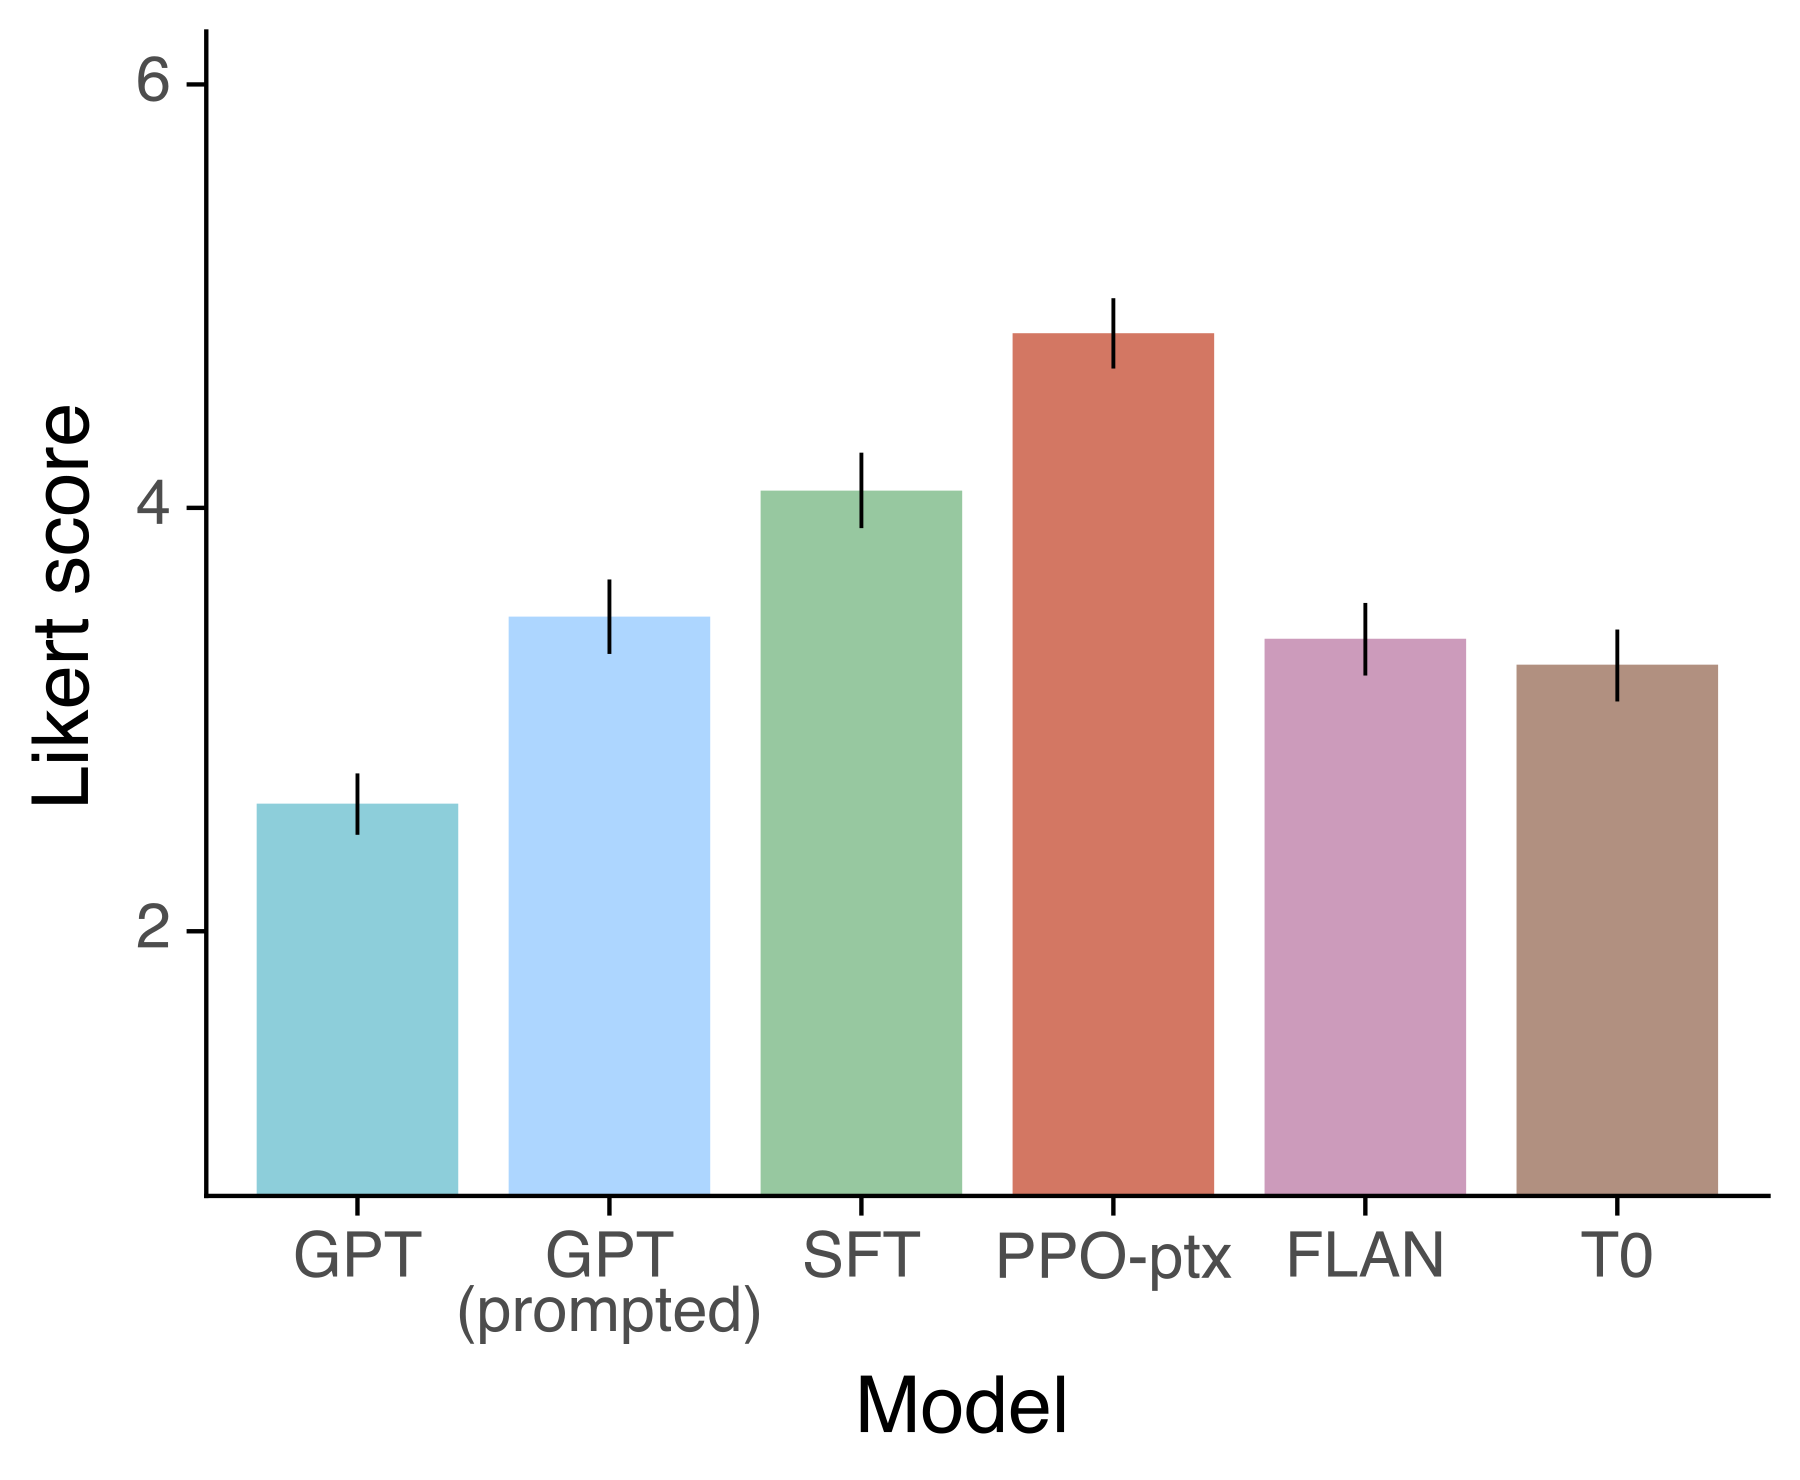
证据四:图5与附录C.5的数据分布对照。 直接比较时InstructGPT对作者训练的FLAN数据模型胜率78±4%,对T0数据模型79±4%。这些对照是用相关数据微调175B GPT-3的版本,并非原论文所有模型和训练预算。结果支持API任务分布适配的重要性,不能概括为偏好学习普遍优于多任务训练。
证据五:§4.2的能力代价与负结果。 PPO在SQuAD、DROP等公开任务出现退化,混合预训练梯度可缓解;TruthfulQA整体有改善,但1.3B PPO-ptx是例外。Winogender、CrowS-Pairs未显示显著改善。它说明行为对齐具有多目标权衡,而非一个总分提高就自动修复偏见、知识和可靠性。
教学算例。 某回答在当前策略概率0.1、参考策略0.2,单样本log比为 ;减去它反而增加该样本塑形回报。这不违反KL非负,因为其他更被当前策略偏好的回答贡献正log比。比较奖励变化时,应同时看原奖励、KL期望和人类偏好。
五、代理奖励、群体选择和私有数据限制复现
如果奖励模型只学到“两句话看起来很整齐”,可能给内容错误的两句话高分。因此应该另测事实保持、字数约束和人类整体偏好,不能只看奖励曲线。这个例子说明代理指标与真实任务之间的缝隙,不是论文中的真实样例。
创新主要是系统化的数据和训练组合、跨规模证据以及对能力退化的处理,不是发明PPO本身。
主要代价包括示范与排序标注、同时维护策略/参考/奖励/价值模型、额外预训练梯度,以及奖励模型被策略过度优化的可能性。输出更合评价者口味,也可能意味着更会迎合风格;如果评价者未能识别错误,错误信号就会被放大。
公开论文披露了关键流程和预算,但完整客户数据、私有检查点与标注条件并不等同于可完整重建的公开实验。作者明确承认模型仍会编造、误解指令、给简单问题冗长回答及未识别错误前提。这里的安全性是有限评估结果,而非形式保证。
六、沿偏好目标寻找不需在线PPO的训练路径
奖励代理与在线PPO可被另一种优化路径替代。DPO在特定偏好假设下直接用离线回答对训练;继续核对其数据覆盖与参考分布条件,而非把省去奖励网络理解为省去所有偏好假设。
自测与参考答案
1. 奖励模型和价值模型有什么区别?
答案:奖励模型预测完整回答获得的偏好分数,在PPO中充当固定反馈函数;价值模型预测从当前前缀继续生成的回报,用于优势估计并随训练更新。相同初始化不意味着职责相同,也不意味着价值预测就是人的偏好标签。
2. 为什么PPO裁剪之外还需要相对SFT的KL项?
答案:裁剪关注当前更新相对产生样本的旧策略,连续很多小步仍可能走得很远。KL项持续参照固定SFT分布,约束累计偏移。二者都不能保证奖励真实,只能缓解更新与分布偏离方面的问题。
3. 85%的偏好胜率能否解释为85%的回答正确?
答案:不能。它表示在所测提示与评价者条件下,一份回答比对手更受偏好。两个回答都错时也可能分出高下;偏好还包含格式和有用性。应分别报告事实核查、任务成功、拒答或遗漏以及不同人群评价,明确比较对象。