075|DPO:把奖励模型藏进概率比,直接学习偏好
论文:Rafael Rafailov 等,Direct Preference Optimization: Your Language Model is Secretly a Reward Model,首次公开于2023年。论文、正文 v3。本文采用2024年更新的 v3。DPO 属于直接偏好优化,不能只因名称带“策略优化”就把它等同于 PPO 式在线强化学习。
图表来源:Rafael Rafailov 等,2023,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
InstructGPT先拟合奖励,再在线采样并用PPO更新策略。本篇在特定偏好模型和KL正则目标下重参数化这条路径,追问能否直接使用已有偏好对;它改变优化方式,RLAIF改变标签来源,两者可组合。
五个前置概念
五个前置概念:成对偏好只确定两项相对排序;参考策略定义改变的基准;KL散度度量策略分布偏离;配分函数把未归一分数变成概率;奖励等价类表示只差问题相关常数的奖励具有相同偏好和最优策略。
一、问题设定:已有偏好对时,怎样直接训练策略而不再拟合奖励网络
一对回答只给相对喜好,不给绝对正确奖励。若显式奖励只作为训练策略的中间表示,能否把它消去?本篇先给出最优策略与奖励的对应条件,再将对应式代入偏好似然,最后检验简化训练的效果。
二、从KL正则最优策略消去成对损失中的配分函数
训练数据为 :问题 、被偏好的回答 、较不被偏好的回答 。这不意味着 完美,也不意味着 完全错误;只表示在这一对中,标注者更喜欢前者。
Bradley–Terry 模型把偏好概率写成奖励差的 sigmoid:
这种模型假设偏好可由标量效用差表达。现实中的偏好冲突、群体差异和非传递选择不一定完全符合它。论文以此作为建模前提,而不是证明人类偏好天然服从该形式。
语言模型的策略 是整段回答的条件分布。参考模型 通常来自 SFT,用来定义模型改变的起点。本文的经典离线设定不需要环境交互;生成过程可以看作逐token决策,但训练利用的是固定完成序列的似然。
从常见 RLHF 目标出发:
控制偏离参考策略的代价。给定奖励、允许优化整个策略分布时,最优解满足:
对同一个问题的所有回答相同。在比较 与 时,两个 抵消。因此只需要概率比,不必对巨大回答空间求和。
定义单个偏好对的 margin:
这就是论文式7。它不是“只提高好答案概率”,而是增加相对于参考模型的成对概率优势。每条回答的 log probability 是回答 token 对数概率之和,不能随手换成平均每token概率却仍宣称实现原始目标。
梯度包含权重 :已经很好地区分的偏好对更新较小,排序错误的偏好对更新较大。它与朴素地无休止降低坏答案似然不同。由于参数共享和归一化,不能把单步梯度直觉提升为“每个赢家的绝对概率在实际训练中都必然增加”。
§5的引理1、引理2说明:给同一问题的所有回答奖励加同一个函数 ,既不改变 Bradley–Terry 偏好,也不改变 KL 正则下的最优策略。定理1利用这个奖励等价类,解释为什么可以选择对数概率比形式而不损失相应表示能力。
附录的命题还要求参考分布在相应回答上为正等条件。理论是关于分布、奖励和可表示性的关系,不是神经网络非凸训练的全局收敛定理。有限数据未覆盖的回答、参数化模型容量不足、标签噪声和优化误差,都可能使实际结果偏离理想最优解。
此外,DPO损失中没有再显式逐批计算一个完整KL惩罚项,但参考策略与 已进入重参数化。对固定奖励的解析最优策略而言,较大 更保守;对有限数据训练过程,不能仅看损失中 乘在梯度外面,就推断实测KL一定如何变化。
成对概率优势没有确定第三种回答的去向
对固定提示和一对回答,DPO 损失只看到相对参考策略的对数概率比之差。若只考察这一对,当前策略同时把赢家、输家的概率乘以同一个正数,其比值不变;剩余概率可以转移给未观察的回答,而这一对的损失完全不变。这是有限偏好覆盖的可辨识性问题,不与奖励等价类的理论矛盾。
另外, 的作用是按当前分离程度重新加权数据:在 时,梯度外部系数分别约为 。这些是同一损失的局部权重,不是策略更新的完整长度,因为回答的参数梯度、批内其他偏好对和优化器仍参与更新。
自构三答案反例。 参考策略对赢家、输家、未标注答案的概率为 。策略 A 为 ,策略 B 为 。对这一个偏好对,两者的参考校正概率比都是 2,所以都有 ,DPO 损失相同;但 B 的赢家概率只有 A 的一半。因而验证偏好优化时,除 pairwise accuracy 以外,还应检查实际生成分布、未覆盖答案和任务指标,不能从训练损失下降推出所有好答案的绝对概率都上升。
自构例子,未运行: 参考模型给A和B的概率为0.2、0.1;当前模型为0.3、0.1。若偏好A,未乘β的margin是 。模型已经相对起点更偏向A。若两者都变为原来的0.5倍,比值优势不变,这也说明DPO关注成对相对变化,而不是保证A绝对概率增加。
同一问题的常数抵消只发生在同一条件下
给同一问题的两个候选奖励都加7,成对奖励差不变;最优策略中的归一化常数也会共同改变并抵消。若两个候选来自不同问题,这两个问题可有不同常数,便不能直接消去。构造偏好batch时应检查赢家、输家确实共享同一提示,而非只看回答字段数量匹配。
教法联系:Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla的Illustrating Reinforcement Learning from Human Feedback。算例为本文自构。
三、用参考校正的概率差执行离线更新
输入:偏好对 D、参考策略 ref、初始化策略 policy、β
freeze ref
for prompts, chosen, rejected in D:
    pw = sum_answer_token_logprobs(policy, prompts, chosen)
    pl = sum_answer_token_logprobs(policy, prompts, rejected)
    rw = sum_answer_token_logprobs(ref, prompts, chosen)  # no gradient
    rl = sum_answer_token_logprobs(ref, prompts, rejected)
    margin = β * ((pw - pl) - (rw - rl))
    loss = mean(-logsigmoid(margin))
    update policy parameters
输出:经过偏好学习的语言模型
提示和 padding 必须正确掩码,参考与当前模型的分词、聊天格式必须一致。参考 log probability 可在数据与参考模型固定时预先计算;这是实现上的优化,不改变目标。训练循环没有在线采样,并不意味着构建偏好数据从未生成过回答。
四、分开受控奖励前沿与模型、人类摘要评价
奖励—KL图检验优化,摘要胜率检验特定评委偏好;迁移后仍低于参考摘要的结果要与相对PPO提升同时保留。
| 维度 | 原文设置与证据口径 |
|---|---|
| 可控情感 | GPT-2-large;IMDb前缀2—8token;分类器产生可访问的实验奖励,不是人类情感质量的绝对真值 |
| 情感数据 | 25000前缀、每个4个完成、形成6个偏好对;对应150000对是由设置计算,彼此不完全独立 |
| 摘要 | GPT-J SFT 检查点;Reddit TL;DR 人类偏好;DPO、PPO、Preferred-FT共享该SFT起点 |
| 对话 | Anthropic HH约170K对话;Pythia2.8B先在chosen响应上SFT,再做DPO;评估单轮子集 |
| DPO超参数 | 附录B:通常β0.1,摘要β0.5;batch64,RMSprop学习率0.000001,150步warmup |
| 预算比较 | 情感扫描合计22次训练、每100步评估;PPO还使用训练中采样;没有给出统一硬件下覆盖所有任务的端到端等算力表 |
| 自动评价 | gpt-4-0314;响应顺序随机;摘要强调准确与简洁,对话评价有帮助程度 |
| 泛化 | Reddit训练后的摘要模型直接评CNN/DailyMail;是输入领域迁移,不是任意能力泛化 |
| 人工评价 | 表2不同比较收到272、122、199份评判;不能直接当作同样数量的独立训练重复或独立标注者 |
对话实验的 PPO 比较比摘要弱:作者尝试一个已有6B PPO模型,但未得到有效表现,于是把 best-of-128 当作粗略参考。这不是相同基座、相同训练预算下完整重跑的 PPO 对照,不能用来支持普遍的算法优劣排序。
证据一:图2左,奖励—KL前沿。 DPO在该情感实验中以较低偏离取得更高分类器奖励,甚至优于直接获得分类器奖励的 PPO-GT 配置。它支持这组实现中优化方式有效,不证明分类器奖励与电影评论真实质量完全一致,也不证明PPO在理论上达不到同一前沿。 左侧是期望奖励与相对参考策略的 KL 前沿,右侧是 GPT-4 评审的摘要胜率。前者的受控优化证据和后者的模型评审证据应分开判断。
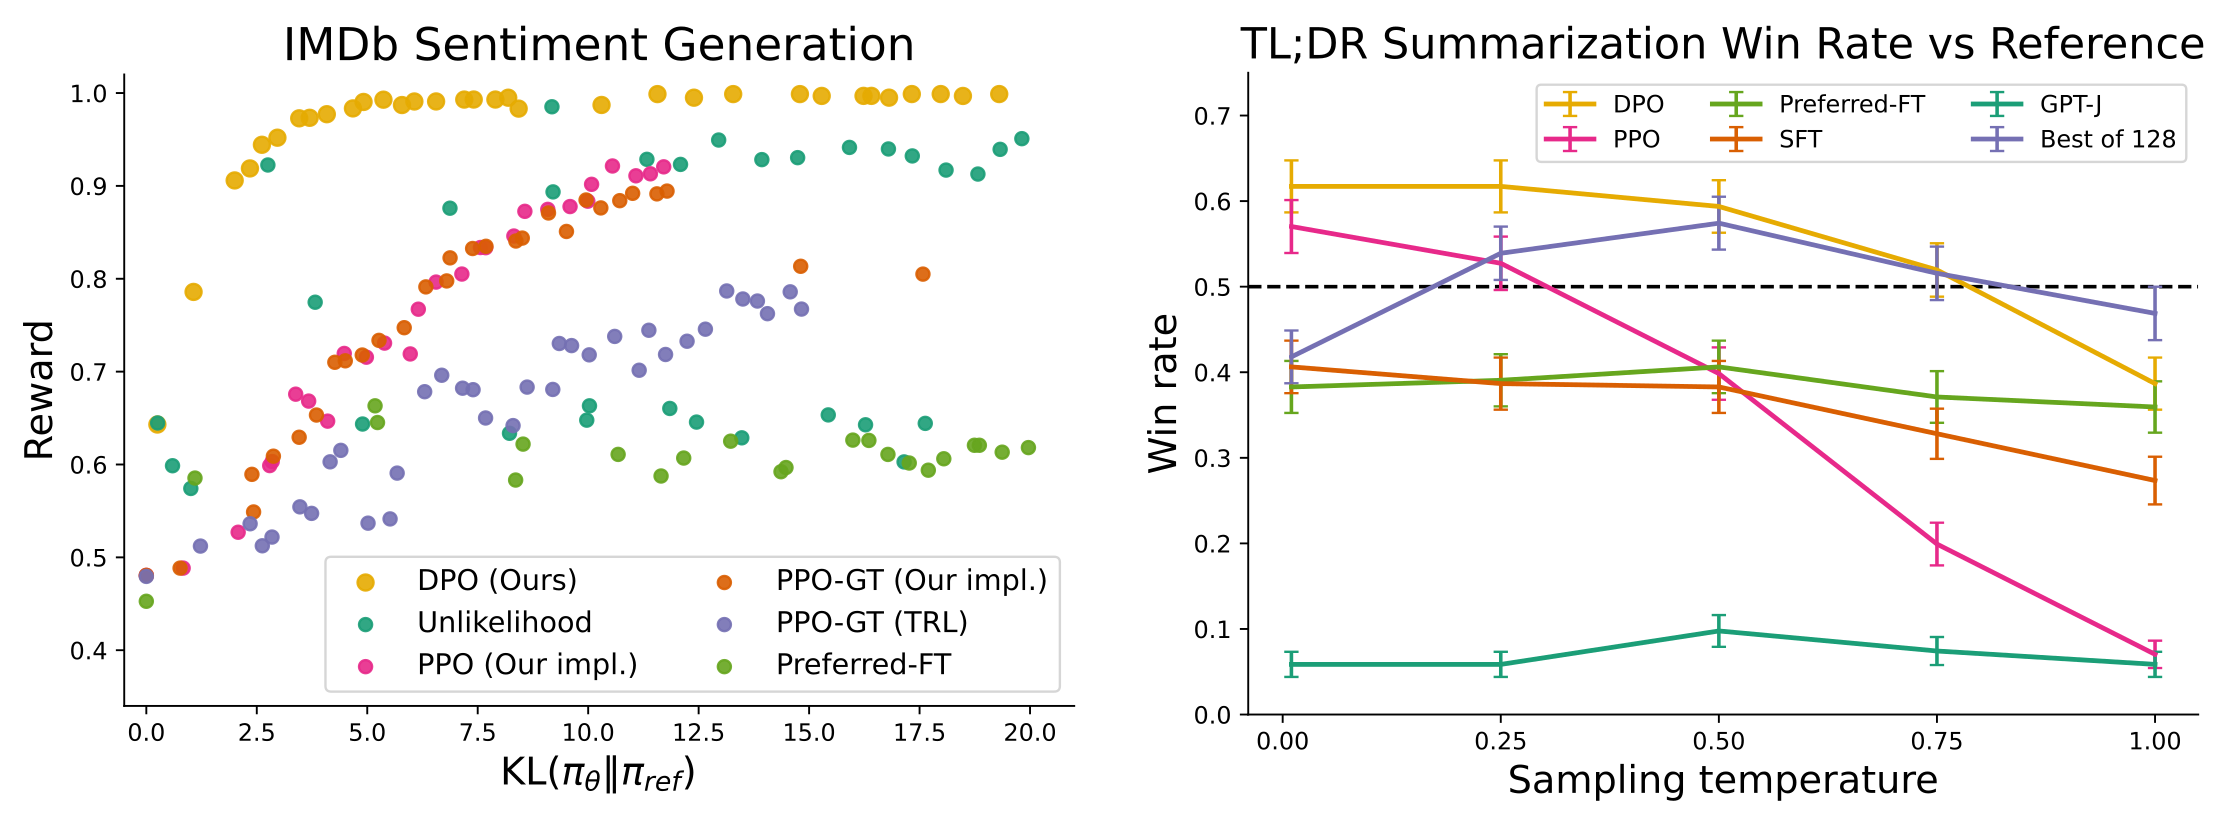
证据二:图2右与§6.2,摘要。 温度0时 DPO 对参考摘要胜率约61%,PPO约57%,绝对差约4个百分点。分数来自GPT-4评判,而非逐事实验证。不同温度下的曲线还显示该配置中的稳健性差异,不能忽略采样设置再比较一个最高点。
证据三:表2,人类与模型评委。 DPO温度0.25对PPO温度0,人类胜率58%;GPT-4简单提示为47%,强调简洁后为54%。评委提示会改变排名判断,单个自动分数不能作为无条件的真值。逐例一致率与人际一致率相近,是有效性支持,但不是所有任务都可靠的证明。
证据四:表1,迁移到新闻摘要。 温度0下DPO对新闻参考摘要胜率36%,PPO26%;温度0.25为31%和23%。DPO相对PPO更好,同时两者均低于50%,说明“优于另一个方法”和“优于目标域参考摘要”是两个不同命题。
证据五:附录C.3表3,朴素负似然的退化。 作者展示无约束压低 rejected 似然的方案产生大量重复、无意义文本。这支持DPO的动态权重与参考校正并非无关细节。不过示例和有限比较没有单独证明每个成分在所有数据集上都必要。
五、成对优势未决定未覆盖回答与绝对赢家概率
省掉独立奖励训练和在线采样循环,降低了工程复杂度,但仍需要两条回答的前向、策略反向、参考概率和高质量偏好标签。
作者将分布外泛化、过度优化和更大模型验证列为开放问题。进一步分析还包括:离线数据可能与更新后策略分布不匹配;更长、更讨好或格式更统一的答案可能获得偏好,而不一定更正确;仅优化相对优势可能把概率质量转移到未被比较的回答上。没有显式奖励网络,不意味着没有奖励投机或评价漏洞。
六、把偏好标签来源与优化算法作为独立设计轴
偏好优化与反馈来源可以分别选择。RLAIF研究AI标签与在线评分,后者并非本篇离线DPO。继续比较时先列出是否生成新回答、是否训练奖励网络、标签来自谁。
自测与答案
1. DPO 不训练独立奖励网络,为什么仍然可以谈“隐式奖励”?
答案:当前策略相对参考策略的对数概率比乘β可以表示一个奖励等价类的成员。它参与成对偏好概率,并对应KL正则目标的策略。但这个值不是独立的事实正确性评分,也不能跨任意参考模型直接比较。
2. 配分函数为什么能消掉?如果两个回答来自不同问题还可以直接抵消吗?
答案:同一个问题的两个奖励都有相同的βlogZ(x),相减为零。不同问题通常有不同Z,因此不能直接利用同样推导消掉。原始DPO数据对必须共享提示条件。
3. “DPO 与 RLHF 目标等价”是否说明不用探索也能学到所有最优回答?
答案:不能。等价推导说明在假设下如何连接奖励和最优策略,数据没有覆盖的区域仍然缺少约束,有限模型也未必达到全局解。应检查偏好覆盖、更新后生成分布与真实评价,而不是把公式当作离线数据充分性的证明。