080|RLAIF:让模型提供反馈,能否得到人更喜欢的回答?
论文:Harrison Lee 等,RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback,首次公开于 2023;采用2024 年 v3,其中包含新增的直接反馈实验。论文也指出服务模型版本变化会影响精确复现。
图表来源:Harrison Lee 等,2023,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
Constitutional AI已经把AI反馈接入训练,本篇进一步系统比较AI与人类反馈,并尝试省去奖励蒸馏。它仍用强化学习;DPO直接优化离线偏好损失,二者的“直接”指向不同环节。
五个前置概念
五个前置概念:软标签保存偏好的不确定性;奖励蒸馏把评审判断压入较易调用的模型;策略梯度按回报调整采样概率;价值基线降低梯度方差;分布偏移表示优化后回答不同于旧奖励训练样本。
一、问题设定:AI评判能否替代部分人工比较而维持最终人评
摘要输入原文,对话输入历史;策略逐token行动,结束后接受序列奖励。附录E把文本转移写成有限时域确定性MDP:给定当前文本和新token,下一文本状态确定。需要检验的是反馈来源及蒸馏方式如何改变最终回答,而不是换一个任务定义。
RLAIF 中的 “AI” 描述反馈来源,不指定必须使用 PPO。本文实际上采用带价值基线的 REINFORCE。类似地,RLHF 不等于某一个固定优化器;一个系统可以改变反馈来源而保留优化流程,也可以保留反馈来源而更换优化算法。
研究的核心假设是:语言模型在“判断哪个更好”时拥有有用信息,即使它一次性生成时未必稳定表现出来。判断任务和生成任务的条件不同,因此同一模型作为评价者提供学习信号并非逻辑矛盾。但同一个模型也可能在生成与判断时重复犯相同错误。
二、把换序软标签与策略梯度的信号分别定义
给评审模型上下文、两个候选和评价准则,读取它生成选项 1、2 的概率,并归一化成软标签。若模型认为候选 A 的偏好概率为 0.6,保留这个不确定性比硬写成“A 完全正确”更细致。
为了处理位置偏差,对同一对候选交换顺序再评一次。令 为 A 排第一时被选中的概率, 为 B 排第一时 B 被选中的概率,则 A 的平均偏好为
这里必须先把两个输出映射回同一候选身份;直接平均两次“选择第一项”的概率会犯方向错误。交换顺序只能缓解位置影响,不会修复对内容的一致误解。
令奖励模型对两候选的分数为 ,预测偏好 ,软标签训练损失是
之后用奖励模型打分当前策略的回答。附录 E 的策略梯度核心可写为
是完整回答的奖励, 估计未来回报,优势项不通过策略损失反向传播。由于中间任务奖励为零、折扣为 1,各时刻的任务回报都是最终奖励;价值模型以平方误差学习基线。完整目标另外加入相对 SFT 的 KL 约束。损失变化不直接等于人类偏好改善,后者必须重新测量。
传统 RLAIF 的奖励模型只在静态候选上训练。策略逐渐变化后,它可能面对新的回答分布。d-RLAIF 直接让现成语言模型给当前回答评分,绕过单独训练的奖励模型。
评审被要求给 1—10 分,利用分数分布计算期望
第二式展示将分值线性映射到 的教学写法。它保留分布信息,不只是贪心读出一个整数。该分数依然是代理信号,不能因为它来自大模型就叫“真实奖励”。在线评审不经历单独奖励模型的陈旧训练集问题,但评审本身仍可能在新分布上失效。
两次换序评判必须先把标签映射回候选身份
设第一次提示按 A、B 排列,模型给“选第一项”的概率为 ;第二次按 B、A 排列,对“选第一项”的概率为 。那么 A 的平均偏好概率是
而不是 。这里概率应先在两个有效标签上按方法归一化,再映射回同一个回答。论文用软偏好信息训练奖励模型,保留了评委的犹豫程度;把它先阈值化成硬标签会丢掉信息。
换序平均针对位置偏差,并不自动消除长度偏好、文风偏好或共同事实错误。两个判断来自同一个模型,也不能当成两个独立专家的证据。反馈生成预算则确实增加了,需要与后续奖励蒸馏、在线策略更新成本一起记账。
自构例子。 两个摘要都没有事实错误,一个漏掉结论,一个保留结论却语句生硬。评审有能力识别覆盖差异,但生成策略经常漏结论;反馈学习可以把策略推向更完整的回答。若评审只喜欢更长的摘要,策略也可能学会重复细节。因此需要固定长度比较、事实一致性检查和独立人评。这是教学设想,不是论文中的样本实验。
换序后先还原身份,再平均偏好
第一次A在前,选第一项概率0.8;第二次B在前,选第一项概率0.6。A的换序平均应为(0.8+0.4)/2=0.6,而不是0.7。这个检查只校正候选身份与位置交换的组合;若评委两次都因冗长而偏爱A,平均不会移除长度偏好。
教法联系:Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla的Illustrating Reinforcement Learning from Human Feedback。算例为本文自构。
三、比较奖励蒸馏和直接在线反馈两条执行路径
输入:初始策略、训练提示、成对候选、评审模型和准则
若采用标准 RLAIF:
    正序和反序分别评价候选,映射回候选身份后平均
    可先让评审解释依据,再读取选项概率
    用软偏好交叉熵训练奖励模型
重复强化学习更新:
    当前策略从训练提示生成回答
    标准分支:奖励模型打分
    直接分支:现成评审在线输出分数分布并取期望
    计算带价值基线的策略梯度,加入相对初始策略的 KL 约束
    更新策略与价值模型;评审不随此梯度更新
在独立测试提示上,由人类评价最终策略
输出:经过反馈学习的策略
这与 DPO 的区别很明确:d-RLAIF 的 “direct” 是直接从评审获得奖励,它仍然采样并做强化学习;DPO 则把成对偏好转成直接训练策略的目标,不需要这一在线奖励循环。
四、结合长度调整、评委一致性与最终策略评价
先看最终人评是否有差距,再看长度调整与评委偏差;未显著不同不能代替预先设定等价范围的证明。
| 项目 | 原文信息与解释 |
|---|---|
| 任务数据 | 附录 C:TL;DR 约 123K 帖子;摘要偏好总计约 92K 对;Helpful/Harmless 各超过 40K 训练样本 |
| 评审 | 默认指令调整的 PaLM 2 L;同尺寸与直接反馈使用 XS。确切参数数目未披露为可复现实验配置 |
| 策略与奖励模型 | 均基于 PaLM 2 XS;摘要策略先做任务 SFT,其余以指令模型为起点 |
| SFT 与 RM | 附录 F:摘要 SFT 批量 128、1 epoch;RM 2—3 epoch;Adafactor、学习率 |
| RL 预算 | 附录 F:批量 128、学习率 、8 epoch、采样温度 0.9、KL 系数 |
| 标注提示搜索 | 在下采样约 3—4K 样本上比较提示与人工偏好一致性;RM 则用完整训练划分,不能把两者规模混淆 |
| 人类评价 | 附录 I:约 2K 评价实例、6K 上下文回答对、每实例 3 位评价者;测试提示不用于训练 |
| 选择与不确定性 | 从 4 个高奖励候选检查点中结合模型评价和少量人工检查选择;报告显著性及标注一致性,未报告完整多种子训练分布 |
摘要的人工反馈 RM 和 AI 反馈 RM 初始化不同:前者从 PaLM 2 XS,后者从摘要 SFT。作者在验证集比较后作此选择,表6 也报告了差异。因此“只换标签、其他全部严格相同”不是准确描述。
人类摘要/有用性评价要求排序且不允许平局;无害性则逐回答判断是否无害。这两个指标不能放在同一个胜率分母里。训练后摘要还经过尾部符号清理,附录 H 将异常符号视为可能的奖励投机;最终人评对象因此不是完全未经处理的原始输出。
证据一|表1:最终人评接近,并不等于统计等价已证明。 摘要上 RLAIF、RLHF 对 SFT 的胜率分别为 71%、73%;直接比较 RLAIF 对 RLHF 为 50%。有用对话对应 63%、64%,两者直接比较为 52%。论文报告差异未显著偏离相当水平;这支持该规模实验中没有发现明显差距,不是预先设定等价界限的严格等价性证明。
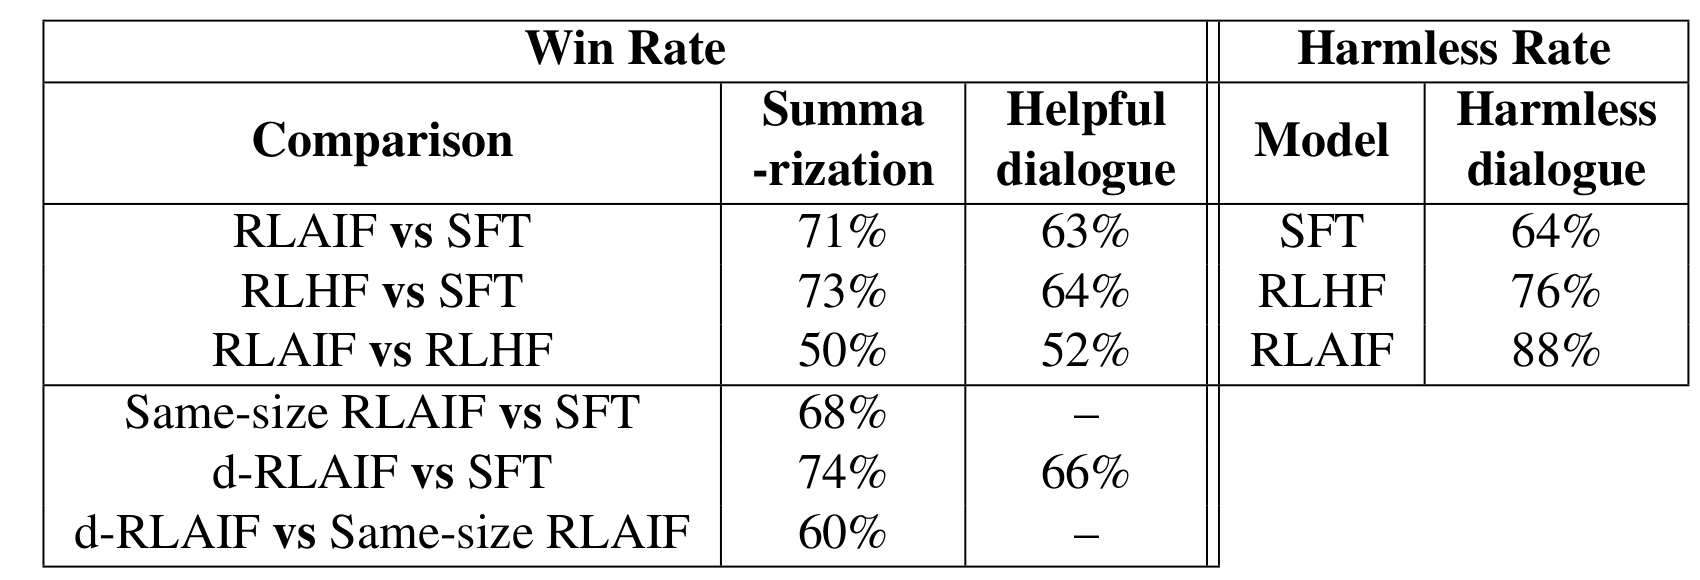
证据二|表8、表9、表10、表11:长度影响相当大。 摘要胜率经长度回归调整后,RLAIF 从 71% 变为 59%,RLHF 从 73% 变为 61%。仍高于 SFT,但表面提升明显收缩。该分析把长度比为 1 时的回归预测当作调整后胜率,依赖模型设定,不等于真正重新生成等长回答的随机对照实验。
证据三|表1 与 §4.3:直接反馈和同模型反馈可有效。 摘要 d-RLAIF 对 SFT 为 74%,对同尺寸标准 RLAIF 为 60%;长度调整后的后者为 56%。有用对话中,反馈模型与初始策略是同一检查点,最终对 SFT 胜率 66%。这支持特定任务中的自我改进行为,不证明无限迭代能持续变强。摘要的“同尺寸”两个模型经过的微调不同,不能冒充相同检查点。
证据四|表2、表4、表5:评审正确率不是单一总开关。 摘要 Base 0-shot 的人工一致率为 76.1%,加 CoT 后 77.5%;详细 8-shot 反而为 69.8%。位置交换后仍偏爱同一位置的比例,XS 为 56%、L 为 18%。同时表5 的摘要 RM 人工偏好准确率,人工反馈为 79.3%、AI 反馈为 74.2%,但最终策略的人评接近。提示更长、奖励模型离线准确率更高,都不自动推出更好的最终策略。
无害任务中,表1 的无害率为 SFT 64%、RLHF 76%、RLAIF 88%;这是是否无害的指标,不检验拒绝是否过多。另一个重要负例在 §3.1:Stanford Human Preferences 上,两条路径在控制长度后都未显著改善 SFT,说明结果依赖任务与数据。
自构换序例子。 A 在第一位置时获得 0.8 的选择概率;交换后 B 在第一位置得到 0.7,意味着 A 此时只有 0.3。映射后平均为 0.55,而错误地平均两个“第一位置”概率会得到 0.75,并把明显的位置偏差误当成强烈内容偏好。若这组数据进入软标签交叉熵,0.55 提供的是很弱的排序信号;它不应被描述成评委以 75% 的信心认可 A。
五、同尺寸反馈有效仍不证明无限自我改进
直接反馈可能避免一层蒸馏误差,也可能更好适应当前样本;这是作者的机制假说,实验没有完全拆开两种原因。
降低人工偏好标注需求不代表整个训练系统零人工:摘要示范、既有候选、人类准则、指令模型和模型选择都带有人类信息。直接评分则把部分离线成本移到每轮训练,需要计算评审模型。论文的历史标签成本估计不能当作今天的训练总成本报价。
六、分别优化反馈来源与偏好利用方式
AI反馈仍需选择优化方式。DPO提供离线偏好路径;若继续在线d-RLAIF,则须计评判调用和当前策略分布。两条路线的“直接”省去不同环节,不是互换名称。
自测:哪些结论真的能够带走
1. 为什么 d-RLAIF 不是 DPO?
答案:d-RLAIF 在线生成回答、调用评审获取奖励,再以策略梯度训练;“直接”表示省掉奖励模型蒸馏。DPO 通过成对偏好目标直接优化策略概率比,通常不包含这个在线奖励评分流程。名字相似不代表优化路径相同。
2. 同一检查点作为评审和初始策略,为什么还能改进?
答案:生成一个好回答和在给定回答后执行评价准则是不同条件任务。模型可能具备能识别却不能稳定生成的特征,反馈把这种识别能力转成生成偏好。但它无法凭空获得所有缺失知识,相关错误也可能被放大;论文只证明具体一次训练的改善。
3. 摘要胜率 71% 调整长度后为 59%,应如何报告?
答案:同时给出原始结果与调整方法,说明长度解释了部分优势,调整后仍有改善。不能删除71%或只展示它,也不能把59%当作已经完成的等长随机实验。更强验证应让候选长度受控,并检查事实、覆盖和可读性等具体质量维度。