065 · Constitutional AI:把行为原则变成修改数据与偏好标签
返回目录 · 上一篇:投机解码 · 下一篇:BLIP-2
论文:Yuntao Bai等,Constitutional AI: Harmlessness from AI Feedback,2022年。原始论文 · v1正文 · 官方原则、提示与样例。
图表来源:Yuntao Bai等,2022,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
InstructGPT用大量人类排序训练奖励代理;若要修改行为标准,重新标注会有成本。本篇沿同类偏好框架,把部分无害性反馈改为原则指导的AI批评与比较;有用性仍包含人类反馈,变化的是反馈来源而非取消监督。
五个前置概念
五个前置概念:监督微调模仿目标回答;偏好模型把成对比较变成分数;软标签保留偏好强度;红队测试主动寻找失败输入;Goodhart效应指过度优化代理指标后与真实目标脱节。
一、问题设定:自然语言原则怎样变成可训练的行为反馈
“减少伤害”是文字原则,不能直接对网络求导。它需要先被模型用于批评或比较具体回答,再变成监督目标和偏好标签;本篇检验这条转换链能否改善无害性与有用性的取舍,以及误差会在哪一层出现。
这种转换带来可扩展性,也带来误差。原则可能含糊,两个原则可能冲突,评判模型可能偏爱某种措辞,偏好模型还可能学到表面线索。最终策略优化的是学到的分数,并不是直接优化“原则的真实含义”。
论文还强调无害与回避的区别。对敏感问题一概给出空泛拒绝,可能在某些评分条件下显得安全,却不能提供有帮助的解释。研究目标是减少有害回答,同时避免用统一套话结束所有讨论。这里的评价标准有明确取舍,不能当成与文化和用途无关的客观常数。
将生成看成强化学习时,状态可理解为对话前缀,动作是输出token,轨迹是整段回答,偏好模型提供奖励。没有物理环境模型;训练中最核心的外部信号来自比较数据。Constitutional AI改变这些比较数据如何产生,而不是提出新的策略梯度定理。
二、分开监督修订与AI成对偏好两条转换链
从一个已经较有用的RLHF模型出发,对红队提示生成原回答。随机选取原则,要求模型批评,再根据批评改写。可以重复若干次,得到多个修订版本。
用于监督训练的是“原问题→修改后的回答”。批评是生成更好数据的中间过程,不必要求最终助手在每次回答前都公开一段自我批评。为了保留普通任务的有用性,训练集还混入有用性提示及对应回答。
教学化监督目标为
这里 是对话提示, 是被选入训练集的回答, 是助手。损失仍然是最大似然;新增机制是训练答案的形成方式。这一区分可以避免把“自我批评”误写成网络内部必然执行的一种新计算模块。
从监督阶段模型生成一对回答,给反馈模型提供对话、两个选项和一条原则。反馈模型对A/B给出概率,作为软偏好标签。再把这些无害性标签与人类有用性标签混合,训练偏好模型。
设软标签 表示偏好回答A的概率,偏好模型分数为 ,令
这是理解软比较训练的标准二元交叉熵写法。若两条回答差别很小,软标签可以表达不确定性;硬标签则把轻微偏好变成绝对胜负。最终RL使用偏好模型信号并沿用既有RLHF训练流程,不能将此式直接称为助手的全部RL损失。
论文还尝试让反馈模型先写CoT。这样可能改善判断,却会让随后A/B概率过于接近0或1。作者在该变体中把概率限制到0.4—0.6,以缓和极端标签。这个经验处理不是证明“真实偏好总在40%—60%”,而是在控制训练信号强度。
原则到行为之间有三处误差
文字原则先被评价模型解释,再变成批评或偏好标签,最后被学生与奖励优化吸收。原则表达含糊、AI判分失真、策略利用奖励漏洞是三个不同故障;只检查最终奖励上升无法定位。原文的起点还接受过人类有用性反馈,所以“AI反馈”不等于整个系统没有人类监督,减少的是某类直接有害性标注。
设问题要求助手对一个观点作尖锐批评。原回答包含人身攻击。原则可以要求批评论证而不攻击个人,修订于是保留对论据的反驳、删除侮辱。一个差的反馈模型可能仅凭“语气温和”选择空泛回答;一个较好的反馈应同时检查是否真正回应论点。这个自构例子说明多目标原则需要具体化,不能只把礼貌当成质量。
软偏好保留的不是绝对正确概率
AI标签认为A优于B的概率为0.6,奖励模型当前预测0.9,成对交叉熵对奖励差的梯度为0.9−0.6=0.3,会把差距拉小;若先硬化成A必胜,梯度则为−0.1,反而继续拉大。两者更新方向都可能相反,说明软标签的犹豫信息参与了训练,而非只改变显示分数。
教法联系:Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla的Illustrating Reinforcement Learning from Human Feedback。算例为本文自构。
三、记录原则、评判概率与人类有用性数据的混合
输入:预训练模型、有用助手、原则集合、提示数据
监督数据阶段:
    对红队提示生成初始回答
    重复:采样原则 -> 批评当前回答 -> 生成修订
    收集原提示与各修订回答
    混入有用性回答,监督微调得到SL-CAI
偏好数据阶段:
    用SL-CAI为每个提示生成两个回答
    采样一条原则,由反馈模型给出A/B软概率
    混合AI无害性标签与人类有用性标签
    训练偏好模型PM
强化学习阶段:
    从SL-CAI初始化策略
    生成回答,用PM评分,按既有RLHF流程更新
输出:经过原则反馈训练的策略
其中反馈模型、偏好模型和策略是不同角色。反馈模型负责依据原则标注;偏好模型将比较规则压缩为可高频评分的函数;策略负责生成。它们可能使用相近的基础模型,但不能因此省略角色差别。
教学审查。 原则要求既不协助危险行为,又尽量提供安全替代。候选A一句拒绝,候选B拒绝危险部分并给出安全方案,候选C表面拒绝却继续给危险细节。若裁判只抓“不能帮助”这几个词,A和C都可能高分。应把原则遵守、实质有用性与规避式回答分别标注,审计从原则到标签的转换。
四、分别读取有用性、无害性与多轮修订证据
先认清图3横轴是模型规模、图2才跟踪RL进程;Elo与绝对有害评分给的是不同证据,不能互换成风险百分比。
| 项目 | 原文设置与用途 |
|---|---|
| 修订提示 | 42,496个人工红队提示加140,335个模型生成提示,共182,831个 |
| 修订次数 | 每个红队提示生成四组批评—修订;采样温度1 |
| 有用性数据 | 135,296个人工提示,每个采样两个有用助手回答 |
| 监督预算 | 一个epoch,batch 1024序列,学习率为预训练学习率的0.5倍 |
| PM标签 | 135,296个人类有用性比较与182,831个AI无害性比较 |
| RL对照 | 各RL运行使用相同提示集合;具体超参数引用既有工作,本文不臆补 |
| 人工评价 | 24个快照共10,274个有用性比较、8,135个无害性比较 |
| 附加评分 | 64个人工挑选的留出红队提示,每个平均256个模型回答,用学得的绝对评分器评分 |
数目中的“提示”“回答”“比较”是不同单位。四轮修订不意味着四倍独立人类标注,生成更多文本也不意味着覆盖四倍独立风险。各阶段数据来源应分别记录,才能判断人类成本究竟减少在什么地方。
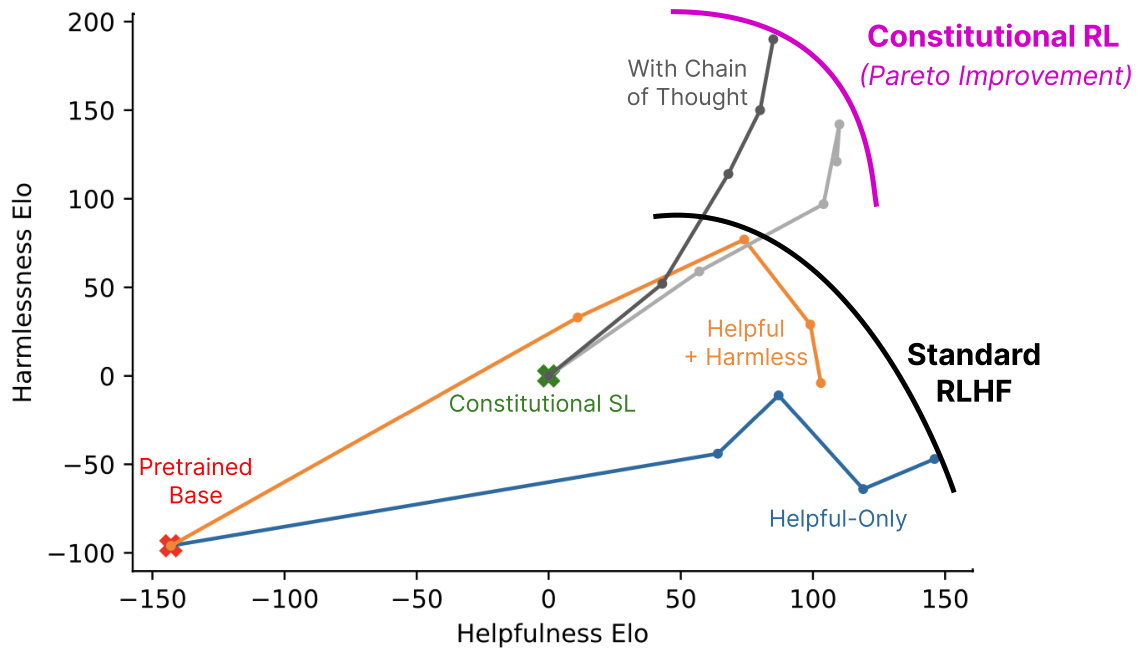
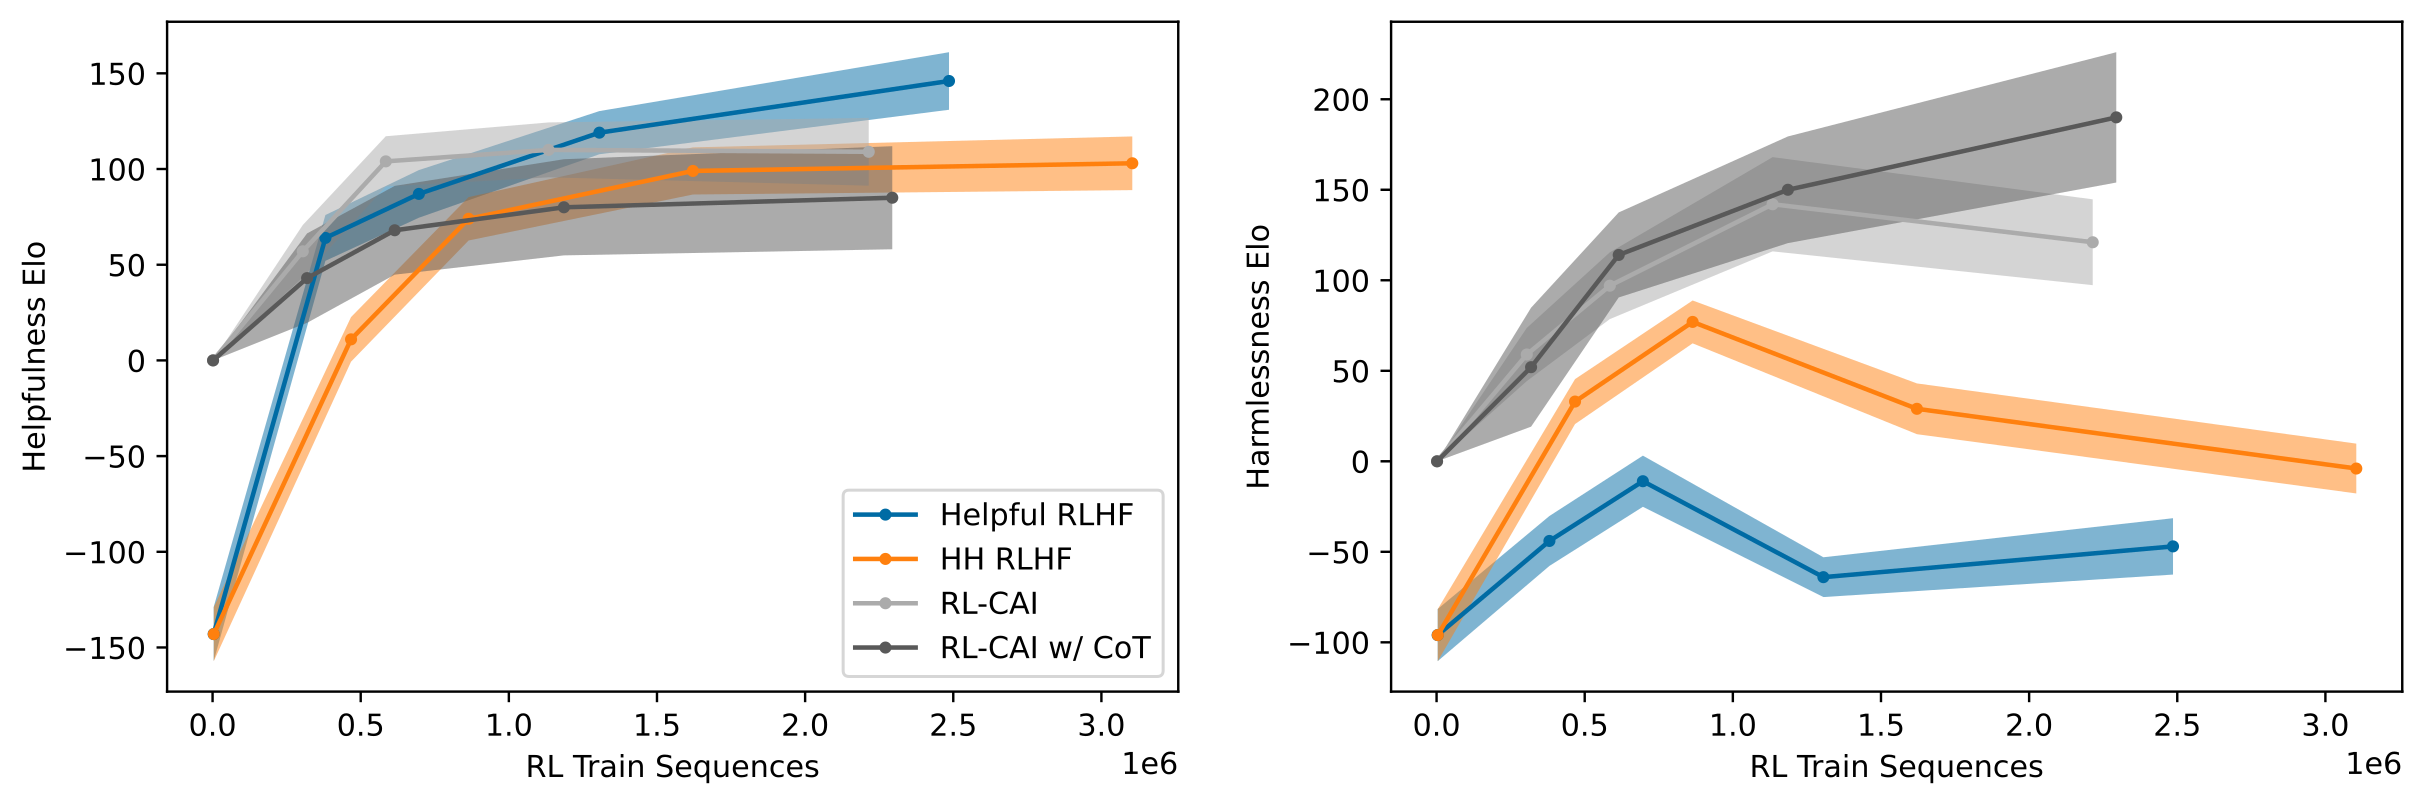
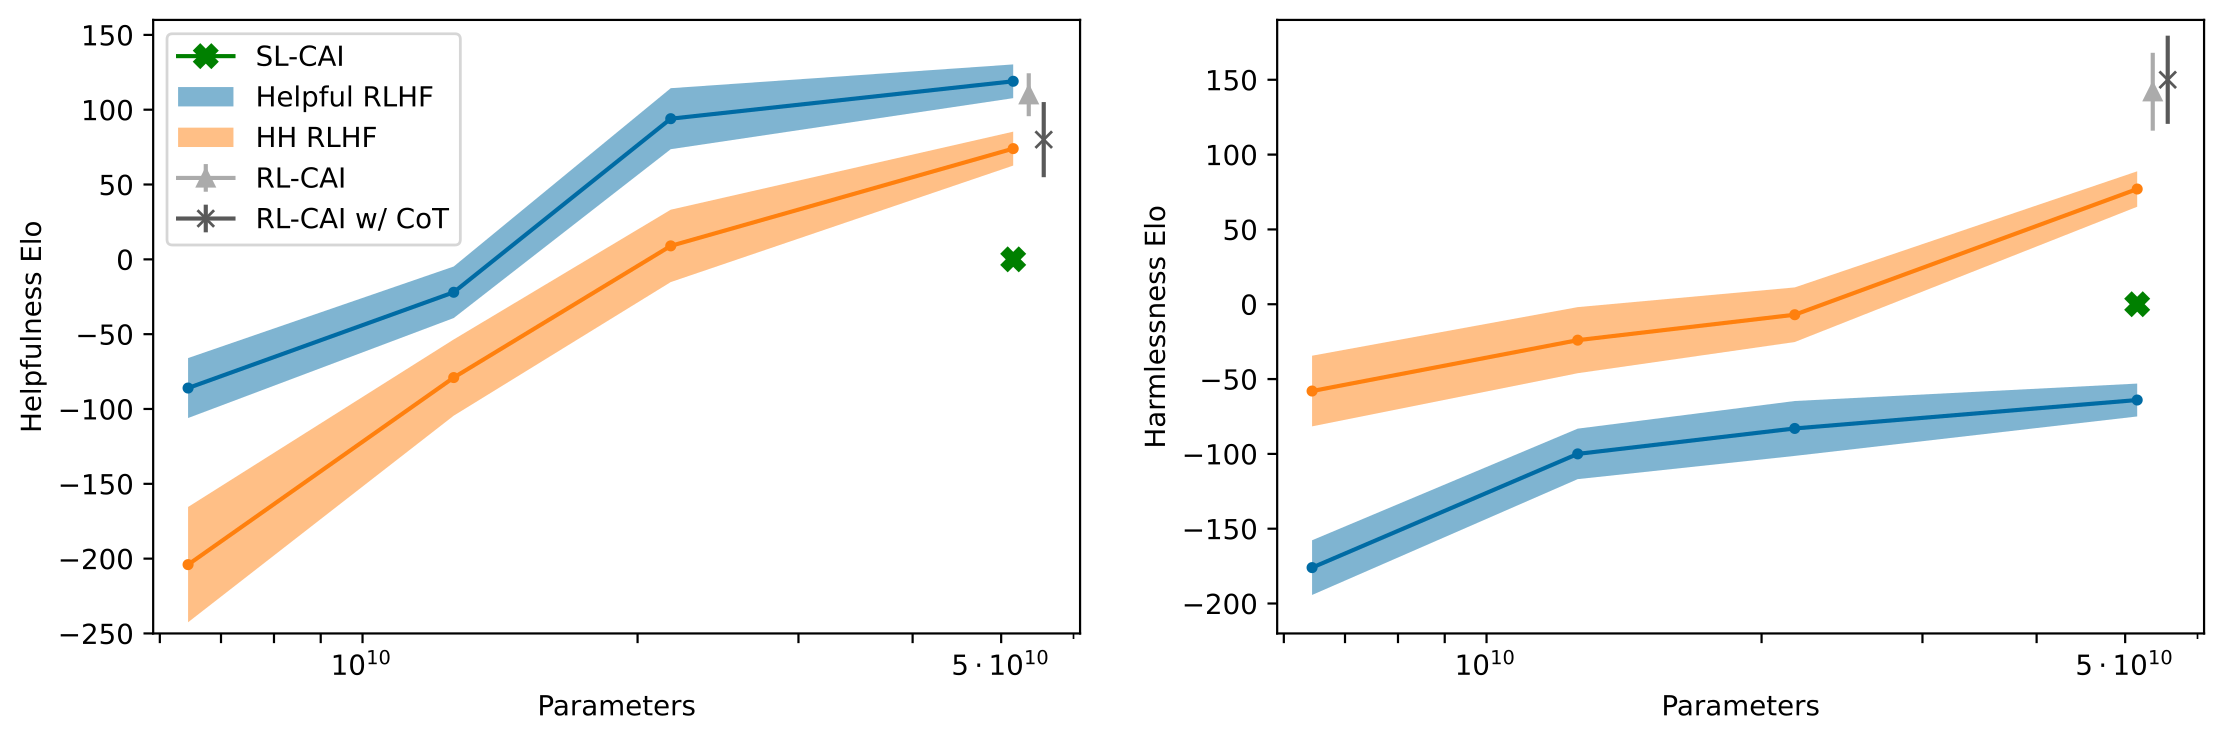
证据一:图2、图3与图8,主要行为比较。 人工偏好结果支持RL-CAI在给定有用性水平下取得较好的无害性表现。Elo是相对比较尺度,零点可人为设置,不能把它当作有害概率或绝对风险百分比。 下方展示的是图3:两幅横轴都是模型参数量,左幅纵轴为有用性Elo,右幅为无害性Elo。相同尺寸先分别比较两个面板,才能看清偏好取舍;向右表示模型更大,并不表示同一个模型训练更久。图2才是把有用性和无害性分别放在两轴、用点表示RL训练进程的图,不能把它的读法套给图3。
证据二:图7,批评是否必要。 小模型更受益于先批评再改写,大模型中两种方式更接近。作者也观察到批评可能夸大或误判原回答。这不支持“每一段自我批评都忠实解释修改原因”。
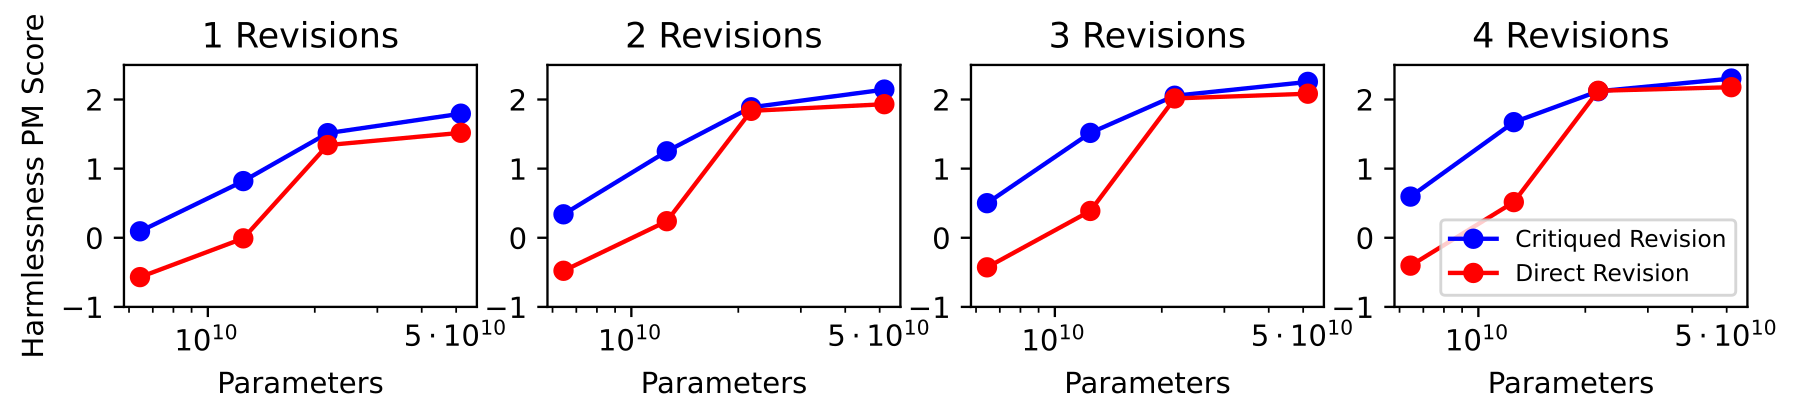
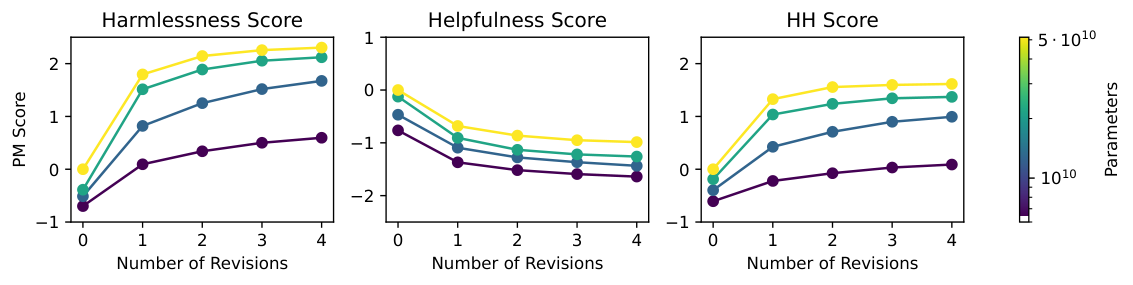
证据三:图5与§3.4,多轮修订。 偏好模型分数随修订改善,但作者提醒高分区间的校准变差。它支持修订能推动代理指标,尚不足以证明每轮都降低真实伤害。
证据四:§4.3,反馈信号的失效。 过度RL会产生严厉措辞和模板化语言;软标签、原则变化和概率截断改善部分行为。这些处理有些是定性观察,没有给出足以量化每个模块独立贡献的完整消融表。
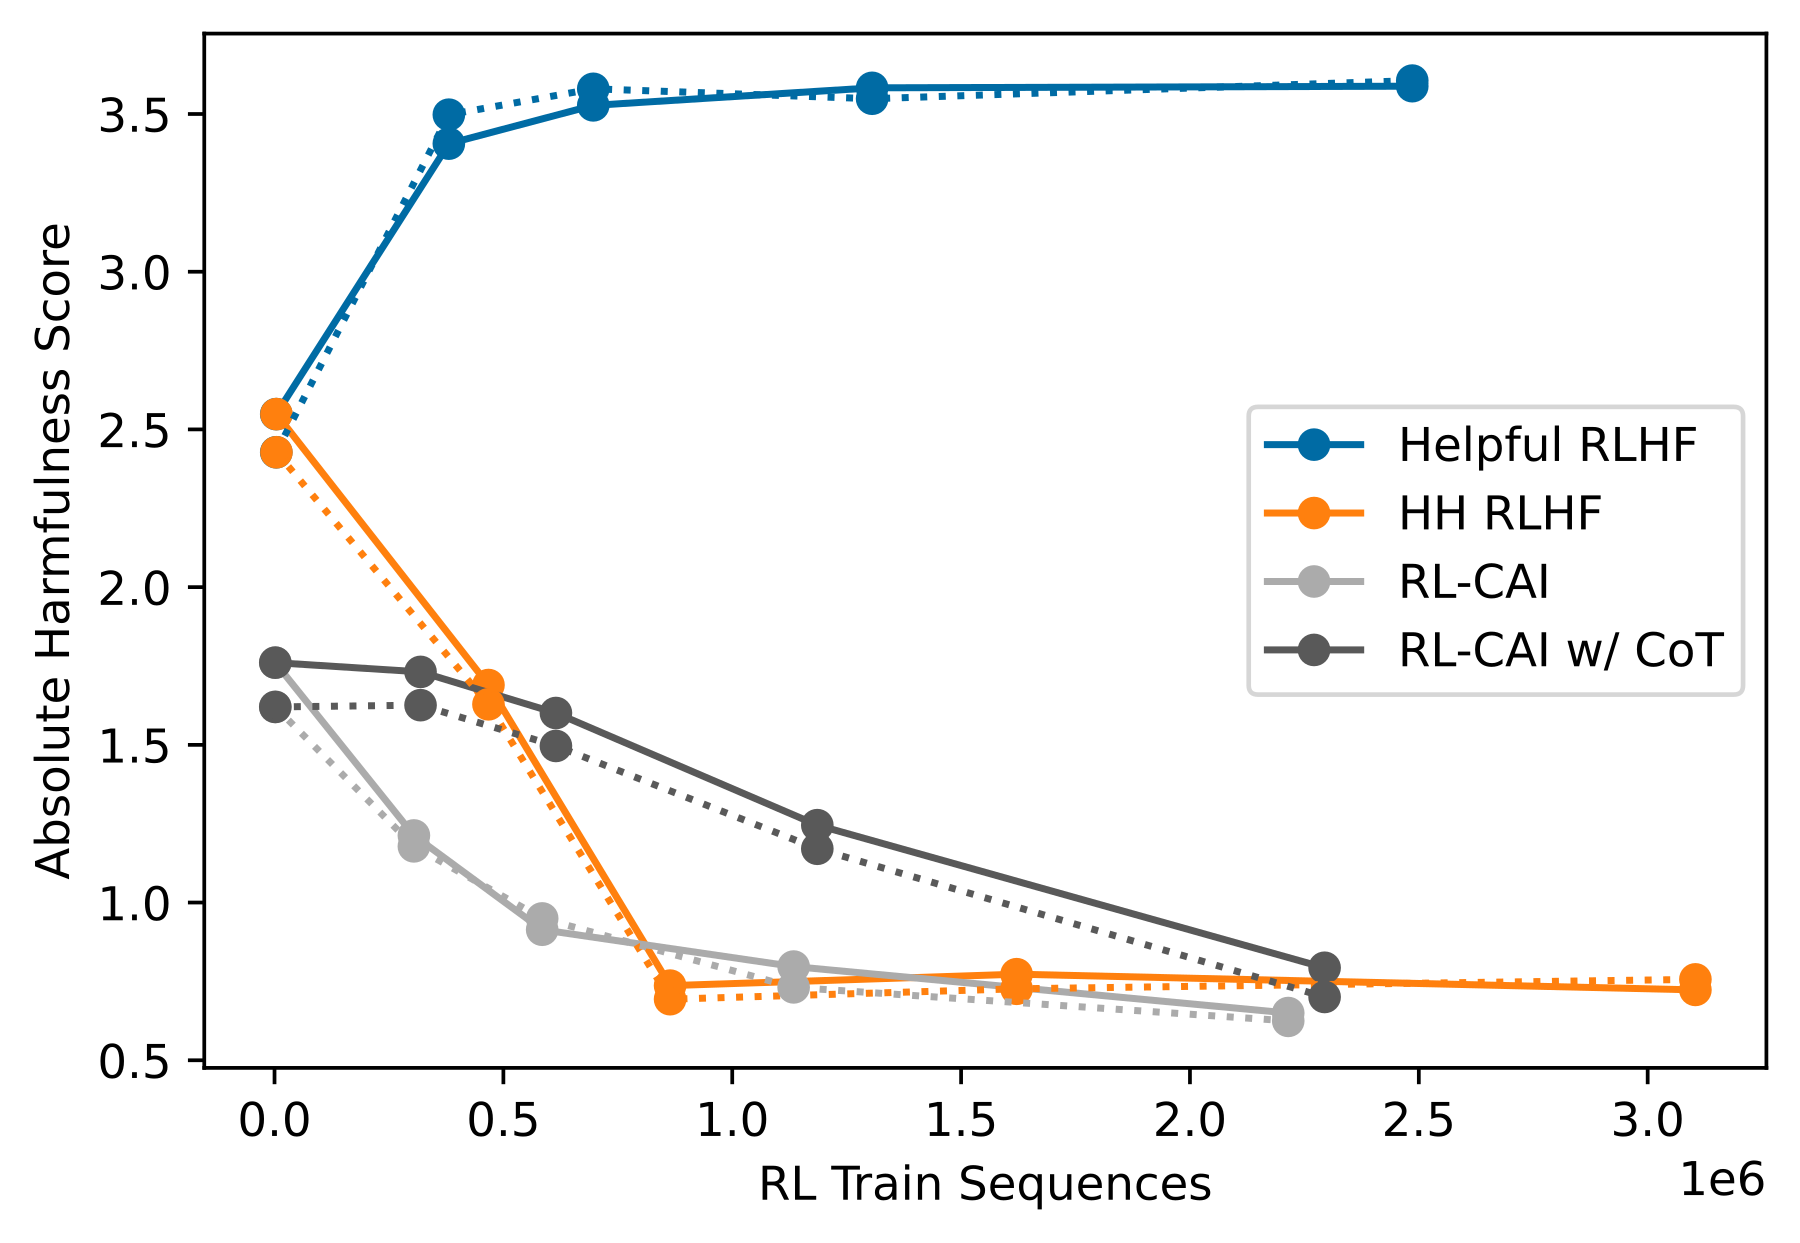
证据五:图10与§4.5,另一种评价。 绝对有害评分的下降与相对偏好结果提供补充,但评分来自学得的模型,且只有64个挑选的留出提示。256次采样扩大的是同一提示的回答覆盖,不等于16,384个独立提示。
尤其要注意人工评价指令发生了变化:在同样无害时,评审被要求更偏好有解释、较少回避的回答;旧人类偏好训练数据没有完全采用相同要求,评审来源也变化了。因此结果同时包含训练方法与评价目标的匹配,不能简化成“AI标签在任何标准下都超过人类标签”。
五、原则歧义、评判错误和奖励投机仍需独立审查
监督阶段先把回答分布移到较合适区域,RL进一步优化偏好。原则公开比隐含在大量标签中更容易讨论,但执行原则的模型仍然不是透明规则引擎。
“不使用人类无害性标签训练”也不等于没有人类贡献:原则、少样本提示、红队问题、有用性标签与最终人工评价都来自人。论文也把进一步替代有用性反馈留作未来方向。
作者承认鲁棒性、过度优化和减少人工观察后的未知失败仍是问题。我的分析是,评判者与被训练模型可能共享盲点:一个原则没有覆盖的新情形,可能同时被生成器、反馈模型和偏好模型忽略。因此扩大自动反馈规模,并不能线性扩大独立监督信息。
复现还受基础模型、历史人类数据及RL实现可得性约束。官方原则和样例足以复现部分提示行为,不代表可以严格重建论文训练。更稳妥的迁移实验应分别检查原则理解、标签质量、奖励模型泛化和策略输出。
六、继续比较AI反馈与人类反馈的适用范围
原则标签的来源值得继续检验。RLAIF直接比较人类和AI反馈,并探索在线评价;重点看最终人评、长度偏好与分布变化,而不是只看AI偏好模型的训练分数。
自测:能够回答,才算理解
1. 这篇论文为什么不能概括为“AI完全自己对齐自己”?
答案:人类写原则和示例、提供有用性标签及部分提示,并参与评价。替代的是特定无害性比较标签,而非全部监督来源。模型对原则的解释还继承预训练中的知识与偏差。
2. 反馈模型已经能比较回答,为什么还训练偏好模型?
答案:完整原则提示与比较推理较昂贵,偏好模型将这些比较蒸馏成可供RL大量调用的评分器。但这也引入额外近似:偏好模型可能学习表面特征,策略又可能利用这些特征获得高分。
3. 偏好分数升高,怎样判断是真改善还是奖励投机?
答案:用与训练分数不同的人工评价、留出攻击、逐类错误分析和有用性检查,观察是否出现套话、过度拒绝或夸大批评。还要保持评价指令一致。单看奖励曲线或同源评分器,无法完成判断。