064 · 投机解码:小模型先起草,大模型怎样并行验收而不改变分布
返回目录 · 上一篇:PAL · 下一篇:Constitutional AI
论文:Yaniv Leviathan、Matan Kalman、Yossi Matias,Fast Inference from Transformers via Speculative Decoding,2022年公开,ICML 2023。原始论文 · v2正文。这里解读的是这篇论文的精确采样方案,不把后来所有“草稿—验证”方法都视为同一算法。
图表来源:Yaniv Leviathan、Matan Kalman、Yossi Matias,2022,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
Transformer解码依赖前缀,通常每轮大模型只推进一个token;FlashAttention优化单次注意力搬运,仍未改变这个串行调用接口。本篇用便宜草稿与并行验证推进多个位置,同时要求目标采样规律不变。
五个前置概念
五个前置概念:自回归让下一token依赖已确定前缀;提议分布用便宜方式产生候选;拒绝采样用接受规则修正候选分布;KV缓存保存前缀注意力状态;墙钟时间是实际等待时间,不等同于运算次数。
一、问题设定:减少大模型串行调用时,怎样保持完整采样分布
在访存受限的生成中,大模型反复读取参数却只输出一个token。先起草再验证能摊薄调用,但若直接接受“差不多”的词会改写分布;因此本篇先证明随机接受与拒绝补偿,再讨论什么时候节省时间。
二、用接受质量与残差分布证明输出精确性
记目标模型的下一token分布为 ,草稿模型为 , 是已经确定的前缀。这里的 都应包含实际温度、top-k或nucleus等采样变换;不能拿原始softmax概率验证一个经过不同截断分布采出来的候选。
目标是让最终输出仍服从 。这不意味着随机采样时每次运行都得到与另一段代码完全相同的字符串,也不保证相同随机种子消耗方式一致。它保证概率分布相同;贪心解码在一致的数值和决策约定下,则可以保持目标模型的确定性选择。
这与蒸馏不同:蒸馏最终由学生代替教师,允许能力或分布变化;此处小模型只提议,大模型仍决定最终分布。它也不是用小模型评分筛选大模型答案,更没有更新任何策略参数。
为什么能并行验证?候选前缀已经由草稿给出,大模型可以像处理已知文本一样,同时计算每个位置的下一token分布。未来候选是否最终被接受,不影响我们提前计算这些条件概率;但一旦某个候选被拒绝,后续结果依赖了错误前缀,必须废弃。
先采样 ,以
接受。如果拒绝,不能简单地再从 抽一次,而应从剩余分布
抽样。已经通过草稿接受的概率质量为 ;拒绝分支补上 ,两者相加刚好是 。这是附录A.1证明的关键,而不是靠实验发现“输出质量差不多”。
若所有草稿token都被接受,大模型还可以从最后一个位置的分布多采一个token。若途中拒绝,则保留此前接受的前缀,加上一个补偿采样token。因此一次目标模型调用至少推进一个token,最多推进草稿长度加一。
设平均接受率为 ,草稿长度为 ,草稿单步耗时与目标单步耗时之比为 。在接受行为独立同分布、并行验证成本近似一个目标步骤等简化假设下,平均每轮产出为
预期加速比为
分子代表推进的token数,分母代表一轮成本。增大草稿模型通常提高接受率,却也提高 ;增大草稿长度增加潜在收益,却在连续拒绝时浪费更多工作。因此“草稿越准越好”和“每次猜得越长越好”都不成立。
接受率可以写成 ,也就是两个分布重合的概率质量。它关心草稿与目标的接近程度,不等于草稿在通用基准上的准确率。一个总体更强、但输出风格与目标差别更大的模型,未必是更好的草稿。
这套成本分析并不声称减少所有FLOPs。并行验证可能执行更多乘法,但减少重复读取权重和串行等待,从而降低墙钟时间。当计算资源已经被高batch填满,多出来的运算不再“便宜”,收益可能缩小。此处是由机制推导出的负载边界,具体数值必须实测。
接受率等于两个分布重叠的质量
固定合法前缀,令 为草稿模型的下一 token 分布、 为目标模型的分布, 枚举词表。一次草稿 token 来自 ,接受概率为 ,因此总接受率 。右侧正是1减总变差距离。草稿与目标越接近,目标模型一次验证能兑现更多token;但草稿模型越大通常也越贵,所以提高α并非唯一优化目标。这里 必须已经应用各自约定的温度和截断规则; 的词不会被草稿抽中,接受步骤不需要对它计算除法。
只有A、B两个token,目标为 ,草稿为 。草稿提出A时以0.75接受,提出B时总接受。接受分支贡献A的0.6和B的0.2,总接受率0.8。拒绝的0.2概率全部补到B,最终正好是0.6、0.4。
如果拒绝后直接从 再抽,A会额外得到 ,最终变成0.72,B变成0.28,分布就被扭曲了。这个自构例子说明补偿分布不是可有可无的细节,而是精确性的核心。
多起草两步为何可能降低预计加速
在独立接受率0.5、草稿单步成本0.1的教学近似中,草稿长2时预期产出1.75、轮成本1.2,加速约1.46;长4时产出1.9375、成本1.4,反降为约1.38。后续词越来越可能因前面的拒绝而被丢弃,额外草稿并非都能兑换成输出。实际测量还需检验并行验证成本假设。
教法联系:Lilian Weng的Large Transformer Model Inference Optimization。算例为本文自构。
三、逐段验证草稿并核算拒绝后的缓存与成本
输入:目标模型P,草稿模型Q,已确定前缀h,草稿长度γ
用Q自回归生成x[1:γ],保存每步完整分布q[i]
用P一次计算所有候选前缀上的p[1:γ+1]
依次检查i = 1 ... γ:
    u = Uniform(0, 1)
    如果u <= min(1, p[i](x[i]) / q[i](x[i])):
        接受x[i]
    否则:
        r = normalize(max(p[i] - q[i], 0))
        y = sample(r)
        返回h + x[1:i-1] + y
所有候选均通过时:
    y = sample(p[γ+1])
    返回h + x[1:γ] + y
实际实现还要处理EOS、长度上限、缓存回滚、浮点误差和零概率。这些属于实现正确性条件,不能因为数学证明成立就默认任意内核也完全正确。特别是拒绝后继续使用被拒绝前缀的KV缓存,会让后续计算对应错误上下文。
四、对照接受率、草稿耗时与端到端加速
分布证明回答是否正确,时间表回答是否值得;接受率更高的草稿也可能因更贵而拖慢整体。
| 项目 | 原文设置与口径 |
|---|---|
| 目标模型 | T5 v1.1 XXL,11B参数,已有任务检查点 |
| 草稿模型 | T5-small 77M、base 250M、large 800M |
| 任务 | WMT英德翻译、CNN/DailyMail摘要 |
| 基线 | 标准T5X自回归实现;模型权重不改变 |
| 硬件与负载 | 单个TPU-v4、batch 1,温度0与1分别测量 |
| 其他分析 | GPT式小模型、LaMDA等测接受率;不都进行了端到端速度实现 |
| 统计范围 | §4.2每种设置用目标模型生成的10K token估计接受率;主速度表未给完整置信区间 |
这不是同预算训练比较,模型训练成本并没有因解码方法而消失。论文使用已有草稿,但部署仍要容纳草稿参数与相关状态。评价的对象是相同目标分布下的推理执行方式。
证据一:算法1和附录A.1,分布保证。 通过接受质量与剩余质量相加,可以证明输出服从目标分布。证明不依赖草稿足够准确;准确程度影响速度,而非理想算法的分布正确性。
证据二:表2,端到端速度。 T5-small作草稿时,翻译温度0为3.4倍、温度1为2.6倍;摘要分别为3.1倍和2.3倍。结论对应batch 1和该实现,不能直接迁移到所有GPU服务。
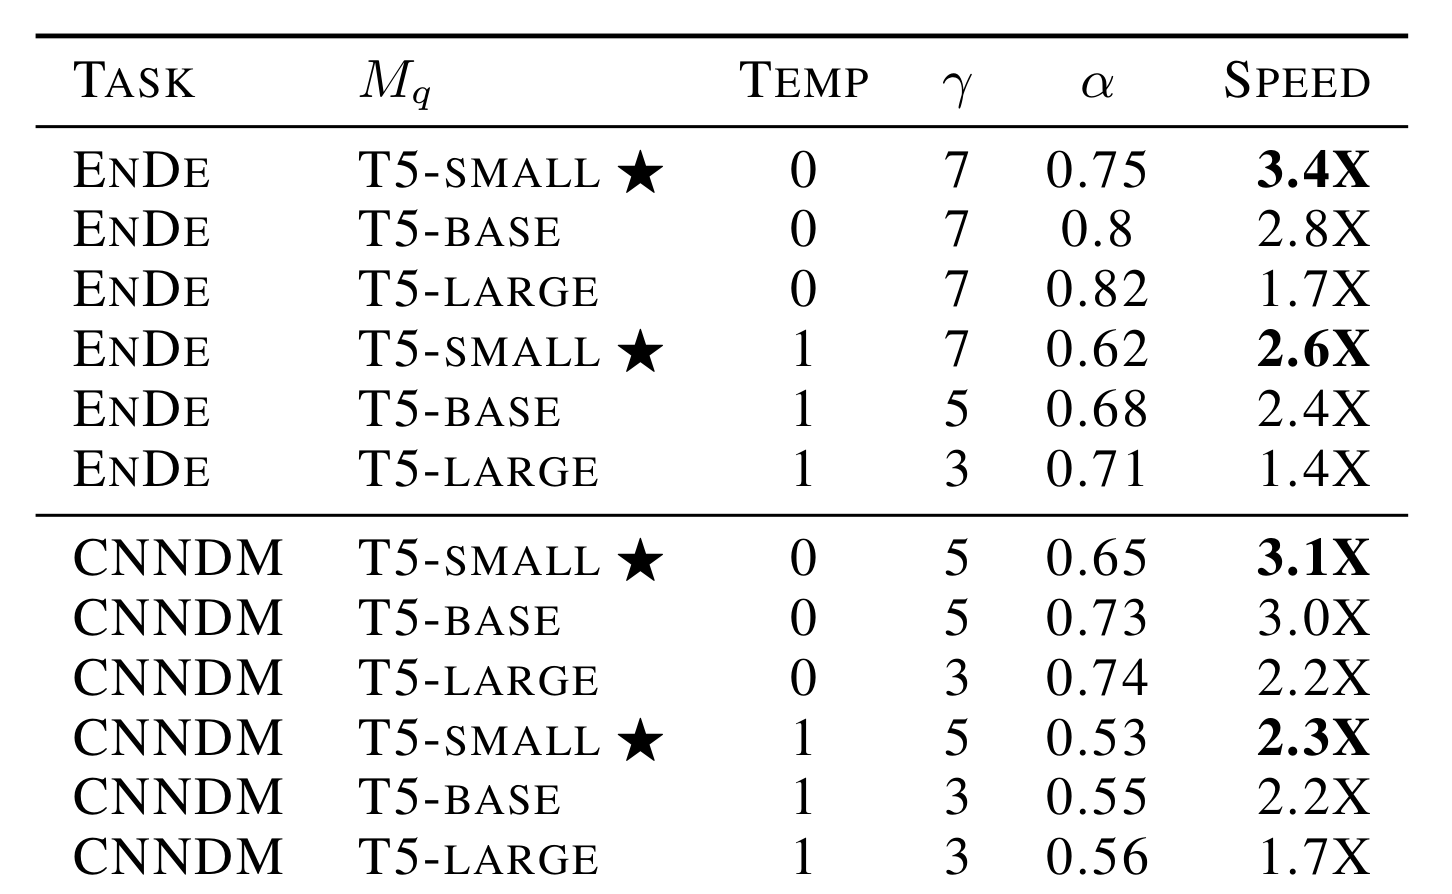
证据三:表2,大草稿不一定更快。 翻译温度0,small接受率0.75、速度3.4倍;large接受率0.82、速度1.7倍。更高接受率未能补偿草稿成本,直接反驳“只优化接受率”的选型方法。
证据四:表1,运算量与时间的区分。 在忽略草稿成本的理论示例中, 对应约1.63倍运算与3.69倍速度。这是理论情形,不是另一组硬件实测,更不是能耗下降3.69倍。
证据五:附录A.3表4,模型预测的误差。 翻译贪心场景,T5-base理论3.3倍、实测2.8倍;large理论2.5倍、实测1.7倍。实现差异与接受率独立性近似都影响预测,理论公式适合指导调参,不能替代测量。
论文第4.2节的LaMDA结果主要是分布重合与接受率分析。只看到137B模型名字就把T5速度数值套到LaMDA,是常见的证据范围扩大。
教学算例。 p=(0.6,0.4)、q=(0.9,0.1),重叠为0.6+0.1=0.7,拒绝概率0.3。拒绝后残余只落在第二类,恰好补回目标分布缺的0.3质量。若拒绝时直接重新从p抽一次而不使用残余分布,第二类最终概率变为0.1+0.3×0.4=0.22,失去精确性。
五、理论分布不变仍需实现和负载条件成立
它把算法正确性与系统性能联系起来,但两者需要分别论证。
主要代价包括草稿步骤、未接受候选的计算和双模型状态。它降低目标模型串行调用次数,却不保证总调用耗时永远降低。输出极短时,初始化和至少一次目标调用无法摊薄;草稿与目标不匹配时,反复拒绝也会抵消收益。
我的分析是,实际部署应记录每轮接受长度的分布,而不仅是平均值。平均接受率相同,一种工作负载可能连续接受很长一段后集中拒绝,另一种可能频繁早拒绝;独立假设下的预测未必同样准确。还应区分首token延迟、逐token延迟和多请求吞吐。
六、比较独立草稿与同模型多头候选
独立草稿的维护成本可在Medusa中换成共享主干的未来头,但候选树和接受规则必须重新审查。保留分布的证明不能仅因为两者都叫投机推理就自动迁移。
自测:能够回答,才算理解
1. 为什么拒绝候选后不能直接从目标分布重新抽样?
答案:接受分支已经从目标分布中占用了一部分概率质量,再从完整目标分布抽会重复分配。必须只补上目标超过草稿的剩余质量,才能让两个分支合起来精确等于目标分布。
2. 草稿模型更强、接受率更高,为什么可能更慢?
答案:每轮草稿本身更贵,而接受率提高带来的额外token有限。应比较平均产出与总轮次成本的比值,不能只看接受率。表2的small与large正是这种权衡。
3. “不改变输出”应该如何理解和验证?
答案:随机采样时指分布一致,不保证不同实现使用同一随机种子得到逐字相同文本。要核查采样变换、接受概率、剩余分布和缓存处理;小词表可枚举验证概率,大模型还需测试实现行为与数值边界。速度则另用目标硬件和负载测量。