051 · T0:把提示多样性变成训练数据的一部分
返回目录 · 上一篇:FLAN · 下一篇:GSM8K与验证器
论文:Victor Sanh等,Multitask Prompted Training Enables Zero-Shot Task Generalization,2021年公开,ICLR 2022。原始论文 · 模型与代码 · PromptSource。
图表来源:Victor Sanh等,2022,原文;CC BY 4.0。本篇展示做了PNG格式转换,图中数据与标签未改动。
先接住前作的问题
FLAN让模型在训练中学习自然语言指令,但单一模板不能揭示换措辞后的稳定性。T0是同期平行路线,组合T5与公开多提示数据,分别检验留出任务迁移和提示稳健性,不能将二者合成一个平均分问题。
五个前置概念
五个前置概念:多任务学习让共享模型接受不同监督任务;模板渲染把结构字段变成文本;标签映射连接数据标签与回答词;四分位距描述中间一半结果的跨度;负迁移是学习新任务后某些原能力下降。
一、问题设定:未见任务的迁移与换一种问法的稳定性能否同时改善
同一任务换问法可能改变模型表现。T0把数据字段渲染成多种自然语言输入,目标仍是标签词、答案或摘要;编码器—解码器用最大似然学习目标文本,不训练奖励模型或执行策略更新。需要分清增加任务种类和增加同任务模板各自改变什么。
与原始FLAN相比,T0使用11B的T5+LM,重点分析多种提示表达,并同时留出自然语言推断、指代、词义消歧和句子补全四类任务。主要T0检查点对这些留出任务统一评估,而不是为每个簇单独训练一个不同留出模型。
但T0、T0+、T0++不能混用。后两者逐步加入更多数据,其中包括部分原评估任务;T0++主要只剩推断与BIG-bench作为留出任务。一个扩展版本在旧测试集分数跳升,可能是监督条件变化,不是零样本能力突然飞跃。
二、把数据字段、标签和多种模板变成可采样分布
论文提出PromptSource,将数据字段、提示文本、目标模板和答案候选显式保存。模板可以改变措辞、字段顺序,也可以反转任务方向,例如由摘要生成文档。反转版本参与训练,但不用于原任务指标评估,以免测量对象悄悄改变。
论文时的P3集合共有2073个提示、177个数据集;这是资源池规模,不是全部都进入一个T0训练集。正文研究的训练与评估集合覆盖62个数据集、12类任务,具体训练子集见表5。
设样本 属于数据集 ,模板 生成输入 和目标 ,训练:
模型只对目标文本计算生成目标,不训练重建输入。编码器双向阅读提示,解码器自回归输出;“双向编码器”与“自回归目标”在此并不冲突。
对固定候选答案 ,评估分数是:
原文不做长度归一化,因此标签措辞与长度可能影响选择。模板多样化可能让模型少依赖一种表面格式,但不能从训练目标直接证明模型理解了说明的全部语义。
模板多样性也改变训练分布
设同一数据集有m种模板,每个原样本可渲染为m条不同文本。如果按渲染后总行数采样,模板更多的数据集会被自动加权;若先均匀选择数据集、再选样本和模板,则不会。模型学习的不是脱离采样协议的“所有任务平均”。T0还区分不同训练混合版本,某个测试集在T0留出、在T0+纳入,两个结果便不能都称对该集零样本泛化。
自构例子: 两个释义模板分别问“这两句同义吗”和“它们表达不同意思吗”。后者必须反转标签映射。如果模板文字变了而目标标签没变,模型会接收互相矛盾的监督。PromptSource显式保存输入与目标模板,有助于发现这一错误,但工具本身不会自动保证所有模板语义正确。
模板增加怎样偷偷改变数据集权重
自构数据集甲有100题、每题2模板,乙也100题、每题8模板。若按渲染后行均匀抽样,乙占800/1000=80%;若先等概率选数据集,再选题与模板,两者各50%。所以模板多样性消融必须同时确认采样权重,否则既改了表达方式,也改了任务曝光量。
教法联系:Lilian Weng的Prompt Engineering。算例为本文自构。
三、区分训练混合版本与测试提示的抽样口径
输入:T5+LM、训练数据集、多个输入/目标模板
固定训练任务与留出任务清单
对训练数据集渲染模板,检查标签映射和条件分支
按样例数混合,限制大数据集与多模板造成的权重膨胀
对packed批次计算目标序列似然,更新完整模型
只用训练任务的验证数据选择检查点
对每个留出数据集:
  运行全部评估模板,不选表现最好的模板
  候选任务按目标对数概率排名
  记录各模板准确率,汇总中位数及四分位距
输出:任务表现分布,而非单个精心挑选提示的最佳分
四、沿提示分布、模板数和任务数分别读消融
先看同一留出任务的提示分布,再比较训练混合;T0+纳入的测试集不能继续解释为同口径零样本。
| 项目 | 原文设置 |
|---|---|
| 基础模型 | T5+LM 11B;另有3B消融;先前T5训练1T token,再有100B token的LM适配 |
| 模板数据 | P3是更大的资源池;主要T0每数据集平均8.03个训练提示,含反转任务 |
| 输入输出 | 分别截断1024与256 token,使用packing |
| 优化 | 批量1024序列,相当于2²⁰输入token;Adafactor学习率10⁻³、dropout0.1 |
| 计算报告 | 附录B表1,单次T0在v3-512 TPU约27小时;全研究约270小时、250B训练token |
| 常规留出评估 | 四类任务的11个数据集,多数用验证集,指标为准确率 |
| 扩展评估 | 14个BIG-bench任务,采用维护者给出的提示;不是整个BIG-bench |
| 不确定性 | 中位数与四分位距反映提示差异;不能当作独立训练种子置信区间 |
大数据集抽样上限在§5按样例与模板数共同处理,因此复现需要保留数据集—模板映射。全研究token量包括预备实验,不应写成单模型训练消费量。主文对应段落未给可直接核验的统一更新步数,本文不从总成本推造每次步数。
评价时,若三种提示准确率分别为50、80、90,中位数是80,最好分是90。只报90会隐藏很差的50;更大的模板集合与分位数有助于揭示系统对措辞的依赖。这里为教学构造,不是论文原始分布。
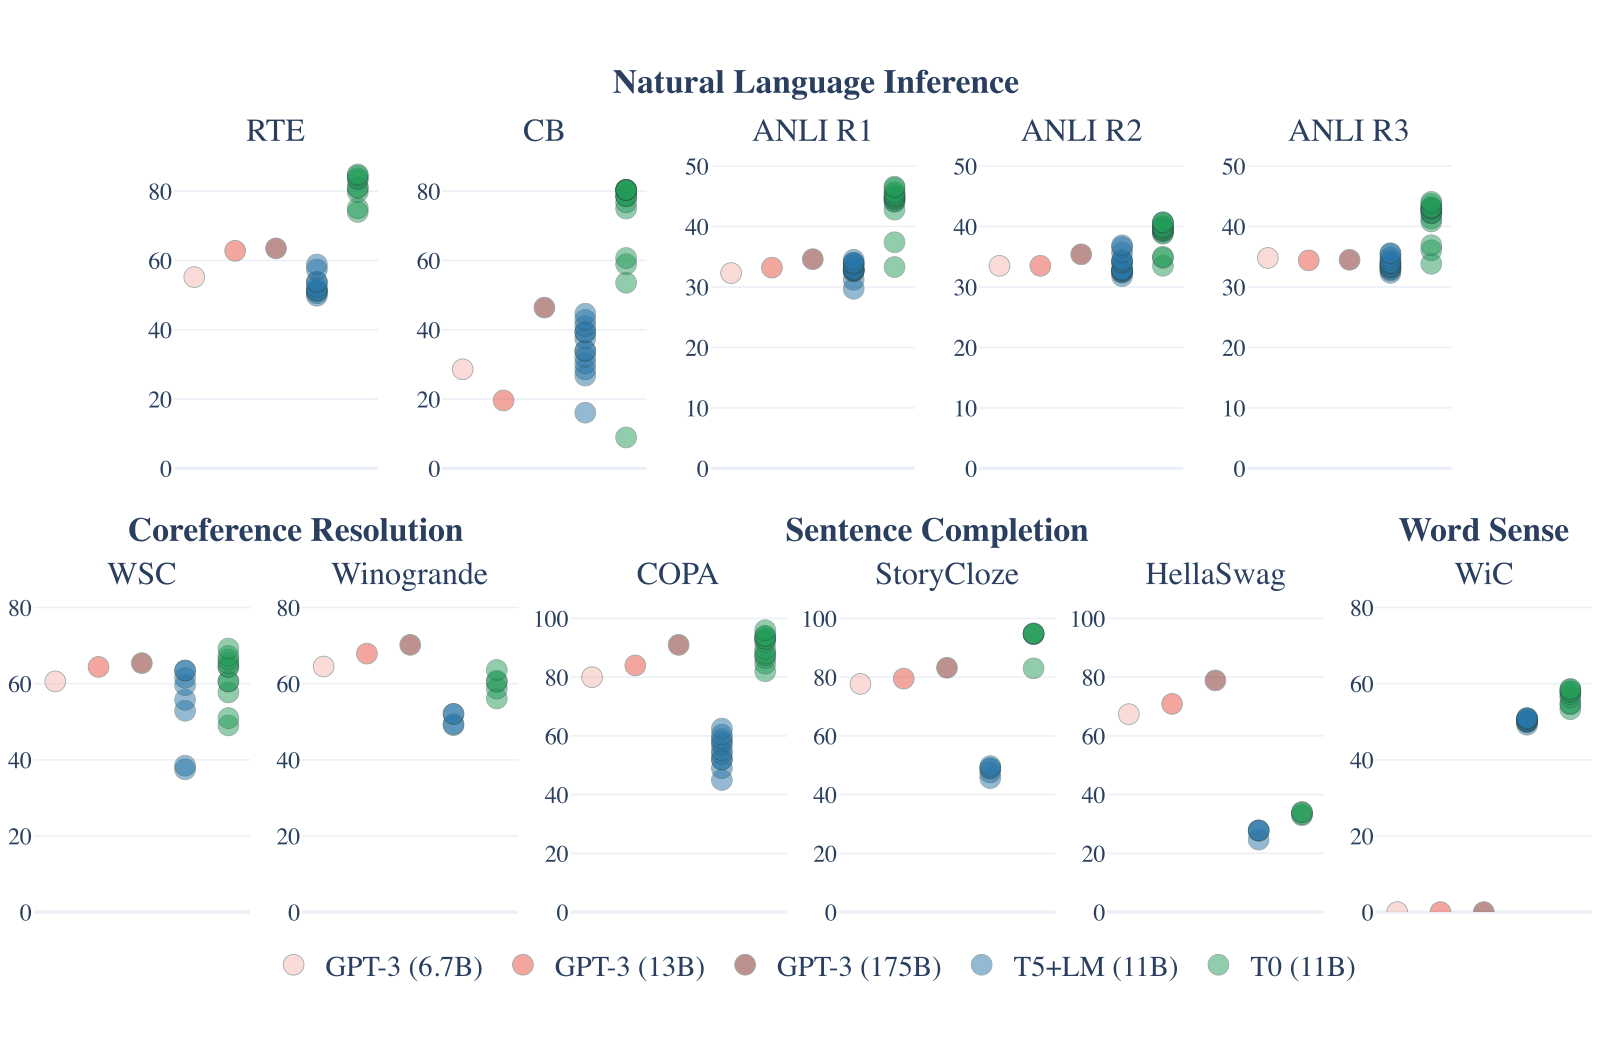
证据一:图4与附录表6。 同一基础T5+LM与T0比较,RTE模板中位数由51.81升至81.23,CB由33.93升至78.57,ANLI R1由32.85升至44.70。它们支持多任务提示训练能改善留出任务。CB等小评估集的提示变化可能很大,因此中位数变化不应掩盖分布范围。 每个点代表一个评估提示的成绩,分布宽度反映措辞敏感性;GPT-3 参考值只用单一提示,不能当作同样的多提示分布。
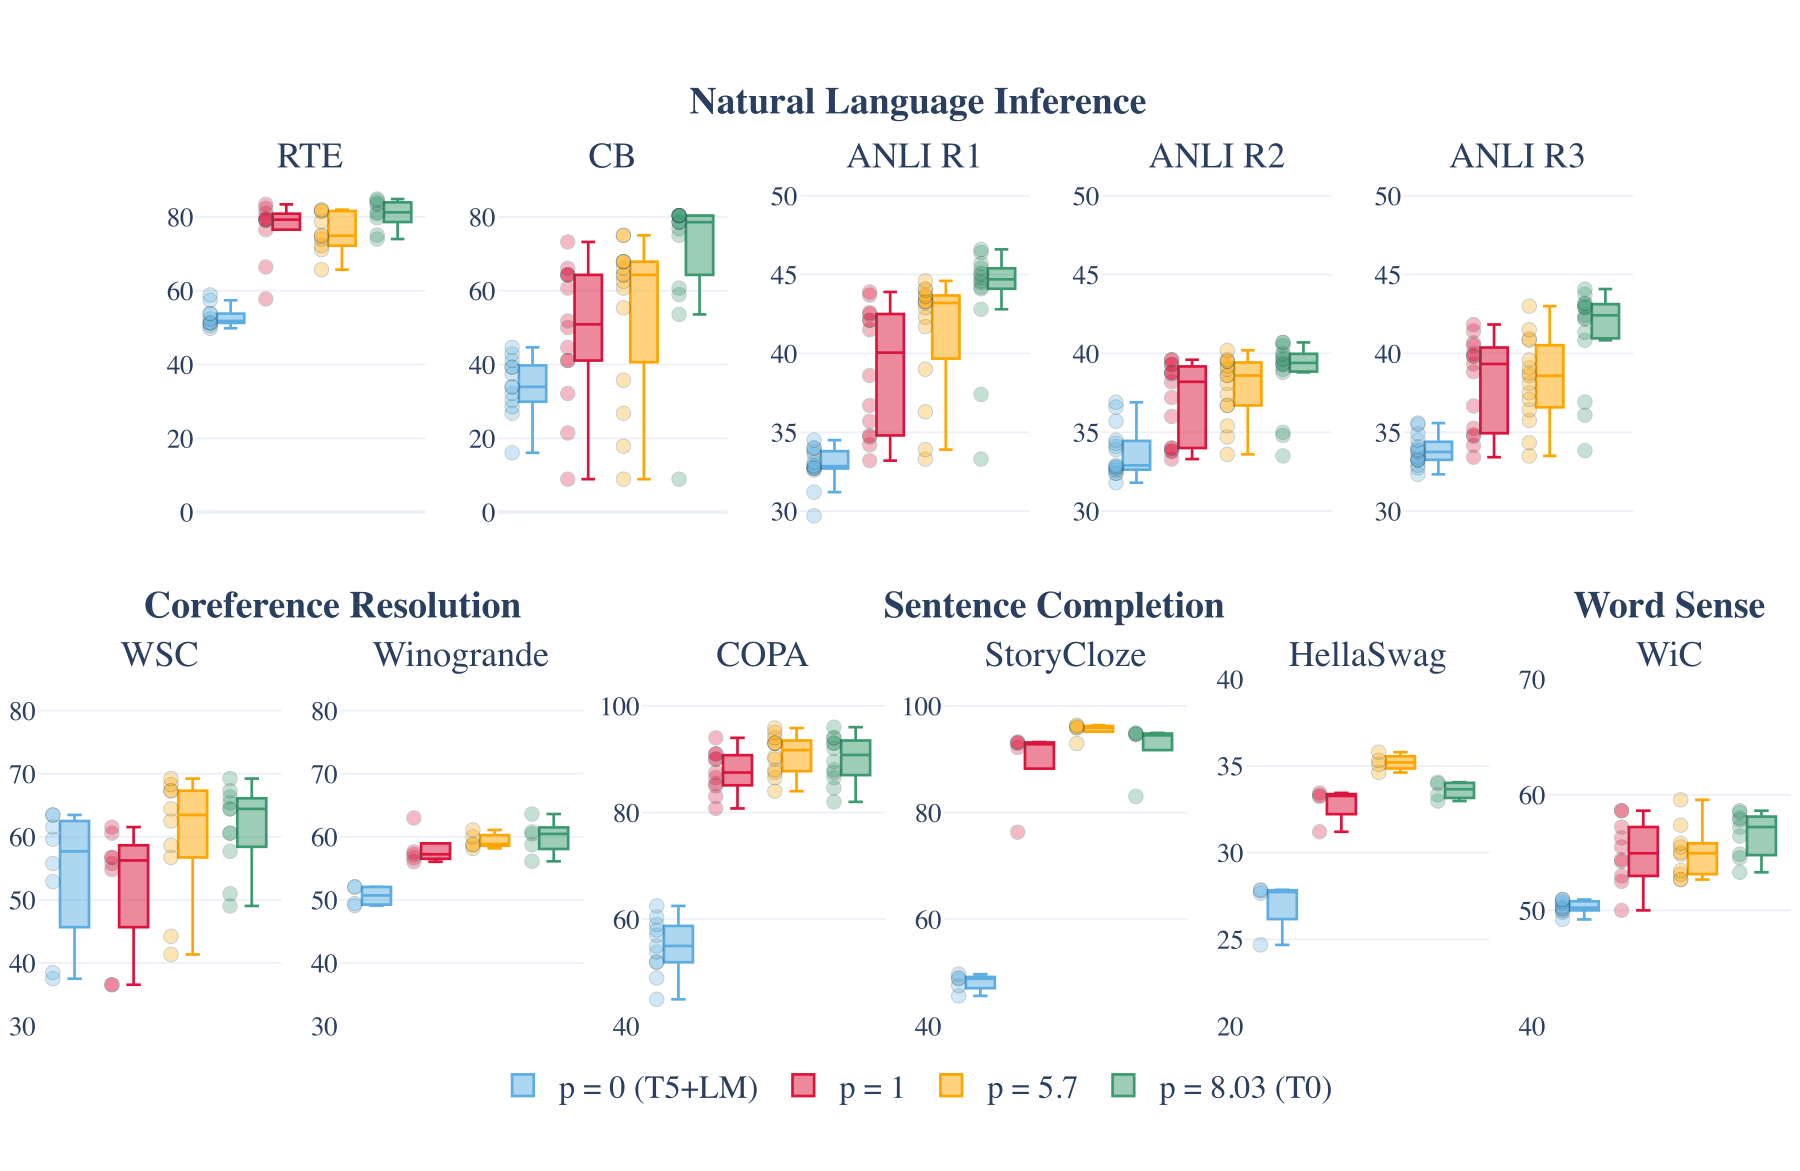
证据二:图6与§6.2。 每数据集一个模板已经有益;从一个增加到平均5.7个原任务模板,11个数据集中8个中位数提高、7个四分位距缩小。支持提示多样性在多数任务上改善稳健性,但不是所有任务都如此。扩到8.03还加入反转任务,数量和任务形式同时变化,需要区分这层混杂。
证据三:附录表6的版本差别。 HellaSwag中位数从T0的33.65跳到T0+的85.79,看似巨大提升,却不能当作同一零样本设置:T0+加入了GPT-3评估数据。表中灰色专门标出非零样本结果。反而在仍留出的RTE上,T0+中位数64.98低于T0的81.23,说明增加任务也可能产生负迁移。
证据四:图5与附录表7。 BIG-bench的Logical Deduction准确率,T5+LM为31.00、T0为55.40、T0+为44.20、T0++为43.60;Vitamin C则依次38.29、64.73、66.24、70.00。两种趋势同时存在,不能概括成训练数据越多每一项就越好。作者“13/14超过大基线”的说法还涉及至少一个T0变体达到较好结果,不等于一个固定变体在全部任务都胜出。
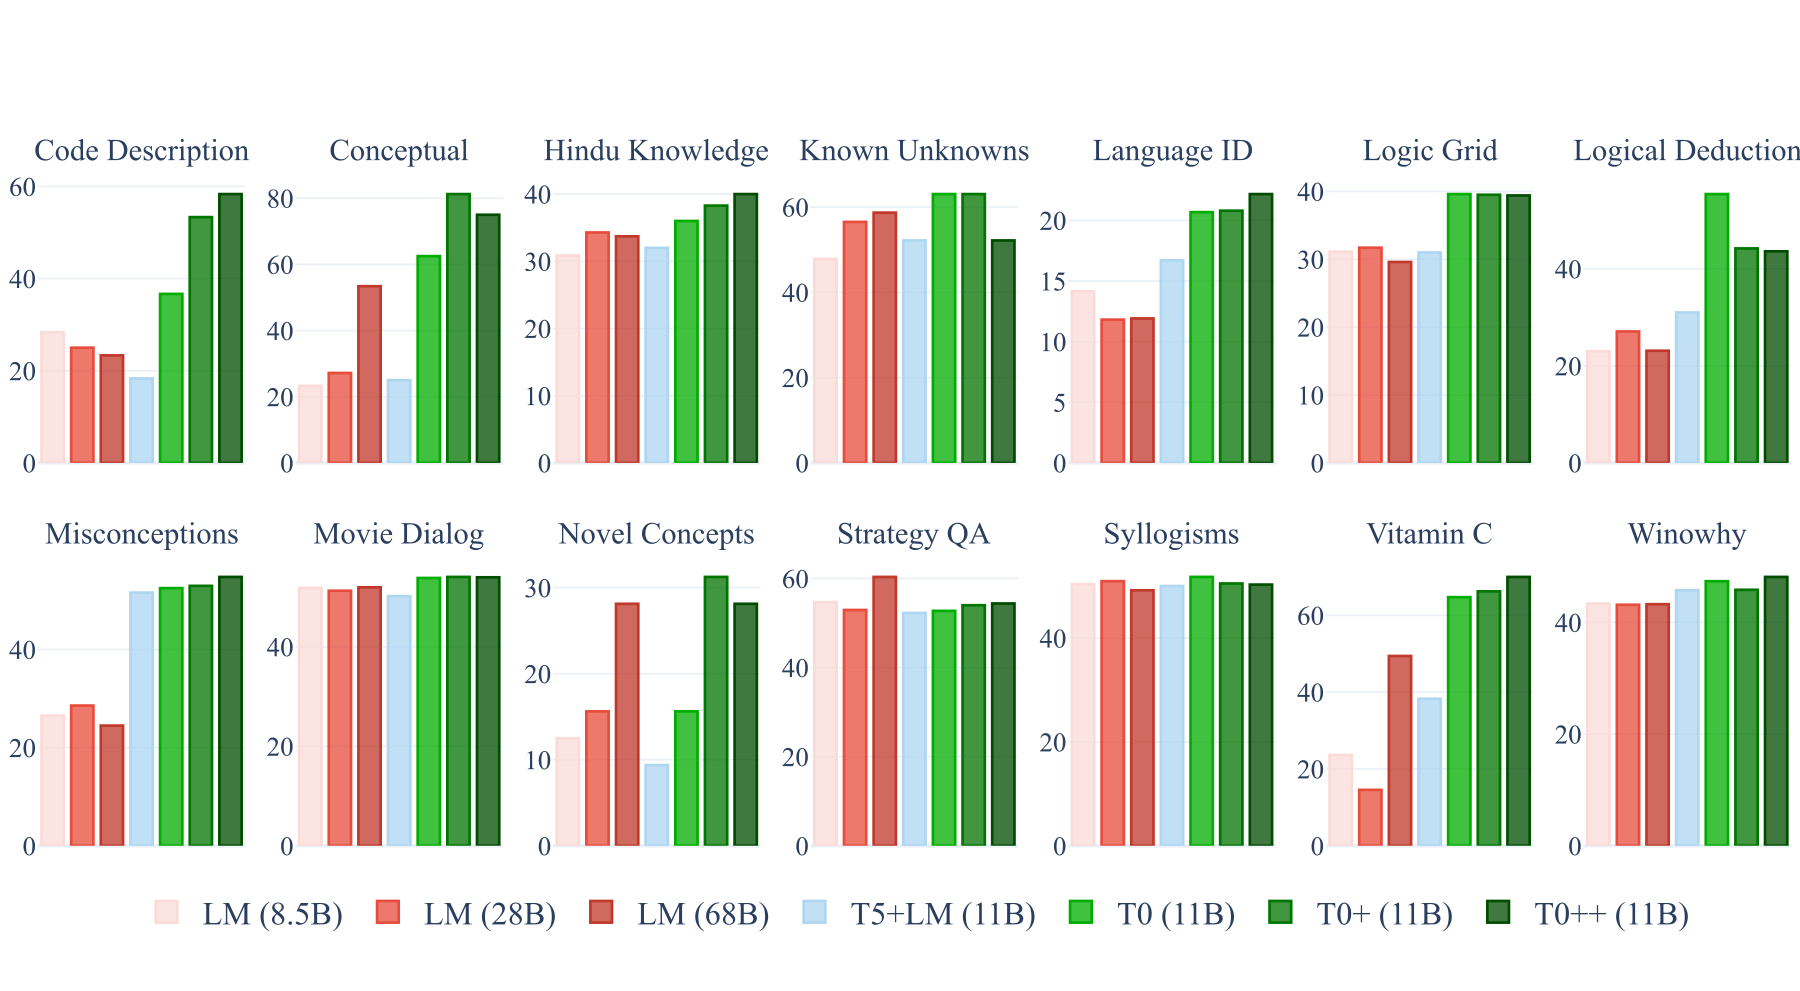
与GPT-3的9/11比较也有口径差异:T0报告多模板分布,GPT-3论文主要给单一提示结果;模型架构和预训练数据不同。它展示可行的参数规模取舍,不证明模型大小不再重要。
教学算例。 A、B各1000条原样本,A有10种模板、B有2种,展开后按行随机抽样会得到约5:1的任务比例;先均匀选任务则是1:1。要单独测试模板多样性的价值,可保持每任务曝光token相同,只改变模板种类,避免把重复次数增多误认为语义稳健性收益。
五、任务族边界与格式适应仍限制语义解释
T0的贡献包括多任务提示训练的证据、提示稳健性消融,以及可检查的公开模板和模型。作者在§2明确对提示为何有效保持开放,不声称语义理解已被因果证明。这个克制很重要:跨任务分数可能同时来自格式适应、标签语义与共享知识。
任务分类也有边界。问答数据可能包含指代或推断子问题,无法只靠数据集名称保证所需技能完全没见过。附录D专门讨论释义判断与单向蕴含的关系,说明留出的是按给定分类定义的任务,而非彻底隔离所有认知能力。
六、把提示训练与偏好训练的信号分开
模板稳健不等于偏好满足。InstructGPT引入排序反馈,可对照其API任务分布与本篇留出任务;差异应归到具体监督来源,不能凭同称“指令模型”直接排名。
自测与答案
1. T0+在HellaSwag大幅超过T0,为什么不是最有力的零样本提升证据?
因为T0+的训练集合加入相关评估数据,监督条件改变。需要按表6灰色标记区分留出与已训练结果。公平的零样本比较应固定留出定义,不能只按模型名字认为都一样。
2. 提示数量增加与数据集数量增加为什么应分开消融?
前者更多改变同任务的表达覆盖,后者增加内容、技能与标签分布。它们对准确率和措辞稳健性的影响不同,也可能产生负迁移。T0固定数据集比较提示数,才更接近回答提示多样性的作用。
3. 提示四分位距很小,是否说明模型已经稳定正确?
不一定,它也可能对所有提示稳定答错。应同时看中位数、四分位距和随机猜测基线;还要检查模板是否真正覆盖不同表达,是否存在标签映射错误。稳健性与准确性是两个维度。