043 · CLIP:用语言定义视觉分类器
返回目录 · 上一篇:Switch Transformer · 下一篇:Prefix-Tuning
论文:Alec Radford等,Learning Transferable Visual Models From Natural Language Supervision,2021。原始论文 · 官方代码。
先接住前作的问题
DPR展示独立编码两端后用相似度检索的接口,本篇把这种教学结构换成图片与文字配对。此前固定类别视觉头不能灵活接收新类别定义;CLIP用语言构建测试时分类方向,后来的LLaVA才另组合语言生成模型。
五个前置概念
五个前置概念:余弦相似度比较向量方向;对比学习提升正配对相对其他候选的分数;温度控制softmax的尖锐程度;零样本迁移不在目标训练集拟合参数;线性探针冻结表示并训练一个线性分类头。最后两个设定使用的目标标签量不同。
一、问题设定:图像类别能否在测试时由语言描述重新定义
普通图像分类头在训练前固定类别,换到交通工具等新类别通常需要新标注和读出。互联网图片及说明可提供弱配对监督,本篇让模型在一批候选中双向找配对,使测试类别可由文本定义;它不是完全无监督,也不直接生成描述。
传统固定标签只表达有限类别;自然语言能够表达对象、属性、行为与场景,但描述有噪声,可能只说图片的一部分。CLIP依赖大量配对中的统计规律足以形成有用表示,而非每个配对都完整准确。论文构建的WIT包含4亿图文对,规模本身是方法效果的重要组成部分。
“零样本”指不使用目标数据集训练样本来拟合该任务分类器,并不表示训练中从未见过目标概念或相似图片。目标类别列表、提示模板与任务说明仍然属于系统输入,不能从成本或信息来源中删掉。
二、从图文相似度矩阵推导双向对比目标
设一批有 个正确配对 。图像编码器 与文本编码器 分别输出归一化向量:
是相似度logit, 是可学习温度。小温度使分布更尖锐。原实现以可学习对数尺度表达倒温度,数值限制也属于稳定训练配方。
图像到文本损失为:
对角项是配对正例,其余批内项作为负例。反向损失对矩阵转置后执行同样计算。双向训练迫使两种模态都能检索对方;它并不证明非配对描述都语义错误,例如同批两张狗照片可能互为“假负例”。
分类时为类别 构造描述 ,令 ,预测 。多模板时先合并类别表示,再用于匹配。分类权重可以缓存,因此每张图通常不必重新编码所有文本。
两个方向的匹配为什么都要做
batch中N张图和N段文本产生相似度矩阵 ,v、t是单位向量,τ为温度。逐行交叉熵问“这张图匹配哪段文字”,逐列问“这段文字匹配哪张图”;两者平均。它约束配对关系,不直接训练逐token描述生成。所谓零样本分类,是把类名写进文本模板后用文本编码器生成分类方向,并不是另有一个无需定义类别的万能输出头。
自构例子: 要区分自行车、摩托车和汽车,可分别编码三句类别描述。图片向量与三句相似度为0.31、0.27、0.15,则选自行车;这些是假设数值,不是论文结果。如果把任务改为交通标志识别,使用“一个交通标志,上面……”可能比泛泛“照片”更贴近数据。模型参数没变,任务接口却变了,这正是可迁移性的来源之一。
相似度矩阵的一行与一列各代表什么
三张图和三段文字构成3×3匹配矩阵。图到文损失固定一行比较三段文字,文到图损失固定一列比较三张图;若只实现行softmax,两方向训练就不完整。另需注意两张图可能都满足同一描述,非对角项因此可能是语义真配对,批次身份标签不等于世界里唯一的正确描述。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、先训练配对表示,再编码候选类别作为分类方向
输入:配对图文数据、图像编码器 f、文本编码器 g
训练:
  抽取 N 个配对样本
  U = normalize(f(images)); V = normalize(g(texts))
  logits = exp(log_scale) * U @ V.T
  labels = [0, ..., N-1]
  loss = (CE(logits, labels) + CE(logits.T, labels)) / 2
  更新 f、g 和 log_scale
迁移:
  将每个类别放进任务合适的描述模板
  编码、归一化并缓存各类别文本向量
  对新图片计算与类别向量的相似度
输出:相似度最高的候选类别
低对比损失不直接保证计数、空间关系或开放式问答能力。
四、连同模板、总数据与失败领域读取零样本成绩
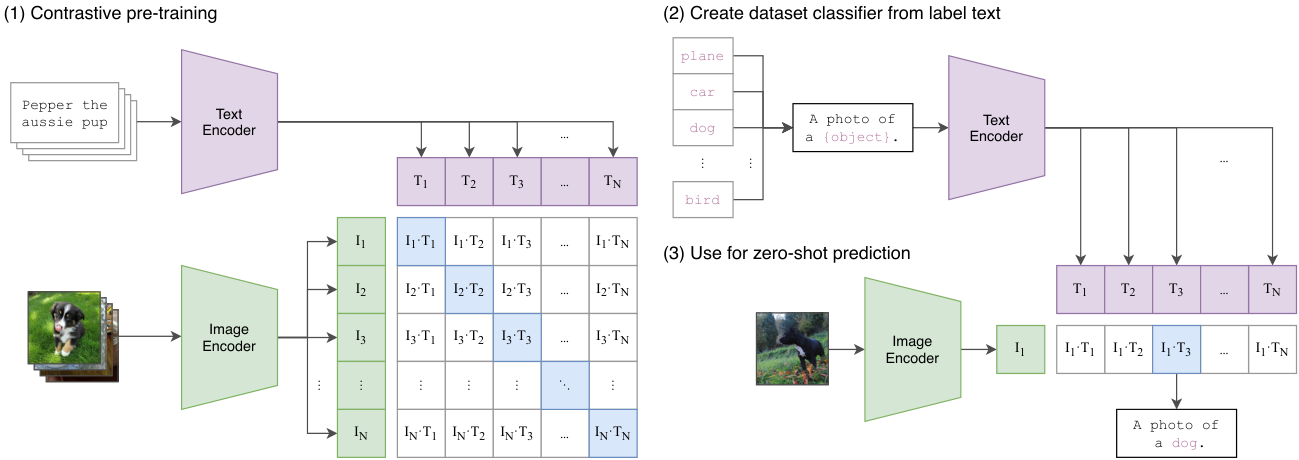
图1先解释训练到分类的接口转换,再读提示集成、领域落后与自然分布变化,不能只记ImageNet单值。
| 项目 | 论文设置与解释 |
|---|---|
| 数据 | §2.2,WIT约4亿图文对,以约50万个查询词组织检索,每查询最多约2万对以平衡覆盖 |
| 模型 | §2.4–2.5,5种ResNet与3种ViT;文本侧为Transformer |
| 训练 | 32个epoch,批量32768,Adam配合解耦权重衰减和余弦学习率;不是少量目标数据训练 |
| 算力 | 最大ResNet训练18天、592块V100;最大ViT训练12天、256块V100;ViT-L/14还用336像素额外训练1个epoch |
| 评估 | 多种视觉任务的零样本分类、冻结表示后的线性探针、自然分布变化测试 |
| 对照 | 监督ResNet、已有弱监督方法、不同提示模板、架构与计算规模 |
| 不确定性 | 不同实验报告方式不同;大型模型主结果不能当作多次完整预训练的均值与置信区间 |
表中的“零样本”与“线性探针”必须分开:后者使用目标训练集学习分类器。不同模型也不总是拥有相同训练数据,因此零样本CLIP胜过监督模型不能自动归因于损失函数一项。
证据一:图1与表1。 图1给出配对训练到语言分类器的完整接口;表1报告CLIP在ImageNet零样本top-1为76.2%、top-5为95.0%。作者据此强调接近原始监督ResNet-50水平且不用其128万张ImageNet训练图。实验支持语言监督可以转化为有效类别识别,却不能说明CLIP用了更少总数据:4亿弱配对才是其预训练基础。 流程图的训练端是图文配对,测试端是给定类别文本的相似度分类;它没有画出逐 token 生成答案的解码器。
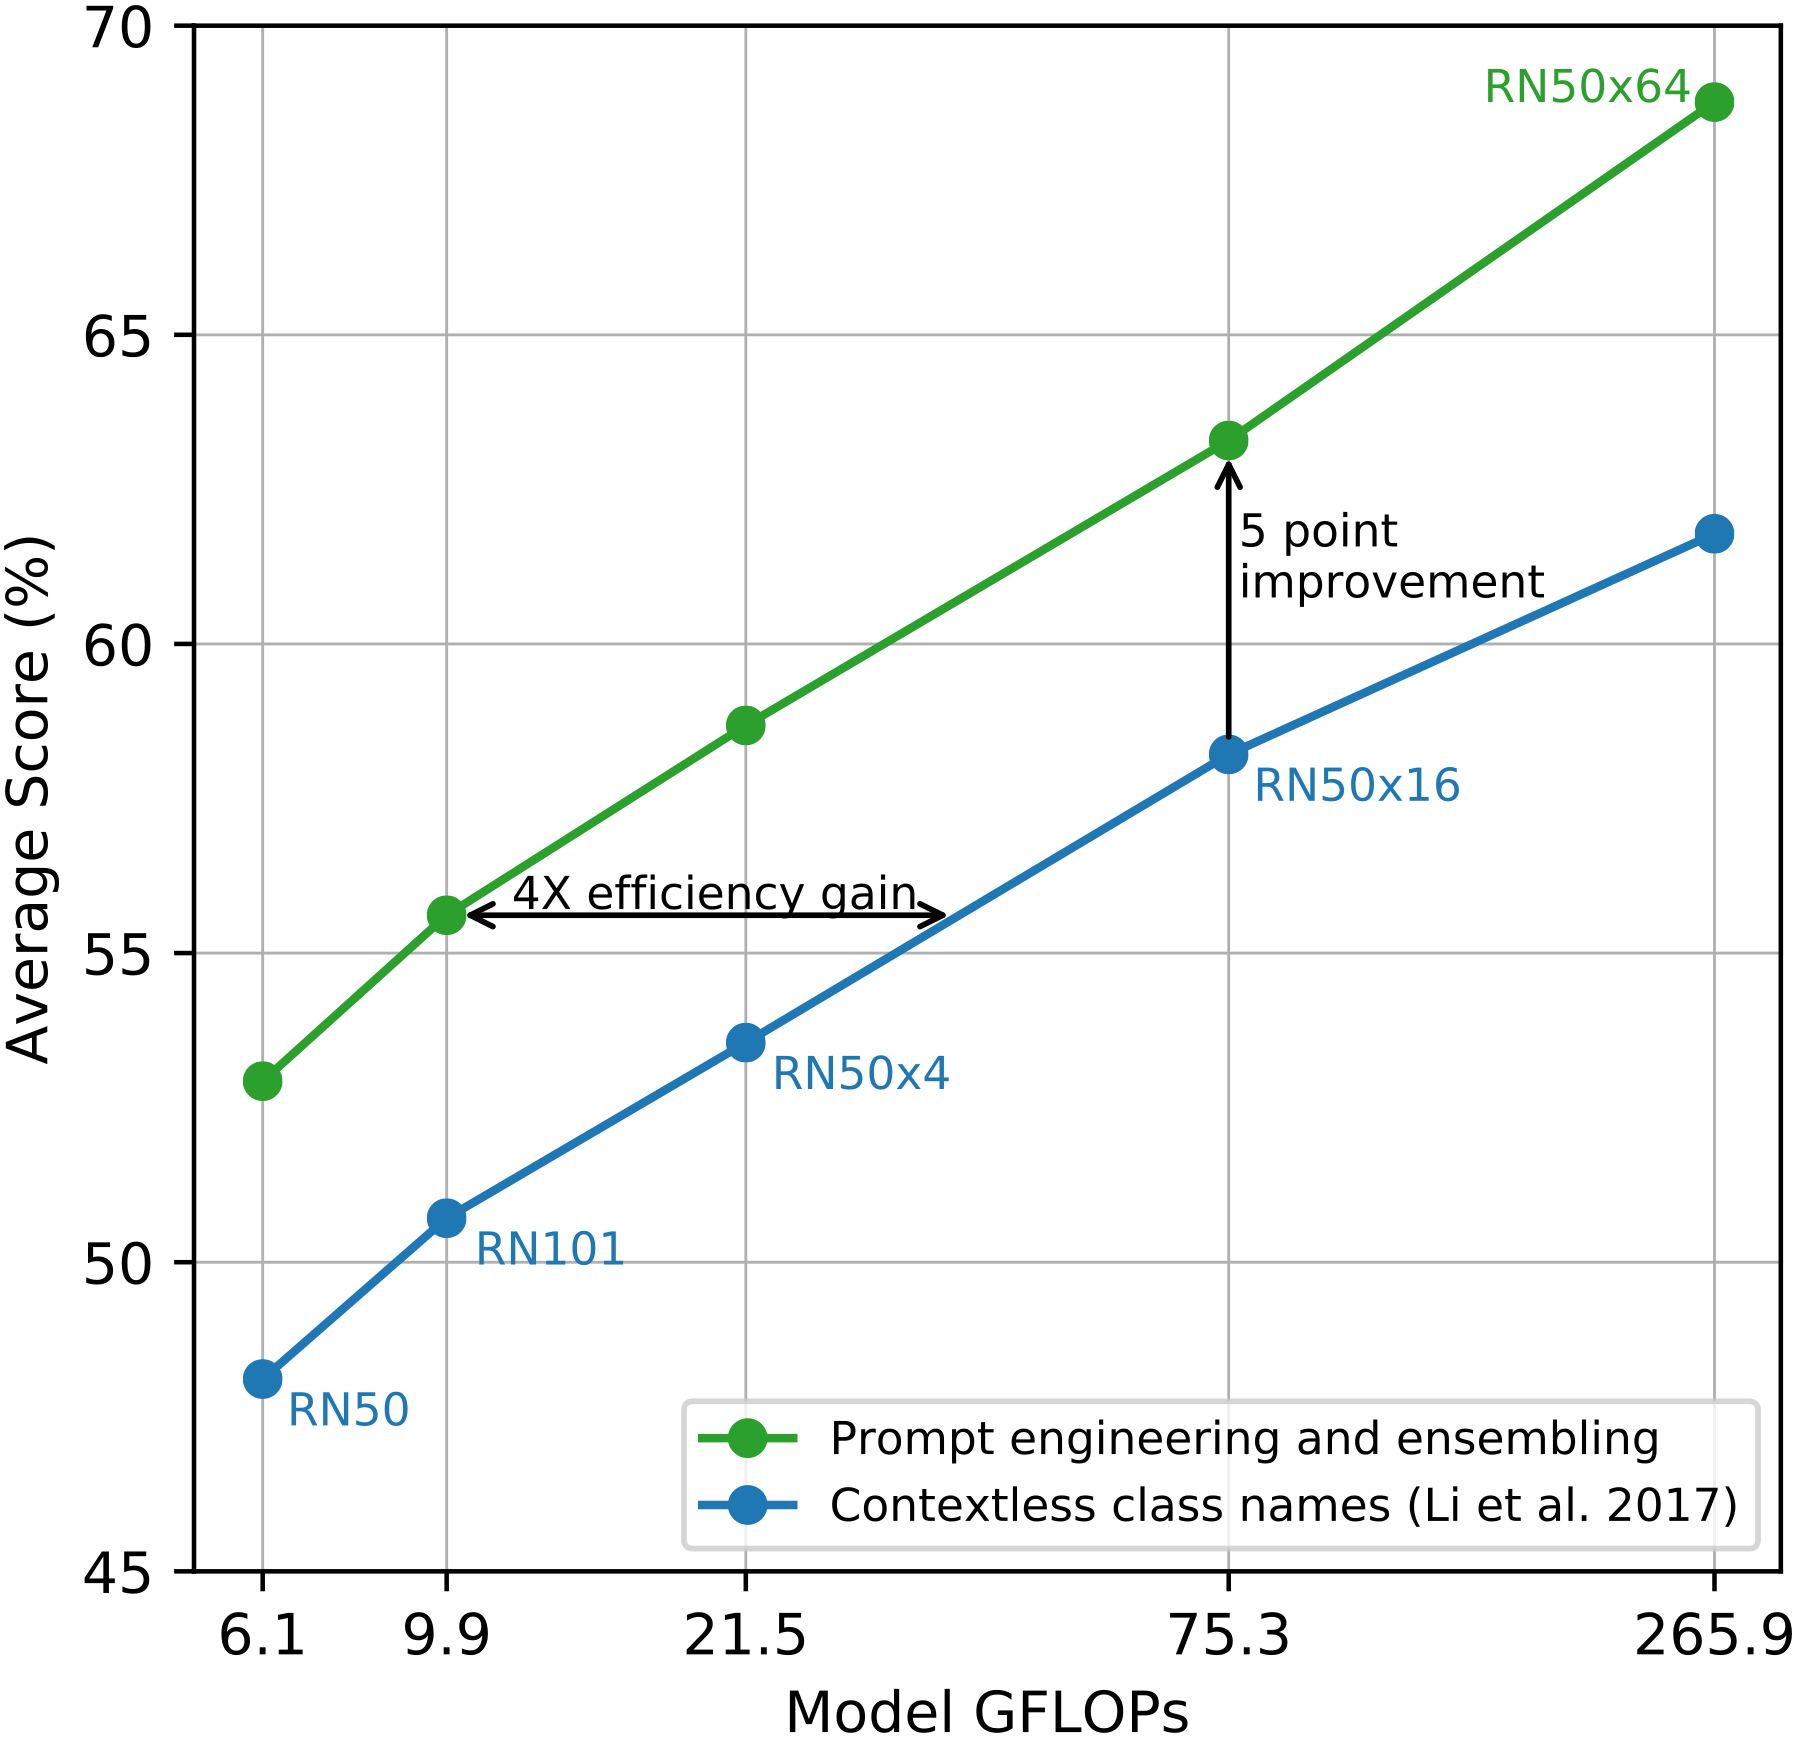
证据二:§3.1.4与图4。 仅将裸类别名放入“照片”模板,ImageNet准确率就提升约1.3个百分点;80个提示的集成再带来约3.5个百分点提升。跨36个数据集,提示工程与集成平均接近5个百分点。这说明文本接口的表达会影响迁移,也意味着比较方法时必须交代模板。缓存后每图成本低,不等于设计与编码提示不花资源。
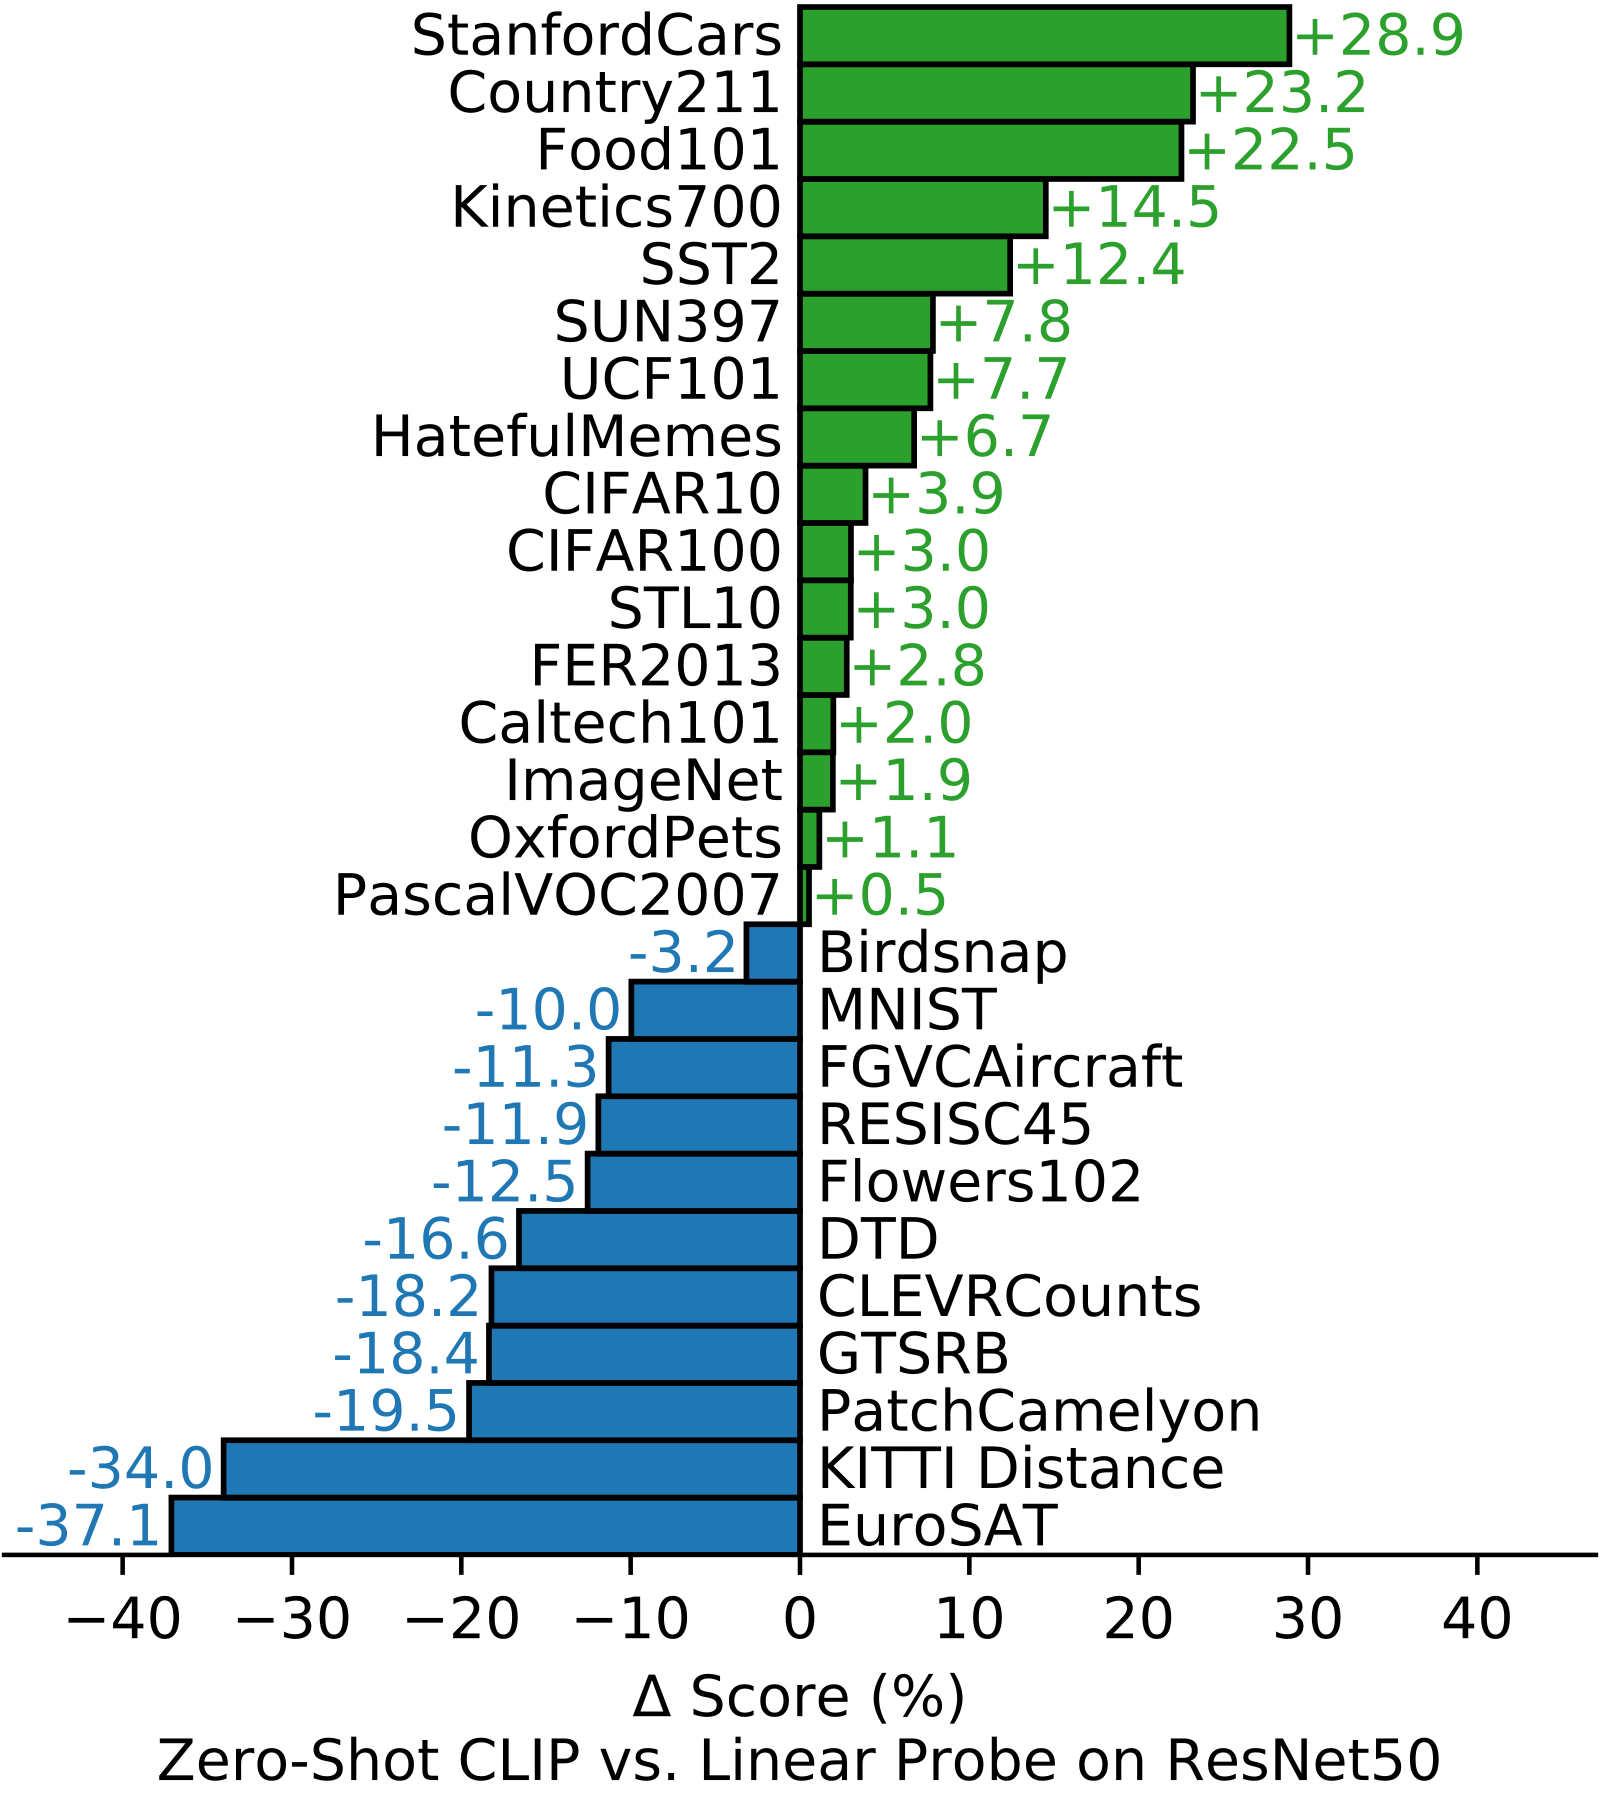
证据三:图5。 零样本CLIP在27个数据集中有16个超过监督ResNet-50表示的线性探针,但在EuroSAT落后37.1个百分点,在KITTI距离任务落后34.0个百分点。支持的是广泛而不均匀的迁移,不能总结成“零样本已经替代监督学习”。遥感、细粒度距离和某些计数任务要求的信号,未必被普通网页描述充分监督。
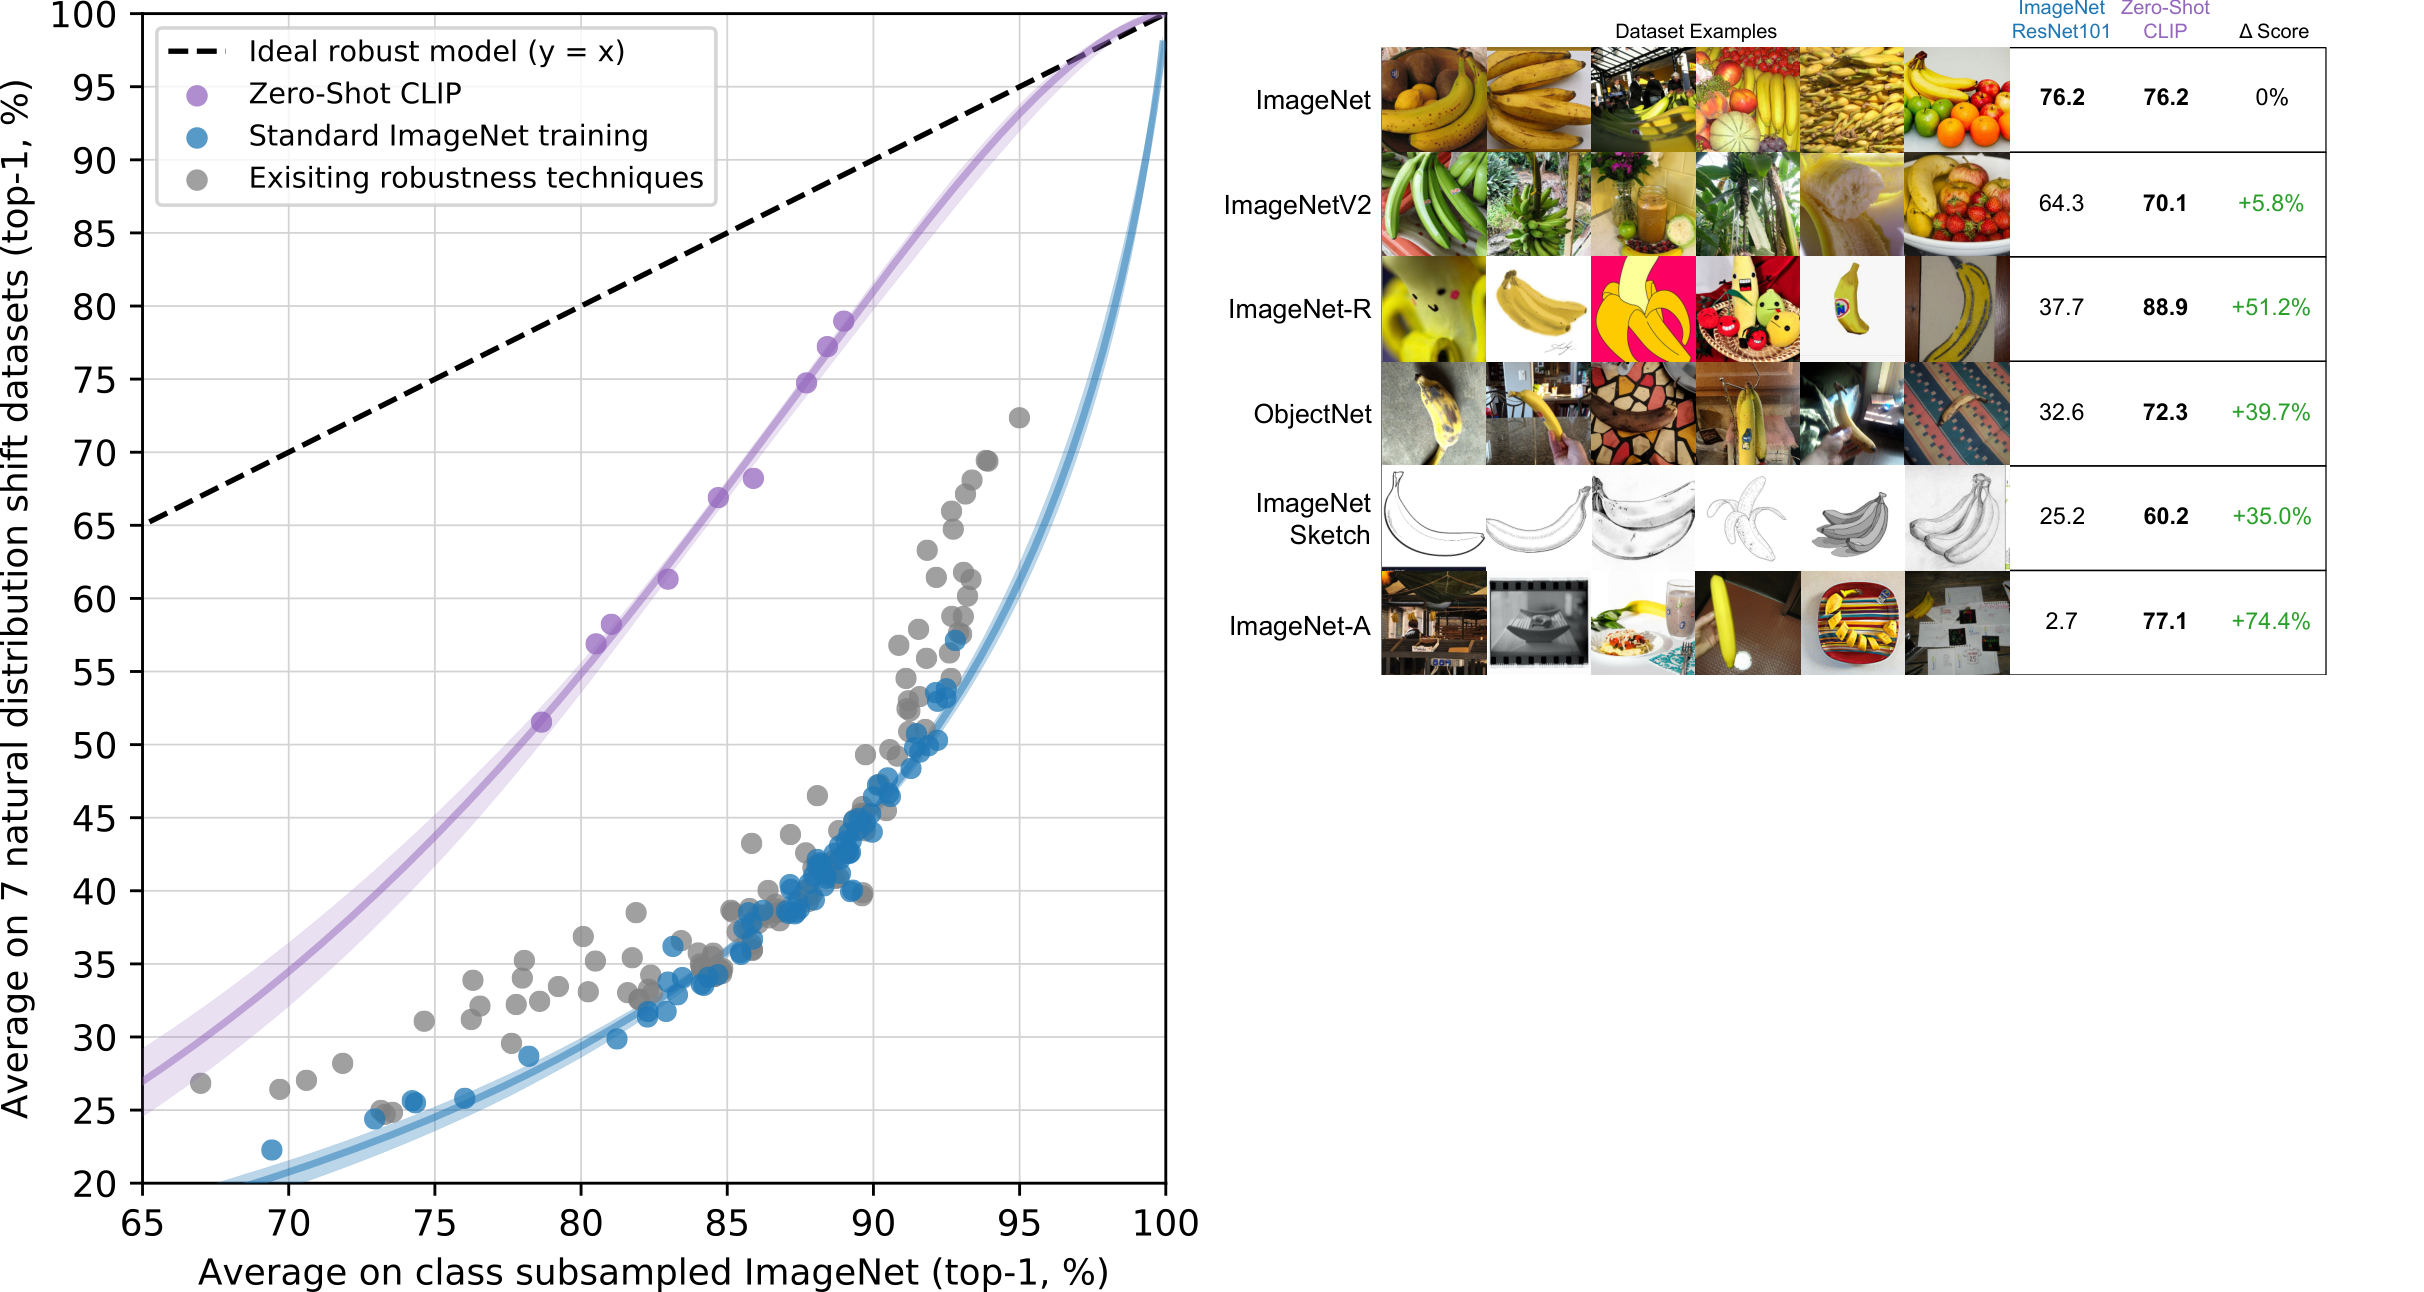
证据四:图13的自然分布变化。 在ImageNet都为76.2%的对照下,ImageNetV2上监督ResNet-50为64.3%,CLIP为70.1%,差5.8个百分点。这是特定自然变化下更强迁移的证据,不是所有扰动或所有新领域下的保证。只控制原数据集准确率仍未控制数据、模型与训练机制的全部差异。
§4还检查预训练与评估的重叠。但海量数据近邻搜索不等于完美查重,移除可疑样本也可能改变测试分布。读者应把这些检查理解为降低污染疑虑的证据,而不是证明任何目标图片都绝不在训练集中。
教学算例。 两对样本的分数矩阵为 。第一张图对正确文字的概率为0.881,第一段文字对正确图的概率却为0.731,因为两个softmax分母不同。若两段文字其实都是同义描述,把非配对项一律当负例也会产生假负例压力。
五、类别描述接口还不具备逐token对话生成
作者选择对比目标,相比生成整段描述更直接优化可迁移的配对表示;图2在其比较配置中支持更高的零样本学习效率,这仍不是对所有生成目标的理论否定。
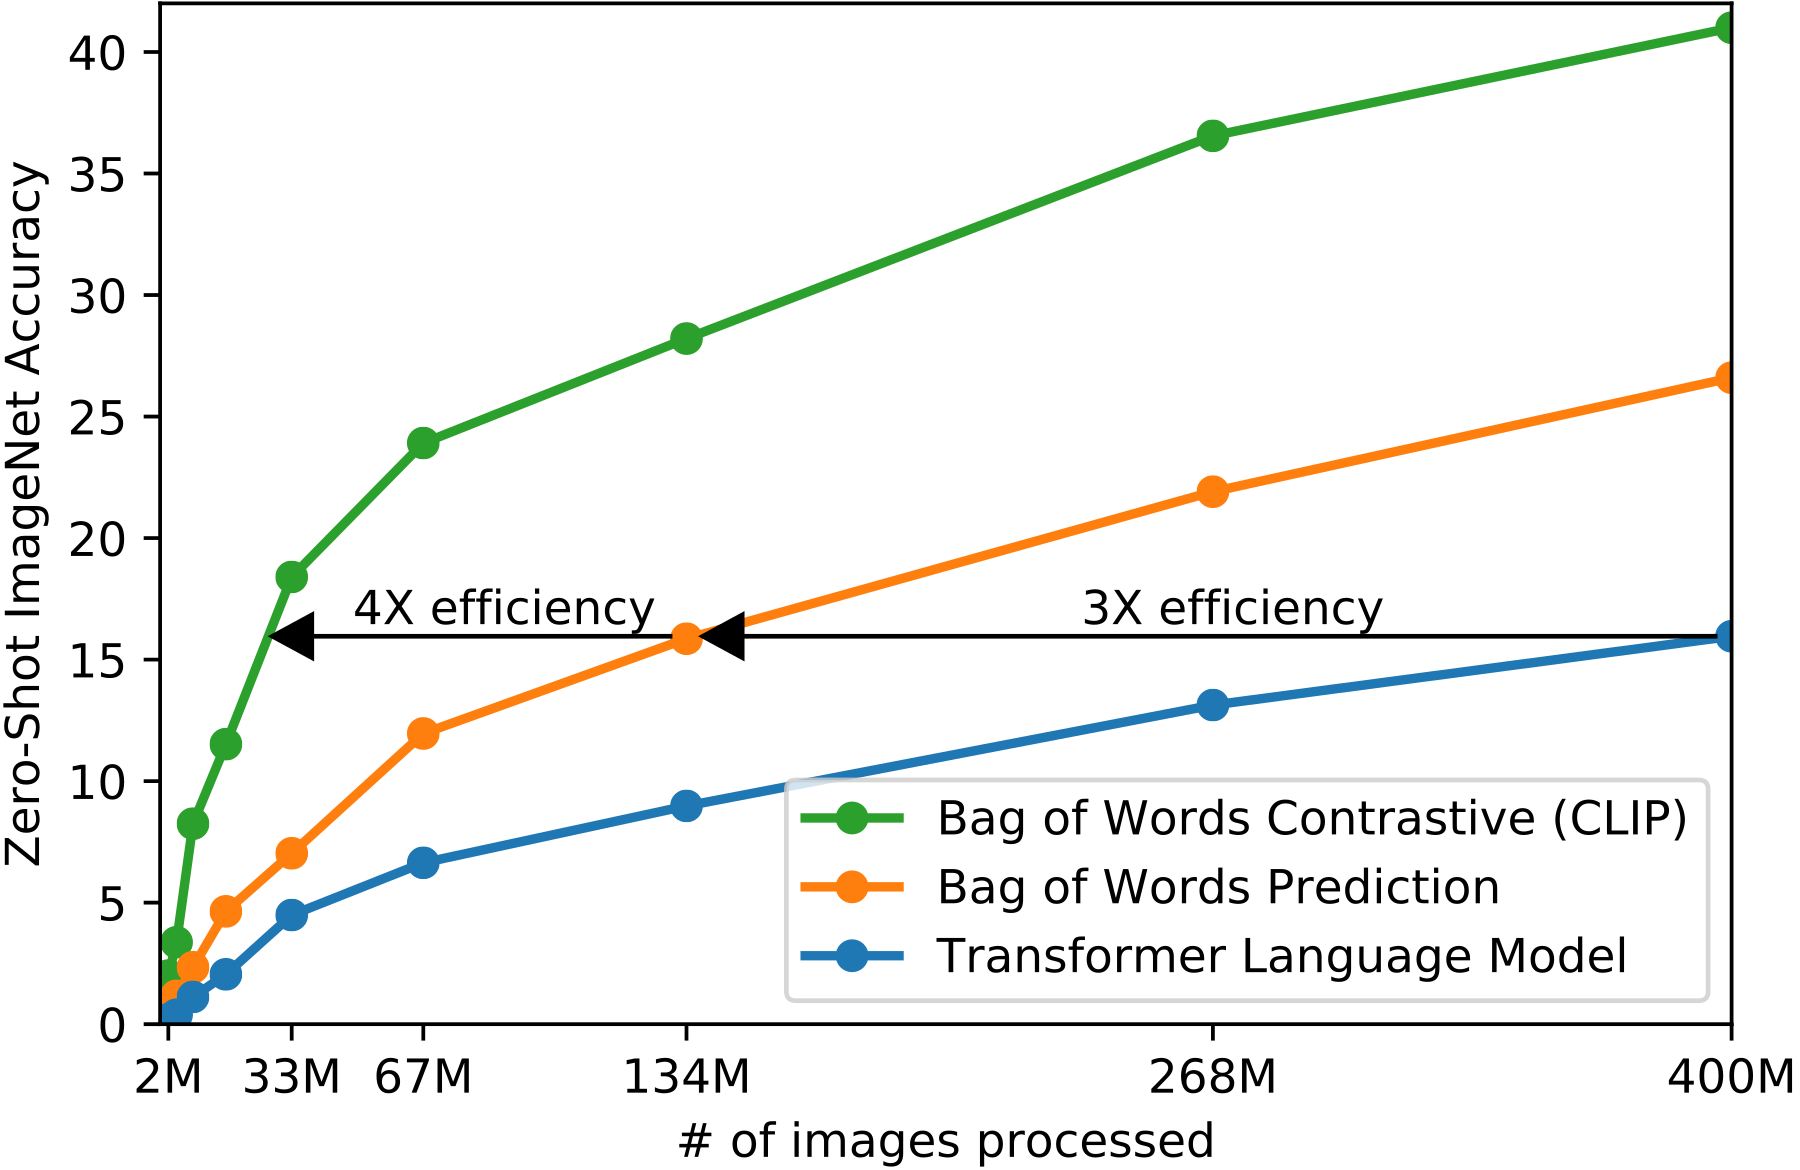
代价包括预训练成本、网络数据覆盖偏差和候选描述敏感性。只比较输入候选并不能保证候选集合完整;给猫图只提供“狗”和“飞机”,系统依然会选一个。这个限制来自分类接口,本身就要求应用给出合理的拒识或评估设定。
六、把图文表示模块接到视觉语言生成
相似度接口能定义新类别,却不会生成对话。Flamingo和LLaVA将视觉表示与语言生成组合;继续读时应检查连接模块与指令监督分别负责什么。
自测与答案
1. CLIP没用ImageNet训练标签,为什么不能说它完全不需要监督?
图文对应关系就是监督信号,网页文字还可能直接包含类别名称。零样本只限定目标任务适配方式,不抹去预训练监督、任务候选和模板信息。公平比较需要同时报告目标标签量与总预训练数据。
2. 为什么相同图片换一组类别描述就能执行新任务?这等于生成模型吗?
训练让文本和图片向量可比较,类别描述的向量可以充当分类器权重,所以不必重训固定输出头。最终仍是在给定候选中比较相似度,没有自回归生成答案的步骤;它可以成为后续视觉语言系统的组件,但两者功能不同。
3. 如果图文检索损失越来越低,为什么计数仍可能很差?
损失只要求正确配对比批内其他配对更像。网页描述常靠对象和场景就能区分,精确数量未必是必要信息;还可能存在共享描述的假负例。需要专门计数数据、控制对象与背景的实验验证,不能由预训练损失直接推出计数能力。