073|GQA:查询头可以很多,历史记忆不必人手一份
论文:Joshua Ainslie 等,GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,2023。论文、正文 v3、论文采用的 Flaxformer。原文主实验是 T5 编码器—解码器模型,不把后来 decoder-only 模型的采用情况当作这篇论文的实验。
图表来源:Joshua Ainslie 等,2023,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
Transformer每个头通常保存独立K/V,长历史解码时反复读取的缓存随头数增长。本篇在完全独立与MQA式单组共享之间引入分组;它可与FlashAttention的内核、vLLM的布局组合,改变的是结构轴。
五个前置概念
五个概念:KV cache存储历史键值避免重复计算;query头决定每次如何读取历史;带宽瓶颈表示时间主要花在搬数据;继续预训练让已有模型适应结构或数据变化;吞吐与延迟分别衡量单位时间总工作量与单次请求等待时间。
一、问题设定:查询头保留多样性时,怎样减少历史KV搬运
缓存避免重复计算历史表示,却不免除下一步读取。若所有查询共享一份K/V,存储更省但表达约束更强;GQA保留多个查询头,调节它们共享多少组K/V,并研究已有MHA检查点怎样低成本适配。
二、定义分组共享并分析均值初始化的非等价性
设查询头数为 ,KV 头数为 。MHA 对应 ;MQA 对应 ;GQA 在两者之间选择。每个查询头仍然有自己的 query 投影,所以共享 KV 不意味着组内所有头产生相同的注意力分布。
对于查询头 ,令 为所属组,其输出为:
是头维度, 是掩码;自回归自注意力使用因果限制。不同 可以针对同一组历史键提出不同查询,因此仍有多种“读取视角”,只是历史信息的写入表示被共享了。
本文不是删掉历史 token,也不缩短上下文窗口。缓存仍然覆盖相同序列,只是每个位置存储的 KV 头更少。它也不同于 FlashAttention:后者主要改变注意力计算与数据搬运组织,GQA 改变参数共享和表示容量。
需要注意原文只对 decoder 自注意力和交叉注意力应用 MQA/GQA,encoder 自注意力保持 MHA。编码器并行处理输入,其性能瓶颈与逐 token 解码不完全相同。
从已有 MHA 检查点转换时,每组的 key/value 投影取组内平均:
是该组的原始头集合。query 和输出投影按转换方案保留。平均值利用全部原始头的信息,是一个初始化选择;因为 softmax 非线性,平均投影后的注意力不等于原先多个注意力输出的平均,所以不能声称这是无损压缩。
随后按原始预训练配方继续训练 比例的步数。主实验取 ,即原预训练步数的5%。没有新的专用 GQA 损失;沿用 T5 的预训练目标,让各层共同适应共享结构。
对于仅考虑 decoder 自注意力的简化计算,设层数 、批量 、历史长度 、每个缓存元素 字节,KV 存储量近似为:
前面的2分别对应 key 和 value。在其他条件相同时,GQA 相对 MHA 的缓存比为 。这是缓存项的关系,不是总显存或总时间的关系;权重、激活、临时工作区和交叉注意力缓存都可能占用资源。
此外,查询头数量没有减少,很多注意力乘法仍然存在。速度改善主要来自内存流量和更合适的并行布局。原文还讨论了 MQA 的单个 KV 头在多分片上复制的浪费;组数适当增加时,逻辑缓存增加不一定按同样比例转化为物理通信和存储增加。
为什么平均 K/V 后还需要继续训练?
即使查询 相同,平均键之后的注意力也不等于原来注意力的平均,因为 softmax 是非线性的。设两个头对两个位置的打分分别为 和 ,它们给第一位置的权重为约 和 ;先分别归一化再平均得到 。先平均键导致打分变为 ,归一化后却为 。即使值向量暂时保持相同,输出也已经改变。
这解释了两阶段适配各自的作用:均值池化给共享 K/V 一个利用原检查点信息的初始化,继续预训练则让查询、共享表示和其他权重适应新约束。原文§3.3也指出,GQA转换后已经具有合理表现,继续预训练进一步改善质量;不能把适配带来的收益提升为“不训练就完全不可用”。它不是把原模型无损重排,也不能仅凭头数减少比例预测模型质量。
自构显存核算,未运行。 对仅计算 KV 缓存的单请求,取 32 层、序列长度 4096、每头维度 128、每数 2 字节。32 个 KV 头需要 字节,即 2 GiB;改为 8 个 KV 组后是 512 MiB。第一个因子 2 表示 K 和 V。查询头数保持 32,并不产生这份历史缓存;权重、工作区、分块浪费和批处理都没有包含在该数值中,因此它是缓存容量下降四倍,不是整个系统显存或延迟下降四倍。
共享键值仍允许两颗查询头读出不同内容
设共享的两个key为(1,0)与(0,1),两颗query分别为(1,0)和(0,1),忽略相同缩放时分数分别为(1,0)和(0,1)。softmax权重彼此交换,因此读取同一份V也会得到不同输出。GQA减少的是历史K/V副本,不是把组内query的计算与表达全部合并。
教法联系:Lilian Weng的Large Transformer Model Inference Optimization。算例为本文自构。
三、转换检查点并继续训练以适应共享约束
输入:已训练 MHA 检查点、组数 G、继续训练比例 α
for decoder attention layer:
    divide H query heads into G groups
    for each group:
        shared_K = mean(original_K_projections_in_group)
        shared_V = mean(original_V_projections_in_group)
    retain query projections and compatible output projection
continue pretraining with original objective and data recipe
finetune on each downstream task
decode with G KV heads and H query heads
输出:经适配的 GQA 模型及其质量/时间测量
数学目标是原任务损失;机制是共享投影与继续训练;指标是下游分数、稳定性和推理时间。“用5%算力”指利用已有模型后的增量适配,不是从随机初始化得到同等模型只需原训练成本的5%。
四、同时读取组数、质量恢复和计时单位
先统一表1和图3的计时口径,再比较组数;继续训练比例与任务质量共同限定“接近MHA”的含义。
| 项目 | 原文设置 |
|---|---|
| 模型 | T5.1.1 Large 与 XXL;主要转换对象为已有 XXL 检查点 |
| 增量训练 | 原预训练数据与配方;5%比例约600 TPUv3 chip-days,不是600天墙钟时间 |
| 下游任务 | CNN/Daily Mail、arXiv、PubMed、MediaSum、Multi-News摘要,WMT14英德翻译,TriviaQA |
| 任务微调 | 学习率0.001、batch128、dropout0.1;训练到收敛,用开发集最好检查点;不是所有任务固定相同更新次数 |
| 长度 | CNN/WMT输入512输出256;其余摘要2048/512;TriviaQA2048/32 |
| 解码 | 贪心解码;主要报告开发集分数 |
| 时间测量 | 8张TPU;每芯片选可容纳的最大batch,最多32;各模型独立优化并行方式;xprof测量 |
| 指标 | 摘要ROUGE-1、翻译BLEU、问答F1;表1平均值混合了不同指标,并非统一的正确率 |
| 重复与稳定性 | 附录A:不稳定任务上的MQA报告3次微调平均;不能扩大为所有模型所有任务都进行了相同重复数 |
这里允许不同模型利用自身更小缓存选择更大批量,是合理的系统吞吐比较,但不是固定 batch、固定并行策略的纯算子消融。若关心交互式低延迟,需要另做 batch1、固定长度和相同硬件配置的实验。
证据一:表1与图3,主要折中。 MHA-XXL、MQA-XXL、GQA-8-XXL 的平均分分别47.2、46.6、47.1;时间1.51、0.24、0.28秒。按表内时间自行计算,MHA/GQA约为5.39倍;这个比值仅适用于该测量。GQA 比 MQA 略慢,但平均分更接近 MHA。 质量—延迟图以每样本平均推理时间为横轴;组数图固定输入2048、输出512。更换生成长度后,不能直接搬用这条延迟比例。
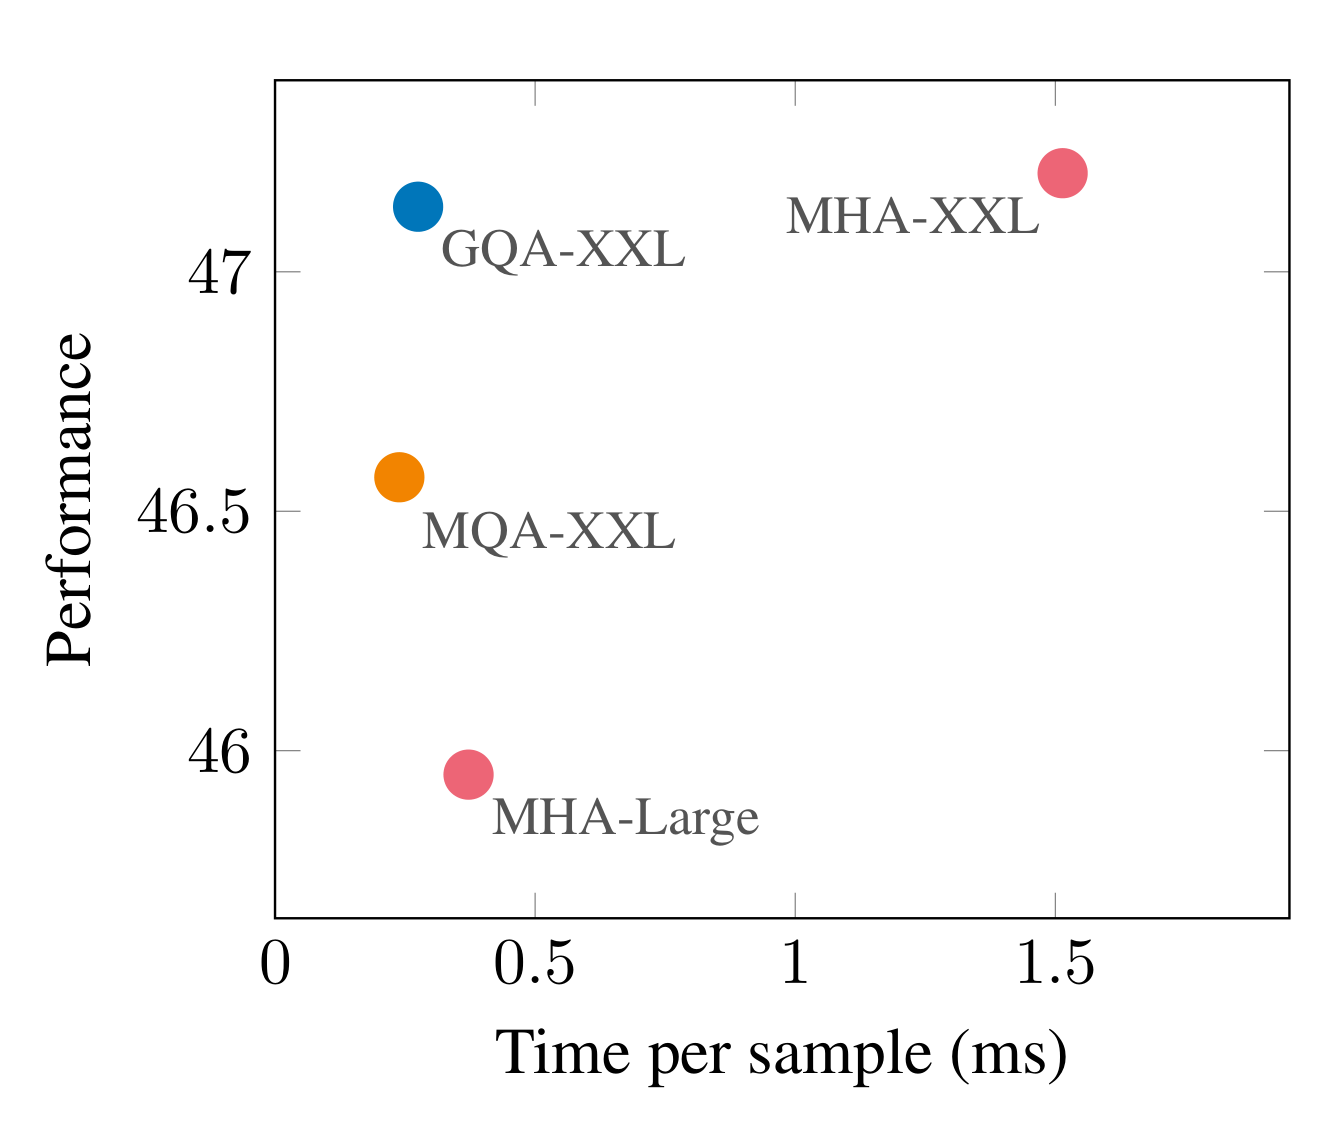
读图时留意单位: 这份 v3 原稿的图3横轴写作 ms,但表1把相同数值标成 s,二者标注不一致。本文的秒数沿用表1;图中只据相对位置比较速度与质量,不把 GQA 的 0.28 解读成 0.28 毫秒。
证据二:表1的分任务结果。 GQA 的 PubMed 为47.7,对比 MHA47.5;TriviaQA为81.6,对比81.9;CNN为43.5,对比43.8。因此“质量接近”不等于每项严格无损,也不能从略高的单项分数推出新结构本身更准确,尤其缺少完整不确定性区间时。
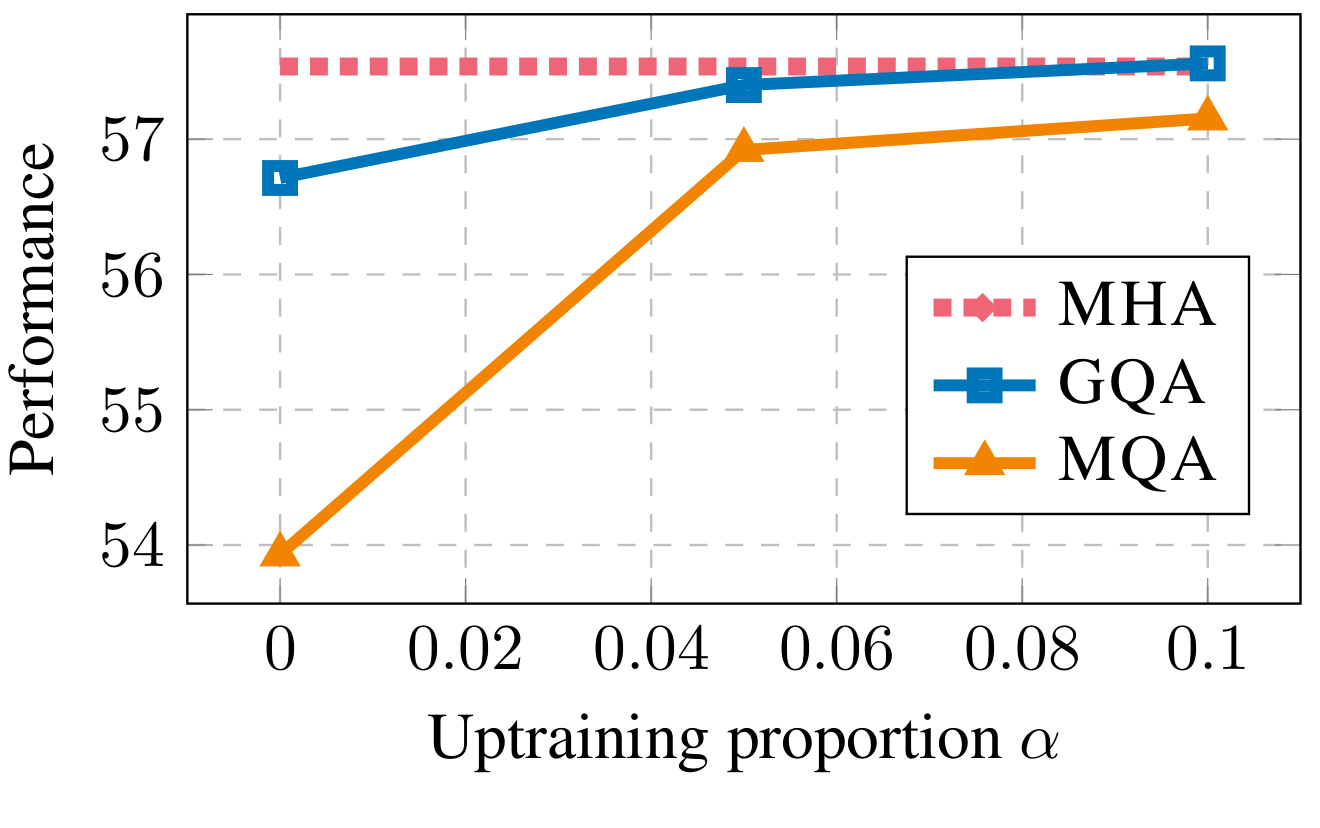
证据三:图4与图5,转换和恢复。 平均原始头的初始化优于保留单头和随机初始化;5%继续训练帮助 MQA 与 GQA,增加到10%的收益递减。这支持“保留已有表示再适配”的路线;图中趋势不能证明5%是其他模型、数据或组数上的最优比例。
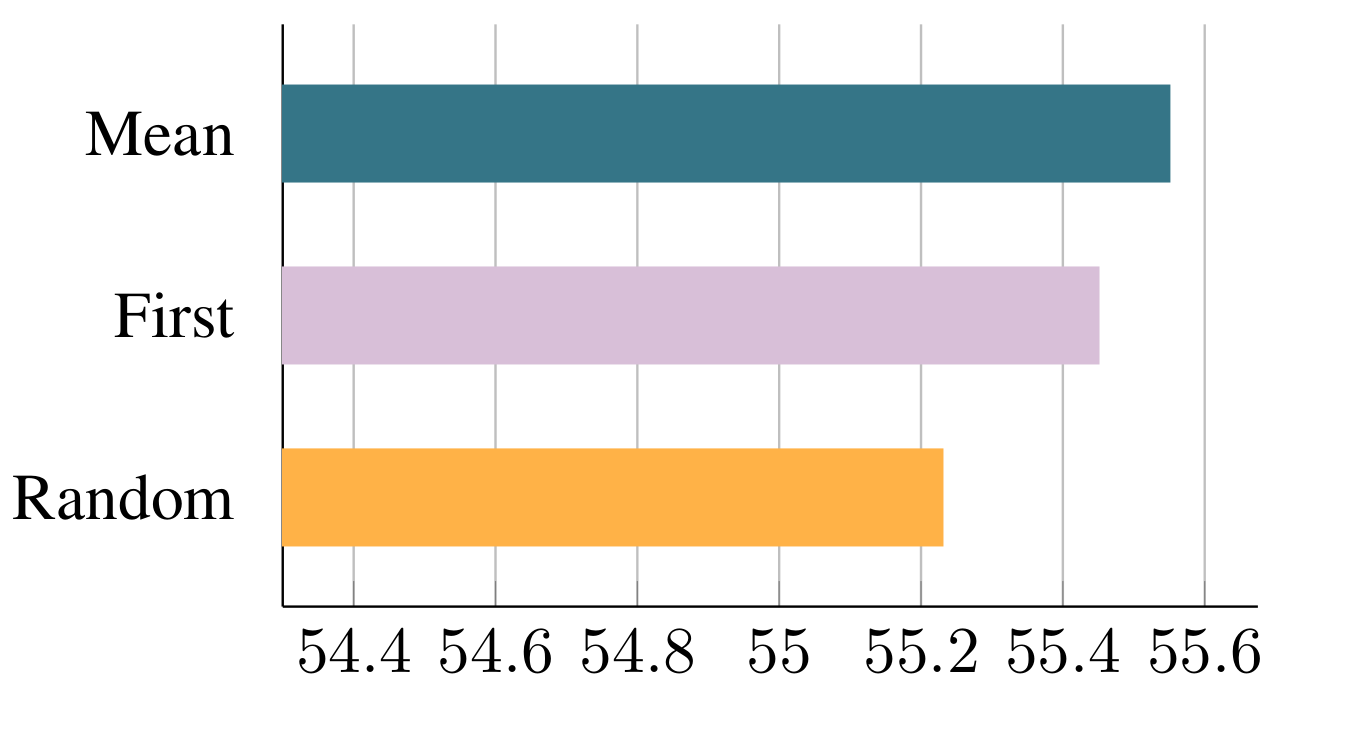
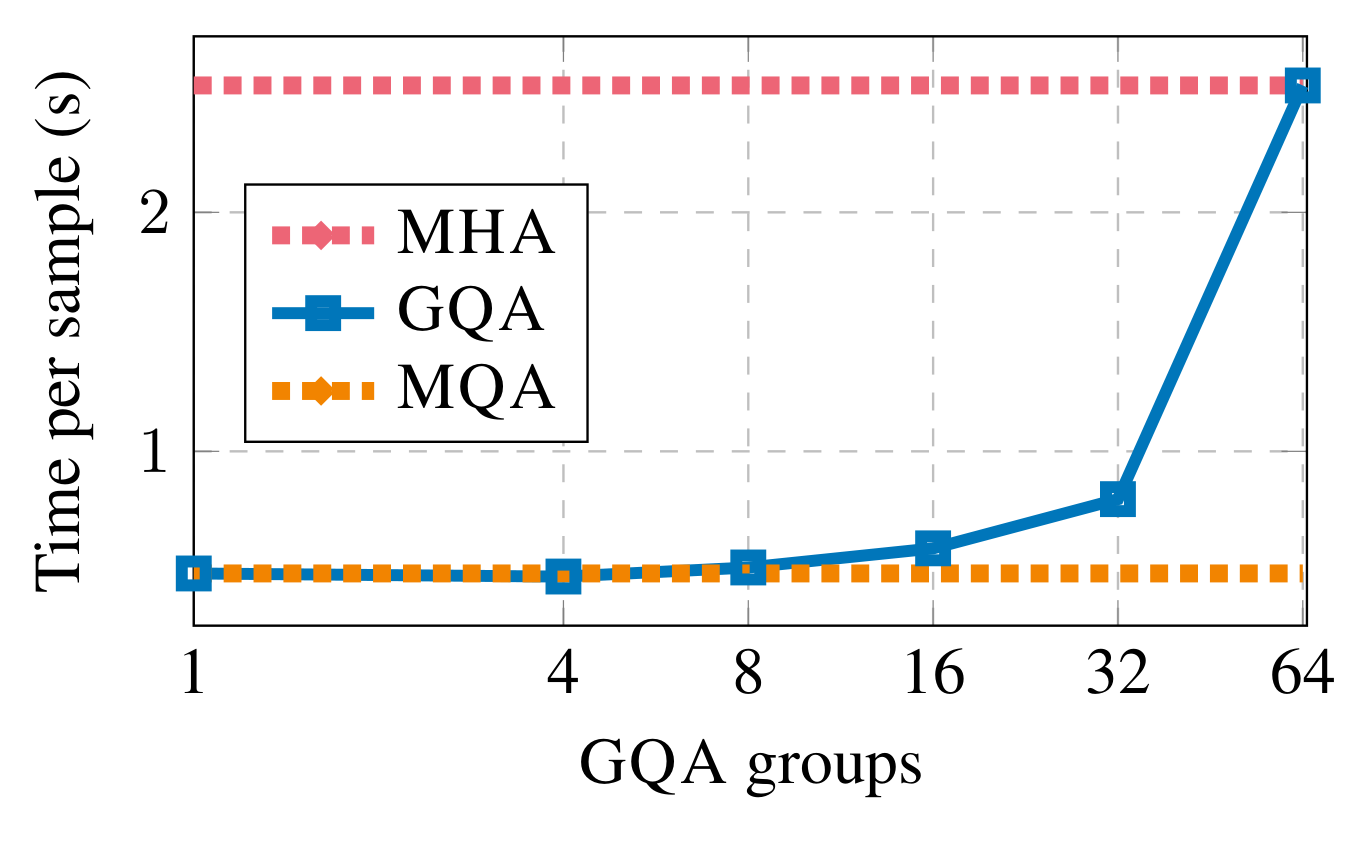
证据四:图6,组数。 在输入2048、输出512的配置下,从1组增加到8组的时间开销较小,接近 MHA 时增加更明显。8组是作者选择的实用折中,不能因为一个后来的模型也使用8个 KV 头,就认为已经得到普适理论常数。
补充证据:附录A。 从头训练的多个 MQA T5-Large 出现损失尖峰,在长输入任务微调中发散;转换后 MQA 更稳定但仍有方差,GQA 看起来稳定。作者没有继续定位根因。因此可以报告观察到的稳定性差异,不能自行解释为“平均头一定消除了某种梯度病态”。
五、缓存四倍压缩不保证整体四倍加速
它让部署约束能够进入模型架构设计,而不必在完全独立的 KV 与完全共享的 KV 之间二选一。
作者承认主实验仅覆盖编码器—解码器结构,没有与从头训练的 XXL GQA 做等预算比较,也承认 ROUGE 不能全面评价生成质量。因此论文没有回答“同样总训练预算下,先训练MHA再转换,是否优于直接训练GQA”。
进一步分析还包括:KV压缩对长序列大批量可能更有价值,但当权重搬运或计算成为主瓶颈时,收益会减弱;转换需要原预训练数据或足够匹配的替代数据;缓存省下来的显存可能用于更大批量,改变延迟与吞吐的折中。质量、总显存和速度应该分别测量。
六、把缓存共享结构与内核、分页组合
共享K/V之后,vLLM继续减少请求间分配浪费,FlashAttention优化读写路径。这是结构、布局与内核三个可组合层次,需在共同负载下重新测整体收益。
自测与答案
1. 同组查询头共享 K 和 V,为什么输出仍然可以不同?
答案:每个头的 Q 仍不同,因而与相同 K 计算出的分数和 softmax 权重不同,可以从同一组 V 中读出不同组合。共享的是历史表示,不是查询方式,也不是最终注意力权重。
2. 把32个 KV 头改为8个,是否等于模型快4倍、总显存少75%?
答案:只在相同条件下,自注意力 KV 缓存项缩小到四分之一。模型权重和其他工作区并未同比缩小,查询相关运算也仍存在。必须测量具体瓶颈,才能预测端到端收益。
3. 为什么不能直接平均头后发布,并宣称和原模型等价?
答案:注意力包含非线性,平均投影不能保持原输出。需要测量转换后的质量并决定所需适配训练;原文图5也展示继续训练的作用。即便均值初始化优于其他方案,也只是好的起点,不是等价性证明。