040 · Performer:不存注意力矩阵,也能近似全局注意力
返回目录 · 上一篇:MMLU · 下一篇:The Pile
论文:Krzysztof Choromanski 等,Rethinking Attention with Performers,首次公开2020,ICLR 2021。原始论文。
先接住前作的问题
Longformer和BigBird通过限制连接省成本,本篇沿平行路线直接近似Transformer的指数核。它保留全局影响的可能,但有限随机特征改变了计算函数;不能把线性复杂度叫作无损精确注意力。
五个前置概念
五个前置概念是:核函数衡量成对相似,随机特征用有限向量近似核,结合律改变矩阵乘法顺序,行归一化让权重求和为一,前缀和保证因果范围。它们也为后来的线性注意力和状态空间模型提供比较语言。
一、问题设定:保留全局交互时,怎样避免显式位置平方矩阵
普通注意力先计算 ,再把行归一化矩阵乘值向量;显式构造 需要平方存储。本篇问能否用较小随机特征近似核,交换矩阵乘法顺序,以近似误差换取全局交互的可扩展计算。
令 、,则 。我们希望找到特征映射 ,使:
于是可以先对所有键和值做摘要,再用每个查询读取:
分子括号内是特征维度乘值维度的矩阵,分母是特征向量,不随序列长度平方增长。数学上只是结合律,但前提是原来的指数核已经用可分解特征表示近似;不能直接对softmax矩阵随意交换运算。
二、从随机核特征推导结合律计算与归一化误差
教学性地,若 ,定义:
利用高斯矩母函数,有 。是随机特征数,越大通常估计方差越小,但计算和存储增加。上述独立高斯形式便于理解,FAVOR+进一步采用正交化随机特征及相关变体改善方差和效率。
正值特征避免某些三角随机特征在分母中出现正负抵消的问题,但指数运算仍可能溢出或数值不稳,需要恰当的稳定实现。正交特征降低估计误差,不等于每次随机采样都优于所有独立采样。
尤其要区分:未归一化核估计无偏,不自动推出归一化输出也无偏。随机变量的比值期望通常不等于期望的比值。论文的核估计、收敛和误差保证各有条件,不能简化为“最终注意力完全无误差”。
线性计算来自结合律,近似误差来自特征映射
令 分别为位置 的查询与位置 的键、值, 为序列长度。以 维随机特征 近似指数核后,输出为 ,其中 、。先累积S和z再处理每个查询,不构造n×n矩阵;因果版本仅用j≤i的前缀累积。核估计的无偏性不自动推出除法后归一化输出也无偏,因为对随机分子 与非零随机分母 ,一般 ;各期望还须存在。
教学算例。 假设特征已经给定,两个键特征为 、,标量值为3、5,则 。查询特征 的输出为13/3,等价于按核权重1和2加权两值。这里仅验证重排计算,不声称这组人工特征已精确近似某个softmax核。
自构序列有一千个键,但当前查询只与其中一个高度匹配。softmax可能形成很尖锐的分布,有限特征近似则可能把较小质量分配给其他键。若输出依赖精确复制一个位置,即使总体MSE不大,也可能选错答案。
先比较关联顺序,再比较核近似
取4个token、特征映射宽度3、值宽度2。先算特征键转置乘V得到3×2,再由4×3查询特征乘它得到4×2,避免显式4×4矩阵。这个重排是结合律;换不同随机特征后输出仍会变化,是核近似造成的。把两种误差分开测,才能定位实现问题。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、固定特征数、数值尺度与因果前缀累积
输入:Q、K、V,随机特征数m,正交随机映射
缩放Q和K,使点积对应原softmax温度
计算正值特征PhiQ、PhiK
若双向注意力:
    S = transpose(PhiK) @ V
    z = sum(PhiK, sequence_axis)
    输出 = (PhiQ @ S) / (PhiQ @ z)
若因果注意力:
    按位置维护S和z的前缀累计
    每个查询只读取截至当前位置的累计值
按数值稳定规则归一化,接回残差与前馈网络
训练时可按方案重采样随机映射
输出:近似全局注意力结果
双向累计不能直接用于自回归预测,否则会把未来键值泄漏给当前输出。前缀累计还存在内存与并行度取舍:存全部前缀便于并行,串行维护一个状态更省内存。这是算法与实际训练系统之间的重要连接。
四、分开看硬件收益、近似方差与OOD表现
速度上界、固定长度近似误差与下游OOD结果不是同一实验,分别阅读才可解释取舍。
| 项目 | 论文设置与需要回答的问题 |
|---|---|
| 任务 | 像素预测、PG-19文本、TrEMBL蛋白序列等;单序列与拼接长序列分别分析 |
| 主要替换 | 通常只替换注意力部分,其余骨干保持一致;某些内存受限长任务不得不缩小全注意力基线 |
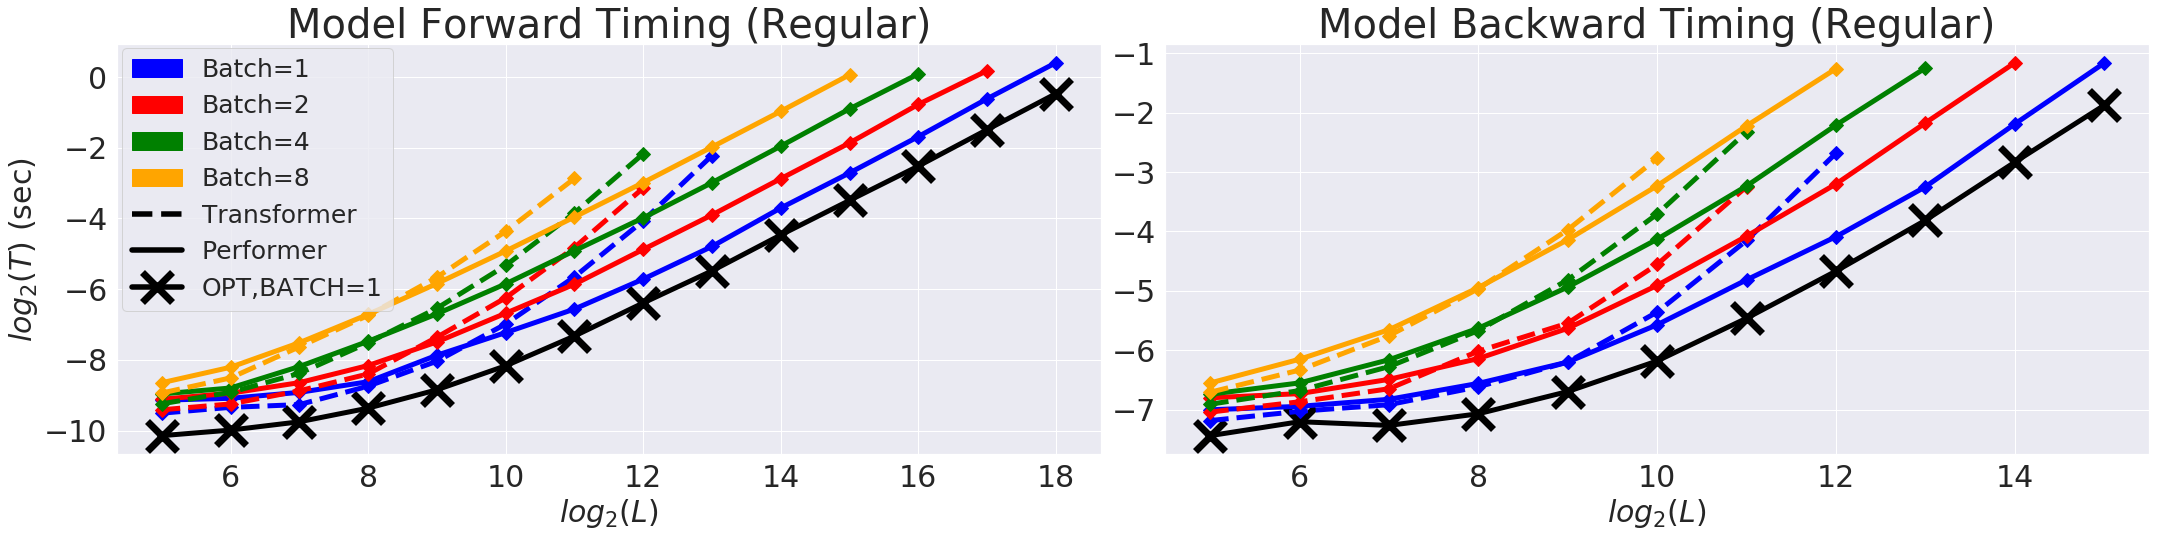
| 速度实验 | 图3在16GB V100上比较前后向速度与可运行长度,默认6层、8头、隐藏512、FFN2048 |
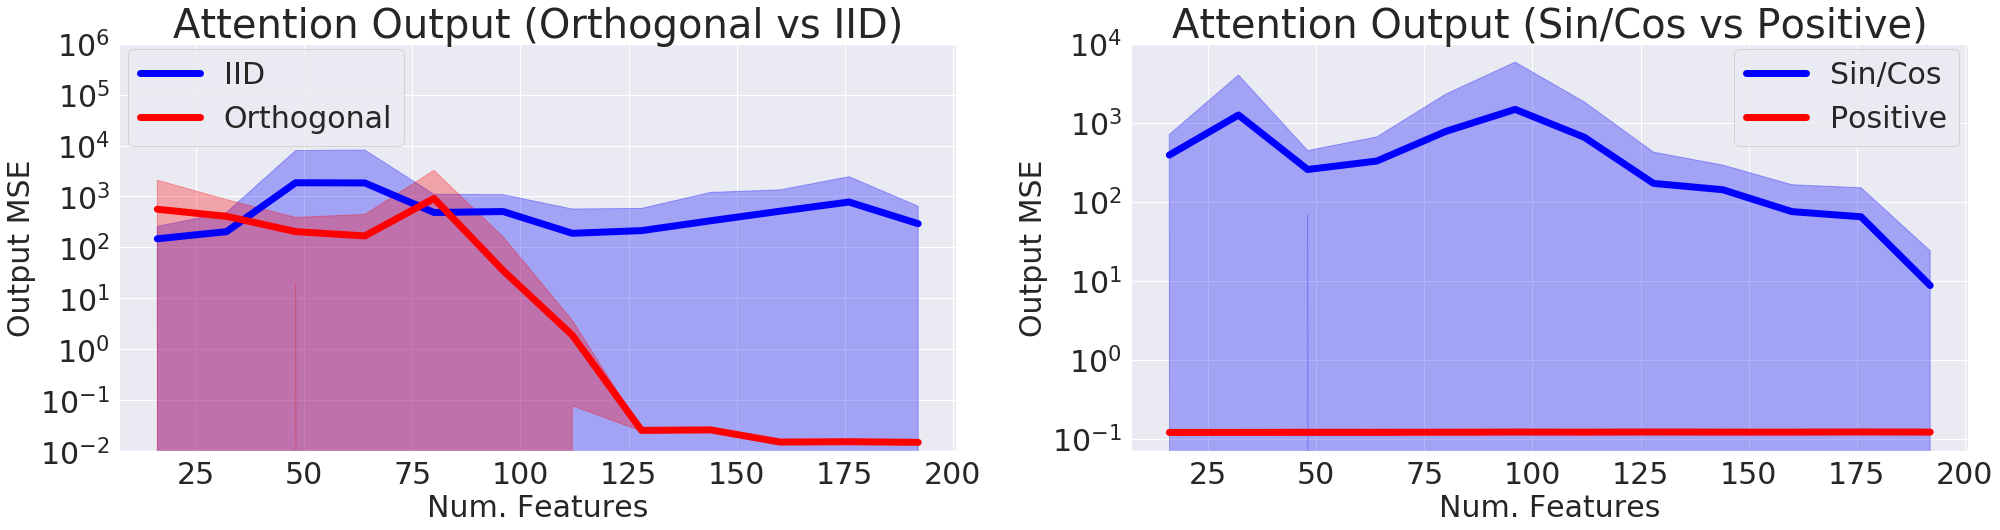
| 近似实验 | 图4使用长度4096、维度16,改变随机特征数量;15次随机输入采样报告标准差 |
| 训练设置 | 附录A默认Adam固定学习率、dropout0.1、梯度裁剪0.5;批量按设备可容纳范围调整 |
| 蛋白划分 | 附录C区分随机IID与保留部分Pfam家族的OOD;作者说明并不保证严格序列距离隔离 |
| 指标 | 核/输出近似MSE、任务准确率与PPL、内存和速度;不能用近似误差代替泛化质量 |
大部分实验不是严格同墙钟、同批量、同容量三者同时相等的比较。特别是长度8192拼接蛋白任务,全注意力基线被迫缩小,而Performer可用更大模型。该结果说明内存预算内的系统优势,不是单独证明同容量下注意力机制更准确。
可做未执行实验:固定Q/K/V与随机种子集合,改变特征数、查询键范数和分布尖锐度,记录归一化输出误差、最大位置是否一致、耗时和峰值显存。它能解释哪些输入更难近似,而不是只测一组平均随机矩阵。
证据一:图3,结合律产生实际资源收益。 图中随长度增长,Performer可以在更长序列运行,并改善前后向成本。图还给出把注意力直接返回V的理想参照,提醒读者其他网络组件仍有不可消除成本。结论绑定具体实现与16GB V100,不能外推为所有长度和硬件的固定倍数。 速度图中的 OPT 是注意力直接返回 V 的理想参照;近似误差图另固定序列长4096、维数16并改变随机特征数。速度上界与近似质量不能混读。
证据二:图4与§2–3,特征设计确实影响误差。 正特征相对三角特征、正交相对独立特征在所测条件下具有更低误差,15次采样标准差体现随机性。它支持FAVOR+的设计,而非说明一次近似可无损替换任意预训练模型;必要时仍需适配训练。
证据三:附录C表2,IID收益与OOD退步。 双向蛋白任务中,Transformer测试准确率33.32,generalized Performer36.09,softmax Performer33.00;OOD分别25.07、24.10、23.48。更好IID分数没有自动转化成更好家族外表现,且generalized核不是同一softmax近似目标,必须分列解释。
论文还研究其他可核化注意力,例如ReLU形式。若这类模型分数最好,只能支持替代核在该任务上有效,不能把它当作“softmax近似更精确所以分数更高”的证据。核选择与近似质量是两个实验变量。
五、低维摘要和随机误差仍影响精细读取
再把该分析接到复制与检索任务,比较从头训练和从全注意力权重直接替换两种设置。若直接替换失效、适配后恢复,说明模型可以学会补偿近似,但不能宣称原函数保持完全不变。训练适应与数学近似应分别报告。
限制包括特征数与精度取舍、数值稳定、因果实现的并行成本,以及不同数据分布中的泛化差异。它保留全局交互的可能性,却压缩了键值摘要,某些精细检索任务可能受影响。
原文对这一比较另有具体限定:普通注意力可写成 ,输出为行归一化后的 。如果先构造 ,就需要平方规模存储。。
六、以随机近似对照稀疏图和精确IO优化
线性核近似改变函数,FlashAttention则保留稠密函数并优化搬运。比较两者时应分别测近似误差、保存空间、FLOPs和墙钟时间,不能只用“快速注意力”统一归因。
自测与参考答案
1. Performer为何不是把注意力矩阵直接低秩分解一次?
它用可计算的核特征映射近似成对相似度,不需要先生成原矩阵再分解。节省来自提前构造特征并改变乘法顺序。
2. 核估计无偏,最终输出是否也无偏?
不自动成立。最终输出包含随机分子除以随机分母,期望与除法一般不能交换。必须使用相应误差或收敛分析,不能省略归一化。
3. generalized Performer分数更高,是否证明softmax近似更准确?
不是。generalized版本可以选择另一种核,改变了目标注意力本身。任务质量、核形式与近似误差需要用不同对照分析。