039 · MMLU:模型的平均分掩盖了哪些知识盲区
返回目录 · 上一篇:BigBird · 下一篇:Performer
论文:Dan Hendrycks 等,Measuring Massive Multitask Language Understanding,首次公开2020,ICLR 2021。原始论文。
先接住前作的问题
GPT-3展示few-shot迁移,却还需要比少数任务更广的知识与问题求解测量。本篇转向评估而非训练创新:用多学科选择题追问模型会什么、不擅长什么,以及答题信心是否可信。TruthfulQA与GSM8K是互补测量。
五个前置概念
五个前置概念是:基准定义统一测试,few-shot在上下文提供示例,加权平均决定不同题群的影响,校准连接概率与频率,分布偏移改变训练和测试关系。记住这些,比背住某代模型的一个总分更有助于阅读后来的评价论文。
一、问题设定:流畅续写之外,怎样测量跨学科知识应用
既有常识或语言任务高分,不能保证模型会应用数学、法律、医学和历史规则。本篇用57个学科、不同难度的选择题检查预训练知识能否被调用,不为每个学科提供大规模训练;目标是测量能力分布,而非授予职业资格。
题目涵盖人文、社会科学、STEM与其他领域,包含高中、大学和专业层次。它们要求的能力并不统一:有些偏事实回忆,有些要求计算,还有些涉及规范或场景判断。总体分数是这些不同能力的混合指标。
原文从公开资料人工收集题目。因此“没有在MMLU上微调”不意味着从没见过题目来源;模型可能在预训练时接触相同考题、解释或改写。知识学习是测试本来想测的东西,逐题记忆则可能夸大迁移,二者需要区分。
二、先定义题集、聚合权重与置信度校准
§3报告总共15,908题,少样本开发集每学科5题,验证集1,540题,测试集14,079题。三个分项按文字相加与总数存在细小不一致:。这应记录为原文计数口径疑点;严格复现应以固定版本的数据文件和脚本为准,不能悄悄修改原文数值。
GPT-3评估为每个学科使用固定示例,提示以任务说明、示例、待答选择题和答案前缀组成。模型对A/B/C/D候选token评分,选择最高概率者。UnifiedQA的输出则按与选项的文本重叠转换成选择。这些读出方式不同,比较时需要保留。
设第 题正确选项为 ,候选分数为 ,则:
如果按全部题目统计,大题量学科权重更高;如果先算每学科准确率再平均,则各学科等权。论文表1明确写加权准确率,复现不能在不说明时换成另一种平均。
教学算例。 学科A有100题答对90题,B有10题答对1题;按题准确率82.7%,按学科则50%。另有四选一猜测基线25%,但不能把高于25%的部分直接当“真正理解比例”:题目相关、格式偏好和训练污染都会影响这种解释。需要学科分布和独立测试检查。
一个系统若给大量回答80%的信心,那么这类回答实际应约有80%正确,才称得上良好校准。它和准确率不同:总是信心十足的模型可以较准却不校准;谨慎但能力弱的模型也可能校准较好。
教学性地,令预测置信度为 、正确性为 ,可把样本分组后比较每组 和。原论文图8主要比较各学科平均信心与准确率,还报告RMS校准误差。不要把它误读成每个回答的误差都同样大。
总分要同时报告估计单位和题目分布
对学科s有 题、答对 题,按题汇总为 ,按学科等权则为 。其中 为学科总数。两者回答不同问题:随机抽一道题的表现,或随机抽一门学科的平均表现。跨实现复查总分时应确认采用哪种聚合、示例数、选项打分及异常输出规则,不能只复制一个百分比。
同一总分差先问是几道题的翻转
自构100题中,模型A对60题、B对62题;若B修好A的12题又弄错其10题,净增仍只有2题。独立均分掩盖了大量题级交换。比较知识领域时,保留配对正确/错误账本,再按题目或学科的声明单位估计不确定性,比只比较两位小数更能定位改进。
三、固定few-shot样例、候选评分和数据版本
输入:固定版本题库、学科示例、待评估模型
对每个学科:
    取规定的最多5个示例,构造固定提示模板
    对每道测试题,附加题干与四个选项
    读取答案候选得分,按规定选项映射得到预测
    保存预测、正确标签、置信度与提示长度
计算逐学科和明确加权方式的总准确率
比较平均置信度与实际正确率,检查错误类型
输出:分组成绩与校准分析;不使用测试题调参
对于自测式复现,候选概率是否在四个选项内重新归一化、答案前是否带空格、选项是否为单token,都需要记录。否则同一模型可能因为评估实现变化得到不同分数。
四、同时读总体成绩、分科缺口与信心曲线
平均分、学科差异和校准曲线回答三种问题,不能用一个总分替代可靠性。
| 项目 | 原论文设置与要验证的问题 |
|---|---|
| 题库 | 57学科,四选一,来自公开考试练习和教学资料;随机基线25% |
| 模型 | GPT-3四档规模、UnifiedQA,以及附录中的RoBERTa、ALBERT、GPT-2对照 |
| 监督条件 | GPT-3零/少样本不更新参数;UnifiedQA已在其他问答数据微调,测迁移 |
| 预算 | 主要是模型推理评估,GPT-3最多5个示例;非统一算力预算下重新训练所有模型 |
| 指标 | 加权准确率、逐学科表现、平均信心与校准误差 |
| 人类参照 | 非专业众包与估计专家水平不同;专家89.8%是综合考试资料及部分估计,非同一专家群完整实测 |
| 不确定性 | 固定少样本示例提高协议一致性,但没有覆盖全部提示重采样方差;主表单值不可直接宣称差异显著 |
评测论文不适用“算法优化了奖励”这类问题。它的优化对象是测量设计与诊断能力;方法好坏应看覆盖、区分度、可重复性与偏差,而不是是否让模型分数更高。
自构两模型都在100道题答对60道。模型A每题给60%信心,模型B每题给99%。准确率相同,B的概率承诺明显更不可靠。但A是否真正校准,还需检查不同样本子组:它可能在数学全错、历史全对,平均值掩盖了结构性差异。
第三个诊断是允许弃答,绘制覆盖率与保留样本错误率的关系。若信心排序有效,少回答一部分题应能降低错误率;若无明显改善,则平均置信度并不足以支持可靠选择。该方案是教学延伸,不是原论文已经给出的部署系统。
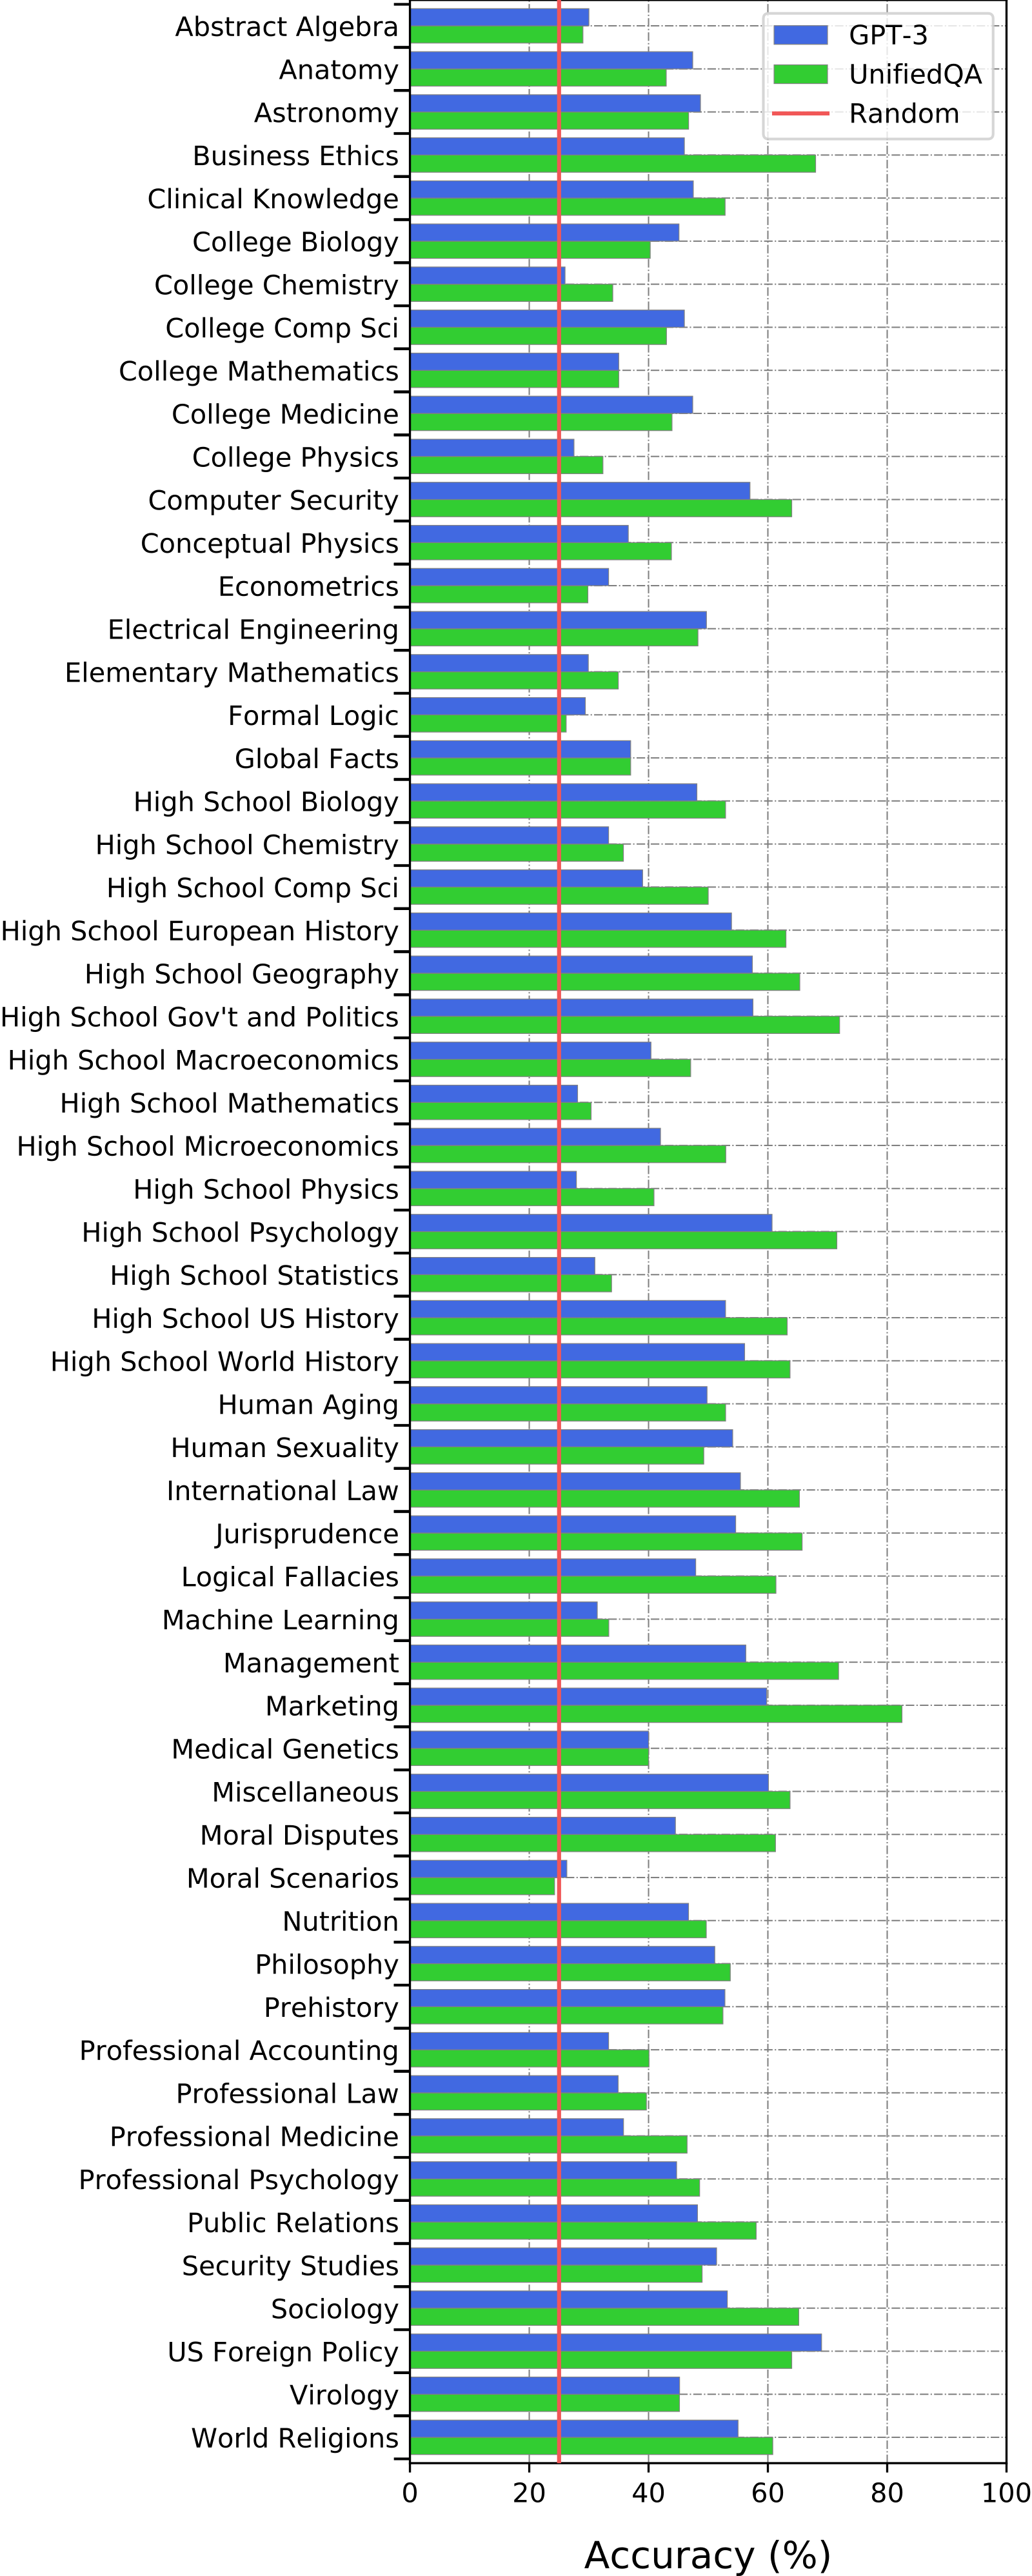
证据一:表1,规模并不能独立解释表现。 GPT-3最大模型少样本加权准确率43.9%,小三档约25%;UnifiedQA为48.9%。最大GPT-3超过随机18.9个百分点,却仍落后于有问答迁移训练的UnifiedQA。这里不能由参数差异推出谁的架构天然更好,因为训练目标和监督资源不同。
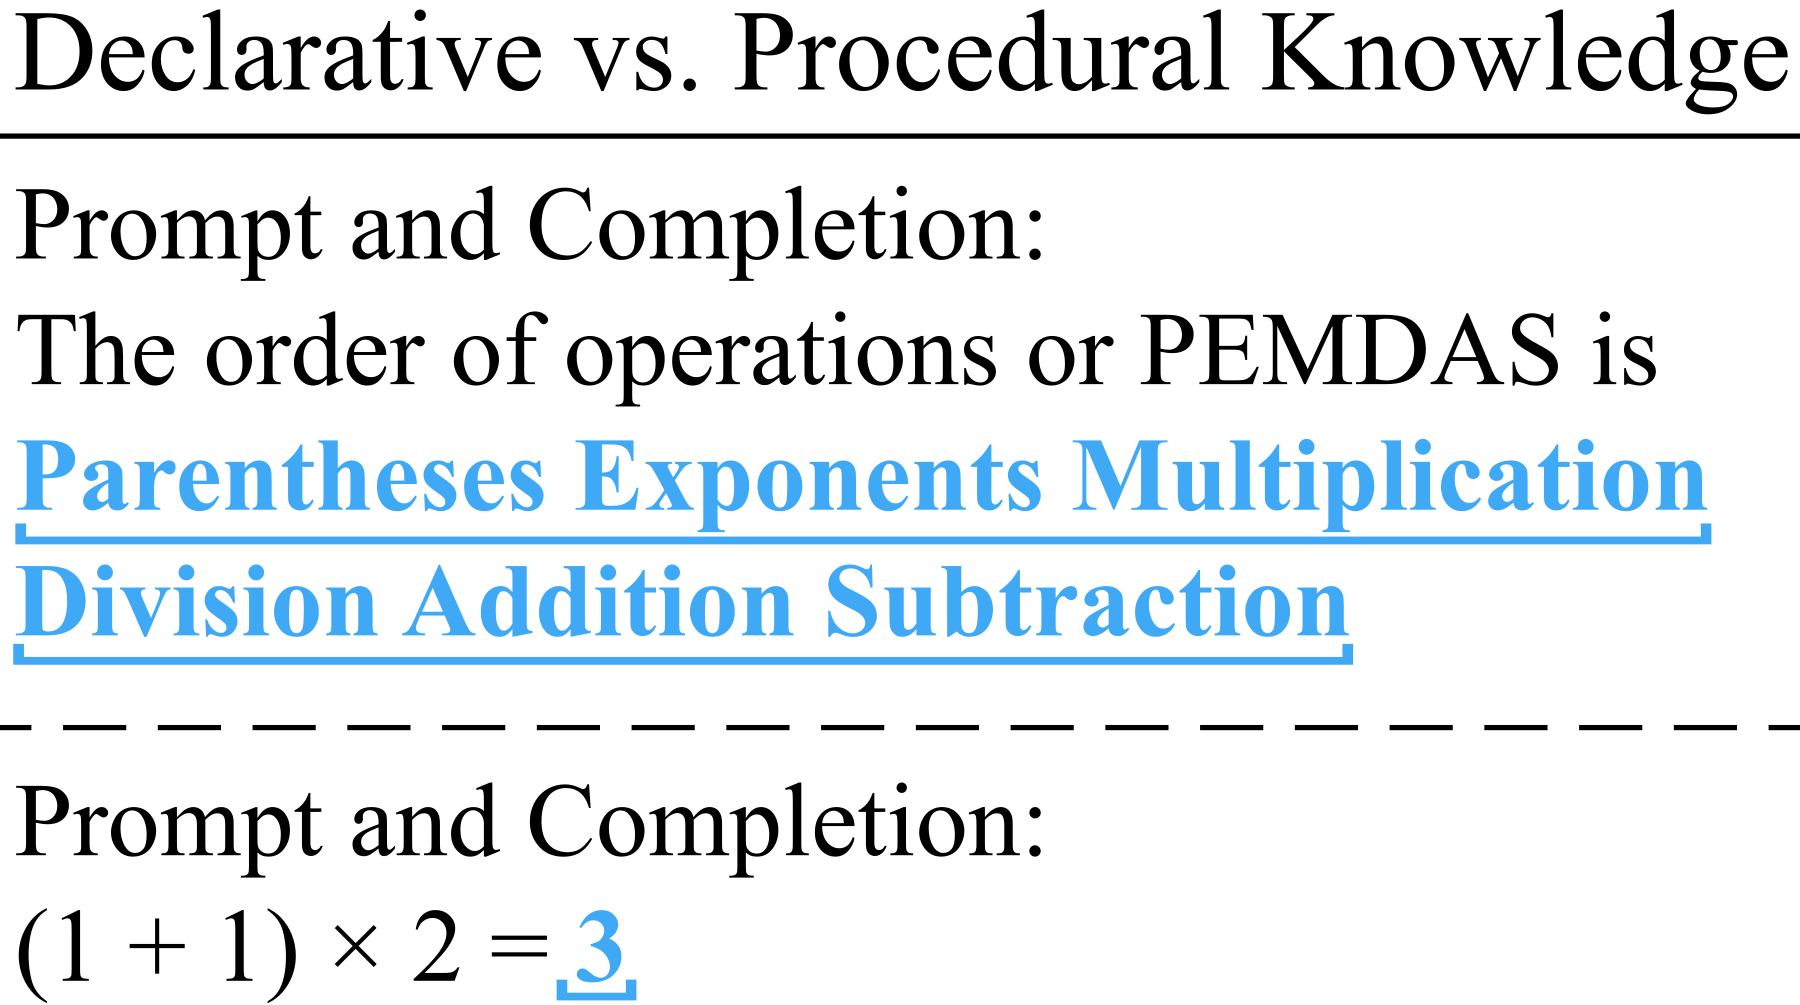
证据二:图6、图7,能力并不均衡。 GPT-3不同学科跨度很大,计算密集型领域较弱。正文列大学医学47.4%、大学数学35.0%、小学数学29.9%,说明名称上的教育层级不一定对应模型难度。图7能复述运算优先规则却算错的例子支持“知道规则与应用规则有区别”的直觉,但单个例子不是所有推理错误的完整机制证明。 准确率分科图、生成示例和置信校准图回答不同问题。校准图要比较信心与实际正确率的偏差,不能只看哪个模型给出的概率更高。
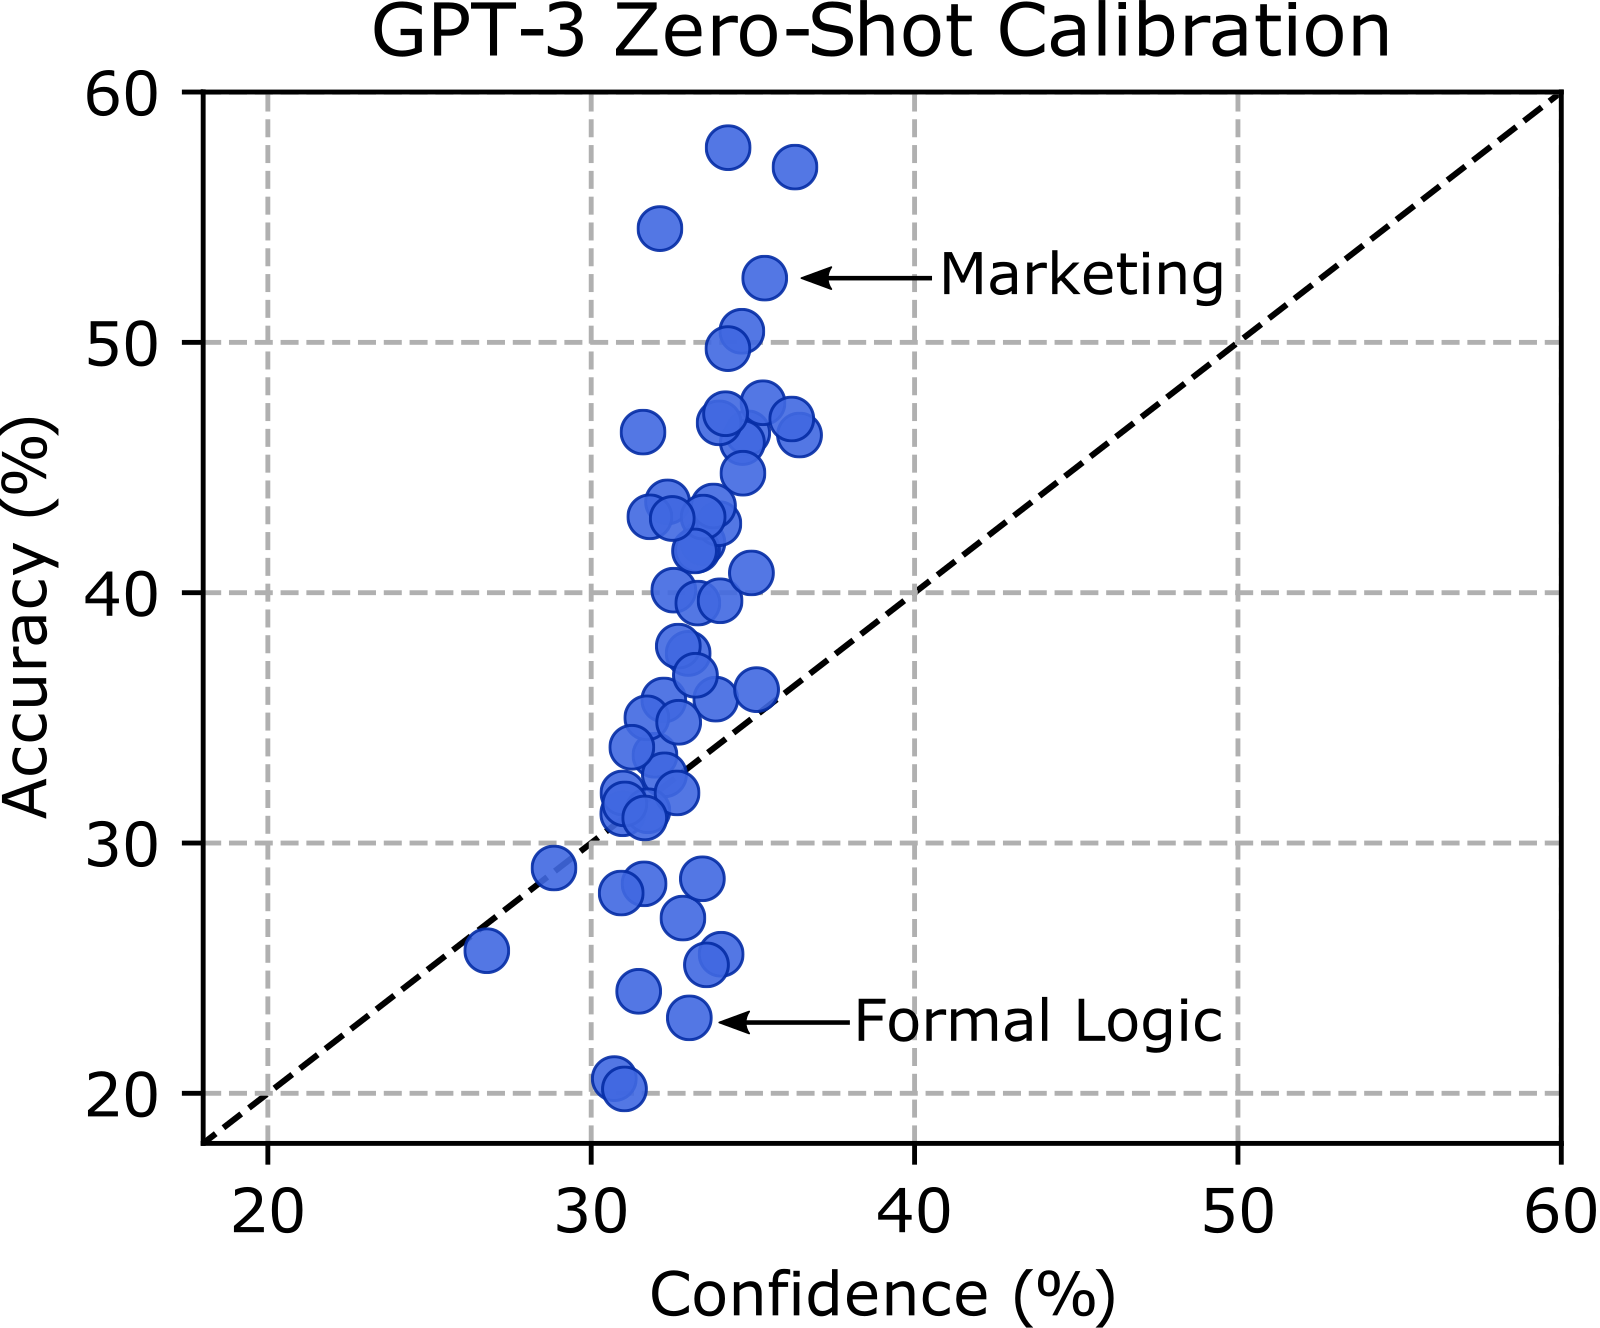
证据三:图8与图11,信心不可靠。 零样本某些学科的平均信心与准确率差距达到24个百分点;少样本虽改善,仍存在明显差距。这支持需要校准研究,而非说明只要降低输出语气就能解决。模型概率、自然语言自信表述与真实正确率是不同信号。
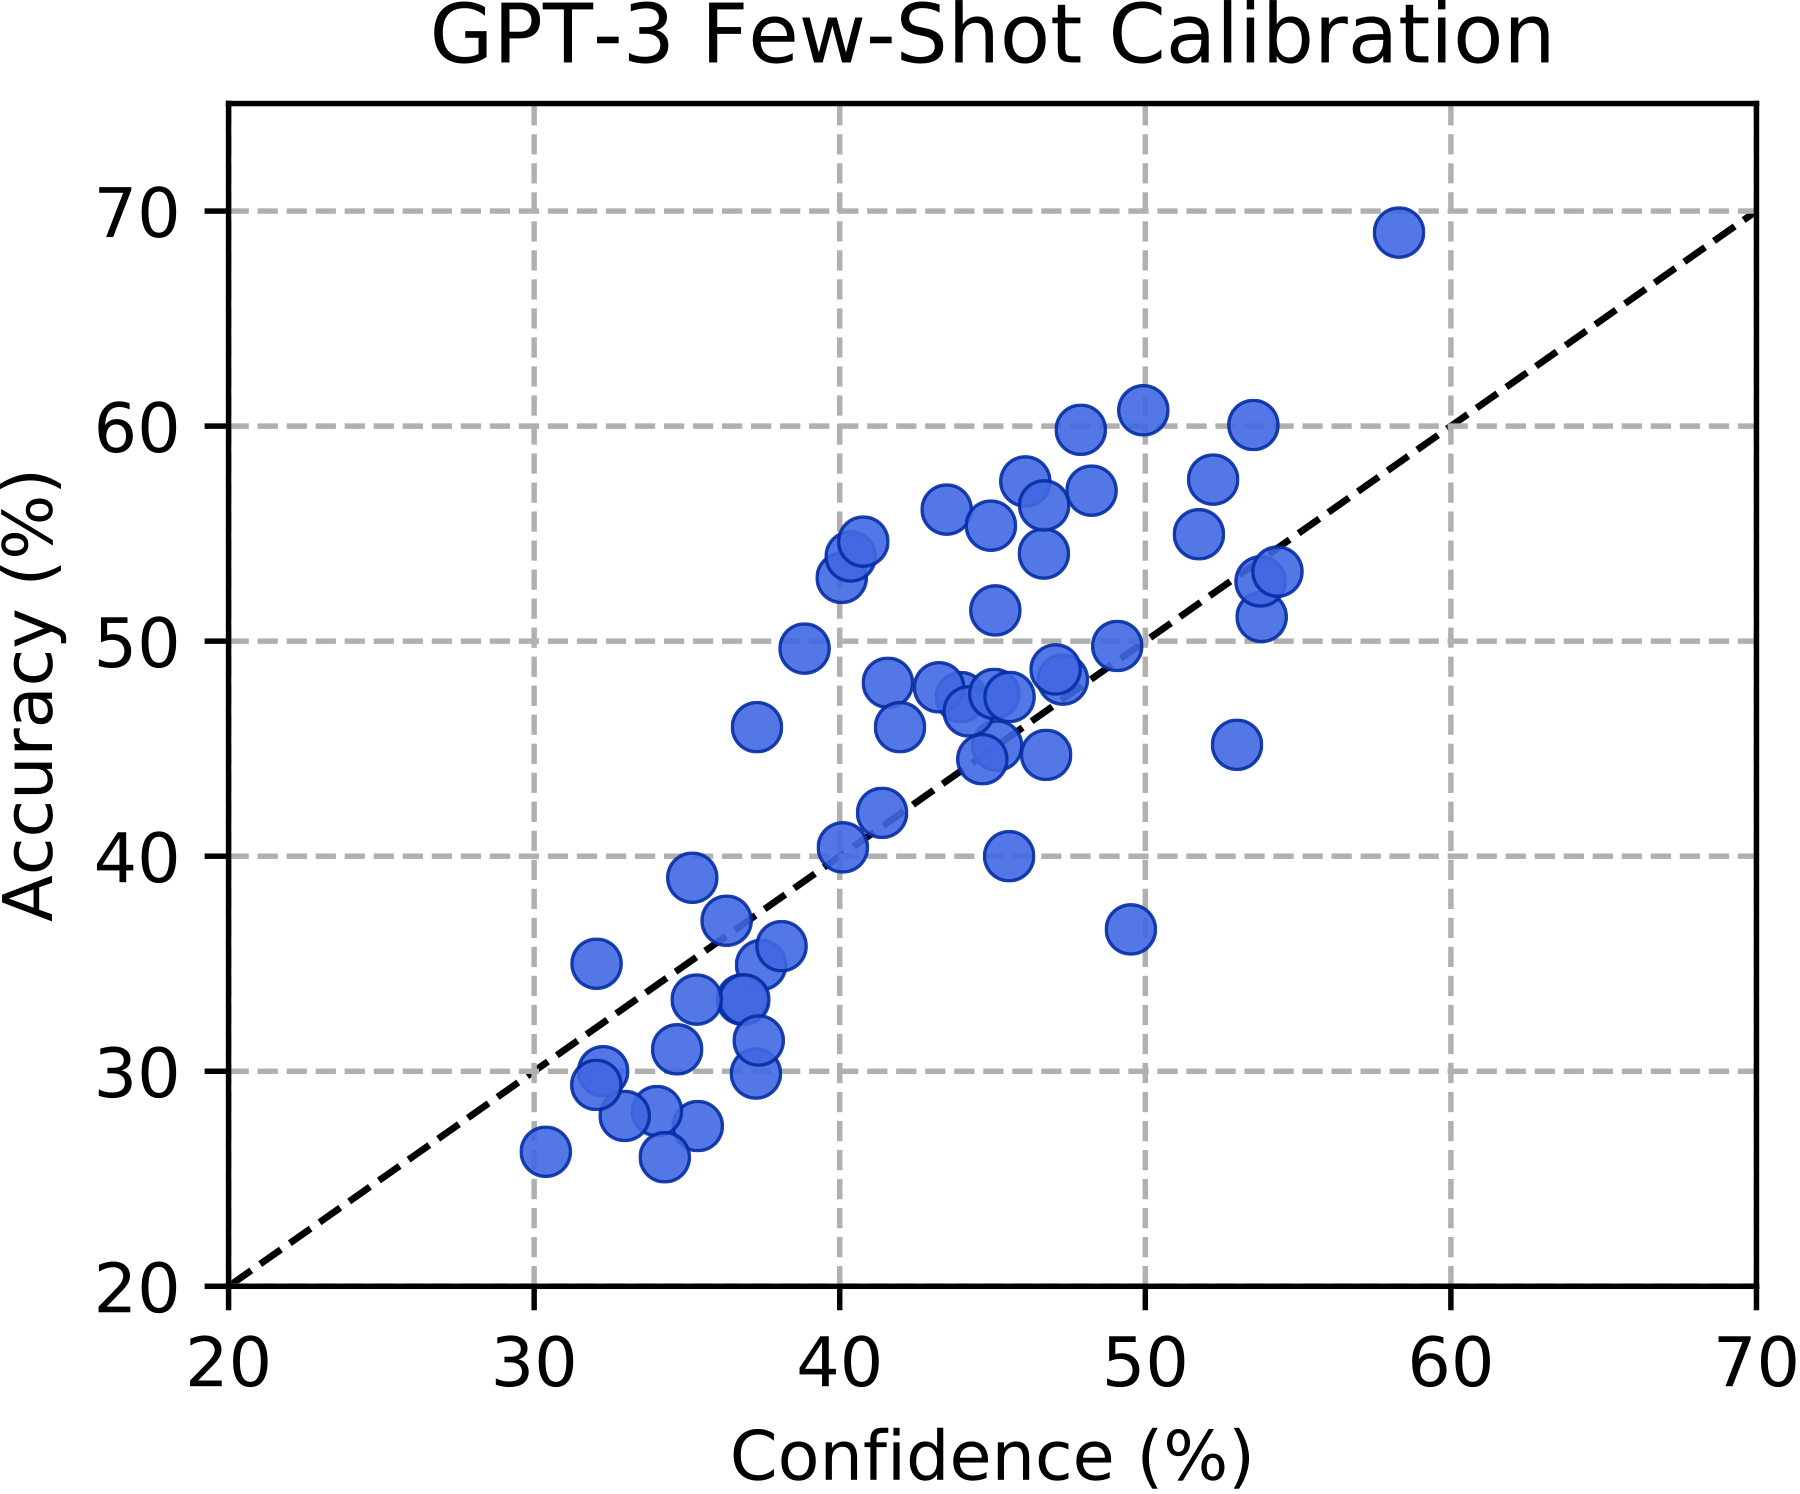
读图8的对角线。 横轴是模型平均信心,纵轴是实际准确率,每点对应一个学科。在线下方表示信心高于正确率,在线上方表示正确率高于信心;离线越远,二者差距越大。这是学科层面的平均校准,不保证同一学科的每道题都可靠。
附录B.2用题目概率与准确率关系分析精确记忆,作者认为未见强证据支持大量逐题记忆。但这种间接统计不能证明没有污染;公开发布后的后续模型更应使用额外来源审计或新题验证。
五、选择题与公开题源限制了能力解释
可做未执行实验,把一组题的选项随机重排并同步重映射标签,比较准确率与答案一致性。如果模型习惯某个字母,重排会暴露偏差。再用不改变知识要求的题干改写,区分格式脆弱性与知识缺口;必须由人工核对改写没有改变答案。
局限包括选择题可猜测、题目含糊或错误、领域代表性有限、公开来源污染,以及分数不能覆盖开放式解释、多模态感知或实际操作能力。
六、把本篇机制再推进一步
1. 总准确率相同,按学科等权分数不同,是否一定是谁算错了?
参考答案:不一定。学科题数不同时,按题加权与按学科等权是两个估计对象;前者让题量多的学科影响更大。应同时声明权重与题目分布,再比较模型;若改分母后排名变化,说明结论依能力分布和聚合选择。
七、分别补测真实性与多步数学
知识选项分数之外,TruthfulQA检验常见误解,HELM组织多指标协议。后续评价要明确知识、真实性和校准各自的事件,不能把一种总分当作另一种能力的替身。
自测与参考答案
1. MMLU高分是否等于获得专业执业能力?
不等于。它只测给定选择题中的文本知识和求解,真实工作还涉及信息收集、沟通、行动与后果。专业领域题目得分不能直接外推到完整实践能力。
2. 两模型准确率相同,为什么可靠性仍可能不同?
它们可能在不同领域犯错,也可能对错误给出不同信心。需要分科、校准和选择性回答分析,不能仅看平均正确率。
3. 不在MMLU上微调,是否就排除了污染?
没有。题源可能进入预训练,甚至公开题库本身被读取。微调协议与训练数据重叠是不同问题,间接记忆分析也不能提供完全排除证明。