062 · HELM:模型评价为什么需要一张地图,而不只是一个分数
论文:Percy Liang等,Holistic Evaluation of Language Models,2022年公开,TMLR 2023。原始论文 · 正文 · 论文对应结果站v0.1.0 · 官方代码。本文讨论论文的历史快照,结果站后续版本不应与之混合。
图表来源:Percy Liang等,2023,原文;CC BY 4.0。本篇展示做了PNG格式转换,图中数据与标签未改动。
先接住前作的问题
MMLU提供知识切片,TruthfulQA补测误解复述;它们不能共同自动给出一个业务最优模型。本篇把场景、指标和调用方式交叉组织,追问哪些比较有共同测量条件、哪些格子仍然未知。
五个前置概念
五个前置概念:基准是数据与协议的组合;适配把语言模型接口映射到任务;校准衡量概率与实际频率是否一致;鲁棒性衡量扰动后的表现;混杂因素是与比较对象共同变化、却可能解释结果的其他变量。
一、问题设定:任务接口不同,怎样让模型分数真正可比较
语言模型接收文本并返回文本或概率,任务却可能是分类、检索、摘要或问答。提示、示例、答案格式、候选打分和停止条件决定如何把接口变成一次测量;如果这些条件缺失,两个同名“正确率”也未必可比。
因此,评测对象更准确地写成 : 是模型, 是适配方式, 是测试分布, 是评分规则。这是便于理解的自构记号,不是论文提出的新模型公式。只公布模型名和最终分数,实际上省略了决定测量含义的大部分条件。
HELM将核心场景与专项评价分开。核心场景适合横向查看多个模型的多项属性;专项评价则更集中地检查知识、推理、记忆等具体问题。两者回答不同问题,不能因为专项数学测得细,就认为真实问答中的鲁棒性也已得到保证。
它仍主要评估静态语言模型接口,不是多轮工具使用的完整社会部署实验。训练奖励、环境动作和策略梯度不适用;这里真正需要分析的“算法”是评价流水线,以及它如何避免把不同条件的结果拼成排行榜。
二、把场景、适配和多维指标定义为完整测量对象
论文的核心指标包括准确性、校准、鲁棒性、公平性、社会偏差、毒性与效率。理解这些名字时,最容易犯的错误是把它们当成七个可以直接相加的数。
准确性要依任务定义:分类正确率、问答匹配分数与摘要重合指标并不具有同样语义。校准关心概率是否可信;鲁棒性关心扰动后是否保持表现;公平性关心不同群体或条件下的差异。社会偏差与毒性也不是同一个概念:语言没有侮辱词,仍可能系统性忽略某类人。
以校准为例,将样本按预测置信度分为 个箱,常见估计为
是第 组样本, 是总样本数, 是实际正确比例, 是平均预测概率。HELM默认使用十个等样本数量的箱。这个指标回答“概率是否与频率一致”,没有直接回答“模型是否知道哪些题更难”。后者还可通过选择性预测衡量:只回答置信度最高的一部分问题,观察覆盖率与准确率的变化。
这一区别可以从单调变换看出。如果所有置信度都被压向0.5,样本难易排序可能完全不变,拒答策略的排序能力也不变,但概率的校准会改变。因而单看ECE,不能替代所有不确定性评价。
以下是教学化评价流程,并非一个训练算法:
校准与选择性回答对应不同决策问题
ECE按置信度分箱,比较箱内平均置信度与实际正确率;改变分箱会改变估计,低ECE也不保证每个重要子群都校准。选择性回答则设覆盖率c,仅回答最高置信度的c比例样本,报告这些样本的正确率。它测的是模型能否把风险集中到被拒答部分,而非把拒答自动算对。原文同时报告校准与选择性指标,正是因为两者不能互换。
教学算例。 A在100题中答对80题,置信度全部0.8,可总体校准,却无法按置信度挑出更可靠子集。B也答对80题,但前50题置信度0.9且45题正确,选择覆盖率50%时达到90%。两者同准确率并不具有相同路由人工复核的价值。
设两个模型都答对100题中的80题。甲对每道题都声称99%确定,乙平均给出80%置信度。两者准确率一样,但甲明显过度自信。若乙还能把错误题排在置信度最低的一端,系统就有机会通过拒答提高可靠性;单看平均80%置信度仍不足以证明这一点。
总体校准怎样掩盖子群失真
两组各50题,预测置信度都为0.6;第一组45题正确,第二组15题正确,合计60题正确,整体看恰好校准。分组后真实正确率却为0.9和0.3。这个账本说明总体ECE较低仍可能掩盖重要群体差异,公平性与校准不能只靠一个汇总数互相替代。
教法联系:Lilian Weng的Extrinsic Hallucinations in LLMs。算例为本文自构。
三、固定提示与答案映射,并记录缺测与重复种子
输入:模型版本集合、场景、适配规则、指标实现
为每个场景确定测试样本和允许使用的示例池
对每个模型、场景、示例种子:
    从示例池选择固定的上下文示例
    按统一规则生成提示,记录实际示例数与截断
    调用模型,保存原始提示、输出、概率和时间
    用相同评分规则计算适用指标
    对扰动样本与分组样本进行对应评价
汇总不同种子与场景,保留缺测项
输出:分项结果、原始行为和可复查的运行配置
公平比较不是把所有模型塞进同一个字符串后便自动成立。统一规则提高可比性,但模型对提示方式的适应程度不同。更完整的分析应同时报告统一协议下的表现,以及在同等调参预算下的适配表现。后一条是由论文结果引出的实验设计建议,不能冒充论文已经完成的全模型最优提示搜索。
四、按指标方向和任务颜色读取关系图
先辨评测覆盖图与行为关系图,再看各纵轴是越大还是越小更好;跨场景相关不等于单模型因果改进。
| 项目 | 论文设置及其含义 |
|---|---|
| 覆盖 | 30个模型,16个核心场景,另有26个专项场景 |
| 指标 | 七类核心指标;不可计算或不适用的格子保留缺失 |
| 适配 | 通常最多五个上下文示例;窗口不足时减少数量 |
| 重复 | 三次示例选择,不是在三个随机种子上重新训练模型 |
| 样本上限 | 表7示例配置为每场景最多1000个评价实例;专项设置需另查 |
| 资源 | 调用和运行成本随模型及场景变化,不是同预算预训练对比 |
| 可检查材料 | 原始提示与回答、适配配置、指标和结果网站 |
这里的“样本效率”尤其需要谨慎。同样五个示例,长度可能不同,模型窗口也不同;某个模型只能容纳三个,实际收到的信息就不同。所谓相同shot数只是部分控制条件,不能代替token长度与实际输入记录。
闭源模型还存在训练数据未知、模型版本变化和接口限制。评测可以让输出行为更透明,却不能仅凭输出完全排除测试污染。将这些未知明确记录,比把所有差异都解释为架构优劣更合理。
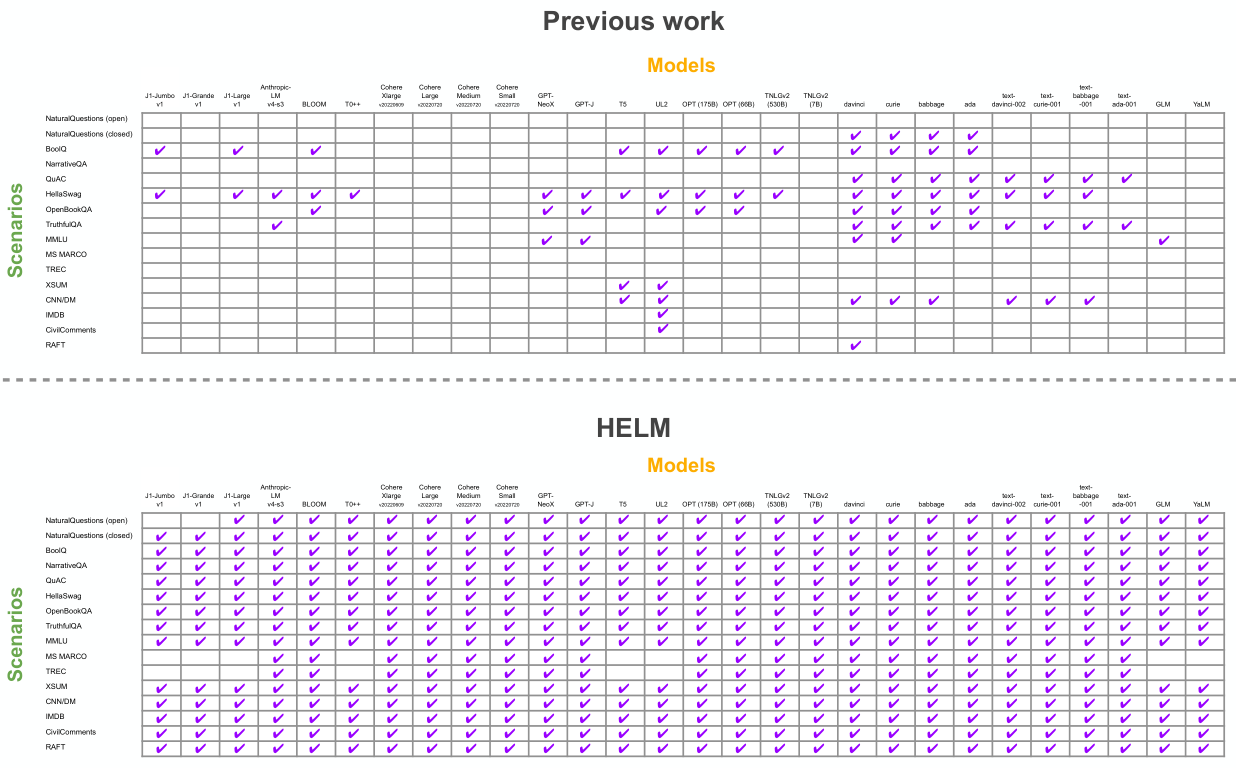
证据一:图4,比较覆盖是否改善。 论文报告核心场景的平均覆盖从17.9%提高到96.0%。这是评测完整度的改变,不是模型准确率提升。它支持建立共同测量空间的贡献。 覆盖图比较评测了哪些模型—场景组合;指标关系图把准确率放在横轴,校准、鲁棒性等放在纵轴。覆盖增加与准确率增加不是同一件事。
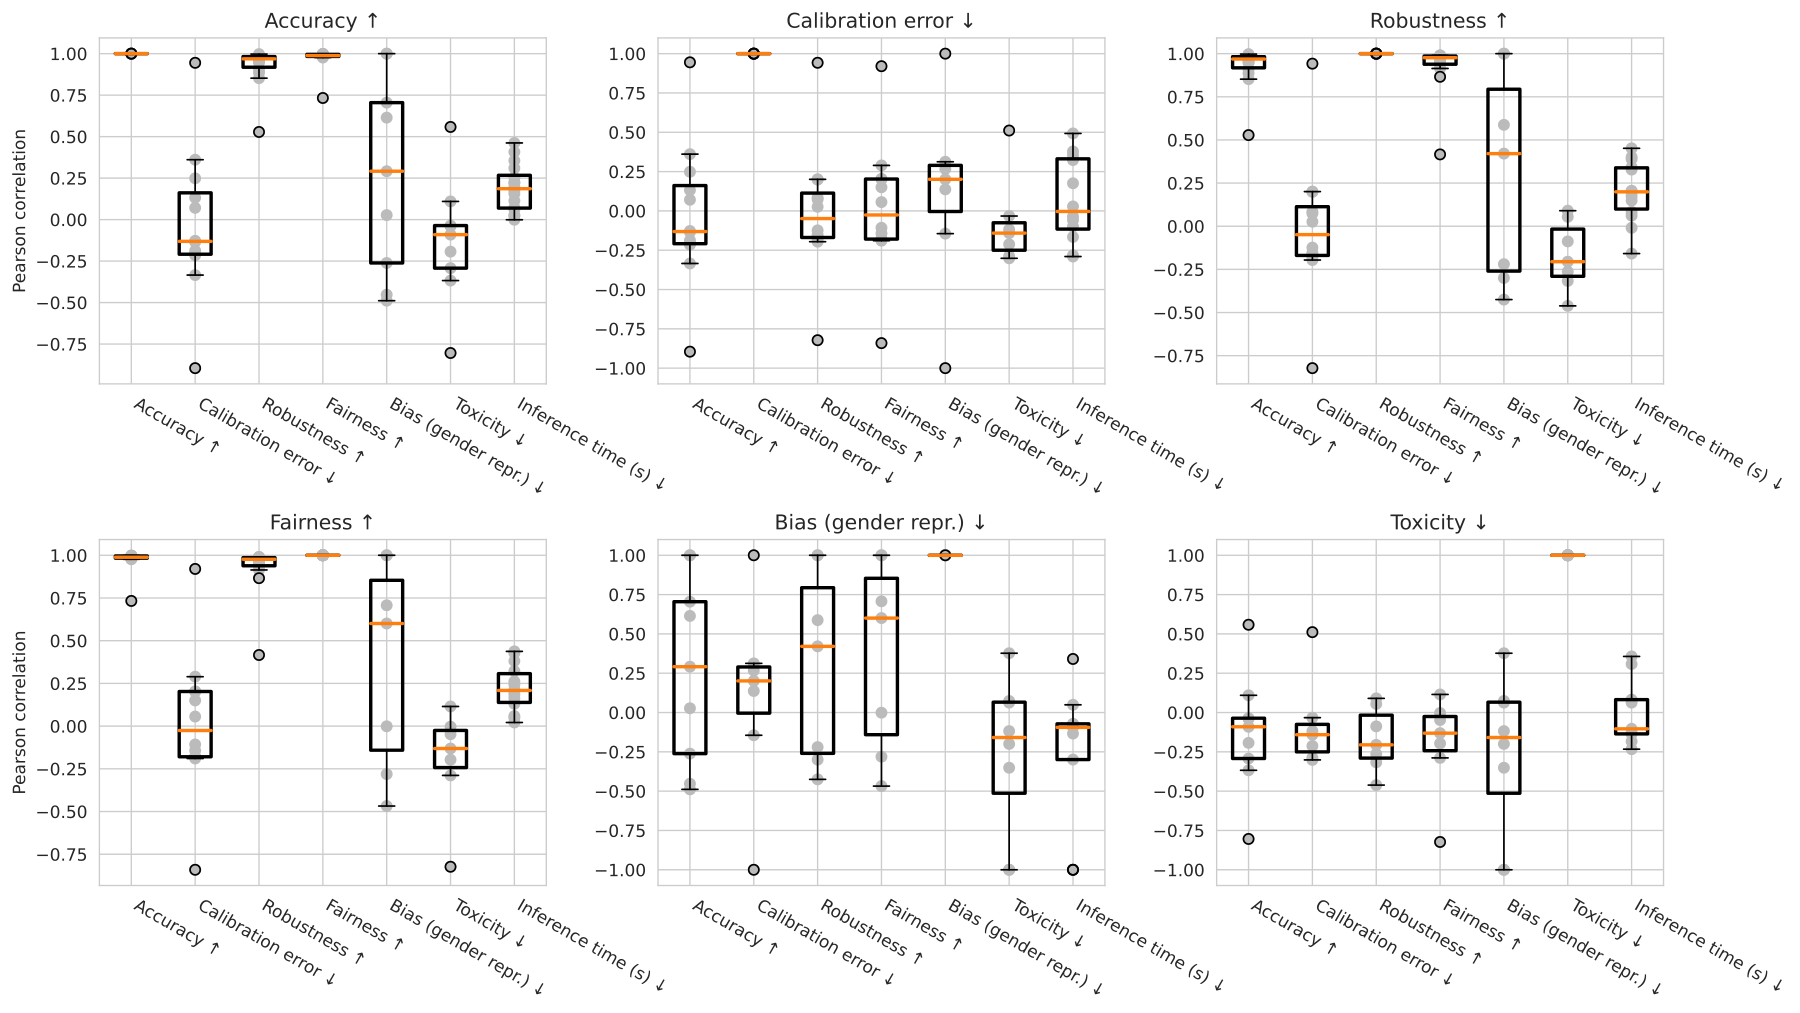
证据二:图24、图25,指标是否等价。 跨指标关系并不统一,不能用准确性代替其他目标。相关性是这些模型、这些任务中的统计现象,不能证明提高某项指标会因果性地改善另一项。
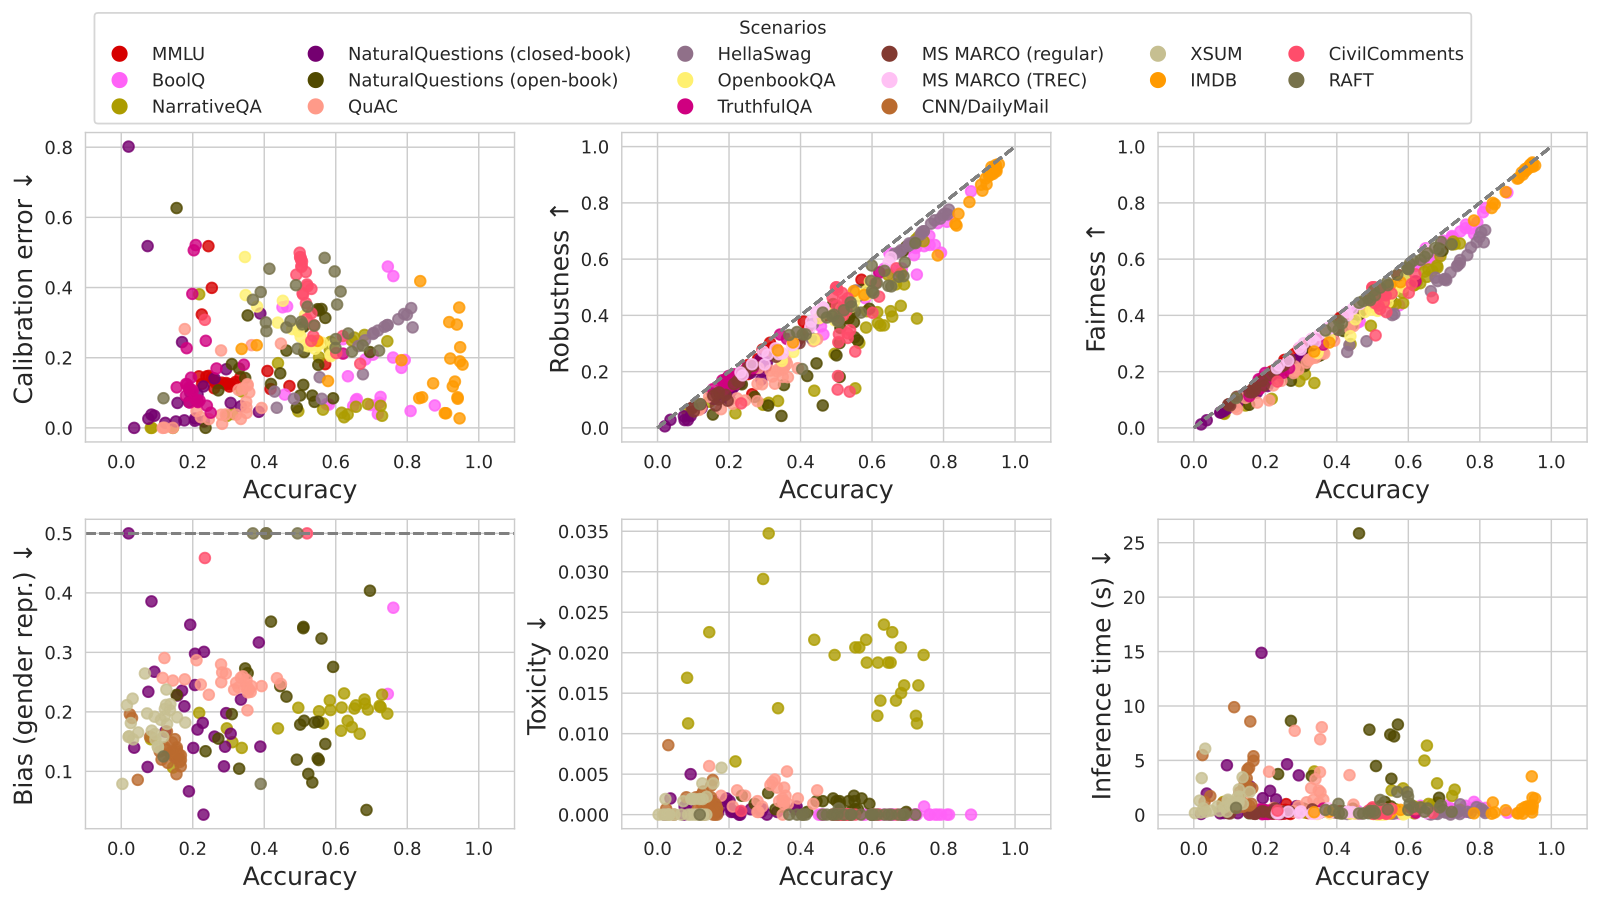
读图24先看箭头。 六幅横轴都是准确性,点的颜色区分任务场景;纵轴的鲁棒性、公平性越高越好,而校准误差、偏差、有害性和推理时间越低越好。因此“点更靠右上”不是统一的理想方向,也不能把不同颜色的任务差异直接解释成同一模型的因果改进。
证据三:图31与§8.2,示例选择的影响。 davinci在开放资料NaturalQuestions的三组示例下,F1为0.376、0.611、0.636。选择一个最好种子会明显改变印象;这不是训练不稳定,而是提示适配敏感。
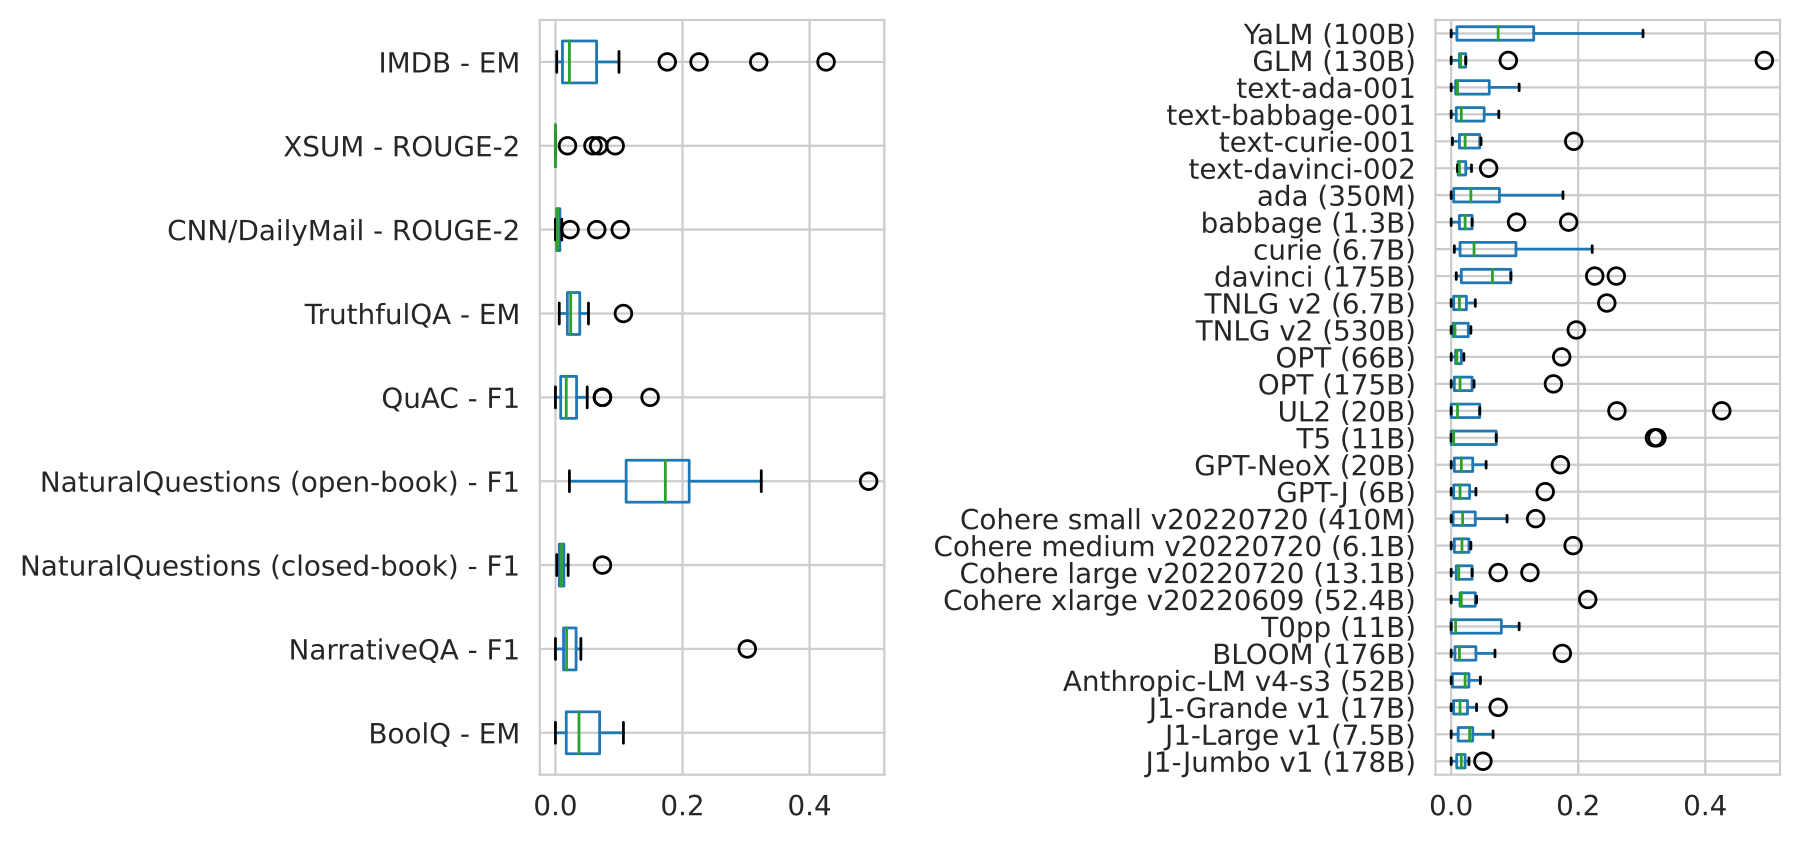
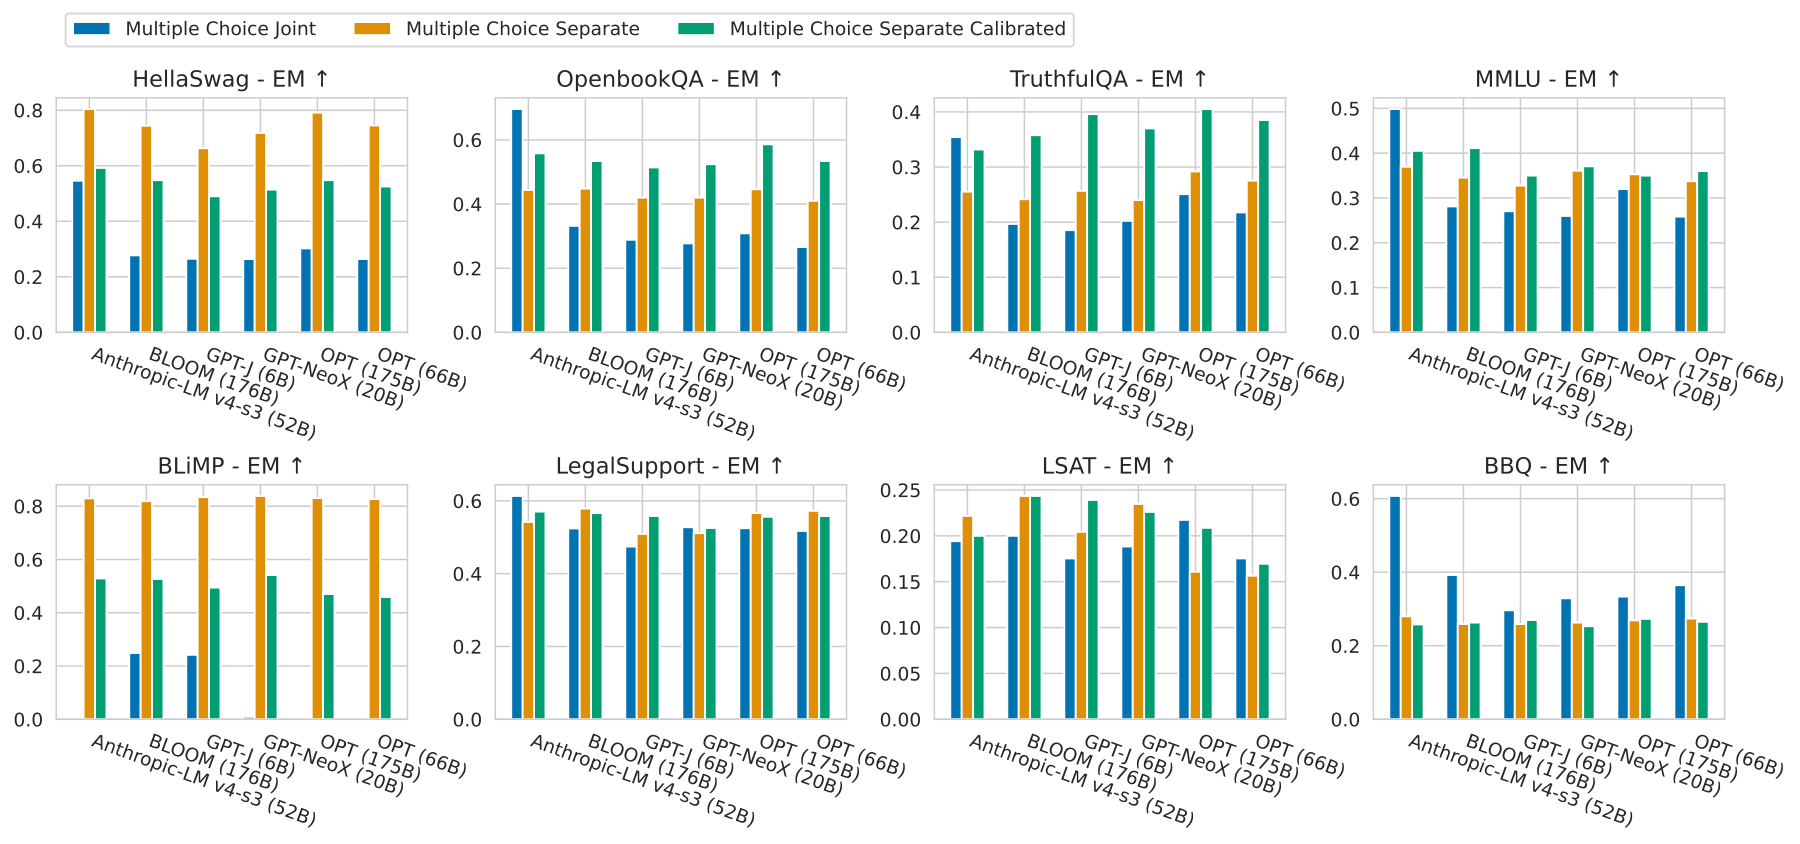
证据四:图33与§8.2,统一协议的局限。 联合展示选项与分别打分,会改变模型间差距甚至效率关系。它支持把适配方式视为测量对象的一部分,不能据此挑选每个模型最好的一次分数,再声称是同协议比较。
证据五:§8.3,高准确率不保证好校准。 HellaSwag上两个高准确率模型的ECE仍为0.286和0.341。它说明正确率与置信度可靠性可以脱节;没有证明所有场景都出现相同程度的问题。
面对如此多结果,最有效的阅读方式不是记住全部名次,而是挑一个结论,沿“图中趋势→适配配置→原始回答”向下追踪。若原始回答格式不符合评分器,低分可能混合了任务能力与接口遵循能力;这两者都可能重要,但解释应分开。
五、覆盖不全与指标权重仍需由实际用途决定
再假设20道错误全来自某种方言表达。总体正确率和总体校准可能都不错,群体表现却不均衡。这个自构例子表明多指标不是多填几列,而是从不同角度揭示同一组输出的结构。
HELM的新意主要是评价设计与基础设施。它把过去分散的结果放进较一致的协议,且没有用一个平均数掩盖所有缺失。分类框架的价值还在于暴露盲点:一个格子为空,是可讨论的知识缺口,而不是默认没有问题。
作者在第10节明确讨论缺少的任务、领域、语言、模型及适配方式。英文与静态任务的覆盖,不能自动推及其他语言、长期交互或真实工作流。自动毒性评分也只是代理指标,不能替代上下文中的人类判断。
我的分析是,多指标评价仍面临选择偏好。哪些群体需要单独检查、哪些错误成本更高、是否允许拒答,都与使用场景相关。不存在一个脱离用途的权重向量,能把所有维度压成永远合理的总分。实际选择模型时,应先确定不可接受的失败条件,再比较满足条件的模型成本和性能。
例如,一个内部文档问答系统可以先设定引用正确性和拒答要求,再比较延迟;一个自动补全文本系统则可能更关注交互速度和用户接受率。这样的决策顺序是读者可应用的方法,不是HELM论文已经替所有部署给出的答案。
六、在多指标评价里进一步明确推理预算
多指标地图还需完整推理预算。推理评估协议进一步拆开候选覆盖、选择与停止;可将本篇场景—指标矩阵扩成模型、提示和控制器的共同测量对象。
自测:能够回答,才算理解
1. 两个模型使用完全相同的提示,是否足以保证公平比较?
答案:相同提示控制了一个变量,但模型训练目标、tokenizer与上下文窗口可能不同,同一提示的适配程度也不同。它可以定义明确的统一协议比较,却不能证明已经测得每个模型在相同适配预算下的最佳能力。
2. 准确率提高,为什么不能推断校准、公平性和鲁棒性都提高?
答案:准确率只计算当前分布上的正确比例。概率是否可信、错误集中在哪些群体、扰动后是否保持答案,属于不同性质。它们可能相关,但关系依赖数据与模型,不能用一个指标替代其余测量。
3. 如果只能给业务方一个推荐,应该怎样使用这张多指标地图?
答案:先明确用途和必须满足的约束,再选相应场景与指标,检查原始错误和不确定性,最后在合格模型中比较成本。不要先求全榜平均再倒推业务需求;缺失的重要指标需要补测,而不是当作默认通过。