060 · ReAct:让推理决定行动,让观察修正推理
返回目录 · 上一篇:FlashAttention · 下一篇:GPTQ
论文:Shunyu Yao等,ReAct: Synergizing Reasoning and Acting in Language Models,2022年公开,ICLR 2023。原始论文 · v3全文 · 项目与代码。
图表来源:Shunyu Yao等,2022,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
CoT生成的过程只能继续依赖已有上下文,错误事实可能越写越深。本篇把推理与真实工具行动交错,让外部观察改变后续条件;它主要是冻结模型的提示和执行协议,不引入新的强化学习更新公式。
五个前置概念
五个前置概念:策略根据历史选择行动;部分可观测性表示当前观察不含全部状态;工具调用产生真实外部反馈;上下文示范通过成功轨迹指定行为模式;闭环控制依据行动后的观察调整后续决策。
一、问题设定:推理缺少事实时,怎样把行动反馈接回下一步决策
只推理可能缺证据,只调用工具又可能不知道下一步查什么。ReAct要求把信息缺口转成可执行动作,读取真实返回,再决定继续、改查或终止;模型自己写出的“观察”不能替代环境事件。
二、区分模型生成的行动与环境返回的观察
设环境观察为,行动为,历史上下文为。模型策略根据历史选择下一步。ReAct扩展行动空间:
是真正影响环境或查询工具的动作,是语言推理。语言步骤只更新模型上下文,不会让环境自动发生变化。写下“已经找到杯子”不是找到杯子;必须由环境观察支持。
HotpotQA与FEVER属于问题输入下的信息检索任务。ALFWorld是与具身任务相对应的文字游戏,WebShop是使用真实商品资料构建的购物环境。后两者有稀疏成功反馈,但主要ReAct实验并不据此更新模型权重。它们也不是直接在真实机器人或真实电商账户执行任务的实验。
与RAG相比,ReAct允许下一次检索依赖之前结果;与思维链相比,多了外部事实与状态反馈;与纯行动策略相比,多了明确的目标分解和工作记忆。它仍依赖大模型已有知识,不能从几条轨迹从零学出全部常识。
在知识任务中,典型序列是Thought、Action、Observation。维基工具有三类操作:搜索实体,返回首五句或类似实体;在当前页面查找字符串;提交最终答案。这是受限检索接口,不能视作最强神经检索器。
作者发现内部知识与外部检索各有弱点,于是设计两种回退规则。ReAct超过步骤预算仍未答出时,转向思维链自一致性;或者先用自一致性,答案未达到过半共识时转向ReAct。
这不是训练了一个最优调度器,而是启发式选择。主设置自一致性采样21条、温度0.7,HotpotQA和FEVER的ReAct步骤预算分别为7与5。混合方案总计算与工具调用量不同,不能仅用分数比较声称单位成本更好。
行动的价值在于改变下一步可用证据
将历史写成 ,其中 为任务输入, 为第 次行动、 为真实观察, 为当前步。模型根据历史 选择行动 ,真实工具返回观察o后形成 。内部生成的推测只是H中的模型文字,不拥有工具观察的事实地位。ReAct的信息闭环因此依赖调用边界、失败返回和停止条件,而不是固定输出几个“Thought”标签。
任务是“找到红杯并放到桌上”。模型先推断杯子可能在柜子,执行查看,观察说柜子为空;随后更新计划到洗碗池,实际看到杯子后再拿取。关键不是它写了多少思考,而是第二个位置选择受“柜子为空”约束。
把观察的来源写进执行日志
模型提出“搜索甲机构”,环境返回“无匹配”,下一步历史应包含这一实际失败结果;若系统把模型自行猜测的机构地址当成Observation插入,就制造了伪证据。实现可把行动请求、工具返回和模型解释分成独立字段,并用调用ID相连,方便检查哪项结论真的来自外部反馈。
教法联系:Lilian Weng的LLM Powered Autonomous Agents。算例为本文自构。
三、执行检索或环境动作,再按预算触发回退
输入:任务、少量成功示例、可调用工具及停止条件
上下文 ← 示例 + 当前任务
循环直到结束或达到步骤预算:
    模型依据上下文生成推理或一个合法行动
    若为推理:仅追加到上下文
    若为搜索/环境行动:
        执行真实工具或环境接口
        将实际返回观察追加到上下文
    若为finish:提交答案或结束任务
记录行动、观察、成本与最终评价
工具执行器不可把模型自行生成的“Observation”当作真实返回。这是实现该算法语义所必需的区分。输入中的网页或环境文本也只是任务证据,不能自动成为高于任务规则的新指令。
长程决策任务不需要每一步都写长推理。论文让思考稀疏出现,例如完成子目标后更新计划,或者搜索位置失败后换策略。文本长度并非贡献本身,有用的是维护当前状态与接下来的决策。
主实验没有新损失函数;参数固定,机制是不同类型步骤交错。另有小模型微调实验,用3000条最终答对的生成轨迹训练8B/62B模型。必须将这一分支与少样本提示结果分开。
教学轨迹。 问某机构是否成立于某城市,第一步搜索只得到同名组织;有效下一步是补国家或创办人以消歧,而不是重复同一查询。可记录“新证据数/调用数”和重复行动率:十次调用若都回到同一页面,并未获得十份独立证据。搜索成本也应与CoT额外token一起纳入比较。
四、按知识、家庭任务和购物的不同指标读结果
分别读问答准确率、任务成功率和最佳提示:工具并未在所有知识任务胜出,34个百分点也来自最佳值比较。
| 项目 | 原文设置与评价意义 |
|---|---|
| 基础模型 | 主要PaLM 540B冻结提示;附录另有GPT系列结果,不能不注明模型混用分数 |
| 知识任务 | HotpotQA只给问题、FEVER只给声明;不直接提供标准支持段落 |
| 提示数据 | HotpotQA六条、FEVER三条人工轨迹;Act/CoT对照由同源示例删除相应部分 |
| ALFWorld | 六类任务、134个未见游戏;每类标注三条轨迹,排列其中两条形成六种提示 |
| WebShop | 约118万商品、1.2万指令的环境;评估500条测试指令,采用一条上下文示例 |
| 训练对照 | BUTLER使用大量专家轨迹;WebShop IL为1012条人工轨迹,IL+RL另用10,587指令 |
| 指标 | HotpotQA精确匹配、FEVER类别准确率、ALFWorld成功率、WebShop属性得分与全条件成功率 |
| 预算与统计 | 知识任务有步骤及采样预算;ALFWorld报告不同提示均值和最佳值;没有统一全任务墙钟成本及置信区间 |
预训练知识、工具访问和任务适配数据是不同资源。仅看一两条提示与十万条专家轨迹,不能推导ReAct总学习成本更低;它使用的大语言模型已经从广泛文本中获得先验。
证据一:表1保留知识任务负结果。 HotpotQA精确匹配Act25.7、ReAct27.4、CoT29.4、CoT-SC33.4。ReAct相对纯行动改善1.7个百分点,却低于纯思维链2.0个百分点。FEVER则为Act58.9、ReAct60.9、CoT56.3。工具能增强事实依据,并不保证任何检索接口都提高最终分数。
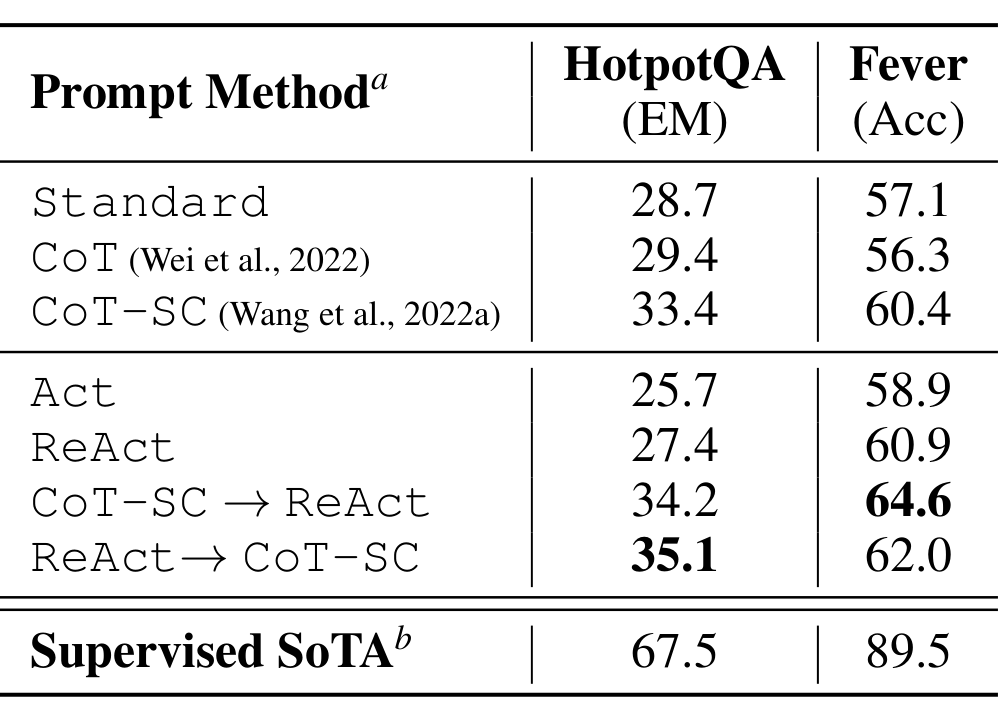
证据二:表1的组合优势。 ReAct转CoT-SC在HotpotQA达到35.1,CoT-SC转ReAct在FEVER达到64.6。它支持内部和外部信息互补;同表专门监督最佳为67.5和89.5,说明提示方法仍有大差距。不能把“优于部分提示基线”扩展成“超过所有专门模型”。
证据三:表2的错误分布。 作者从两种方法各取50条答对、50条答错,共200条手工分析。答对组中过程或事实有问题的比例ReAct6%、CoT14%;失败组ReAct搜索错误23%、推理错误47%,CoT幻觉56%。ReAct失败样本的幻觉记录为0%,只能描述这份分层小样本,不能宣称系统没有幻觉。
证据四:表3的ALFWorld。 ReAct平均57%,六种提示中最佳71%;Act最佳45%,BUTLER最佳37%。摘要34个百分点来自71−37的最佳值比较,不是平均ReAct提升34点。逐类看Cool任务BUTLER100高于ReAct最佳86,Pick 2两种提示方法最佳同为41,不能只引用总体掩盖子任务。
证据五:表4的WebShop。 ReAct属性得分66.6、全条件成功率40.0;Act62.3/30.1;IL+RL62.4/28.7;人类专家82.1/59.6。相对Act成功率增加9.9个百分点,相对IL+RL增加11.3个百分点,比较对象必须写清。40%的成功也意味着多数测试任务没有满足全部条件。
五、工具质量与重复行动仍可能阻断闭环
如果它只重复“杯子应该在柜子”,文字再合理也没有闭环。可构造同一任务的不同物品位置,比较Act、固定计划和ReAct的无效动作数与成功率;这是一项未执行的教学实验。
工具返回的新信息可以修正既有判断,而不是让模型只在自己生成的文字里循环。
主要局限是检索质量和控制稳定性。模型可能反复搜索相同实体、重复无效行动、无法从空结果恢复,或把观察中没说的内容补成事实。原论文认为严格交错格式也可能限制推理灵活性,这与HotpotQA单独ReAct不及CoT的结果一致。
轨迹可读有助于诊断,却不是内部因果过程完全透明或系统已安全对齐的证明。论文展示人工修改推理可引导行为的案例,也不等于建立了对任意任务有效的控制保证。任务工具和终止预算仍需被执行系统落实。
在复现上,实时维基内容会改变,部分原数据答案也可能过时。应保存网页版本和原始观察,区分真正答错与标签时间差,避免同一问题在不同日期比较时把环境变化当成算法进步。
六、沿调用训练、跨尝试记忆和环境接口继续扩展
当前轨迹闭环之外,Toolformer学习调用数据,Reflexion保存跨尝试记忆,SWE-agent改进具体动作接口。三条后继线分别改变训练、记忆与环境。
自测与参考答案
1. 模型输出“Observation: 已找到物品”,是否完成了观察?
答案:没有。观察必须来自工具或环境的真实返回,模型文字本身只是预测。执行器应严格区分模型生成与外部反馈,否则整个闭环会退化成模型模拟自己希望发生的结果。
2. 为什么ReAct在HotpotQA可能不如纯思维链?
答案:受限搜索可能找不到有用信息,交错结构也可能打断灵活推理,错误循环进一步耗尽预算。事实依据更强不等于最终答案更准。应分开测检索召回、证据使用、推理与终止,而非只比较有无工具。
3. 如何公平解释ALFWorld的34个百分点提升?
答案:它来自ReAct最佳71%与BUTLER最佳37%的比较;ReAct跨提示平均为57%。应同时呈现平均、最佳、提示数量、任务分布和训练资源,不能把34点当成任意提示下稳定可得的提升。