070|Reflexion:把失败经验写成语言,下一次真的会更好吗?
论文:Noah Shinn 等,Reflexion: Language Agents with Verbal Reinforcement Learning,2023。原始来源:论文、正文 v4、官方代码。
图表来源:Noah Shinn 等,2023,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
ReAct让当前行动接收反馈,但重试若从头开始可能重复失败,保留整段轨迹又会淹没有用信息。本篇直接增加跨尝试的语言记忆;它改变条件输入,与STaR把筛选轨迹写回参数的方式不同。
五个前置概念
理解本文最需要五个概念:轨迹是行动与观察的序列;上下文学习是在不更新参数时利用输入改变行为;外部记忆是跨尝试保留的信息;oracle反馈是评测时可获得但部署时未必存在的真实判定;隐藏测试是不能被候选生成过程直接利用的最终评估集合。
一、问题设定:一次失败后,怎样让下次尝试用上可靠经验
固定语言模型驱动单个Agent,在ALFWorld、HotpotQA或代码任务中执行、评价并重试。各任务环境和反馈不同,不共享一个统一状态空间;要解决的是怎样把失败转换成下一次可用的短记忆,而不是再训练一个基础模型。
在 ALFWorld 中,观测是环境返回的文本,动作是导航、寻找和操作物体的命令,任务完成状态提供反馈。在问答中,输入问题与检索内容构成上下文,输出答案接受评价。在编程中,候选代码接受生成的单元测试,最后用独立测试集统计成绩。
这三种反馈的可信程度不同。模拟器的任务完成信号比较直接;HotpotQA 实验可以使用真实答案导出的正确与否反馈;程序的自生成测试则可能把错误实现判为正确,也可能用错误期望值否定正确程序。因此,“有反思”不是唯一条件,“反思依据什么”更加关键。
核心假设是:一次失败能够被压缩为有助于下一次决策的经验,而且模型读到经验后能够采取不同、更好的行动。论文用经验性实验检查这些假设,没有给出每次反思都使成功概率单调上升的定理。
二、区分行动、评价和反思,再把轨迹压缩为有限记忆
Actor 负责行动或产生答案;Evaluator 评价轨迹;Self-Reflection 模块把轨迹和评价转换为自然语言反馈。这三个角色可以由语言模型或外部执行器承担,不能因为名称类似 Actor–Critic 就把 Evaluator 等同于学习状态价值的 TD critic。
用教学记号描述第 次尝试:
是任务, 是记忆, 是轨迹或候选程序, 是评价器, 是反思生成过程, 表示追加。截断操作限制上下文长度。模型参数 在这一循环中保持不变。
这里没有一个被梯度下降直接优化的统一 Reflexion 损失。任务成功率是评价指标;“执行—反馈—记忆”是算法机制;改变条件分布是机制产生的效果。三者不能合并成“优化奖励函数”一句话。
反思记忆应该保留因果条件,而非只保留结论
反思是轨迹的有损压缩:如果把“这次查找因文件名变更失败”概括为“永远不要使用查找工具”,下一轮上下文会被错误规则污染。可把反馈拆成观察、候选原因、可检验修改三项,区分已证实与猜测;这是便于审计的教学实现建议,并非论文证明的最优记忆格式。参数冻结只限制更新位置,不能阻止错误内容在上下文中累积。
自构例子,未运行: 任务是实现闭区间整数求和。首次代码用 range(a, b),测试 sum_interval(2, 4) == 9 失败,结果为5。好的反思是“Python 的 range 不含右端点,下次使用 b+1,并检查 a=b”;坏的反思是“需要给所有结果加4”。后者可能修好这一个测试,却破坏其他输入。若测试本身错误地要求结果为8,反思越坚定也可能越偏离真实规格。
累计成功率怎样依赖失败后的条件表现
首轮成功0.6,剩余失败题在收到反思后再成功0.5,则两轮累计为0.6+0.4×0.5=0.8。这里第二轮评估的是首轮留下的困难子集,不能擅自套独立同分布的两次0.6得0.84。累计曲线上升也可能主要来自重试,需要与相同次数但没有反思的对照比较。
教法联系:Lilian Weng的LLM Powered Autonomous Agents。算例为本文自构。
三、保存可检验修改并控制重试与反馈预算
输入:任务 x、固定模型、评价器 E、重试预算 K、记忆容量 Ω
memory = []
for trial in 1..K:
    candidate, trajectory = Actor(x, memory)
    feedback = E(candidate, trajectory)
    if feedback indicates success:
        return candidate
    reflection = Reflect(x, trajectory, feedback, memory)
    memory = last_Ω(memory + [reflection])
return best_or_last_candidate_according_to_protocol
这是便于实现的教学版本。原文算法1的循环条件写法不宜脱离上下文机械照抄;实际程序必须同时保证成功后停止、预算耗尽后停止。最后返回哪个候选也应由评价协议明确规定。
为什么语言记忆可能比原始轨迹有效?原始轨迹告诉模型“发生了什么”,反思还尝试提炼“下次应改变什么”。但这是信息压缩,不是无损记录:概括失真、过早归因以及错误测试都可能把下一次尝试引向错误方向。
对照教学实验。 固定同一首次失败轨迹,第二次分别给原始错误日志、准确反思、等长无关文字和错误反思;保持重试数及总token接近。若只有准确反思改善,才更支持“提炼有效信息”的解释。仅比较一次基线与三次反思无法区分重试覆盖、额外计算和记忆内容的作用。
四、按累计成功、内部测试与任务退化读取证据
先标出首次、累计和最终提交的预算,再读反馈消融;内部测试和多次重试已经参与91%的最终结果。
| 项目 | 原文设置与需要保留的口径 |
|---|---|
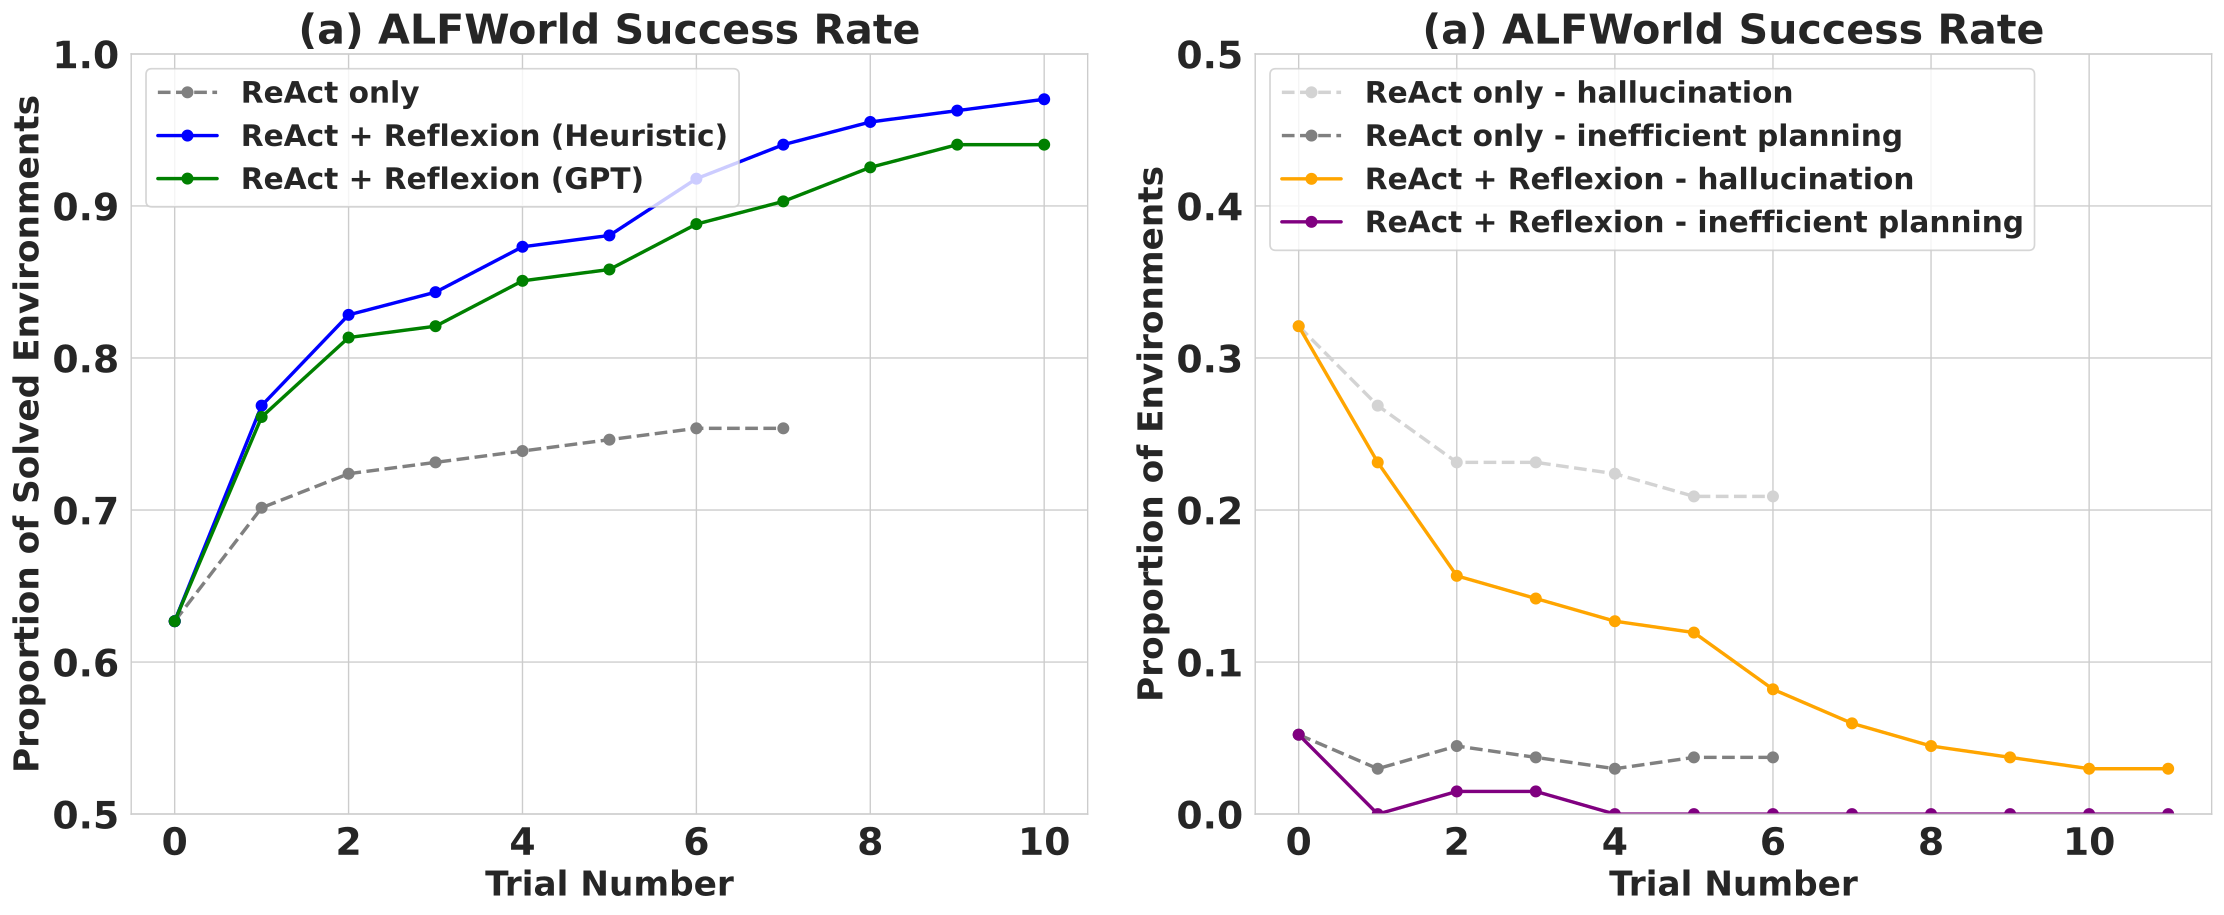
| ALFWorld | §4.1:134个环境、6类任务;基于 GPT-3 的 ReAct;连续12轮尝试,保留最近3份反思 |
| ALFWorld 重试 | 重复相同行动与响应超过阈值,或行动过长时重置;基线也获得重试机会,不是只比较一次基线与多次新方法 |
| HotpotQA | 图4的100道题;CoT、ReAct及记忆消融;使用正确性反馈,部分 CoT 设置提供真实支持上下文 |
| 程序生成 | GPT-4;HumanEval、MBPP 的 Python/Rust 版本;HumanEval Rust 使用较难的50题子集;另有40道 LeetCode hard |
| 内部反馈 | 模型生成单元测试,进行语法过滤与代码执行;语法正确不能保证测试的期望答案正确 |
| 记忆与停止 | 编程保留最近一次反思;成功停止取决于内部测试。统一的编程总调用预算没有在这里所核对的正文中确认 |
| 评价口径 | 最终候选提交隐藏测试;pass@1 描述最终提交,不排除内部多轮生成、执行与修正 |
| 不确定性 | 不把有限任务集上的单个比例当作稳定总体参数;正文结果不足以推导所有模型与任务的置信区间 |
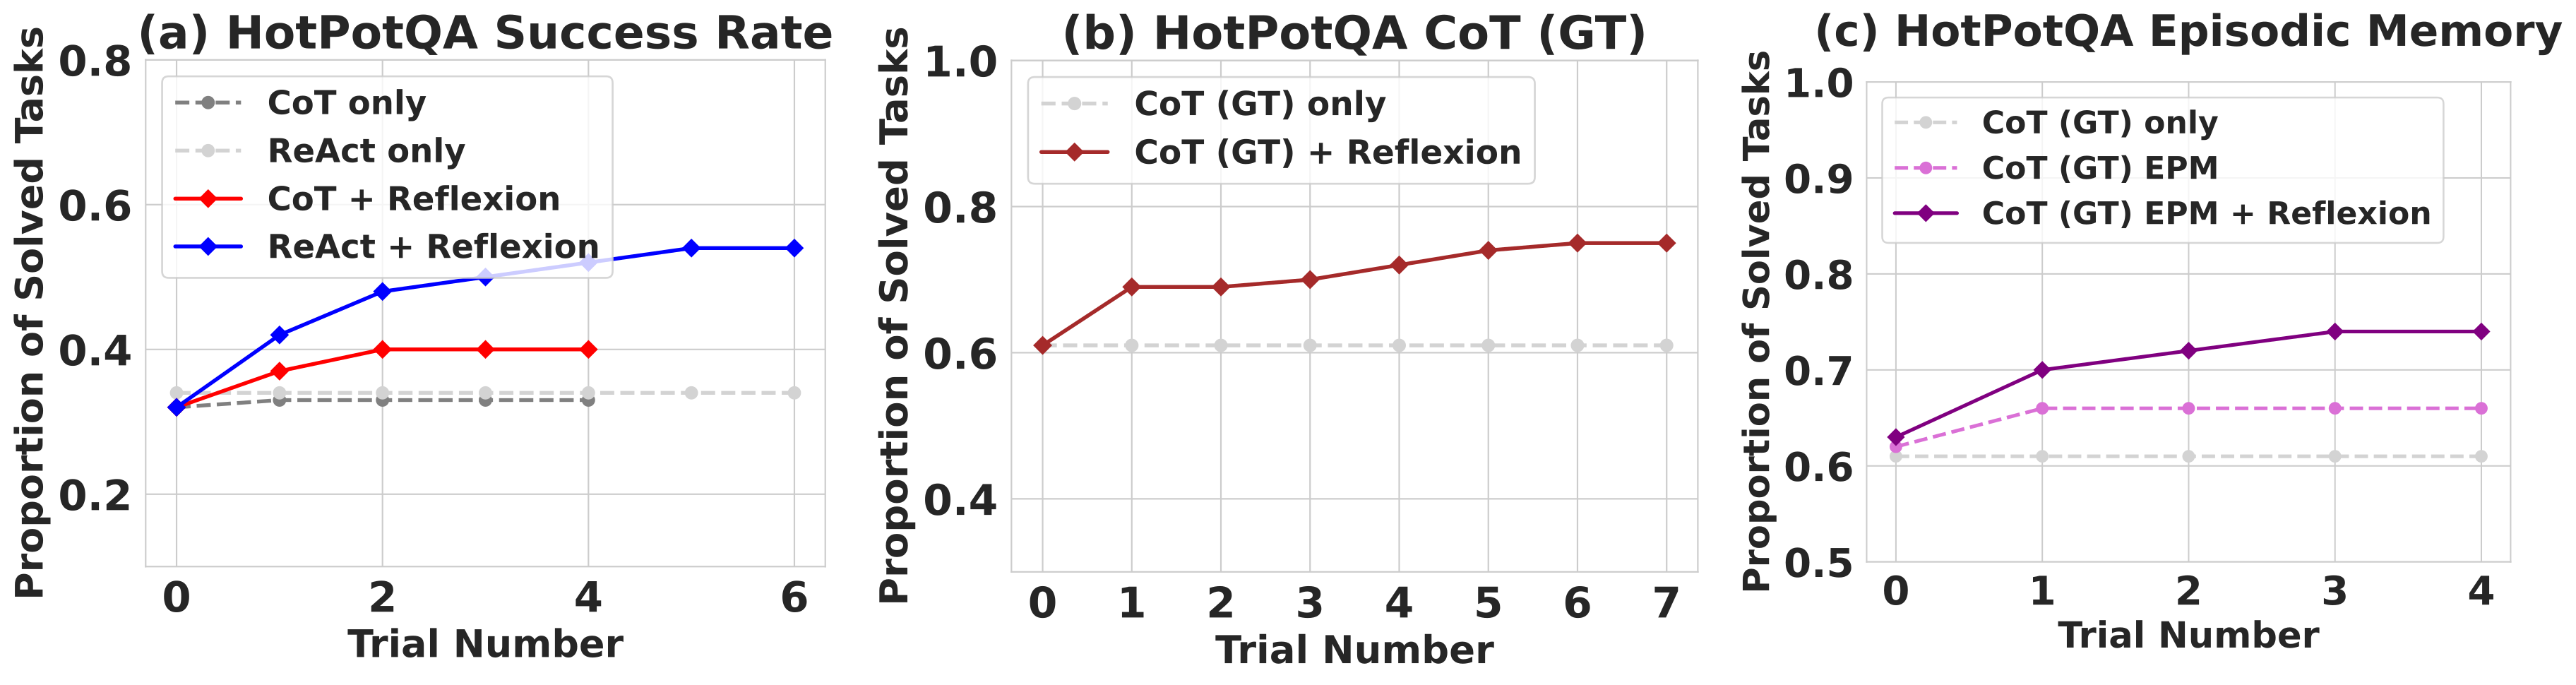
HotpotQA 的正确与否反馈具有实验 oracle 的性质:真实部署的问题通常没有已知正确答案可随时判分。把这个系统搬到开放研究问题上,必须另行构建评价器,不能直接沿用其问答增益。
还要注意不同论文的 GPT-4 成绩不可直接互换。这里 HumanEval 基线80.1%,并不是 GPT-4 技术报告中67%的同一实验配置;模型版本、提示、采样和评测流程都影响可比性。
证据1:图3,ALFWorld 的累计成功。 最终完成130/134个任务,即约97.01%,这个比例由任务数自行计算。曲线支持记忆与重试可以帮助解决先前失败的任务,但它是多轮累计结果,不能证明首次行动就有相同可靠性,更不能只凭最终成功率判断调用效率。 ALFWorld 图画的是多次尝试的累计解决比例;HotpotQA 的100题分析又是另一组任务。累计成功不能代替第一次尝试的成功率。
证据2:图4,问答中的记忆消融。 作者比较仅保留近期经历与加入语言反思的设置,报告反思记忆带来8个百分点的增益。这支持“如何编码过去经验”有作用;然而正确性反馈与部分实验的真实上下文也参与了结果,不能据此证明不依赖验证信息的自由反思同样有效。
证据3:表1,程序任务有明显异质性。 HumanEval Python 为80.1%→91.0%,绝对增加10.9个百分点;Rust 为60%→68%。MBPP Python 则80.1%→77.1%,下降3个百分点;MBPP Rust 为70.9%→75.4%。LeetCode hard 为7.5%→15%,在40题上对应3题→6题,样本很小。“翻倍”不能掩盖只多解3题的事实。
证据4:表2,自生成测试的可靠程度。 作者讨论 MBPP 与 HumanEval 上内部测试放过错误程序的差异,正文给出16.3%与1.4%的相关比例。阅读时必须遵循表中条件归一化方式,不能擅自把它们当成以所有错误程序为分母的标准假阳性率。它支持测试质量影响最终效果,不能证明反思模块本身在 MBPP 上没有价值。
证据5:表3,Rust 子集的组件消融。 基线0.60;省去测试生成而保留反思为0.52;有测试但省去语言反思为0.60;完整方法为0.68。在这一设置下,可靠反馈与语言修正共同出现才取得增益,缺少测试的反思甚至变差。结论范围是该子集与配置,不是任何任务都必须使用相同组件。
五、不可靠反馈会把错误压缩成后续指令
它展示了一种无参数更新的适应方式,为后来“经验记忆”“自修正”系统提供了可讨论的基线。
成本至少包括更多生成 token、评价器调用、代码执行与任务重置。最终准确率提高并不自动意味着单位时间成功率提高;若两个方法可用预算不同,应该同时报告成功率随总 token、调用次数和墙钟时间的变化。
作者讨论了复杂代码与不可靠测试带来的困难。进一步分析还包括:短记忆可能遗忘早期有效信息;同一模型生成答案和反思时可能共享盲点;错误归因可以积累成顽固记忆;任务无法重置时,试错本身可能改变环境,不能照搬离线修正流程。
论文对 LeetCode 时间切分的解释涉及 GPT-4 训练截止日期,其依据不宜当作已证实的去污染保证。GPT-4 技术报告描述的是大部分数据截止于2021年9月、另有少量更新数据,不能由一个题目发布日期推出模型绝不可能见过相关信息。这属于外部原始来源支持的证据边界。
六、继续检验反思反馈本身是否可信
跨尝试反馈若失真,会把错误带入下一轮。DeepVerifier把疑点拆成外部查证任务,属于反馈可信度的后续比较;应一起报告修好多少错误和改坏多少正确答案。
自测与答案
1. Reflexion 没有更新权重,为什么仍然能“学到”经验?它和 PPO 的学习一样吗?
答案:记忆改变了后续生成的条件分布,相同模型读到不同失败经验,可以产生不同动作。这是一种任务内的上下文适应。PPO 则通常通过奖励和梯度更新策略参数;两者变化的存储位置、跨任务持久性和优化机制不同。“语言梯度”只能当作比喻。
2. HumanEval 的91% pass@1 能否说明一次模型调用有91%概率写对?怎样做公平比较?
答案:不能。最终只有一个提交,不代表内部只有一次生成;测试、反思和修正都消耗预算。应固定同一模型与最终隐藏测试,比较相同总 token、执行次数或墙钟预算下的 Reflexion、直接多次采样和无反思修正,并把首次成功与最终成功分开报告。
3. 为什么更详细的反思可能使程序变差?怎样验证问题出在反馈还是反思?
答案:错误测试会提供错误优化方向,反思还可能把局部错误概括成错误规则。可构造真实测试与自生成测试两种反馈,在相同预算下分别运行有反思、无反思系统;另外检查反思是否忠实解释失败。只有这样才能区分评价器失真、语言归因失真和模型无法执行正确建议三种原因。