078|Llama 2:把预训练模型变成可持续改进的对话系统
论文:Hugo Touvron 等,Llama 2: Open Foundation and Fine-Tuned Chat Models,2023。采用论文 v2 正文;不把模型报告理解为所有训练数据均可重建的复现说明。代码与模型入口见官方仓库。
先接住前作的问题
LLaMA提供基础模型,InstructGPT提供SFT与偏好优化框架。本篇直接扩展前者并组合后者,研究如何反复收集新策略反馈;部分规模采用GQA,不能把跨代提升全部归给这一模块。
五个前置概念
五个前置概念:自回归建模逐 token 建模条件分布;SFT模仿标注回答;偏好模型从比较中学习排序;KL 正则约束分布偏移;拒绝采样微调把候选选择结果转成后续训练数据。
一、问题设定:基础续写怎样接成可持续修正的聊天训练闭环
基础训练学习下一词,SFT模仿助手回答,RLHF则让生成token作为动作接受序列奖励。观测是提示与对话历史,回答结束或达到长度上限后一次生成结束;本篇要把这些不同目标组织成聊天闭环,而非只报告基础模型更大会续写。
最重要的变化来自分布:第一代助手产生的答案,和已经对齐多轮后的答案并不相同。如果奖励模型只见过早期回答,它可能学会分辨明显错误,却无法判断新策略产生的细微差异。因此,策略改进以后,还要继续标注新策略的样本。
安全和有用也并非完全同义。一个回答可能非常详细地满足请求,却违反标注准则;另一个回答可能只是拒绝,安全但缺少帮助。把它们拆成两个模型,能够显式安排优先级,但拆分本身不消除冲突。偏好学习还依赖标注者、准则和提示分布足够代表目标应用。
二、区分预训练、示范和带偏好强度的奖励学习
1. 预训练层:延续架构,调整资源配置
Llama 2 沿用解码器 Transformer、RMSNorm、SwiGLU 和 RoPE。表1 的各尺寸均使用 2T token、4,096 上下文;GQA 用于报告中的 34B 和 70B,不能写成所有尺寸都使用。架构相似使它容易与 LLaMA 联系起来,但数据混合、训练量和模型尺寸同时变化,跨代分数不是单一组件的消融。
2. 行为启动层:只对助手回答计算监督损失
设提示为 ,示范回答为 ,SFT 的目标可以写成
提示是条件,不是要模仿生成的目标。因此把多段对话打包进同一序列后,仍需要正确掩码;否则优化任务会混入“预测用户接下来问什么”。这一点在实现上比换一个算法名称更重要。
3. 偏好层:先学排序,再改变生成分布
奖励模型接收完整提示和一个回答,输出标量。成对损失为
是被偏好的回答, 是另一个回答; 随偏好强度而变化。直觉上,明显更好的回答应拥有更大的分数间隔,而两段几乎等价的答案不必被强行拉开同样距离。分数只在训练口径内有意义,不能当成经过普遍校准的正确概率。
策略更新采用两类机制。拒绝采样微调先为提示生成多个候选,用奖励模型选优,再监督学习选中的回答。PPO 则从正在变化的策略继续采样,以奖励和约束进行更新。论文前期主要使用前者,后期顺序结合两者;小模型还学习由 70B 选出的数据,因此跨尺寸比较也包含教师数据影响。
把其策略目标抽象为
按条件选择安全或有用性评分, 表示经过转换和标准化的分数, 是参考策略。KL 控制更新幅度;它有助于抑制奖励漏洞,却没有证明漏洞不存在。必须区分这里的期望目标、PPO 的裁剪更新机制,以及最后测量的人类胜率。
输入:预训练模型、示范回答、提示池、偏好标注准则
对示范回答做 SFT,只计算回答 token 的损失
重复多个对齐阶段:
    从当前策略生成成对回答,收集偏好及偏好强度
    更新有用性奖励模型与安全奖励模型
    用大模型为各提示生成多个候选
    评分、选择优秀候选,结合适当的历史优秀样本
    用选中数据微调策略;小模型可学习大模型样本
    在后期阶段,以带 KL 约束的奖励进一步做 PPO
    用保留提示和独立人类评价检查改进及退化
输出:聊天策略;奖励模型主要服务训练与选择
这是一段教学流程,不是声称所有轮次采用同一份数据或同一超参数。重复收集偏好是闭环的关键;只对一个静态数据集执行多轮训练,并不等价。
4. 多轮记忆:Ghost Attention 改的是训练数据
GAtt 在生成训练对话时反复附上约束,然后在学习用的上下文中只保留第一次约束,并只训练最终回答。它试图让模型在没有反复提醒时仍遵循最初指令。这里没有新增一种注意力算子;变化来自合成数据和损失掩码。注意力图可帮助观察行为,却不能单独证明某个头就是记忆的因果载体。
偏好强度怎样变成更大的排序要求?
论文的奖励建模使用偏好强度信息。把赢家与输家的奖励差记作 ,给这一对的强度标签设置非负 margin ,单对损失可写为
是 sigmoid, 由标签映射得到而不是模型预测。强烈偏好对应更大的 ,意味着相同奖励差下仍保留更强的拉开梯度;它不只是把所有偏好对重复几次。这个建模依赖强度标签有可比较含义,但主观“明显更好”并没有天然的物理单位,所以 margin 映射也应作为实验选择,而非普遍真理。
自构强度算例。 当奖励差 ,普通 时损失约为 0.313,梯度大小约为 0.269;若示意性地设 ,损失变为 1.313,梯度大小为 0.731。同样已经排对的一对回答,后者仍会被强力分开。这些 数值只用于教学,不是复述论文的标签映射表。它也提醒我们:奖励模型排序正确率相同,不意味着奖励尺度相同,而奖励尺度还会影响后续带 KL 约束的策略优化。
将平局保留或剔除,会得到哪两个数
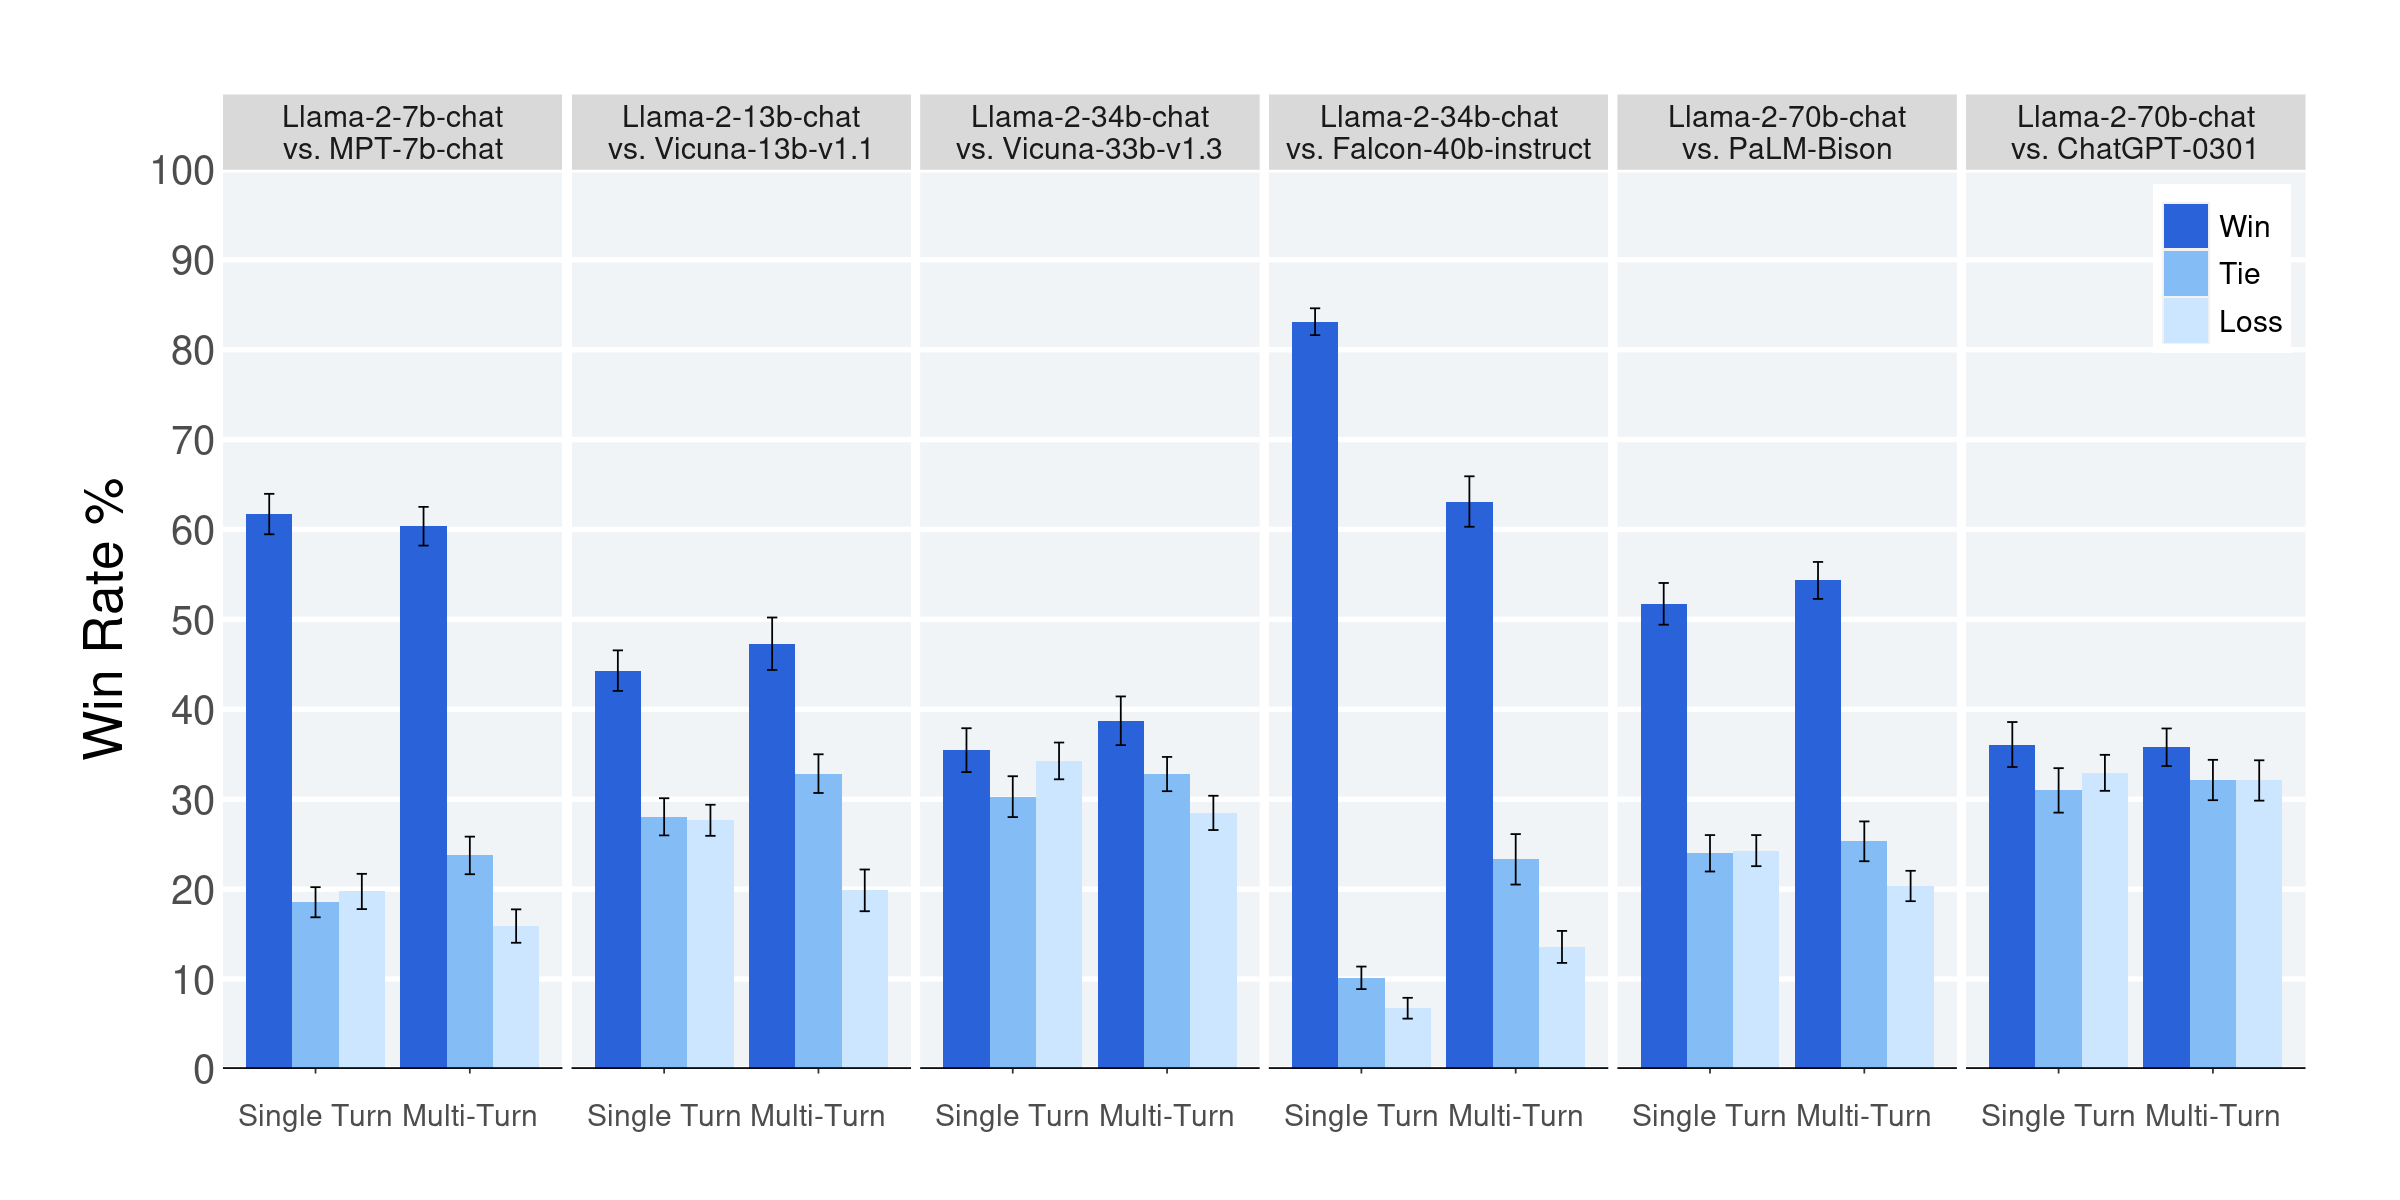
在36胜、31.5平、32.5负的比例中,严格胜率是36%;若只在非平局上计算,则为36/(36+32.5),约52.6%。后者回答“分出胜负时谁更常赢”,不是原全部提示上的获胜概率。原图必须保留三段,才能让读者重算自己需要的口径。
教法联系:Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla的Illustrating Reinforcement Learning from Human Feedback。算例为本文自构。
三、交替更新候选、奖励和策略并维护对话约束
自构例子。 假设助手的初始指令是“用中文、每次不超过三句话”。SFT 教它怎样回答;偏好数据区分简洁正确、冗长正确和简洁错误;奖励模型可能错误地特别喜欢短答案。拒绝采样随后不断选出“无法回答”,分数可能上升而实用性下降。引入新的人类比较可以暴露这个漏洞,KL 则只能限制变化速度。这个例子说明为什么策略指标、代理奖励与真实任务完成率必须同时观察,并非论文报告的失败案例。
四、分别读取基础能力、偏好难度与胜平负
基础成绩不替代聊天评价;奖励排序按偏好强度分层,胜平负按原分母展示,才能读出各阶段真正改善什么。
| 项目 | 论文设置与需要区分的含义 |
|---|---|
| 基础训练 | 表1:各尺寸 2T token、4K 上下文;数据配比没有提供到完全重建全部语料的程度 |
| SFT | §3.1:27,540 条高质量标注,2 个 epoch;批量 64、长度 4,096、初始学习率 |
| 偏好学习 | 表6:Meta 1,418,091 次比较;混合其他来源后 2,919,326 次。混合表包含合成来源,不宜全部称为独立人工写作 |
| PPO | §3.2.3:批量 512、裁剪阈值 0.2、学习率 ,200—400 次迭代;保留提示用于早停 |
| 基础评价 | 表3、表4:MMLU、代码、数学等;基础模型分数与聊天模型人类偏好属于两套问题 |
| 对话评价 | §3.4.2:约 4,000 条单轮/多轮提示,每个比较 3 位评价者;ChatGPT 使用 gpt-3.5-turbo-0301 |
| 不确定性 | 报告标注一致性等评价统计;没有把所有模型训练成多随机种子重复实验来估计训练波动 |
评价者数量不等于独立训练次数。另一方面,对话提示不包含代码和推理题,所以对话评价不能替代这些能力测试。多轮评价主要判断最后一次生成,也不完全代表用户从头到尾完成任务的体验。
证据一|表3、表4:基础能力进步与任务差距同时存在。 表3 的 LLaMA 65B 与 Llama 2 70B,MMLU 从 63.4 到 68.9,相差 5.5 个百分点。表4 的 HumanEval 中 Llama 2 70B 为 29.9,GPT-3.5 为 48.1。前一个结果支持具体配置下的跨代提升,后一个提醒我们“聊天有竞争力”不等于代码能力相等。由于模型与数据同时变化,不能把 5.5 点全部归给 GQA。
证据二|表7、表8:奖励模型擅长什么,取决于数据与答案差异。 有用性奖励模型在 Meta Helpful 上为 63.2;将该测试集按偏好强度拆分,明显更好的样本可到 80.7,几乎无差别的样本为 54.7。支持的是粗差异较容易排序,而非对所有回答拥有可靠的细粒度判断。比较模型未必在同一内部数据上训练,也不能据此宣称该奖励模型普遍强于 GPT-4。
证据三|图12 与 §3.4.2:平局会改变“胜率”的理解。 70B 对所用 ChatGPT 版本胜出 36%,平局 31.5%。剩余失败率为 ,这是自行计算。它说明本提示集上双方较接近;既不是 67.5% 严格胜率,也不是解决了 67.5% 的任务。移除平局再算比例会得到另一口径,发表结果必须说明分母。 原图分别画胜出、打平与失败,并由每题三位评价者判定;平局不是严格胜利,这组有用性提示也不覆盖全部代码与推理能力。
证据四|表11:预训练增强不自动带来安全性增强。 ToxiGen 的有害生成比例中,13B 从 LLaMA 的 23.08 变为 Llama 2 的 26.10,越低越好。该现象不支持“新一代基础模型处处更安全”。作者关于数据过滤的解释属于假说,表格没有把数据过滤作为唯一受控变量。
五、安全偏好与有用性代理仍需独立人评
这篇工作的价值在于较完整地展示模型产品化之前的训练闭环:基础能力、行为示范、偏好排序、策略更新、独立评价相互衔接。它并没有重新发明 Transformer 或 PPO,而是提供了值得拆解的系统组合和规模证据。
代价也具有系统性:新策略需要新偏好,奖励模型需要维护,选优需要多候选生成,PPO 又需要额外模型状态和采样。§3.2.3 提到只用最近一轮样本时曾出现押韵能力退化,随后混入历史优秀回答;该修复没有给出详细量化结果,应保留为作者观察,不能包装成已充分验证的防遗忘算法。
六、比较同类偏好数据的另一种优化路径
同一偏好对也可用DPO优化,作为本篇拒绝采样微调与PPO的平行比较。比较必须固定基础模型、偏好数据与实际生成评价,不能把算法名字当作回答质量保证。
自测:能否区分系统里的三个目标
1. 奖励模型分数持续上升,为什么仍需新的人类评价?
答案:策略优化会改变回答分布,也可能找到奖励模型偏爱的表面特征。训练分布内的排序准确率不能保证新策略分布上的有效性。新评价既检查真实偏好,也为下一轮奖励训练提供新数据;KL 只能限制偏移,不能代替这一步。
2. 拒绝采样微调与推理时 best-of-N 有什么不同?
答案:两者都生成候选并评分,但推理时选择仅影响当前输出;微调会把选中的答案作为训练目标,改变之后的策略参数。后者可能把好行为压入模型,也可能复制奖励偏见和丢失未被选中的能力,因此要检查后续单次生成表现及能力退化。
3. 如何准确解读 36% 胜出、31.5% 平局?
答案:在该版本、该提示集、该人类判定协议下,模型胜出36%、打平31.5%、失败32.5%。平局不能计作严格胜利;这些比例也不是客观题准确率。尤其该提示集没有代码与推理任务,结论应限定为覆盖到的对话偏好。