第 03 天|Dyna:一次真实交互,如何产生多次学习
原论文与版本:Integrated Modeling and Control Based on Reinforcement Learning and Dynamic Programming,1990。原论文。
先接住上一篇的问题
第2天 TD(λ)解决的是“尚未见到终局,怎样从相邻预测的变化学习”。即使每个真实转移都立刻产生一次更新,刚发现的奖励仍可能要等下一次走过旧状态才传回来:如果交互昂贵,能不能用已经学到的转移关系把信息继续往前传?资格迹可以让新误差影响本回合激活过的历史特征;Dyna进一步利用已存模型,为没有在当前轨迹激活的经验安排更新。Dyna把问题从更新规则推进到更新所用经验的来源。这是模型与TD学习的组合,不表示1990年的架构就是在1988年的预测实验上加一个模块。
五个前置概念
- 环境模型:预测动作的下一状态与奖励。
- 规划:利用模型进行决策计算。
- 真实样本:来自环境而非模型的经验。
- 模拟样本:从学习模型生成的经验。
- 模型偏差:模型与真实环境的系统差异。
一、问题设定:一次真实转移之后还能学几次
导航智能体每次移动会得到下一位置和任务奖励。只用这条真实经验更新,可以学习当前经过的状态动作,却不能立即让所有相关旧状态都知道新结果。Dyna研究的正是昂贵交互下的学习与规划:学习器能否一边行动、一边建模,再让模型生成一步经验,交给同一个更新器?
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 在线、单智能体、模型驱动的学习与规划 |
| 状态/观测 | 导航位置等状态 |
| 动作 | 移动指令 |
| 奖励或学习信号 | 任务奖励,由环境与模型分别返回 |
| 终止/边界 | 目标或边界由任务定义,模型也必须编码 |
二、让真实经验与模型经验进入同一个更新器
Dyna 的关键接口是一条经验,而不是一棵必须在执行时搜索的树。真实转移先改善行为/评价,再训练模型;模型随后生成同格式的转移,送回原来的学习器。计算得到的结果保存在价值或策略参数中,下次行动可以直接使用。
这里要分清 1990 年 NIPS 原文中的 Dyna-AHC 和便于讲解的 Dyna-Q。前者组合行动、评价和模型;后者把控制量写成动作价值。二者共享“学习与规划使用同一更新器”的架构,不代表论文只提出了下面的 Q 表代码。
模型规划为何省真实样本?一次新奖励可以被许多旧状态反复回传。但如果模型尚未知道墙被移走,再多内部采样也不会凭空产生真实的新通道。原文变化环境实验因此把规划与探索分开检验:Dyna-Q+ 的探索奖励是应对模型陈旧的一种扩展,不是基本模型回放的同义词。
两种经验共用一个 Bellman 残差
真实更新与规划更新共享 。区别在于 来自真实环境还是 。规划次数 n 增大不增加真实信息量,只增加对已有模型的利用。
用三格链检查奖励如何向前传播
以下是可手算的教学构造,不是论文实验。
三格链 ,到G奖1,其余奖0,,初始Q全0。真实观察B到G后,。若模型保存过A到B,立刻做一次模拟更新,就有,无需再次真实走A。
若模型错误地把A的“左”也记成到B,规划同样会把错误动作抬到0.9。两次更新使用同一公式,证据质量却不同;调大规划次数只能放大已有知识及其错误。
三、实现双循环:先收集证据,再安排规划
输入:Q、模型 M、每步规划次数 n
每次真实交互:
  a ← ε-greedy(Q,s)
  r,s_next,done ← 环境执行 a
  用真实转移做一次 Q 更新
  用 (s,a,r,s_next,done) 更新 M
  重复 n 次:
    抽取已见过的 (s_sim,a_sim)
    r_sim,next_sim,done_sim ← M(s_sim,a_sim)
    用模拟转移做同一种 Q 更新
  s ← s_next 或回合重置
输出:Q 与可用的环境模型
实现要点:此处使用最基本模型回放,不把探索奖励或优先规划当作所有 Dyna 的必选模块。
四、读堵路与捷径实验:加速传播不等于发现变化
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 网格导航与变化环境 |
| 数据来源与规模 | 在线真实经验加内部模拟经验 |
| 对比基线 | 不同规划/学习配置 |
| 训练预算与资源 | 真实步数与内部规划次数必须分开;原文硬件本文未核实 |
| 指标及其含义 | 到达目标、路线适应和学习进程 |
| 随机性与不确定性 | §5图5堵路实验平均50次运行;其他重复未逐项复核 |
| 实际验证的假设 | 模型学习与增量规划能否同时进行并加快适应 |
§3的6×9导航先检验信息传播;变化环境实验在§5,§4介绍的是Dyna-Q更新。三条曲线对应Dyna-AHC(图5、图6标为Dyna-PI)、无探索奖励的Dyna-Q−和带探索奖励的Dyna-Q+,每次真实交互后均做 次规划。堵路实验平均50次运行;其他重复未逐项复核。
用累计奖励斜率区分堵路与捷径
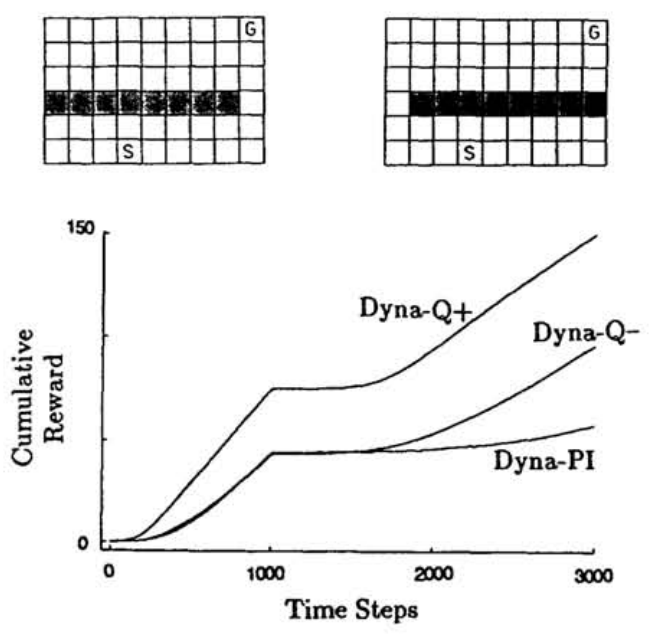
图5横轴是真实时间步,纵轴是累计奖励,斜率表示获奖速度。1000步时短通道被堵、较长通道打开;之后Dyna-AHC/PI曲线几乎变平,而两种Dyna-Q约再用800步找到替代路线。Q+较早学会初始路线,不能把它的领先全解释为规划更多,因为三组的 相同。
Q+为何还会尝试旧模型认为不值得走的地方?原文式(5),PDF第6页在更新奖励中加入 : 是距上次在真实环境尝试该状态动作的步数, 是探索系数,均不同于前面教学代码中的规划次数 。久未验证的动作会逐渐变得值得重试;原实验还允许模拟未试动作,初始模型把它们记为零奖励且留在原状态。
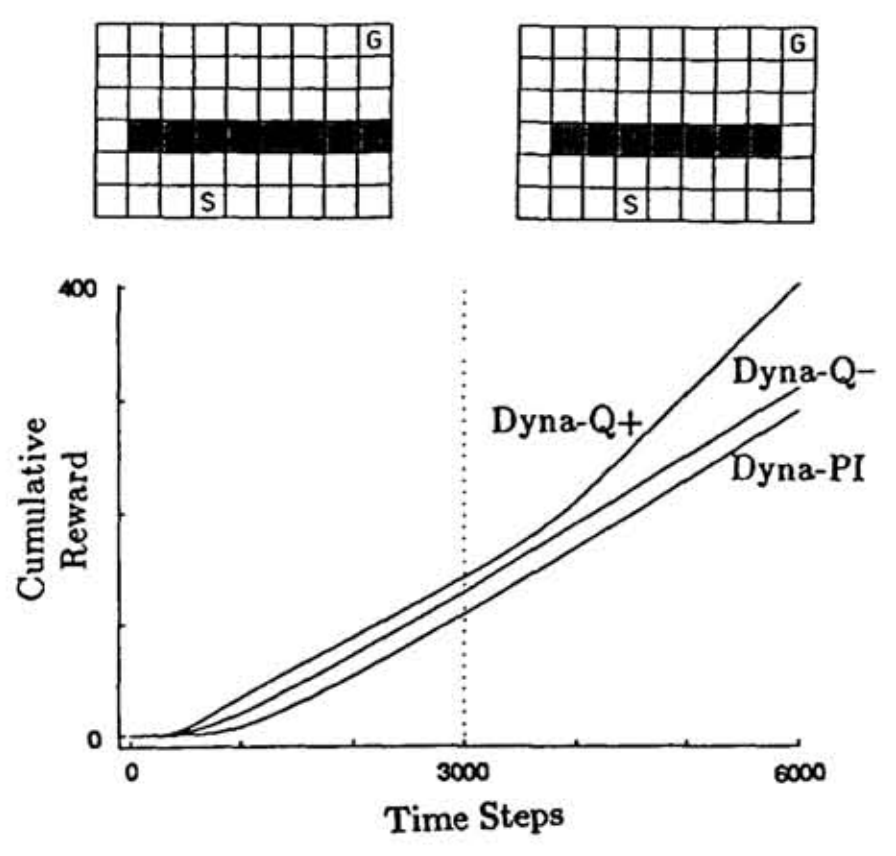
图6怎么读。 上方左图只有绕过横墙左端的长路;右图在墙的右端移去一格,开放更短通道,原来的左绕路线没有被堵住。下方横轴为真实时间步0–6000,纵轴为累计奖励0–400,3000处的竖虚线标出环境变化。三条曲线分别是Dyna-Q+、Dyna-Q−与Dyna-PI;最后一个标签对应正文的Dyna-AHC。
虚线之后,Q+曲线逐渐变陡,另外两条基本保持原斜率,说明这里的区别是主动发现捷径,而不是旧路被堵后被迫换路。读的是单位时间获得奖励的速度,不是把曲线高度当作当前策略成功率。Q+持续重试也有代价:原文指出,在变化前长路已学会的阶段,它的奖励速率略低;累计奖励领先不等于每个阶段的斜率都最大。
这张图没有误差条或置信区间。原文在图5的堵路实验明确报告50次运行平均,但图6的说明没有单独给出重复次数,不能直接套用,也不能仅凭曲线间距断言统计显著性。
上面的基本回放代码没有实现Q+的奖励和初始模型扩展。图1只说明更新接口,不代替这些行为证据。
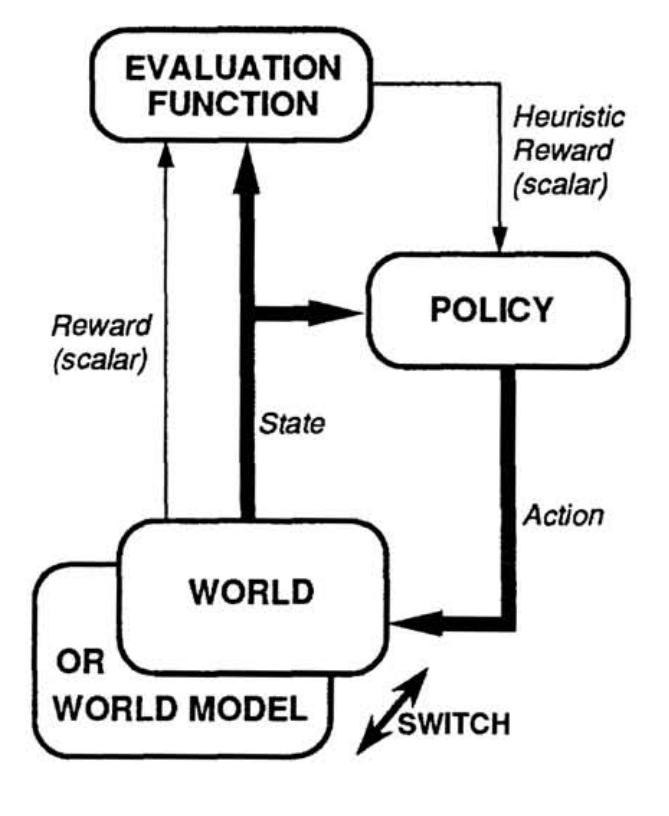
沿粗箭头看,真实世界或模型提供同一种状态、奖励接口;评价函数产生的启发式奖励用于改进策略。这里画的是Dyna-AHC的模块关系,不能把它当成Q+探索奖励的具体实现。
五、模型错了以后,更多规划会放大什么
Dyna节省的是真实交互,内部规划仍消耗计算。比较样本效率应报告环境步数,比较实际效率还需模型拟合与规划时间;错误或过时模型会把同一错误反复传入更新。真实经验仍是纠错来源。
六、继续追问:怎样决定下一步花在规划还是交互
1. 固定总计算预算,规划 n 次是否仍优于更多真实交互?
未必。规划减少的是真实样本需求,每次模型查询和价值更新仍要付费;环境便宜且模型不准时,把时间花在真实交互可能更好。公平试验应同时画真实交互数和墙钟时间两条预算轴,固定硬件、更新成本与探索策略,比较 、若干规划次数及同时间的纯学习方法。Dyna 的架构优势是复用经验,不是任何预算口径下都占优。
2. 环境出现新捷径时,旧模型如何发现?
旧模型不会凭空产生从未观察到的新转移;若贪心策略永不再走相关状态动作,反复规划只会巩固旧地图。需要持续探索、对久未访问动作增加探索奖励,或用变化检测触发重新采样。堵路会在旧最优路径上自然暴露,新捷径则可能完全不被访问,两者发现难度不同;应分别记录变化后首次发现时间与恢复收益时间。
3. 何时应该停止规划并去收集新证据?
比较下一单位计算的预期价值:已知模型上的 Bellman 残差很小、模型误差大或待规划区域缺乏覆盖时,应倾向真实采样;残差大且模型经过验证的区域更适合规划。可用保留真实转移的预测误差、规划前后真实测试回报和边际收益作为停机指标。模型集成分歧只是不确定性代理,不能把“分歧小”当作正确性证明;非平稳任务还需保留最低探索量。
七、沿经验来源与模型误差两条路线继续读
模块组合:第4天 Q-learning。Dyna-Q复用采样Bellman更新,只替换经验来源。读下一篇时先把模型拿开,检查动作价值的最大化目标怎样把预测变成控制;不要据目录相邻推断它由Dyna推导而来。
后作承接模型路线:第39天 MBPO。这里留下的问题是模型生成的经验应当用到什么程度;MBPO继承模型经验训练策略的路线,并专门限制模型展开误差。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:已经用一条真实经验更新过 Q,为什么再用模型生成同类经验仍然有价值?
参考答案:价值更新通常只影响有限的状态动作。假设刚发现 B 能到达目标,模型回放 A→B 可以让这条新信息继续传播到 A,而不用真的再走一次。模型使已有经验中的关系能够被反复利用,提高每次真实交互的信息利用率。
问题 2:模型回放次数翻倍,真实任务表现是否一定更好?
参考答案:不一定。规划只能传播模型已有的信息,不能凭空发现未知变化。如果模型仍认为某条路畅通,增加回放会反复强化过时的路线。还要区分真实交互效率与计算效率:模拟更新同样消耗时间。