第 04 天|Q-learning:从一条经验开始,学会比较未来
原论文与版本:Watkins & Dayan,Q-learning,1992。原文。1989 年博士论文提出算法,此篇重点是收敛证明。
先接住前作的问题
Dyna让真实与模型经验共用更新器,但架构本身没有回答这个更新器为何能学到最优动作价值。本篇回到TD预测留下的控制问题:如果行为还在探索,目标能否评价未来的贪心选择?Q-learning与Dyna-Q是模块组合关系;算法在1989年博士论文中已有提出,本篇所读1992年论文重点是证明,而不是把目录顺序当成发明顺序。
五个前置概念
- MDP:当前状态包含预测下一步所需的信息。
- Q 值:一个状态动作对的未来累计回报。
- Bellman 最优性:最优价值与下一状态的最优选择相一致。
- TD 误差:当前目标与当前价值估计的差。
- off-policy:采集经验的行为与更新所针对的策略可以不同。
一、问题设定:没有转移模型,怎样从一次采样比较长期行动
动态规划可以在已知转移规律下比较动作;现在学习器只有实际发生的一条转移,还不知道其他结果的概率。要保留长期最优目标,同时承受一次采样带来的噪声,就必须说清楚更新哪个表项、目标选哪个动作,以及哪些表项会被反复访问。
Q 不是当前奖励,而是执行一个动作后继续行动的累计收益。难点在于现在不知道未来,又希望从有限经验开始学习。本文以 1992 年收敛证明为中心;算法在 Watkins 1989 年博士论文中已有提出。探索行为与被评价的最优策略可以不同,这是理解 off-policy 的第一处入口。证明要求环境规律固定、奖励有界;这些前提不能被“网络足够大”替代。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 单智能体、在线采样、无模型、off-policy 的有限 MDP |
| 状态/观测 | 可枚举的状态 s |
| 动作 | 有限动作 a |
| 奖励或学习信号 | 有界标量 r,通常折扣 γ<1 |
| 终止/边界 | 真实终止令未来值为零;继续任务另按折扣处理 |
二、把 Bellman 最优期望改为单条转移更新
Bellman 最优算子先假设下一步可以挑选价值最高的动作,再对环境转移取期望。Q-learning 不知道转移概率,于是用一条实际转移给这个期望做噪声采样。关键是目标动作由最大化定义,采样动作却可以来自仍在探索的行为策略:这就是离策略性质的来源。
写成随机逼近:,其中只更新访问的坐标。对有限折扣问题, 在最大范数下具有收缩性;但样本噪声要靠持续访问与步长条件消除。这个现代教学视角帮助理解定理,原文实际证明使用辅助的 action-replay process。
“每一步目标更大”不是收敛原因,目标完全可能更小。真正重要的是期望目标对应正确算子、所有必要坐标都被更新,并且长期步长既不总是太大,也不过早归零。换成神经网络后一次更新会同时改变许多状态,表格证明不再直接适用。
写出目标、残差与每个表项的步长条件
γ 决定未来奖励的折扣,α 是更新幅度。真正终止时 y=r。对每一状态动作的访问子序列要求 且 :前者避免太早停止学习,后者抑制累积噪声。它们与无限访问条件一起使用。
一次样本对应哪个期望
固定当前Q与被访问的 后,对环境的奖励、后继状态取条件期望,样本目标才对应Bellman最优备份。噪声来自这次转移结果,不来自目标中的argmax必须随机;实际行为怎样选到 是另一层采样问题。
把探索动作和目标动作分别算一遍
以下是可手算的教学构造,不是论文实验。
当前 ,样本奖励1,后继动作值为(3,5),。目标,所以新值。
若真实下一动作恰好选了值3的探索动作,Q-learning仍使用5作为目标。若这是终止转移,则目标应为1,新值1.8。一个done标志的含义错了,会比调学习率造成更根本的目标错误。
三、让访问计数决定步长并正确处理终止
输入:有限状态动作空间,折扣 γ,学习率日程
初始化所有 Q(s,a),访问计数 N(s,a)=0
重复采集回合:
  s ← reset()
  while 未真正终止:
    a ← 有探索的行为策略(Q,s)
    r,s_next,terminated ← step(a)
    N(s,a) += 1
    if terminated: y ← r
    else: y ← r + γ max_b Q(s_next,b)
    Q(s,a) ← Q(s,a)+α[N(s,a)]*(y-Q(s,a))
    s ← s_next
输出:π(s) ∈ argmax_a Q(s,a)
固定 ε 的 ε-greedy 是教学采样选择,不自动证明所有状态都可达。代码中用每个表项的访问计数确定步长,比只按全局时间递减更贴近定理条件。有限训练不得因曲线暂时平稳就宣称满足无限时间结论。
四、用手算图理解目标,再核对收敛定理
| 证明要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 理论有限 MDP;不是 Atari 实验 |
| 数据来源与规模 | 随机转移流,关键是每一状态动作无限访问 |
| 对比基线 | Bellman 最优解是理论参照 |
| 训练预算与资源 | 渐近分析,无 GPU 或固定训练预算 |
| 指标及其含义 | 几乎必然收敛,不是平均成功率 |
| 随机性与不确定性 | 概率 1 的理论结论;随机种子表不适用 |
| 实际验证的假设 | 不用已知模型的异步更新能否得到最优 Q |
理论解读(本文分析):原文§3是几乎必然收敛证明,不是环境排行榜。附录ARP把历史更新及其权重变成一个辅助决策过程,再分析它如何趋近真实过程;这里的“replay”不能直接当成DQN经验回放已被消融验证。§4对吸收终止问题的扩展也不能推出任意γ=1过程都成立。
图中最大值分支为何不同于实际行为
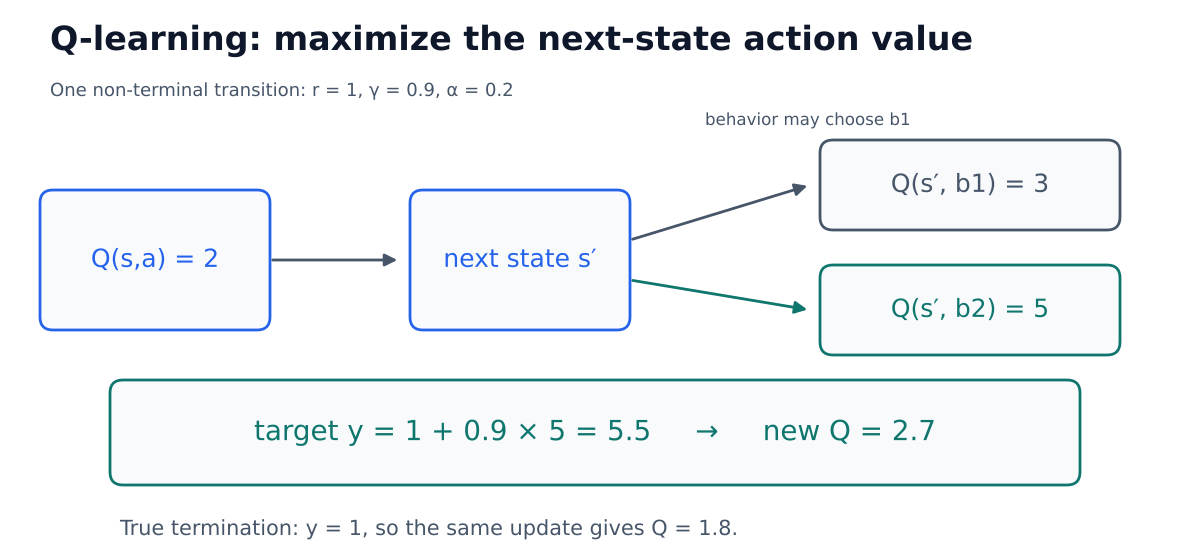
灰色分支是行为可能实际选择的动作,绿色分支是Q-learning构造目标时取的最大值。把行为动作与目标动作分开,才能理解off-policy;若该转移真正终止,则没有任何后继分支,应回到图下方的1.8。
原文§3的收敛结论建立在有限表格、充分重复访问与适当步长等假设上,回答的是采样更新最终是否逼近最优Q;它没有给有限预算的学习速度或神经网络稳定性。附录的action-replay process把历史更新构造成辅助决策过程,用来支撑证明,并非现代经验回放缓存的消融。§4对终止等情形的延伸也带附加条件,不能据此放宽为任意无折扣任务。 查看原文。
五、从无限访问结论退回有限预算限制
定理把“必须知道动力学”的要求换成了充分持续访问与合适步长。它不回答有限预算内多久能学好;大状态空间还会使表格不可行。换成共享网络后,函数逼近、自举和离策略数据的组合需要另行分析。
继续追问:访问、常数步长与共享网络
1. 固定探索概率能否保证所有表项无限访问?还缺哪些环境条件?
固定 只保证在已访问状态给各动作正概率,不保证每个状态都会反复到达。还需有限状态动作、目标状态在探索策略下可达,以及适当的复发或重置机制;存在不可逆吸收陷阱时,一次进入便可能永远失去其他状态。收敛定理直接要求每个相关状态动作无限访问,不能用“采用了 -greedy”替换这个条件。
2. α 长期保持常数时,确定环境和随机环境会有什么不同?
确定性转移与奖励、折扣 的表格问题中,固定 的充分异步更新可依赖 Bellman 压缩性收敛,因为目标噪声随误差消失。随机奖励或转移下,常数步长通常持续响应采样噪声,围绕固定点波动,而不满足经典几乎必然收敛的平方可和步长条件。它适合跟踪变化,但需报告稳态误差;特殊零噪声情形不能概括所有随机环境。
3. 把表格换成共享参数网络,证明中哪一步失去了保障?
表格更新只改变被访问的一个坐标,且最优 Bellman 算子在上确界范数下压缩。共享网络的一次梯度更新同时改动许多状态动作,函数逼近后的投影未必在同一范数下非扩张,有限步优化也未必精确实现 Bellman 更新。因此“压缩算子加受控随机逼近”的证明链断开;回放和目标网络是稳定化机制,不是恢复原表格定理的充分条件。
六、区分行为目标与神经表示两条延伸
平行控制路线:SARSA。未来仍要探索时,用最大值评价会遗漏实际行为风险;SARSA改用实际下一动作。
后作继承目标:DQN。表格装不下视觉状态时可换神经表示,但必须另外处理共享参数、自举与相关数据的稳定性。
原论文与图表入口。§2更新、§3收敛条件与ARP证明、§4扩展。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么执行的是探索策略,Q-learning 却可以学习最优策略的价值?
参考答案:采样决定“观察什么”,更新目标决定“评价什么”。它使用:
下一步取最大值,针对的是最优控制目标,而不是实际探索动作。因此行为策略与学习目标可以不同,这就是其 off-policy 特征。
问题 2:每个动作都尝试过一次,为什么不能保证学到最优 Q?
参考答案:一次观察无法可靠估计随机结果,也未必访问了所有相关状态。经典表格收敛结论要求适当的环境条件、持续充分访问,以及满足条件的学习率。它是渐近结果,不保证有限次数训练足够,也不能直接推广到任意神经网络。