第 08 天|策略梯度定理:Critic 近似到什么程度才不带偏 Actor
原论文与版本:Policy Gradient Methods for Reinforcement Learning with Function Approximation,1999。原论文。
先接住前作的问题
REINFORCE从轨迹概率得到回报加权的梯度,但长回报可能噪声很大。若借用Actor–Critic的评价器来替换回报,预测误差会怎样进入Actor更新?本篇沿似然比策略梯度推进理论条件:它既解释状态访问分布的作用,也回答什么样的价值近似不会改变期望梯度。
五个前置概念
- 访问分布:策略决定看见哪些状态。
- Score function:log 策略概率的参数梯度。
- 兼容逼近:价值特征与策略梯度结构匹配。
- 正交残差:拟合误差对指定特征无投影。
- 驻点:目标的一阶梯度为零。
一、问题设定:用近似价值替代完整回报,会不会改变策略梯度
策略变化会让未来访问的状态也变化,因此不能随手把状态分布视为常数。另一方面,一个价值网络可能均方误差不小,却恰好不影响策略能改变的方向。要建立可靠的Actor–Critic解释,必须同时处理这两个问题。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 可微策略、平均回报或起始状态折扣回报的 MDP |
| 状态/观测 | 状态 s,按策略访问分布加权 |
| 动作 | 随机动作 a |
| 奖励或学习信号 | 环境回报 |
| 终止/边界 | 依平均回报或回合目标分别定义 |
二、递归组织访问分布,再约束价值误差方向
先问一个疑点:策略改变会改变后续状态分布,为什么常见公式中看不到对状态分布求导?答案不是把它当常数。递归展开 时,当前动作概率的导数贡献会通过未来转移不断累积,最终被组织进访问分布 中。这是等价重排,不是忽略环境的长期影响。
得到策略梯度后,第二个问题才是能否用近似Critic替换真实Q。令 ,兼容近似 ,如果在相同采样权重下拟合到一阶最优,便有 。于是 ,价值误差恰好与影响策略更新的方向正交。
这比“Critic预测得越准越好”更精确:重要的是误差在策略可改变的子空间中的投影。但深网Critic、小批次和不匹配分布都可能破坏条件,不能借定理为任意Actor–Critic实现背书。
价值加权梯度与兼容特征的条件
兼容近似可写 。需要同时满足拟合最优性条件,不能仅令网络有相同输出维数。d 的规范化与折扣定义会影响常数。
兼容特征的维度为什么跟策略参数相同
若策略参数有 维,则score特征 也是 维,兼容权重w与它内积才给一个标量价值近似。相同输出维度不够:误差还需在相同访问权重下与这组特征正交。
验算绝对价值错了为何梯度仍可正确
以下是可手算的教学构造,不是论文实验。
单状态两动作,π=(0.5,0.5),logit的score为(0.5,−0.5),真实Q=(3,1)。真梯度为。
取 ,绝对价值均差2,但计算出的梯度仍为0.5,因为常量误差被score抵消。若错误近似为(0,0),梯度则为0。价值均方误差和策略梯度误差不是同一个指标。
三、以同一采样权重拟合兼容特征
输入:可微策略 πθ 与匹配的 score 特征 ψ
重复:
  用当前策略采样状态、动作与回报
  ψ(s,a) ← ∇θ logπθ(a|s)
  拟合 f_w = wᵀψ,使加权回归满足兼容条件
  g ← 样本平均 ψ(s,a)*f_w(s,a)
  θ ← θ+α*g
  重新采样,不把旧状态分布当成永久正确
输出:策略参数
注:理论式需要精确期望与条件;采样版本是近似
实现要点:任意深度 Critic 都不自动满足兼容条件。
四、用梯度对照图核查三个定理的条件
| 证明要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 理论 MDP |
| 数据来源与规模 | 经验用于构造梯度估计;非固定基准数据 |
| 对比基线 | 真梯度与兼容近似梯度 |
| 训练预算与资源 | 局部渐近论证;现代 GPU 预算不适用 |
| 指标及其含义 | 梯度一致性、驻点性质 |
| 随机性与不确定性 | 理论期望与收敛,不是种子均值 |
| 实际验证的假设 | 函数逼近是否可支持策略改进 |
理论解读(本文分析):原文Theorem 2的证明直接利用拟合的一阶条件,使价值误差与策略导数正交;Theorem 3还需要平滑、有界与步长条件。文章主要贡献是理论组织,而不是一份深度网络实验排行榜。读结论时要把驻点性质与全局最优区分开。
图中比较的是梯度贡献而非价值误差
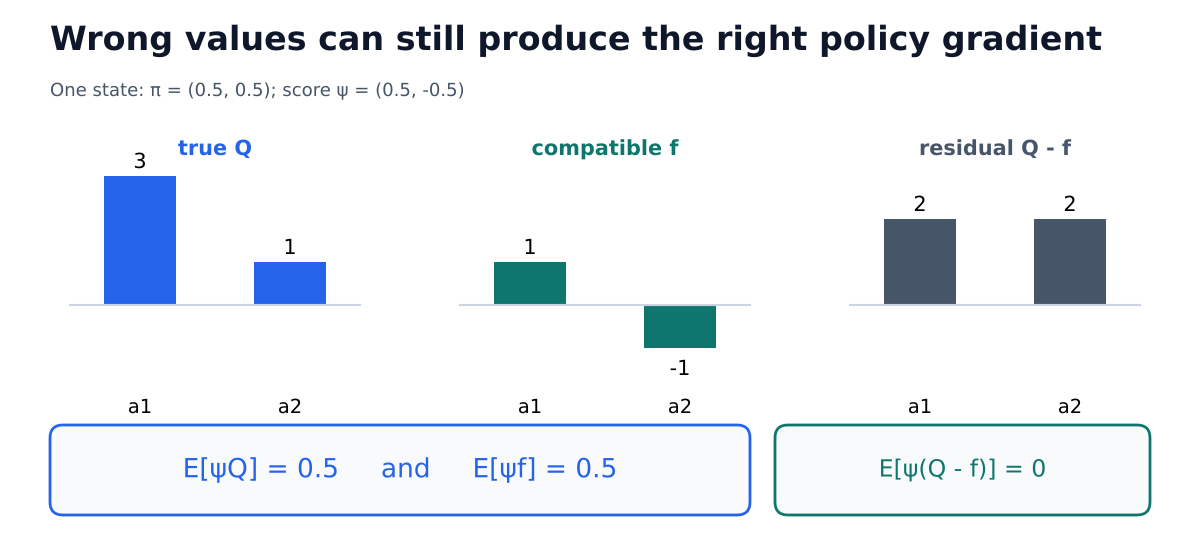
三组柱从真实Q、近似f一直读到两者残差:两个动作都错2,但加权score的正负项相消。图中价值误差不为零而策略梯度一致,说明兼容条件关心的是误差投影;若换成任意深网或不匹配采样权重,这个相消不能自动成立。
三个理论结论构成递进而非三个独立标签:梯度定理先把环境未来影响汇入Q和策略访问分布;兼容近似再要求Critic的特征与策略score匹配,并满足加权误差驻点,使代入近似Q不改变梯度;后续收敛论证还依赖交替更新等条件。因而任意低MSE的深度Critic、共享主干或离策略回放,都不能仅因名称相同自动享有这些保证。 查看原文。
五、从兼容条件退回有限样本近似
Theorem 1的梯度表达、Theorem 2的Critic可替代条件与后续交替更新分析解决不同问题。有限采样、未充分拟合、分布不匹配和共享网络都可能破坏兼容条件;使用了Actor与Critic两个名称,并不意味着实现满足这些定理。
继续追问:分布、拟合和共享表示
1. 共享 Actor/Critic 主干是否仍满足兼容条件?
共享主干本身既不保证也不必然破坏兼容性。经典条件要求动作价值近似对其权重的导数等于策略 score 特征,且在规定访问分布加权的误差目标上满足驻点条件。任意共享深度 Critic 通常不符合这一特定参数化;价值损失还会通过共享参数改变策略。必须明确梯度是否隔离、哪些参数固定及逼近目标,不能从“Actor/Critic共用特征”推出定理适用。
2. 为什么值函数误差很小仍可能使梯度方向错误?
策略梯度误差是 ,不是未加权的均方误差。误差即使很小,也可能集中在 score 很大或决定动作排序的状态动作上;当真实梯度接近零时,更容易翻转方向。应检查误差与策略特征的相关、关键动作差值及访问权重。兼容近似使相关误差满足正交条件,才是其价值,而非要求所有 Q 都拟合得极准。
3. off-policy 数据需要怎样的分布修正?
估计原 on-policy 目标通常既涉及动作比率 ,也涉及目标与行为状态访问分布的差异;轨迹或逐决策重要性采样可在相应条件下处理这种差异。仅乘一步动作比率仍是在行为状态分布加权下更新,除非另有目标定义或状态校正。支持覆盖和有限方差很关键;截断权重虽稳定,却需披露引入的偏差或改变的固定点。
六、把兼容正规方程接到策略几何
直接理论承接:自然策略梯度。兼容特征的拟合方程怎样变成Fisher预条件化,是下一个需要解释的具体环节。
估计器组合:GAE。在实际有限样本中还需选择怎样的优势权重;估计器的偏差方差不能由兼容近似定理自动消除。
原论文与图表入口。Theorem 1—3,特别Theorem 2证明与兼容特征解释。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:策略改变会影响状态分布,为什么公式不需要显式计算状态分布的导数?
参考答案:策略梯度定理通过价值函数的递归关系,把这种长期影响整理进状态访问权重和 Q 值。于是梯度可写成“访问权重 × 动作概率导数 × Q”的形式。状态分布的影响没有消失,只是不再需要单独对它求导。
问题 2:Critic 的预测误差很小,是否就能保证 Actor 得到正确梯度?
参考答案:不能。Actor 需要的是与策略梯度方向相关的价值信息。误差即使整体很小,也可能集中在关键动作方向。兼容函数逼近通过特定特征结构与拟合条件保证相关正交关系;任意神经网络回归并不自动满足这些条件。