第 07 天|Options:把“到达门口”也当作一个动作
原论文与版本:Between MDPs and Semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning,1999。原论文。
阅读范围:本轮已通过UMass托管原PDF读到§2—4,包括定义、SMDP学习、房间规划及中断定理。§5—7的全部证明与实验重复仍未逐项审核;下面手算仍为独立教学构造。
先接住前作的问题
Q-learning与SARSA的教学更新都在每次原始动作后推进一步。即使价值估得准确,长距离导航仍可能需要逐格选择与传播。Options直接扩展动作及决策时间的表示:把有启动条件、内部控制和终止规则的行为当作一个选择;它与一步TD是理论上的推广关系,不是给SARSA换一个动作名字。
五个前置概念
- 时间抽象:用多步行为作为决策单位。
- 启动集合:允许开始某技能的状态。
- 内部策略:技能执行期间的反馈控制。
- 终止函数:决定何时归还上层控制。
- SMDP:决策间隔允许变化的决策过程。
一、问题设定:一次上层决策持续多步时,奖励和折扣怎样计算
“走到门口”不是固定的一串左转右转:途中可能遇到障碍,执行长度也会变化。上层想复用这段行为,就必须同时知道何时能调用、如何在内部反应,以及何时收回控制。评价它时还不能忘记这些内部步骤消耗的时间。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 单智能体、时间抽象与层级强化学习框架 |
| 状态/观测 | 底层环境状态;上层在 option 边界选择 |
| 动作 | 上层 option,内部仍执行原始动作 |
| 奖励或学习信号 | 持续 k 步内的折扣奖励累计 |
| 终止/边界 | β(s) 决定 option 终止;环境终止优先 |
二、把技能三元组接入半马尔可夫目标
把原子动作扩展为 ,不是简单把多个动作拼成字符串。启动集合规定何时可调用,内部策略依观测闭环决策,终止函数规定何时交还控制。因此一个“到门口”的option在不同轨迹中可以持续不同步数,也可以途中避障。
在上层决策时刻观察,持续时间k是随机变量,所以过程成为半马尔可夫过程。Bellman目标先累加技能内部的折扣奖励,再把结束时的价值乘 。只给技能一个总奖励而忘记时间,等于偷偷改变了目标。
call-and-return是最容易实现的执行规则,却不是整个框架的边界。原文讨论从片段学习多个option,以及根据价值中断技能;这些问题说明时间抽象不仅改变动作集合,也改变能从一条经验中学习哪些行为。§4中断定理在真实价值下允许于继续当前option不如重新选择时提前终止;近似价值可能误判,不能无条件继承改进保证。
在技能结束处使用持续时间折扣
k 是技能实际持续时间,所以未来价值要乘 γ 的 k 次方。若漏掉 k,长技能会被错误估值;最终可选技能还须满足启动集合。
一步技能是时间抽象的校验端点
令技能恰好持续 ,累计项只剩当前奖励,尾部折扣也退回一次 ,公式恢复一步动作价值更新。这个端点检查能发现实现把技能名而非实际持续时间当成时间单位的问题。
验算走廊技能为何不能只折扣一次
以下是可手算的教学构造,不是论文实验。
“穿过走廊”持续3步,奖励依次(0,0,2),,结束位置最优价值5。目标为。若误写成总奖励2加,会得到6.5,过度偏爱长技能。
若相同option只用2步完成,内部奖励和尾部折扣都必须重新按实际时间计算;不能给同一名字的技能固定套用k=3。
三、执行技能并按实际持续时间累计回报
输入:固定 options (I_o,π_o,β_o)
上层处于状态 s:
  从可启动 options 中探索选择 o
  R ← 0;k ← 0;s_start ← s
  repeat:
    a ← π_o(s);r,s_next,done ← step(a)
    R ← R+γ^k*r;k ← k+1;s ← s_next
  until done 或 β_o(s) 采样为终止
  y ← R if done else R+γ^k*max_可启动o' Q(s,o')
  Q(s_start,o) ← Q(s_start,o)+α*(y-Q(s_start,o))
输出:上层 option 策略
实现要点:该伪代码假设技能给定,技能发现属于另一个学习问题;终止概率与环境 done 不是同一个量。
四、读房间传播与地标中断的不同证据
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | §3四房间规划/学习;§4连续地标导航 |
| 数据来源与规模 | 房间规划预先给定hallway options及准确模型;学习实验另用交互 |
| 对比基线 | 原始动作A、hallway集合H及A∪H;中断与不中断 |
| 训练预算与资源 | 内部步数和上层决策数需分别计量 |
| 指标及其含义 | 价值传播、每回合环境步数、导航路径长度 |
| 随机性与不确定性 | 房间ε=0.1、γ=0.9;图6后段10回合平滑不等于10个独立训练种子 |
| 实际验证的假设 | 时间抽象能否与原始 MDP 一致地组合 |
实验解读(本文分析):图4预先给出准确hallway模型,展示房间级规划的价值传播,而非自动技能发现;图5将目标移到房间内部,必须保留原始动作补足技能覆盖。图6中仅用H长期可能落后,说明更快早期到达不等于同样的最终最优性。图7地标导航把不中断的600步缩至中断的474步,原始动作最优为425步;这隔离的是已给控制器的切换收益,不是现代网络训练成绩。
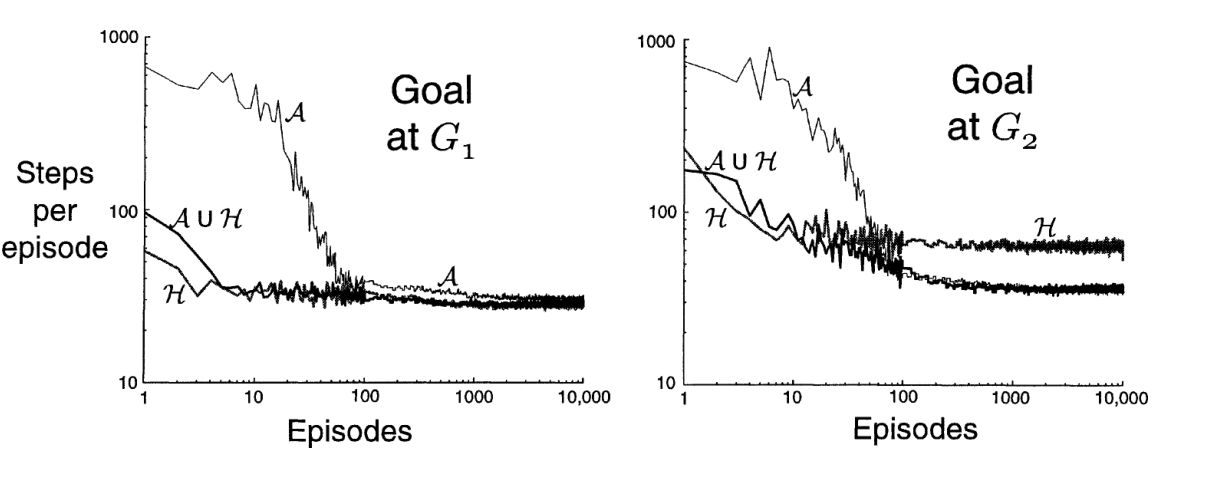
左右列分别以G1和G2为目标,横纵轴均为对数刻度。G2中仅H的曲线最终较高,说明早期学得快不等于最终路线同样短;A∪H保留了到达内部目标的能力。
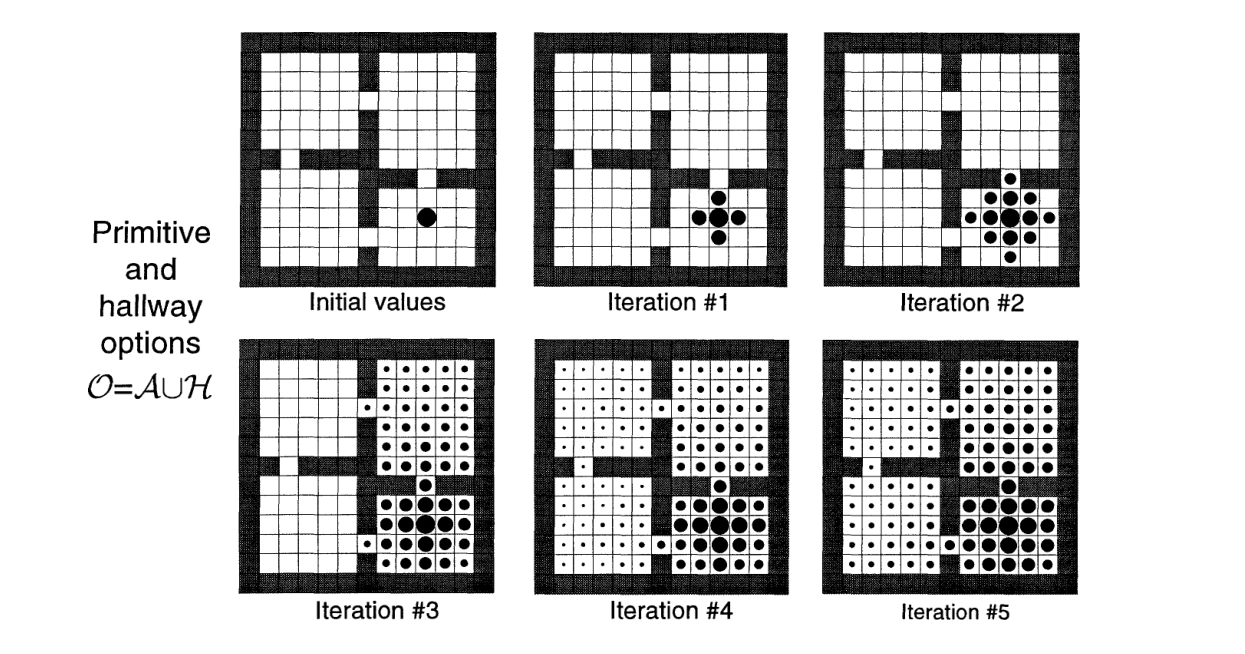
目标移到房间内部后,依次读六个迭代面板:先靠原始动作把价值传到走廊,再利用走廊option扩散。此图的动作集是A∪H,不能据此认为只有H也能到达任意目标。
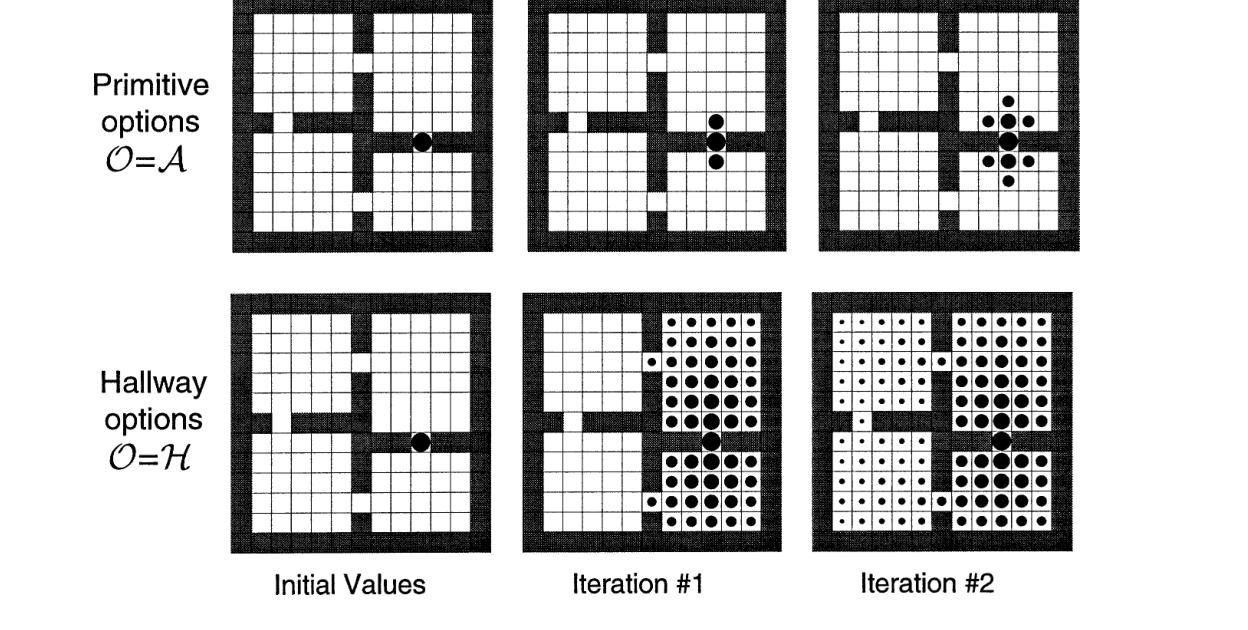
两排从相同初值出发,上排只用原始动作,下排使用走廊option。黑圆的传播范围说明一次规划更新跨越的时间尺度不同;此处模型已准确给定。
对照600步与474步的控制器切换
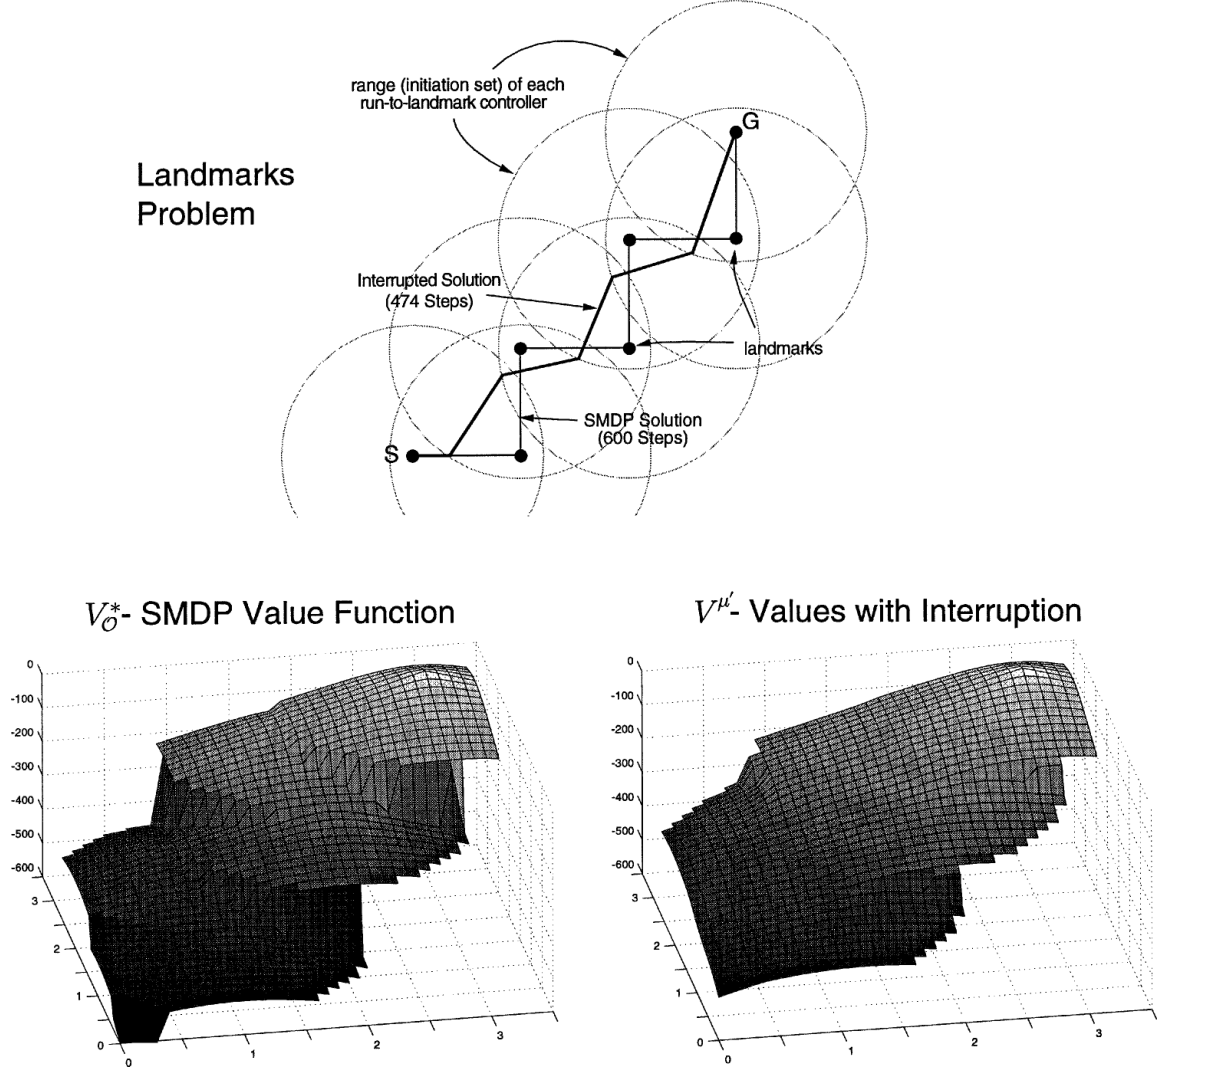
上方细折线按完整option走到地标再切换,粗折线允许途中切换,图内分别标示600步与474步。下方两个价值曲面对应同一任务的两种控制方式;这是有具体价值条件的中断收益,不能仅因几何上更短就断言任意近似控制器都更好。
房间实验将规划与学习分开:图4和图5用准确option模型做价值传播,比较跨房间传播与原始动作的逐格传播;图6才以交互回合检验SMDP Q-learning,须同时看纵轴原始步数和横轴回合。A、H、A∪H分别表示原始动作、走廊技能及其并集,目标不在技能终点时保留原始动作尤其重要。图7展示中断地标控制器可缩短路径;相应定理依赖真实价值比较,不能保证近似价值的每次中断都正确。 查看原文。
五、检查技能覆盖与中断判断是否限制最优性
技能覆盖决定上层能表达哪些策略,持续太久则会推迟纠错。option数量多不等于选择充分,还需检查启动集合、可终止性及是否保留必要原始动作;减少上层决策次数也不保证模型构建与规划的总成本下降。
六、继续追问:可表达策略、预算与技能来源
1. 哪类 option 会损失原始最优策略的表达能力?
若只保留会强制执行多步、无法中断的技能,且任何技能都不能实现最优策略所需的短时动作序列,最优值就可能下降;起始集遗漏关键状态也有同样问题。若每个原始动作都作为一步 option 保留,原 MDP 的策略仍在可选类中,表达能力不因额外技能而减少。这里讨论最优可表达值,不保证有限数据下的学习速度或找到最优解。
2. 如何公平比较一次上层决策与十次原始动作?
应同时计量原始环境步数、上层决策数、模型调用和总计算时间。一次持续十步的 option 在样本预算中消耗十次转移,其目标包含内部累计折扣奖励以及 的终点价值,不能按一次普通动作折扣。若比较规划效率,还应计入 option 模型构建与内部策略执行成本;仅横轴换成上层决策次数会掩盖成本。
3. 为什么固定技能发现与技能选择应分开评测?
固定技能下的选择器实验回答“这些技能给定后是否易于控制”;发现实验回答“从什么数据、奖励和计算预算得到这些技能”。把预制门口技能与从零学技能的算法放在一起,可能把人工先验算成选择器收益。应分别报告技能训练成本、覆盖与可组合性,再在相同下游任务和原始交互预算下评价选择器;技能多样性也不能替代下游收益。
七、从给定技能走向技能发现
底层更新对照:Q-learning。保留一步原始动作作为可选option,有助于检查技能集合是否排除了原任务中的必要选择。
教学联系与潜在组合:DIAYN。本篇假定或组织技能,后者追问如何无任务奖励地学出可区分行为;潜变量技能仍不自动包含完整option三元组。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:把“走到门口”作为一个动作,需要定义哪些东西?
参考答案:需要启动集合、内部策略和终止规则:在哪里可以开始,开始后怎么走,何时结束。因为一个 option 持续多个时间步,上层更新需要累计期间奖励,并按持续时间 使用 折扣后续价值。
问题 2:时间抽象为什么既能简化问题,也可能限制最优解?
参考答案:上层不用每一步都决策,可以复用长行为。但如果提供的技能无法完成某种必要动作组合,上层再聪明也无法选择它。Options 提供组织技能的框架,并不自动保证技能集合足够好,也不自动解决技能发现。