第 12 天|Guided Policy Search:先找到好轨迹,再让策略学会产生它
原论文与版本:Guided Policy Search,2013。原论文。
先接住前作的问题
REINFORCE能从自身采样的奖励构造策略梯度,但复杂运动中随机策略可能几乎见不到好轨迹。GPS沿一条平行路线借助局部轨迹优化来产生引导样本;新问题随即出现:这些样本来自引导分布,不能直接当成当前策略的成绩。本篇限定2013版本,不把后来视觉机器人或约束式GPS一并写入。
五个前置概念
- 轨迹优化:直接优化一段控制序列。
- DDP:利用局部动力学与二阶近似改进轨迹。
- 重要性采样:修正数据分布与目标分布差异。
- 分布偏移:训练状态与实际访问状态不同。
- 局部策略:只在有限区域可靠的控制器。
一、问题设定:随机探索见不到好轨迹,策略怎样得到可用信号
“先找到一次成功”与“让通用策略学会稳定产生成功”是两个问题。局部动力学优化可以提供较好的运动轨迹,策略搜索却要处理引导分布与自身分布之间的差异。GPS把采样来源、重要性估计与约束偏离放进同一个循环。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 轨迹优化辅助的连续控制策略搜索 |
| 状态/观测 | 连续动力学状态 |
| 动作 | 连续控制量 |
| 奖励或学习信号 | 轨迹任务成本的负值 |
| 终止/边界 | 有限轨迹长度及任务约束 |
二、从引导分布重加权到当前策略目标
2013 GPS面对的是探索困难:随机策略几乎见不到像样的运动,纯策略梯度就缺少可利用信号。局部轨迹优化器先利用动力学和代价找到较好轨迹,再把这些轨迹分布作为策略搜索的数据来源。
难点在于好轨迹来自q,不来自当前 。重要性采样用轨迹概率比修正期望,但长轨迹的比值乘积容易由少数样本支配。原文因此配合正则化、引导样本与当前策略样本,迭代检查新策略,不是训练一次行为克隆就结束。
正则的作用是限制策略跑到样本不支持的区域。它保护估计质量,却可能抑制真实改进;原算法根据新旧策略估计调整强度。DDP提供局部引导,并不保证找到全局最好轨迹;也不能把2013版本与后来约束式GPS、视觉机器人系统混为一个算法。
由轨迹比值进入前缀归一化与正则目标
教学示意:。q 是引导采样分布。论文的正则化与采样组织用于控制直接重要性估计的困难;此式是入口,不是完整目标的替代。
把恒等式落到原版算法,还要区分“期望等式”和“有限样本估计”。原文§3,PDF第2页使用轨迹前缀比值 ,令 ,目标写成
前一项先按前缀概率重加权,再归一化;未来动作不必参与过去奖励的权重。后一项要求策略仍给至少一部分已有样本足够概率,否则所有权重都极小但相对排名有利时,归一化回报仍可能虚高。 是正则强度,不是重要性权重。自归一化比值在有限样本下不能直接称无偏;多来源样本还须使用实际混合采样分布作 ,并有支持覆盖。这才解释为什么只列一个重要性恒等式不足以实现GPS。
为什么要用轨迹前缀而非整条比值
第t步奖励已经发生,t之后的动作不能改变它。对未来动作的概率比先取条件期望会得到1,因此可把全轨迹比值缩成到t为止的前缀比值;实际自归一化估计还另有有限样本偏差。
算清引导回报8为何不是策略回报4
以下是可手算的教学构造,不是论文实验。
两条轨迹在引导分布中的概率为q=(0.8,0.2),回报(10,0);新策略概率p=(0.4,0.6)。不加权数据回报平均8,真实策略期望却只有4。重要性加权为。
如果q对新策略偏爱的轨迹只给极小概率,有限样本就可能根本没见过它。公式无偏需要支持集等条件,不能用一次“大权重修正”弥补无数据。
三、交替生成引导样本、修正分布并检验新策略
输入:策略 πθ、轨迹优化器、动力学/任务代价
初始化策略与引导轨迹
重复:
  用轨迹优化产生高质量局部轨迹分布 q
  收集引导轨迹与当前策略轨迹
  计算样本来源相关的概率/重要性信息
  优化原文带正则的策略目标
  运行更新策略,检查状态分布偏移
  必要时重新优化引导轨迹
输出:可直接执行的参数化策略
注:正则求解器与分布估计未展开成可运行代码
实现要点:依赖轨迹优化器与相关模型假设,不能当成纯无模型学习。
四、读去引导、去正则与预训练对照
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 原文连续运动控制任务 |
| 数据来源与规模 | 轨迹优化样本与策略执行样本 |
| 对比基线 | 直接策略搜索及文中相关基线 |
| 训练预算与资源 | 每任务引导与执行预算本文未逐项核实 |
| 指标及其含义 | 轨迹任务收益、复杂行为学习 |
| 随机性与不确定性 | 随机重复与误差条本文未完整核实 |
| 实际验证的假设 | 引导样本能否改善复杂策略优化 |
实验解读(本文分析):原文图2对照去掉引导、去掉正则及restart分布等变体;所有方法每轮10次rollout,但引导版本另用40个guiding samples。这个设计有助于区分“只访问好状态”和“把引导样本纳入策略目标”,也提醒读者不要把相同迭代数误称完全相同数据与模型计算预算。
分清灰带与训练随机性的含义
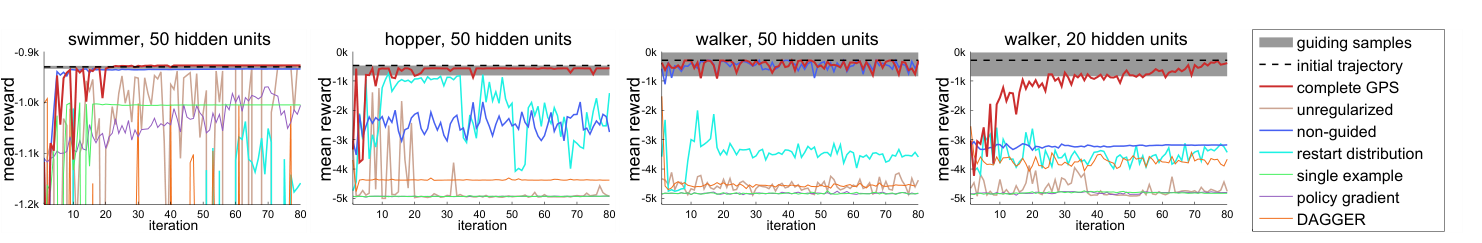
四个面板横轴都是优化迭代,纵轴是每轮rollout的平均奖励,较不负表示较好;swimmer与其余任务的纵轴尺度不同。红线是完整GPS,黑虚线是初始轨迹,灰带表示引导样本回报的范围(原文为两倍标准差),并非红线跨训练种子的置信区间。最后一个较小步行网络面板尤其用于检查:只在预训练时见过引导,是否足够支持后续改善。
2013版GPS的关键对照在图2:完整方法与移除引导、移除正则等变体比较,检验高质量轨迹来源和分布修正是否共同必要。图注说明每轮各方法使用10次rollout,而引导变体还使用40个引导样本,所以横轴迭代不能直接当作相同总采样成本。这里的监督拟合只是循环的一环,轨迹优化器及其模型条件仍是方法成本的一部分。 查看原文。
五、同时计算引导收益与额外采样成本
轨迹引导依赖优化器的模型与局部解,可能比普通Actor拥有更多信息。初始轨迹、模型准确性和局部最优都影响结果;后续GPS版本的约束匹配等机制需另行核对,不能从2013年的重要性采样框架一概外推。
六、继续追问:支持覆盖、权重与模型条件
1. 如果引导轨迹本身是差的局部解,策略会学到什么?
策略容易继承引导轨迹的局部缺陷,尤其当引导样本权重大、覆盖窄且策略缺少新的探索时。GPS 将轨迹优化和策略学习交替推进,可以改进引导分布,但不保证逃出所有局部最优。应改变初始轨迹和起始状态、加入多条解支路,检查策略最终收益是否超出引导轨迹,同时保留轨迹优化失败率,而不只展示成功示范。
2. 引导优化的计算应怎样计入训练成本?
训练成本至少包括真实交互、局部动力学估计或已知模型调用、轨迹优化迭代、重要性权重计算及策略网络拟合;并行硬件和人工初始示范也应说明。若核心价值是减少昂贵机器人试验,可单列真实试验节省,但不能据此宣称总算力更低。应在相同真实样本和相同墙钟两个预算口径分别比较,报告达到同一测试水平的成本。
3. 为何离线行为克隆不等于完整 GPS?
离线行为克隆固定数据集并最大化示范动作似然,不主动寻找更高回报轨迹,也不处理引导分布随策略变化的耦合。完整 GPS 包括以任务代价优化引导轨迹、让策略覆盖这些轨迹,以及控制或修正采样分布差异。一个相同的监督拟合子步骤不等于相同算法;若去掉轨迹搜索,应明确称为其消融或纯模仿基线。
七、继续辨析分布偏移的不同处理方式
平行采样路线:REINFORCE。在没有可用动力学引导时,仍需从策略自身采样,代价与分布修正条件不同。
教学对照:TRPO。两者都面对分布变化使旧样本失真的问题,但TRPO的替代目标和KL约束不是GPS正则的改名。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:轨迹优化已经能找到好轨迹,为什么还需要训练策略?
参考答案:轨迹优化通常针对局部初始条件求解,执行时重新优化也可能昂贵。参数化策略可以直接根据观测输出动作。2013 年 GPS 用优化得到的轨迹引导采样,并通过带正则的重要性采样目标训练策略,使搜索不必从低质量随机行为开始。
问题 2:为什么不能把 GPS 简单理解成“复制成功轨迹”?
参考答案:策略实际执行会访问与引导轨迹不同的状态,小误差可能逐步累积。还存在样本来源分布与目标策略分布的差异,需要在优化中处理。单纯对成功动作做监督拟合,没有覆盖这些问题。