第 11 天|Double Q-learning:为什么取最大值会制造乐观偏差
原论文与版本:Double Q-learning,2010。原论文。
先接住前作的问题
Q-learning用最大动作价值构造目标,但有限样本估值会带噪声。它的渐近收敛结论没有消除训练过程中“挑中正误差”的问题。Double Q直接修改这个最大化环节:把挑选动作和给动作打分分开。
五个前置概念
- 最大化偏差:选择最大噪声估计产生乐观倾向。
- 双估计:将选择和评价交给不同估计器。
- 估计相关性:两套误差是否一起变化。
- 低估:预测低于真实期望。
- 随机逼近:用采样更新渐进逼近期望方程。
一、问题设定:各动作估值无偏,取最大值为何仍会高估
如果两个动作真实同样好,各自估值也平均正确,每次总挑估得较高的那个,报告出来的价值仍会偏高。选择操作筛选了误差。这里要修正的是选择与评价复用同一噪声的机制,而不是让每个单独估计器更大或更复杂。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 表格、无模型、off-policy 控制 |
| 状态/观测 | 有限状态 |
| 动作 | 离散动作 |
| 奖励或学习信号 | 可能带噪的奖励 |
| 终止/边界 | 终止时不 bootstrap |
二、分开挑赢家与评价赢家
最大值的偏差来自“同一噪声被使用两次”:先凭估计挑赢家,再把赢家的估计当成真实收益。即使每个动作估计各自无偏,挑中的误差也倾向为正,所以最大值与期望不能交换。
Double Q把两件事交给不同估计器。A负责选择a*,B评价这个被选中的动作;随机更新哪张表,使两组经验形成不同误差。它没有取两个Q的最小值,也没有要求两个Q永远完全独立;独立性是双估计分析的理想条件,实际自举中关联仍需留意。
为什么会低估?A有时会选到真实次优动作,B即使无偏地评价该动作,得到的也小于真正最优动作的值。算法切断选择噪声的自我奖励,却没有解决“选错动作”的全部问题。
让一张表选动作、另一张表提供目标值
的带噪估计满足 。这不等于 Double Q 对每次样本都准确,也不表示误差从此为零。
比较的是选中动作的误差分布
先固定A选中的索引,再考察B在该索引上的条件误差。理想独立性让“被A挑中”不自动抬高B的平均误差;若两表共享同一种误差,这个条件就可能失败。关键不是两个数值是否碰巧相等。
枚举四种噪声情形并算最大值期望
以下是可手算的教学构造,不是论文实验。
两个动作真值都为0,各自估计独立等概率取+1或−1。单估计最大值在四种情形中为(1,1,1,−1),期望0.5。若A选动作而独立B评价,B对被选动作仍为±1各半,期望0。
再把真值改成(1,0),A偶尔选错第二个动作,B的期望评价就可能低于1。这解释“减轻高估”不等于“保证无偏”。
三、随机选择一张表更新并交叉取目标
初始化 Q_A,Q_B
用 Q_A+Q_B 的探索策略采样转移
每条转移随机选择一个表更新:
  若更新 A:
    a_star ← argmax Q_A(s_next,a)
    y ← r if done else r+γ*Q_B(s_next,a_star)
    Q_A(s,a) += α*(y-Q_A(s,a))
  否则交换 A 与 B 执行同一过程
输出:两表组合产生的策略
实现要点:双估计也可能低估,两个估计高度相关时收益有限。
四、同时读取奖励曲线与起点最大Q
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 构造的随机 MDP |
| 数据来源与规模 | 随机奖励转移流 |
| 对比基线 | 单表 Q-learning |
| 训练预算与资源 | 具体重复预算见实验节,本文未逐项核实 |
| 指标及其含义 | 价值偏差与决策表现 |
| 随机性与不确定性 | 理论期望与实验随机性分开 |
| 实际验证的假设 | 选择/评价分离是否缓解高估并改善控制 |
实验解读(本文分析):图2同时画平均奖励与起点最大Q,平均10000次运行。原文特意指出:Double Q的策略更好,并不意味着其价值估计在10000步内明显更接近真值。这是重要的负面辨析,应读两行图而不能只挑回报曲线;动作排序正确有时比绝对价值误差小更关键。
上下两排分别检查行为与估值
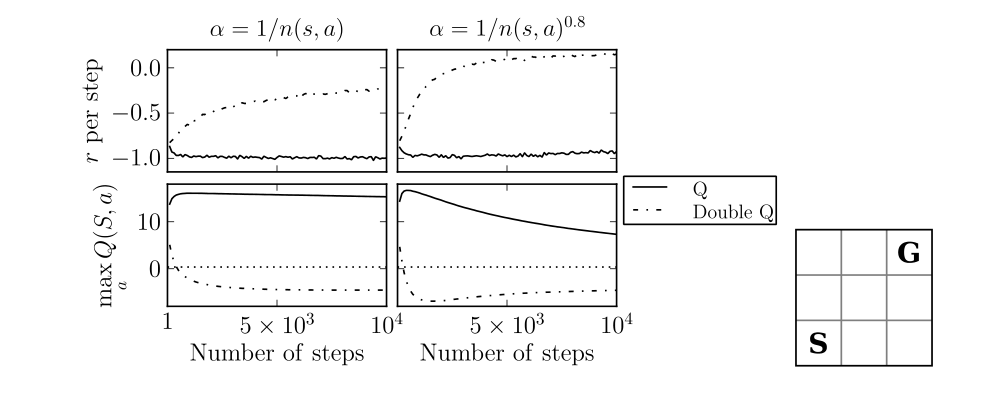
图2两列分别采用不同的步长衰减日程,横轴都是环境步数;实线为Q-learning,虚线为Double Q。上排每步奖励越高越好,下排则应比较估值与真实值的偏差,不能一律把更低当成更好。先在同一列内读两种算法,再比较两列,才能把双估计机制与步长选择分开;图中的均值并不展示单次训练的全部波动。
双估计分析分离“哪一个动作看起来最大”和“该动作值多少”,因此减少同一噪声同时参与选择与评价的偏差,并不宣称两估计总无偏。图2把网格任务的平均每步奖励放在上排、初始状态最大估值放在下排;要同时检查收益与估值,不能把Q数值较低直接当作策略更好。表格收敛还依赖充分访问等条件,不覆盖任意目标网络实现。 查看原文。
五、减少高估之后仍可能低估或选错
交叉评价可能低估,两个估计高度相关时也会残留选择偏差;增加估计器还使样本分配更复杂。图中策略收益与绝对估值并不同步,因此应同时测真实回报,不能只以Q是否降低评价算法。
继续追问:估计相关性与行为收益
1. 两张表完全共享噪声时还能减轻偏差吗?
若两个估计完全相同,交叉评价退化为用同一噪声选择并评价最大动作,高估抑制便消失。部分相关时通常只减弱而非彻底消除选择偏差;其大小还与动作真值差、噪声方差和相关结构有关。应固定单个估计器误差分布,改变两者相关性进行受控测试,不能只凭“用了两张表”推断独立性或无偏性。
2. 真值差很大与几乎相等时,偏差风险有何不同?
真值差远大于估计噪声时,最大动作很少选错,选择噪声的机会较少;若多个动作真值接近,max 更容易挑中偶然偏高者。后者数值高估可能更大,但是否造成大回报损失还取决于选错动作的真实差距。应分开报告估值偏差、动作误选概率和决策遗憾,避免把这三种量混为一谈。
3. 取 min 和交叉评价分别解决什么问题?
交叉评价用一个估计器选动作、另一个给该动作估值,针对选择与评价共享噪声造成的最大化偏差;取两估计的 min 则主动采用较保守的目标,常能抑制高估但也引入低估。二者并不等价,既可有不同固定策略偏差,也可组合。原 Double Q 的表格收敛条件不能自动移植为任意 clipped double-Q 深度算法的保证。
六、把双估计带到相关神经网络中
直接方法承接:Double DQN。在线与目标网络可分担选择和评价,但周期复制使它们相关,需要重新理解双估计的近似。
教学对照:TD3。双Critic取最小值也为控制高估,却不是本篇交叉选动作的同一公式。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:零均值估计误差为什么会在取最大值后变成高估?
参考答案:设两个动作真值均为 0,误差独立地以相同概率取 ±1。四种估计组合的最大值分别为 −1、1、1、1,平均为 0.5。最大化倾向选择正误差,所以“每个估计无偏”不意味着“最大估计无偏”。
问题 2:用一个估计器选动作,另一个估计器打分,为什么有帮助?
参考答案:被选动作在第一个估计器上的正误差,不必同时出现在第二个估计器上,从而减弱选择与高估的关联。但两个估计器可能相关,也可能因选错动作出现低估,因此它不是获得精确价值的保证。