第 10 天|LSPI:反复利用同一批数据进行策略迭代
原论文与版本:Least-Squares Policy Iteration,2003。原论文。
先接住前作的问题
TD(λ)让价值评价可以逐步进行,Q-learning再把采样目标用于控制。它们仍留下有限数据怎样充分利用的问题。
五个前置概念
- 策略迭代:交替评价与改善策略。
- 线性价值逼近:Q 是固定特征的线性组合。
- 投影 Bellman 方程:把目标映射回可表达函数空间。
- 条件数:衡量矩阵求解对误差的敏感性。
- 数据覆盖:样本是否包含决策所需信息。
一、问题设定:固定一批转移,怎样反复评价并改进不同策略
一批转移记录了环境在已访问状态动作上的反应。当前策略改变以后,环境记录仍可使用,但下一状态准备采取的动作变了,评价方程也必须改变。LSPI要从同一批证据反复提取策略评价信息,而不是把重复求解计作更多独立样本。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 基于批量转移、无模型、近似策略迭代 |
| 状态/观测 | 环境状态的人工或固定特征 |
| 动作 | 可计算 argmax 的离散动作 |
| 奖励或学习信号 | 转移中的实际奖励 |
| 终止/边界 | 终止时后继特征为零 |
二、由特征正交条件构造 LSTDQ 方程
LSPI 将策略迭代拆成两个可重复步骤:固定π求近似 ,再对该Q贪心改进。数据集可以不变,但标签不能固定,因为后继动作 会随着策略改变。
为何不是普通最小二乘拟合TD目标?LSTDQ要求Bellman残差与当前特征正交:。整理才得到 。矩阵A包含当前与后继特征的交叉项,通常不对称;把它换成逐样本残差平方的正规方程,会得到不同方法。
这种批量求解可以高效复用有限转移,却不能创造数据中没有的动作信息。特征线性无关、状态动作覆盖、矩阵条件数与策略迭代中的分布变化都重要。求解器成功返回w,不意味着这个w的贪心策略在数据外可靠。
构造不一定对称的A矩阵与奖励向量
A 一般不是普通回归的对称协方差矩阵。求解的是投影 Bellman 固定点,不能随意等同于最小化逐样本 Bellman 残差。
线性方程的形状也是实现检查
特征为d维列向量时,每项 是d×d矩阵, 是d维向量。交换两个外积因子会把A转置;即使维度仍对,也不再是这里的正交方程。
检查终止掩码怎样改写同一批奖励
以下是可手算的教学构造,不是论文实验。
取一维特征φ=1,两条样本奖励为1和3,后继仍非终止且φ′=1,。则,符合平均奖励2的持续过程价值。
若第二条其实终止,φ′应置0,于是。同样的奖励,终止掩码改变了Bellman方程;这不是数值正则能补救的小误差。
三、固定转移集并随策略重建后继特征
输入:固定转移集 D 与特征 φ;初始策略 π
repeat:
  A ← 0;b ← 0
  for (s,a,r,s_next,done) in D:
    x ← φ(s,a)
    x_next ← 0 if done else φ(s_next,π(s_next))
    A += x*(x-γ*x_next)ᵀ;b += x*r
  解 Aw=b(必要时明确数值正则)
  π_new(s) ← argmax_a φ(s,a)ᵀw
  判断策略或参数是否收敛
  π ← π_new
输出:Q_w 与 π
四、对照倒立摆曲线的尺度与采样预算
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 链式 MDP、倒立摆、自行车等原文控制问题 |
| 数据来源与规模 | 收集的状态动作转移,可多轮重复利用 |
| 对比基线 | 近似策略迭代、不同特征和学习方法 |
| 训练预算与资源 | 每任务数据量、特征数见实验节;本文未完整核实 |
| 指标及其含义 | 控制回报/平衡表现和数据效率 |
| 随机性与不确定性 | 倒立摆评价1000次、实验重复100次并给95%区间;自行车统计未逐项复核 |
| 实际验证的假设 | 无需反复在线采集,能否从批数据改善策略 |
实验解读(本文分析):§9分别使用链式过程、倒立摆和自行车。链式过程能与精确价值及改进策略对照,检查表示误差如何影响行动;倒立摆图16、图17、图18则对照LSPI、Q-learning与带回放Q-learning。原文说明策略评价运行1000次,整个实验重复100次并给95%区间,且回放基线做100遍数据。这里数据量相同不代表计算量相同。
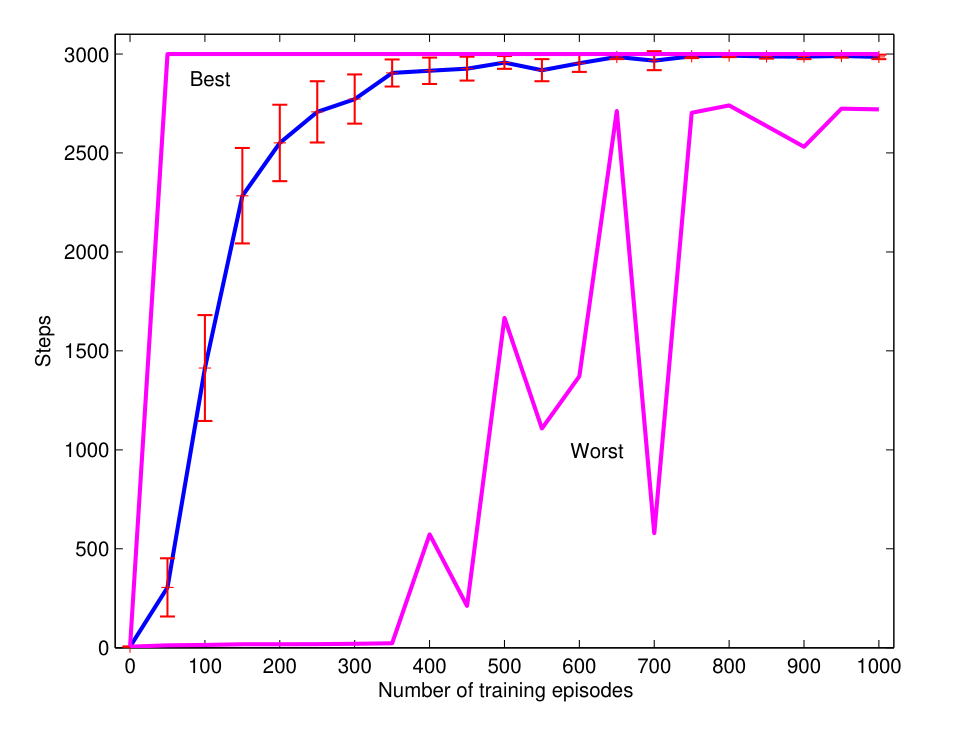
回放版Q-learning的纵轴恢复到3000步上限。蓝色均值、红色误差条和紫色最好/最差数据集曲线要一起看;较好最终平衡成绩还用了同批样本100遍回放,不能与单遍基线等计算量比较。
不要把50步与3000步上限看成同尺度
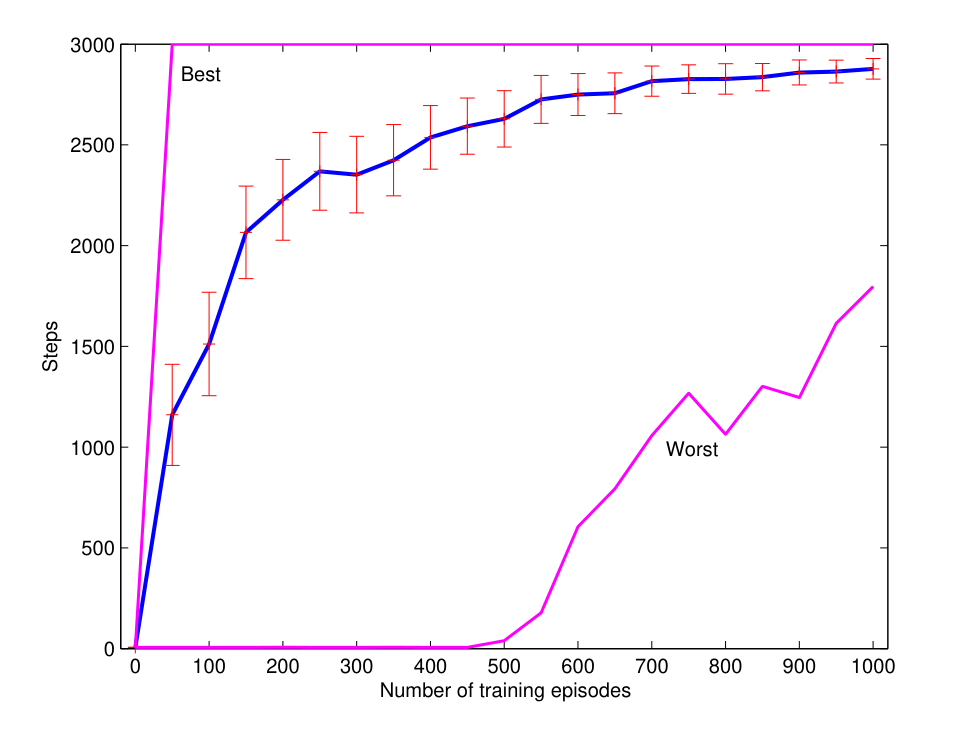
图16的纵轴上限是3000步,蓝线表示跨数据集平均,误差条与最佳/最差数据集曲线揭示样本覆盖的不确定性。横轴增加的是预先收集的随机训练回合,不是测试时继续学习。
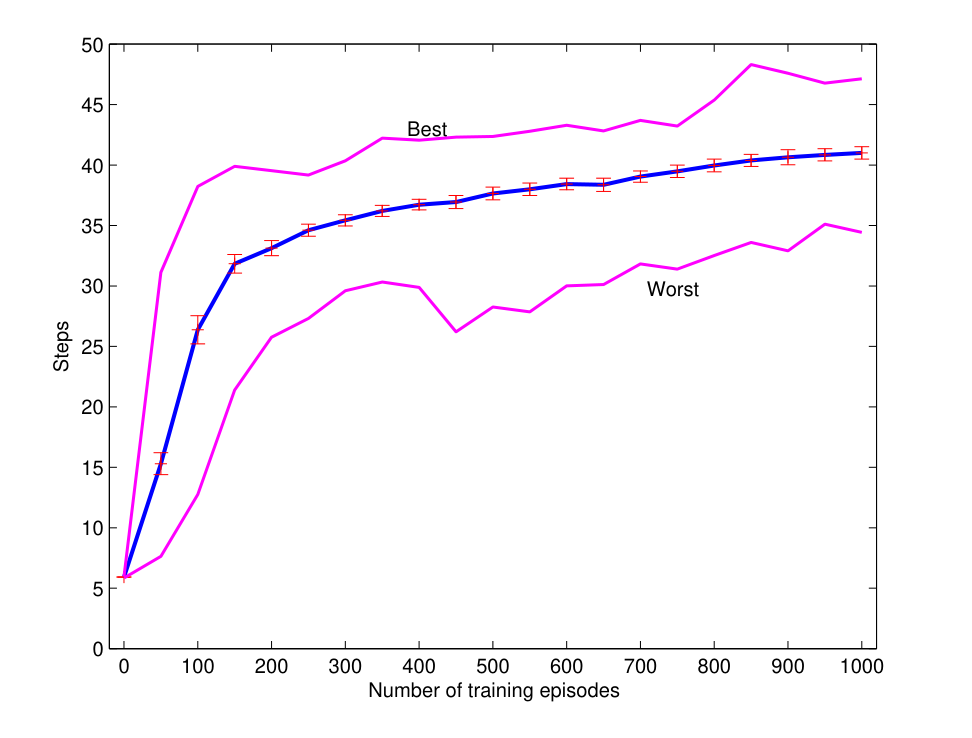
图17采用Q-learning对照,但纵轴最高只有50步,远低于上一图的3000步截断上限。两张图看起来都在上升,若忽略轴尺度就会错读为效果接近;相同特征与样本来源也不能保证两种优化过程同样高效。
图3是LSPI的策略评价—改进框架,不能用框图替代效果证据;其可复用数据的关键在于用同一批转移构建随当前策略改变的LSTDQ方程。倒立摆的图16、图17、图18分别比较LSPI、Q-learning及回放版本,纵轴是平均平衡步数,横轴按原图表示样本预算。结合原文§9.1的独立数据集重复与截断上限来读,才能把数值求解、样本覆盖和控制成功分开。 查看原文。
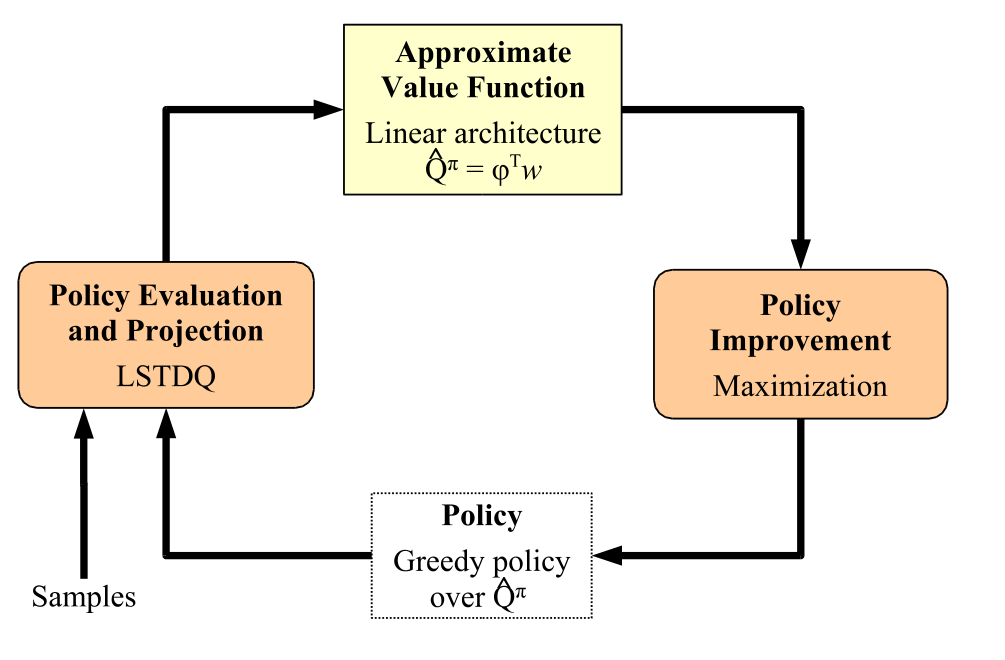
从左下的Samples输入开始:固定数据进入LSTDQ评价,得到当前策略的近似Q,再做贪心改进并回到评价。循环使用同一批转移,并不表示每轮评价方程保持不变。
五、解出方程之后仍要检查数据覆盖
矩阵成功求解只说明给定特征与数据下的近似问题被解出。稀疏覆盖既可能使矩阵病态,也可能让贪心策略追逐不可信动作;重复利用同一批转移不能补出遗漏状态动作的信息。
六、继续追问:特征秩、重复证据与贪心外推
1. 加入一个无法被数据激活的特征会怎样?
若某特征在全部样本中为零,它对应的设计矩阵方向缺乏信息,LSTDQ 方程可能奇异或有多解。岭正则或伪逆能选择一个数值解,却不能从没有的数据中识别该特征的真实价值。更危险的是该特征在部署状态被激活,预测会由正则和初值决定;应检查秩、条件数及部署覆盖,再决定删去特征或补采数据。
2. 同一数据重复求解为什么不等于增加独立证据?
重复求解只是在同一经验转移集合上更充分地求解评价和改进方程,减少优化误差,并没有减少原始样本的统计依赖或增加未观测转移。随着策略改变,同一数据可支持不同 Bellman 目标,但置信区间不能把每轮当作新实验。应使用独立测试轨迹或按原始采样单元做重采样,分别报告样本数和策略迭代次数。
3. 离线场景的贪心改进为何可能降低真实收益?
贪心改进会选择估计最高的动作;覆盖不足时,最高值可能来自外推误差而非真实优势。改进后的策略还会进入与采样分布不同的状态,令投影评价偏差进一步放大。因此经验线性方程被精确求解也不等于真实策略改进。可限制策略偏离数据、对低覆盖动作保守估值,并在允许的独立环境评测或带支持检查的离线评价中验证。
七、从批量控制走向离线动作约束
后续离线问题:BCQ。LSPI留下的外推动作风险,在离线深度控制中更加突出;BCQ通过限制动作候选处理数据支持不足,两者不是同一求解器的版本升级。
评价机制回看:TD(λ)。批量求解改变了利用数据的方式,价值近似和自举目标仍需满足各自条件。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:固定的一批经验为什么可以反复用于不同策略的评价?
参考答案:转移数据记录的是环境关系,而当前待评价策略决定下一状态采用哪个动作。LSPI 每轮根据当前策略重新构造价值评价问题,再据此改进策略。数据不变,但评价对象以及对应的线性方程会变化。
问题 2:为什么精确解出线性方程,也可能得到很差的策略?
参考答案:方程只在给定特征和数据覆盖下成立。特征可能无法表达真实价值,数据可能遗漏关键状态动作,矩阵也可能病态。数值求解准确,只说明解决了这个近似问题,不说明近似问题足以代表真实任务。