第 19 天|优先经验回放:经验并非都值得同样多次重读
原论文与版本:Prioritized Experience Replay,2015。原论文。
先接住前作的问题
DQN通过回放重复利用历史经验,通常均匀抽取;Double DQN修正目标,却没有决定有限更新预算怎样分配。PER与它们是可组合模块:按TD冲突安排重读,同时补偿非均匀采样的影响。它处理已收集数据的利用,不能替代首次探索。
五个前置概念
- 优先级:决定经验抽取倾向的数值。
- 重要性权重:补偿非均匀抽样的梯度偏差。
- TD误差:价值目标与预测差。
- 排序采样:按误差名次而非数值抽样。
- 过期优先级:网络更新后旧误差不再准确。
一、问题设定:经验已经在池中,下一次应该重读哪一条
一个回放池里既有已经预测得很好的转移,也有刚暴露明显错误的转移。优先处理后者可能更快传播信息,却也可能把随机噪声误认为学习价值。若抽样频率改变,还要说明优化目标是否仍是均匀回放下的平均更新。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | off-policy经验回放机制,可与DQN等组合 |
| 状态/观测 | 沿用底层算法状态 |
| 动作 | 沿用底层动作 |
| 奖励或学习信号 | 原任务奖励;优先级不是环境奖励 |
| 终止/边界 | 沿用真实转移终止 |
二、用误差分配抽样概率并修正权重
优先回放问的是“已经存下来的经验,下一次应重读哪条”,不是直接解决首次探索。TD误差衡量当前预测与自举目标的冲突,因而可作学习价值的代理;但奖励噪声、部分可观测和估计错误也会制造大误差。
比例采样与排序采样在异常值上的行为不同。前者保留幅值,后者只保留次序;两者都用α调节集中程度,并保留小概率避免经验永远饿死。旧优先级只有样本被重读时才更新,因此采样依据本身也会过期。
重要性权重解释了偏差:目标若仍是均匀回放下的平均梯度,就应乘 。β<1只做部分修正;归一化权重又缩放整体学习率。高优先级负责“多抽”,重要性修正负责“不把多抽全算成更大权重”,两者并不矛盾。
把多抽与重要性补偿写进同一期望
α=0恢复均匀;β控制修正强度,常逐步趋近1。权重归一化影响整体步幅;α与β的角色不同。
令 为当前固定回放池中第 条转移的更新向量,若使用抽样时的真实概率且 ,则
这是§3.4重要性修正恢复的对象。 是池大小,比例版 ,排序版则按误差名次给优先级。即使优先级来自旧误差,只要分母仍是本次实际抽样概率,上式仍成立;旧优先级主要可能让更新预算分配低效。用另一个版本的概率作分母,才破坏这里的相消。
抽样概率为零为何不能靠权重补救
重要性相消要求均匀目标中的每条经验都具有正抽样概率。若某条 ,它永远不被抽到,除以概率也无从执行;优先级中的正数偏置因此保护的是更新支持,而不只避免一次数值除零。
核对两条经验修正后的贡献系数
以下是可手算的教学构造,不是论文实验。
两条样本优先级(1,3),α=1,抽样概率(0.25,0.75)。均匀目标对每条权重0.5。β=1给重要性权重(2,2/3),因此期望贡献系数分别、。
若将权重除最大值2,系数都变0.25,方向保持但整体步幅减半。β=0则不修正,真正改变了优化时经验的权重。
三、保存优先级、实际概率与重读后的残差
每个新转移以较高初始优先级加入 replay
每次更新:
  按 P(i) 抽 minibatch
  计算当前 TD 目标与 δ_i
  w_i ← (N*P(i))^(-β),按实现归一化
  用 mean(w_i*TD_loss_i) 更新网络
  将本批优先级改为 abs(δ_i)+ε
  更新 β 日程
输出:相同任务策略及非均匀 replay
实现要点:大 TD 误差也可能只是噪声,采样偏差与存储维护有代价。
四、在固定回放库中检验重读效率
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | Blind Cliffwalk、57款Atari |
| 数据来源与规模 | 相同来源replay,改变抽样次数 |
| 对比基线 | 均匀replay、Double DQN、两类优先机制 |
| 训练预算与资源 | 曲线按环境帧或更新次数分别报告 |
| 指标及其含义 | 学习所需更新、归一化分数 |
| 随机性与不确定性 | Cliffwalk图2含10初始化的范围 |
| 实际验证的假设 | 重新分配训练注意力是否更有效 |
实验解读(本文分析):Blind Cliffwalk图2使用同一份回放库,只有一条非零奖励经验,报告10次初始化的中位更新次数及min/max范围。因此它验证重读顺序的效率,不能证明更快探索到第一份成功。原文明确TD误差只是代理;Atari结果还涉及维护优先数据结构的额外成本。
Blind Cliffwalk检验的是重读而非首次发现
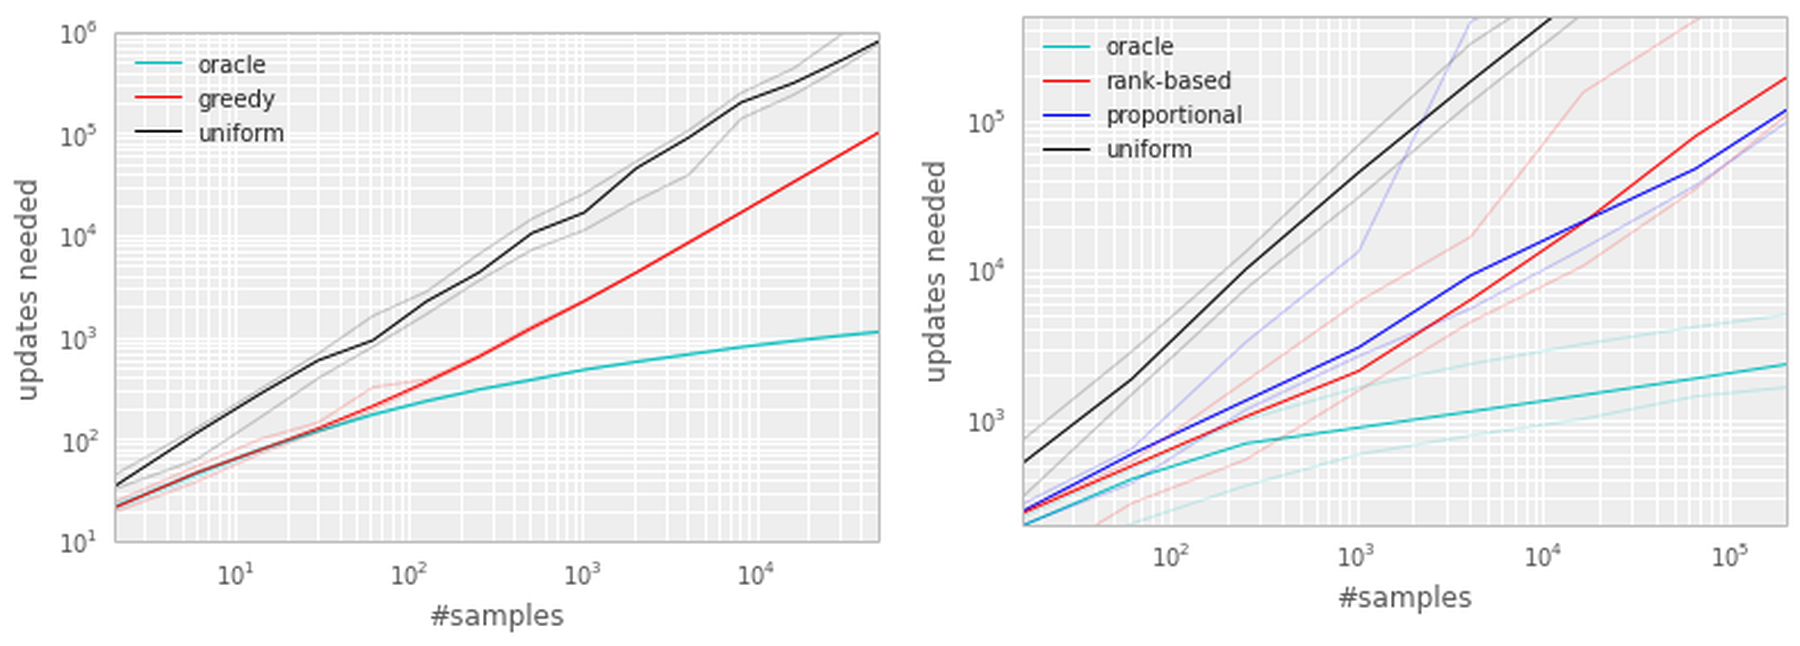
两边都是双对数坐标,纵轴越低表示所需更新越少,曲线垂直差距对应倍数而非固定次数。左图是表格与贪心优先,右图是线性逼近与随机优先,不能把左右红线当成同一个配置。青色oracle利用事后知识作参照,不是可直接部署的探索算法;淡线为多次初始化的极值范围,不是标准误。
图2的横轴是Blind Cliffwalk转移总数、纵轴是学会价值所需更新数,且只有一个成功转移;这隔离了稀有经验如何传播,未声称重新收集到更多成功。图3按游戏比较Double DQN加优先回放的归一化分差,左右方向分别代表提升和下降。图4的速度汇总使用截至当前的最好分数口径,因此步数效率仍要与树结构维护时间及最终检查点结果区分。 查看原文。
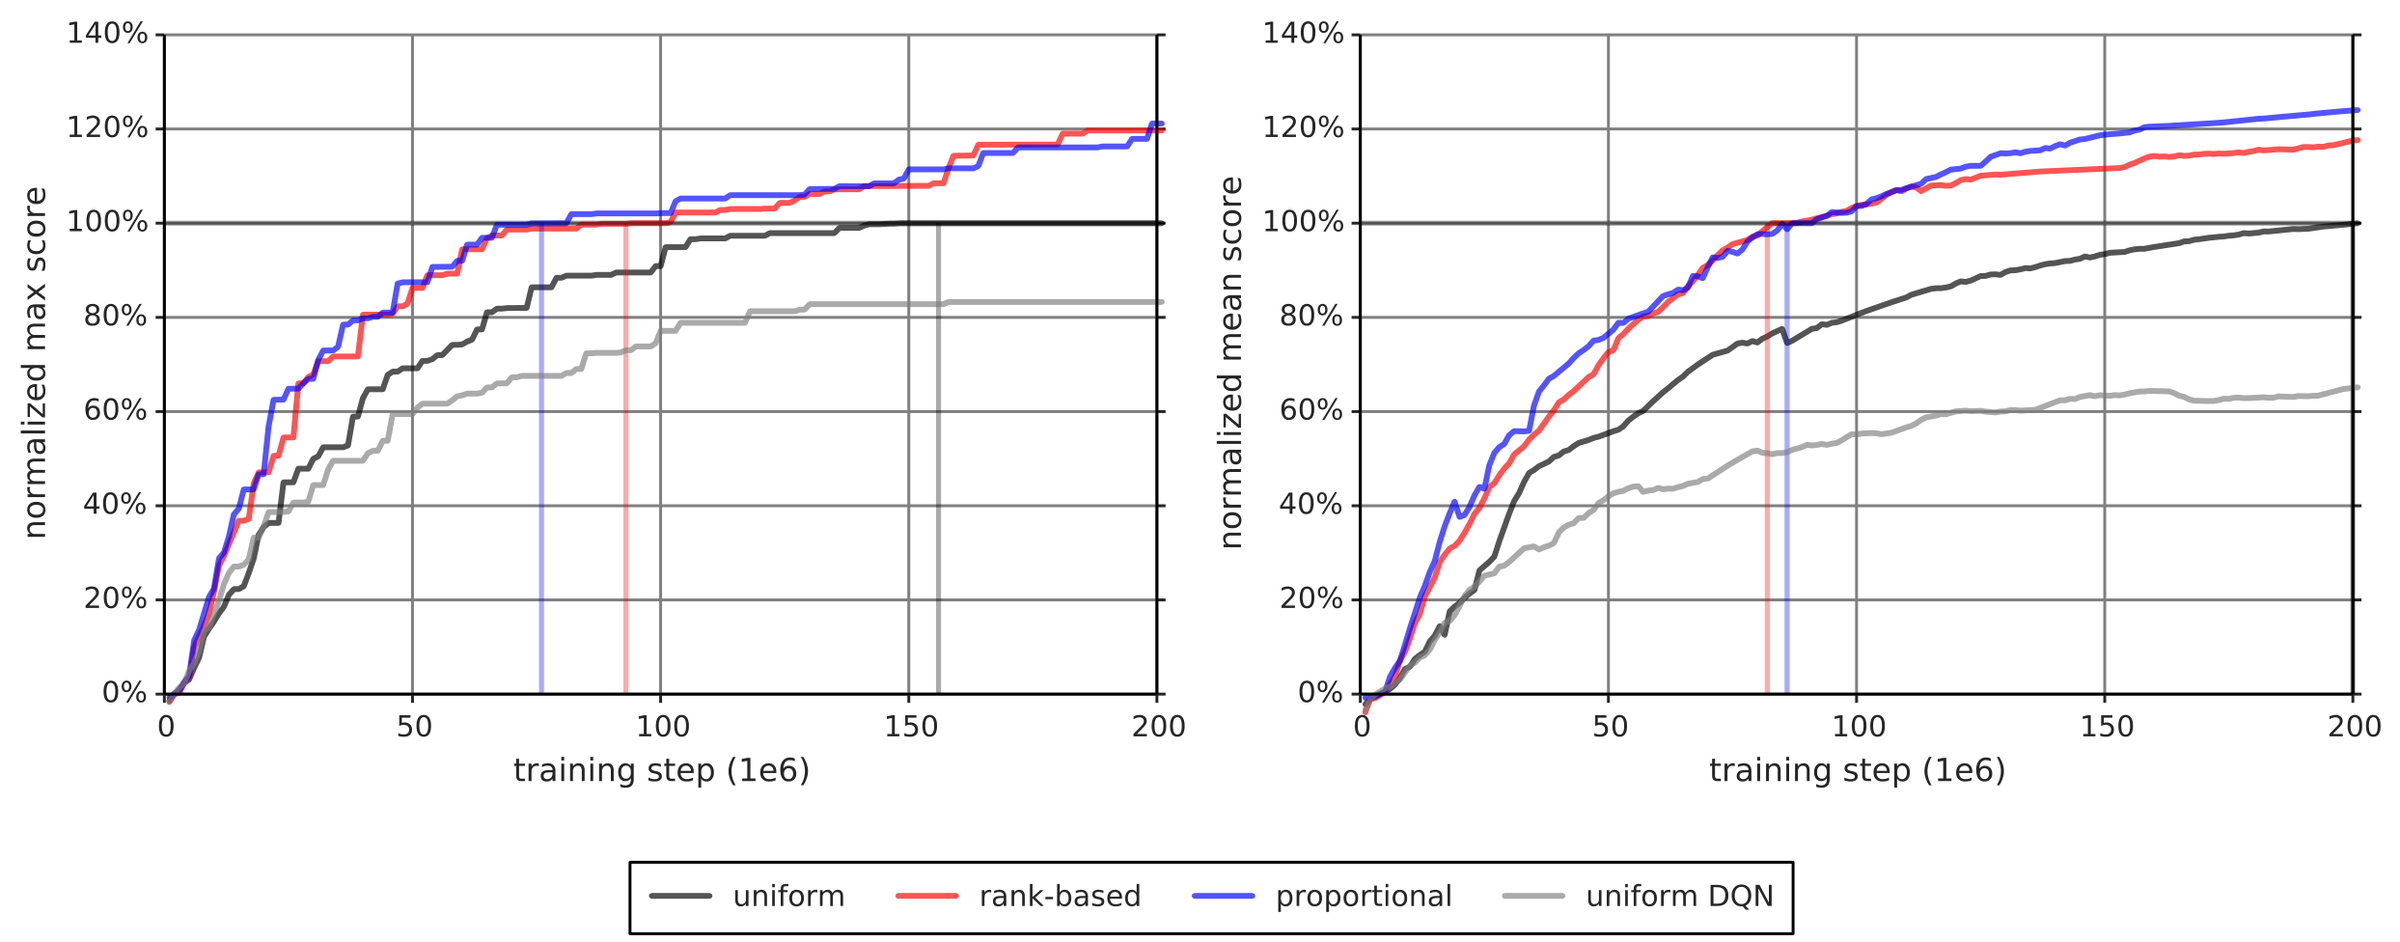
左图汇总训练中达到的最佳成绩,右图汇总平均成绩;100%对应各自Double DQN基线口径。两图到达100%的步数不同,比较提速时先说明采用峰值还是累计表现。
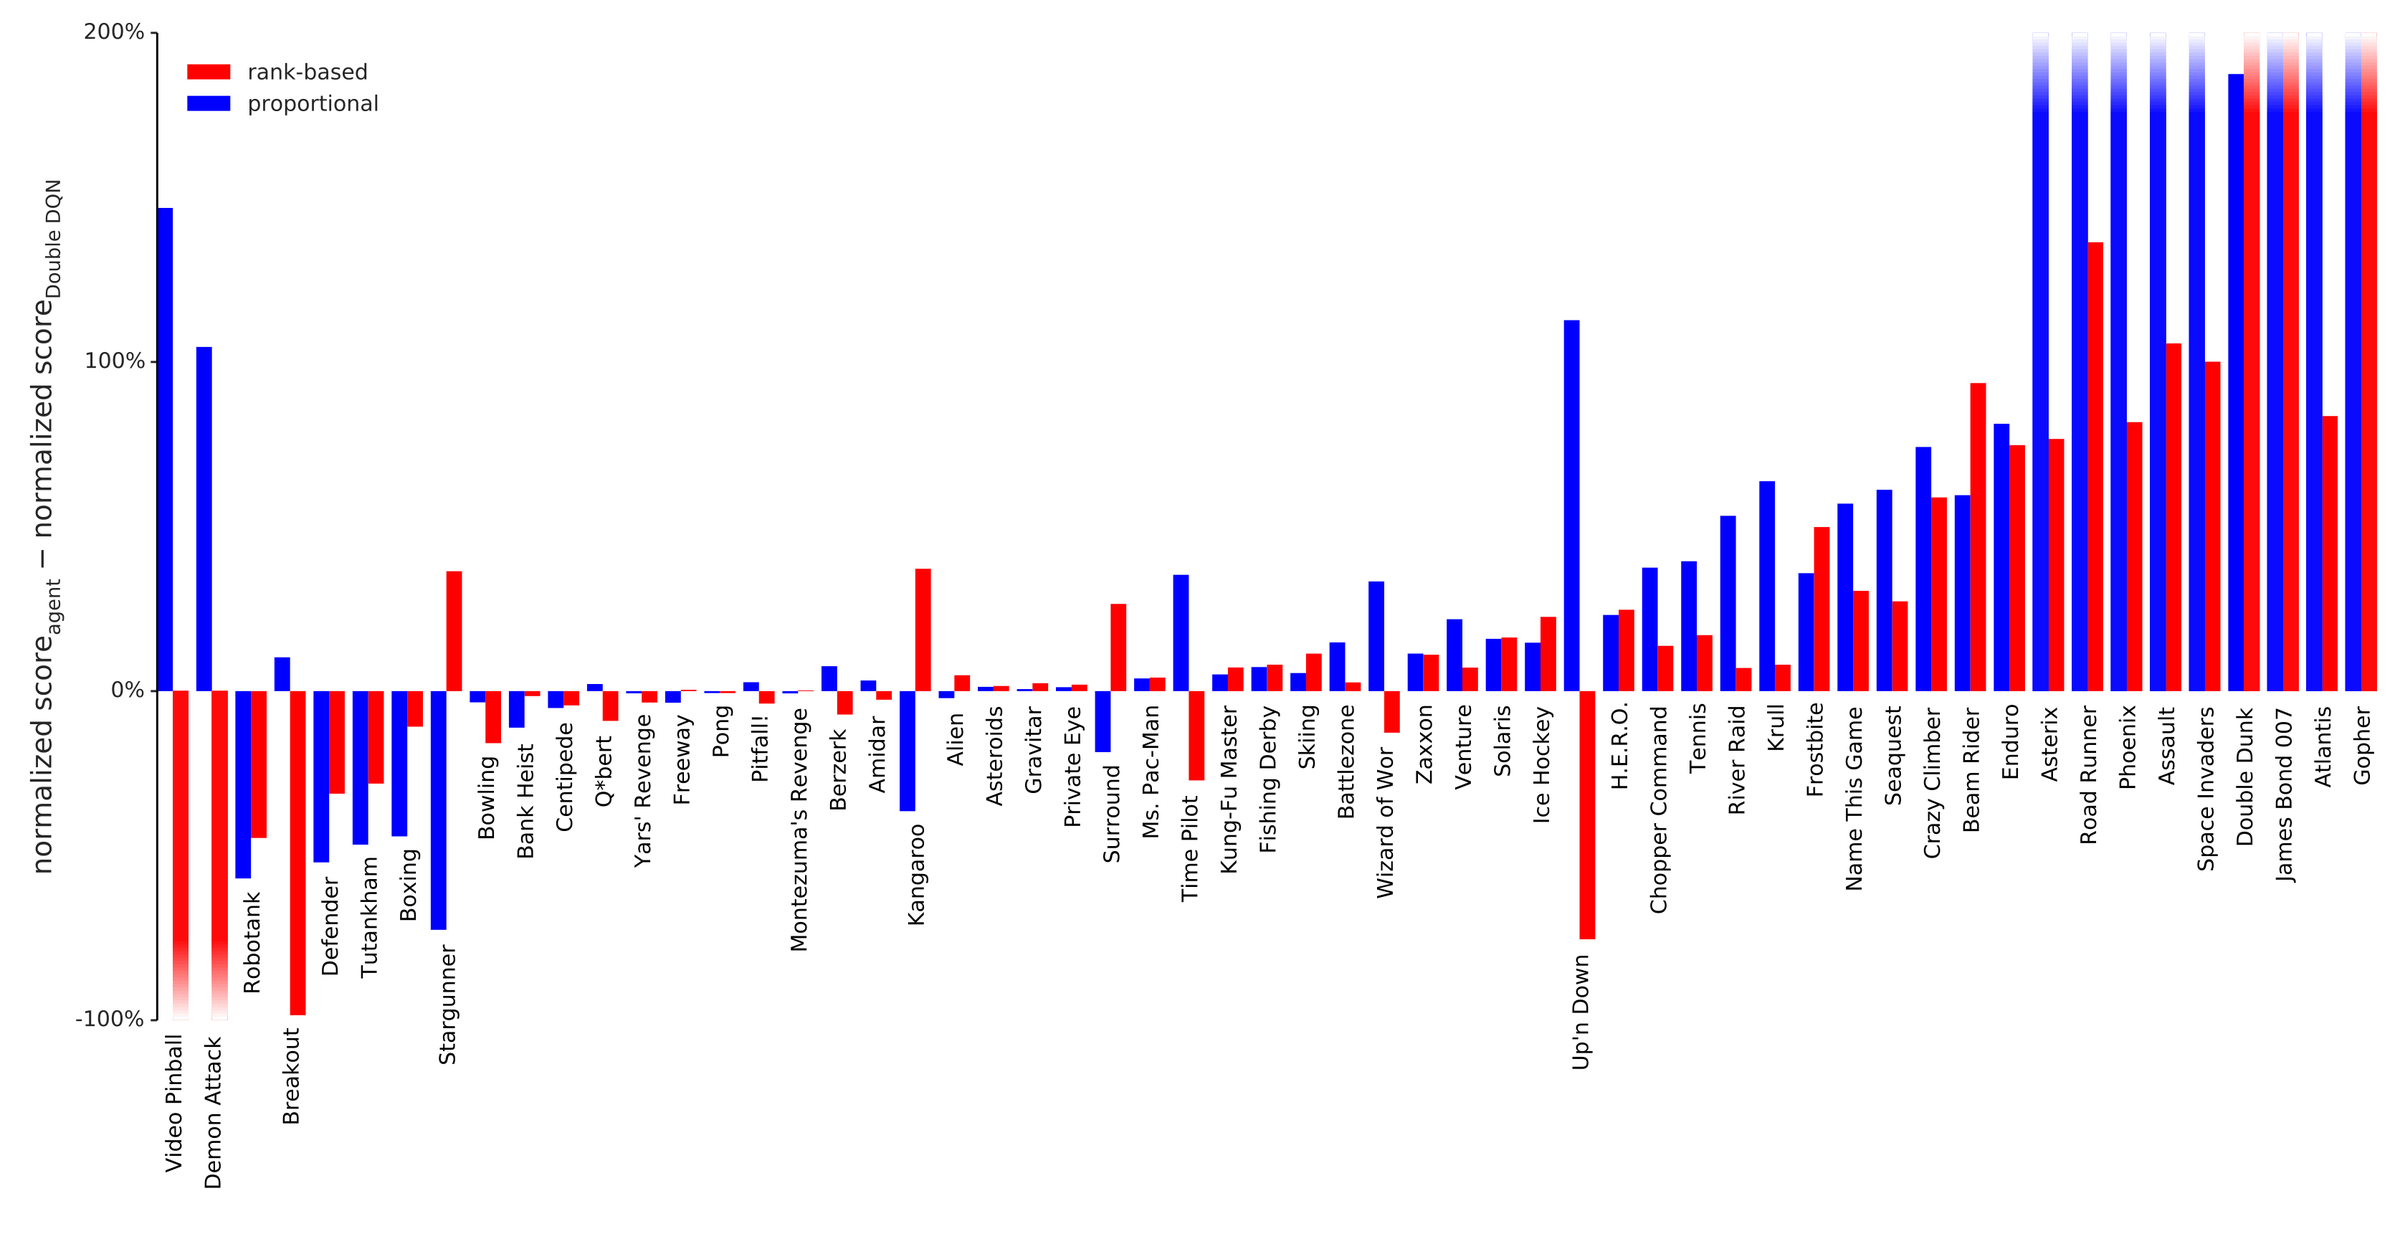
纵轴是相对Double DQN的归一化分数差,零线以下的游戏仍会退步。红蓝表示两种优先级方案,不能只统计正柱或将两者平均后声称逐游戏一致改善。
五、辨认大残差、陈旧优先级与未知经验
TD误差是更新价值的代理,可能把随机奖励噪声排得很高,也可能长期忽略以后才变重要的经验。维护优先级和重要性权重有存储与计算代价;它重新安排已有证据,不能生成尚未访问的关键行为。
六、继续追问:概率版本、噪声与更新预算
1. 高噪声转移会否长期霸占训练?
会有这种风险。TD 误差既含可学习误差,也含不可约奖励或转移噪声;重复采样噪声点未必降低其优先级。可对比秩优先、优先级上限、均匀混合和基于学习进展的调度,记录单条经验被采样份额与真实收益。降低噪声点权重同样可能丢掉罕见重要事件,因此应以受控噪声消融而非一刀切阈值判断。
2. β=1是否在所有实现下完全消除偏差?
在给定有限回放池、按已知概率独立采样且使用精确 权重时, 可恢复均匀池目标的期望更新。批内最大权重归一化、裁剪、无放回采样或非线性优化器会改变这一结论、尺度或从期望梯度到参数更新的对应关系。优先级陈旧本身不破坏上述相消,前提是权重分母与实际抽样概率一致;若二者取自不同版本,修正才会失配。即使池内校正正确,也不修复离策略状态分布、函数逼近和自举偏差。
3. 额外采样维护时间怎样计入效率?
除环境步数外,单列优先级计算、树结构更新/检索、CPU到GPU传输、锁竞争与存储开销,再报告端到端墙钟和总更新次数。若优先回放用较少更新达到同分数,应检验节省的训练时间是否超过维护开销。不同硬件上树查询与网络推理比例不同,因此只能在明确实现和预算下声称效率更高。
七、把抽样频率与目标重标记分别组合
目标重标记模块组合:HER。HER改变一条经验按哪个目标解释,PER改变抽到它的频率,两项需要各自核对偏差。
组合系统检验:Rainbow。当训练对象变成回报分布,优先级的误差度量也随之变化,不能机械复制标量TD优先级。
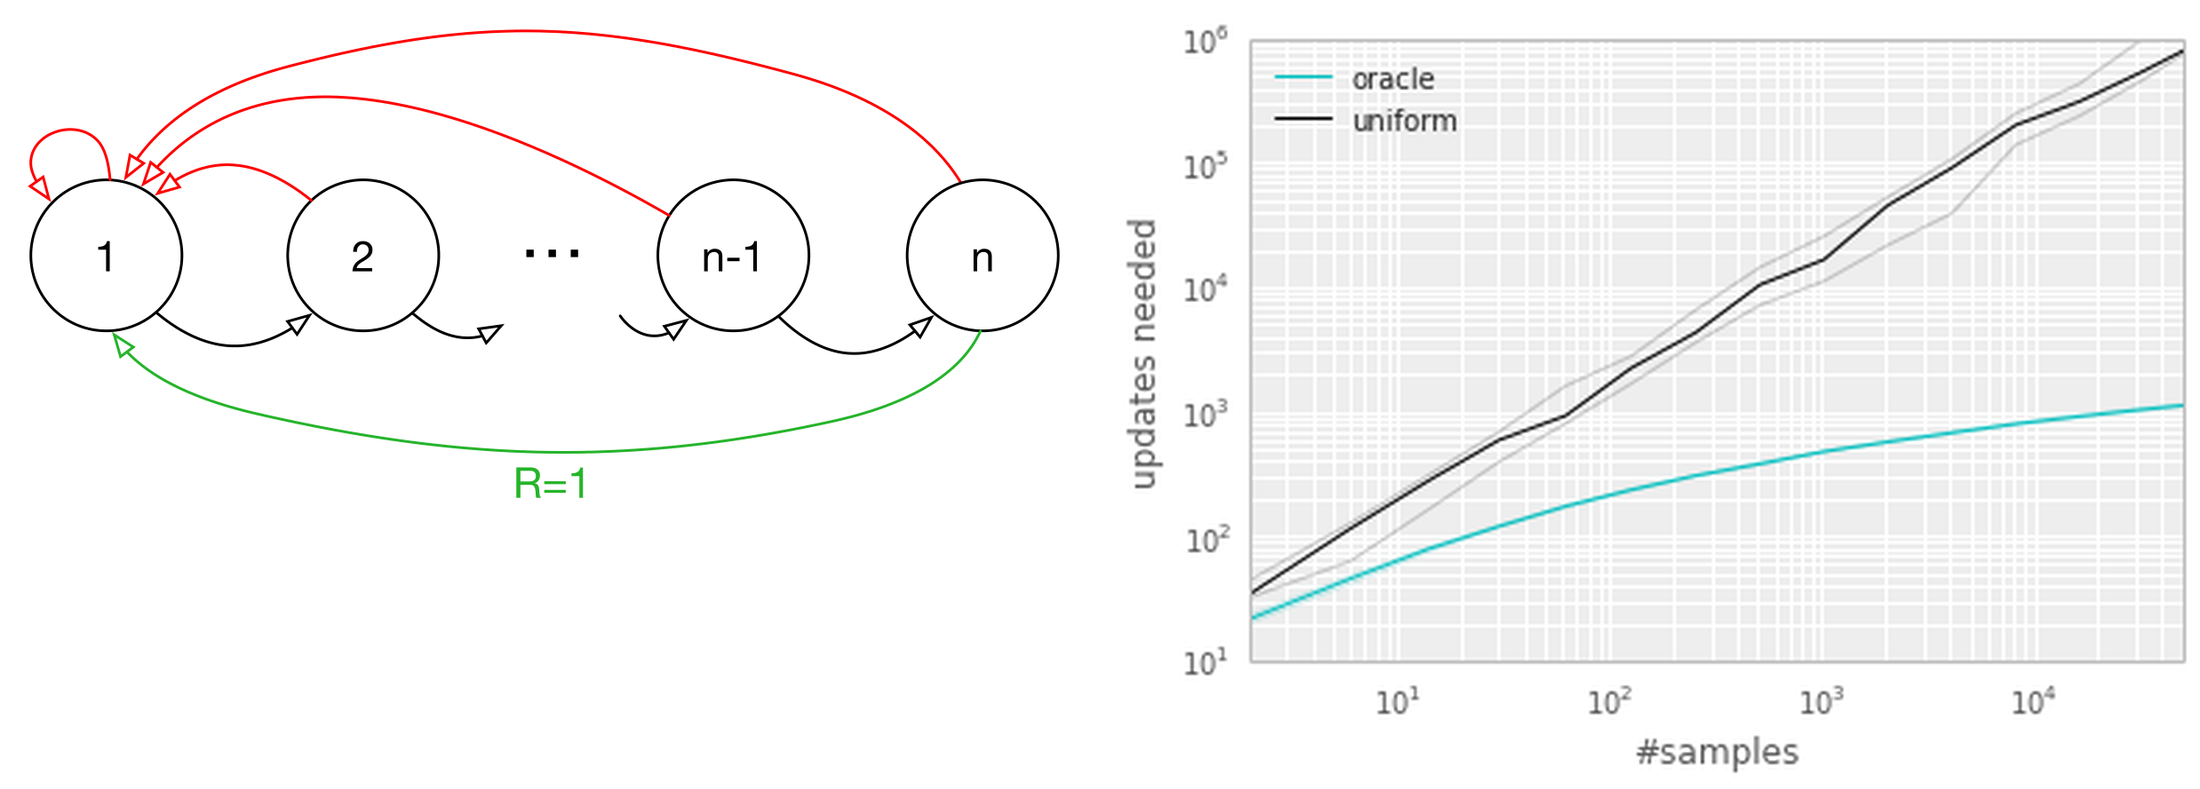
左侧链必须连续选对才能得到末端奖励,右侧在双对数轴比较均匀回放与知道有用样本的oracle。oracle是一种潜力上界对照,不能当成优先级方法实际已实现的速度。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么优先学习 TD 误差大的样本?
参考答案:大误差表示当前估值与目标存在较大分歧,这次更新可能产生更多学习进展。但它只是启发式指标:误差也可能来自不可预测噪声,因此需要让其他样本仍有机会被采到,避免训练被少数异常经验占据。
问题 2:重要性权重修正了什么,没有修正什么?
参考答案:它修正相对于目标回放分布的非均匀抽样。常见权重与 成正比;适当条件下 β=1 对应完整抽样修正。它并不自动修复错误 TD 目标,也不是对所有 off-policy 偏差的统一修正。