第 29 天|Rainbow:六种DQN改进叠加后,哪些真的重要
原论文与版本:Rainbow: Combining Improvements in Deep Reinforcement Learning,2017。原论文。
先接住前作的问题
Double DQN改目标选择,PER改抽样,Dueling改表示,C51改学习对象。Rainbow把这些模块与多步回报、参数噪声组合,追问兼容性与条件贡献。这里是真实模块组合关系,不能把组合效果当作六篇收益的简单求和。
五个前置概念
- 多步目标:使用多次真实奖励再自举。
- Noisy Nets:通过可学习参数噪声探索。
- 组合消融:在完整方案中移除组件。
- 交互作用:一个模块的效果依赖另一个模块。
- 曲线面积:汇总整个训练过程而非终点。
一、问题设定:六个单独有效的改进,放在一起还各自有效吗
所有组件最终都要作用于同一批经验和同一个训练目标。多步尾部需要怎样折扣,选择动作应看哪个分布,优先级又按什么误差更新,这些接口若不一致,系统即使列齐六个名称也不是原算法。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | off-policy、离散视觉价值学习的组合算法 |
| 状态/观测 | Atari叠帧 |
| 动作 | 带参数噪声的动作价值策略 |
| 奖励或学习信号 | 裁剪训练奖励 |
| 终止/边界 | 多步回报遇终止应截断 |
二、沿一条更新数据流连接六个改进
Rainbow的研究问题是兼容性:六个改进单独有效,组合后是否仍有效?双估计管动作选择,优先回放管抽样,多步回报管传播跨度,dueling管表示,分布价值管目标,参数噪声管探索。它们修改同一数据流的不同位置,但并不完全独立。
一次更新先抽一段带优先权重的经验,构造n步奖励与末端折扣,用在线分布均值选动作,再取目标网络分布、投影回固定支持,计算分布损失。优先级可由这个损失更新;不能一边说分布算法,一边原封不动用标量误差解释所有实现。
“移除一个模块掉分”测量的是它在其余五个存在时的条件贡献,不是六份独立收益可相加。模块之间可能替代:固定分布支持造成的截断低估,就可能减弱Double Q防高估的可见作用。
把多步回报与末端分布一起投影
用在线分布期望选a*、目标分布评价,训练分布交叉熵并乘PER权重;具体终止掩码按多步有效长度。
发生提前终止时,多步长度也要缩短
若设n步目标却在第k步真正终止,,累计奖励只到该终点,尾部bootstrap为零。不能继续读入重置后另一回合的奖励,再套原来的 ;组合模块首先要共享轨迹边界。
验算尾部必须使用平方折扣
以下是可手算的教学构造,不是论文实验。
两步奖励(1,2),γ=0.9,末端分布在0和2各0.5。先累积奖励,再把末端支持变为,随后做C51投影。
若误用γ而非γ²,尾部将变4.6。若仍用一步奖励1,就不再是多步Rainbow。模块组合要求接口一致,不能只罗列六个名称。
三、从优先片段构造多步分布目标
建立带Noisy层与Dueling结构的分布Q网络
用带噪网络与环境交互
将n步转移加入优先replay
按优先级采样并计算重要性权重
在线网络按期望选择下一动作
目标网络提供该动作的回报分布
形成n步分布目标并投影
加权交叉熵更新;按实现更新优先级
定期复制目标参数
输出:组合价值策略
实现要点:贡献有交互,不能把单独提升相加。
四、用逐项移除解释组件的条件贡献
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 57款Atari |
| 数据来源与规模 | 在线replay |
| 对比基线 | DQN、六相关基线、逐项移除版本 |
| 训练预算与资源 | 图1报告7M帧达到DQN最好表现,44M帧超所比较基线;不是墙钟 |
| 指标及其含义 | 中位人类归一化分数、曲线面积 |
| 随机性与不确定性 | 完整训练种子本文未核实;部分基线引自各自论文 |
| 实际验证的假设 | 组件在完整系统中是否互补 |
实验解读(本文分析):图3是逐项去除模块的中位分数曲线,图4则按学习曲线面积看逐游戏影响。优先回放和多步移除损失较明显;dueling和Double Q的聚合影响有限且因游戏不同。作者提出支持范围截断可能抵消部分高估,这是解释假说而非已独立证明的机制。
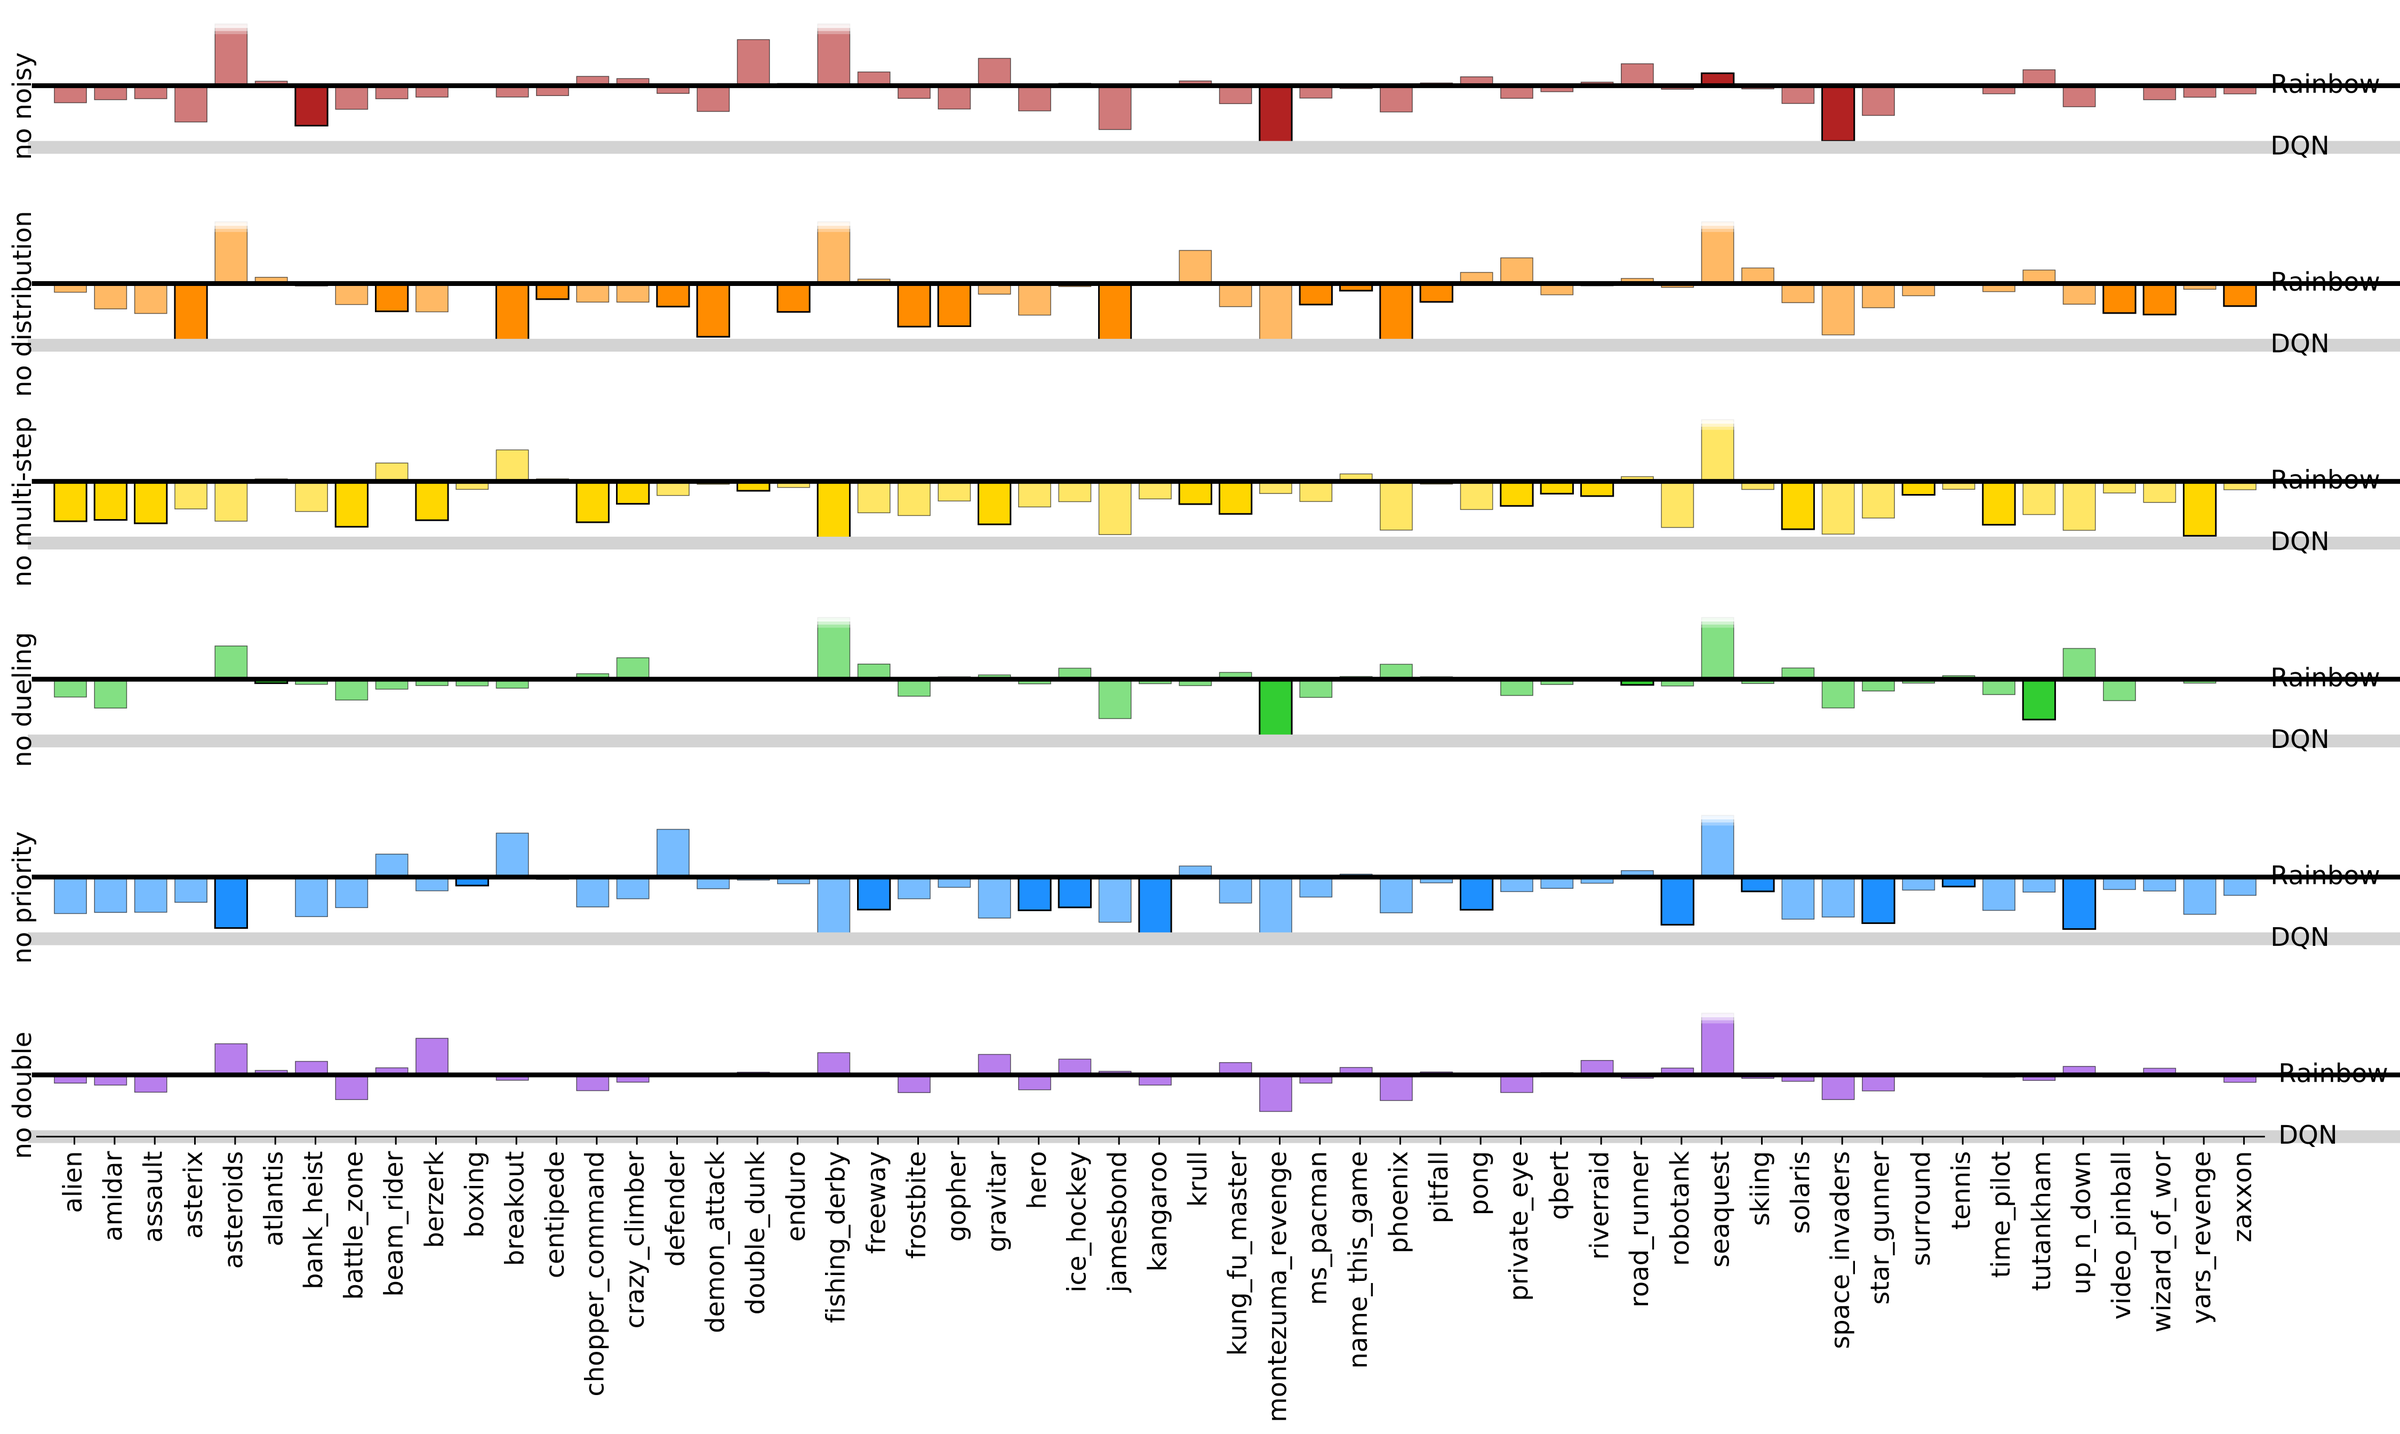
六排逐一移除组件,纵轴表示相对Rainbow与DQN的学习曲线面积变化。少数正柱与多数负柱并存,贡献随游戏而变;原图省略了DQN优于Rainbow的两款游戏,应保留这一边界。
同时读中位分数和逐游戏曲线面积
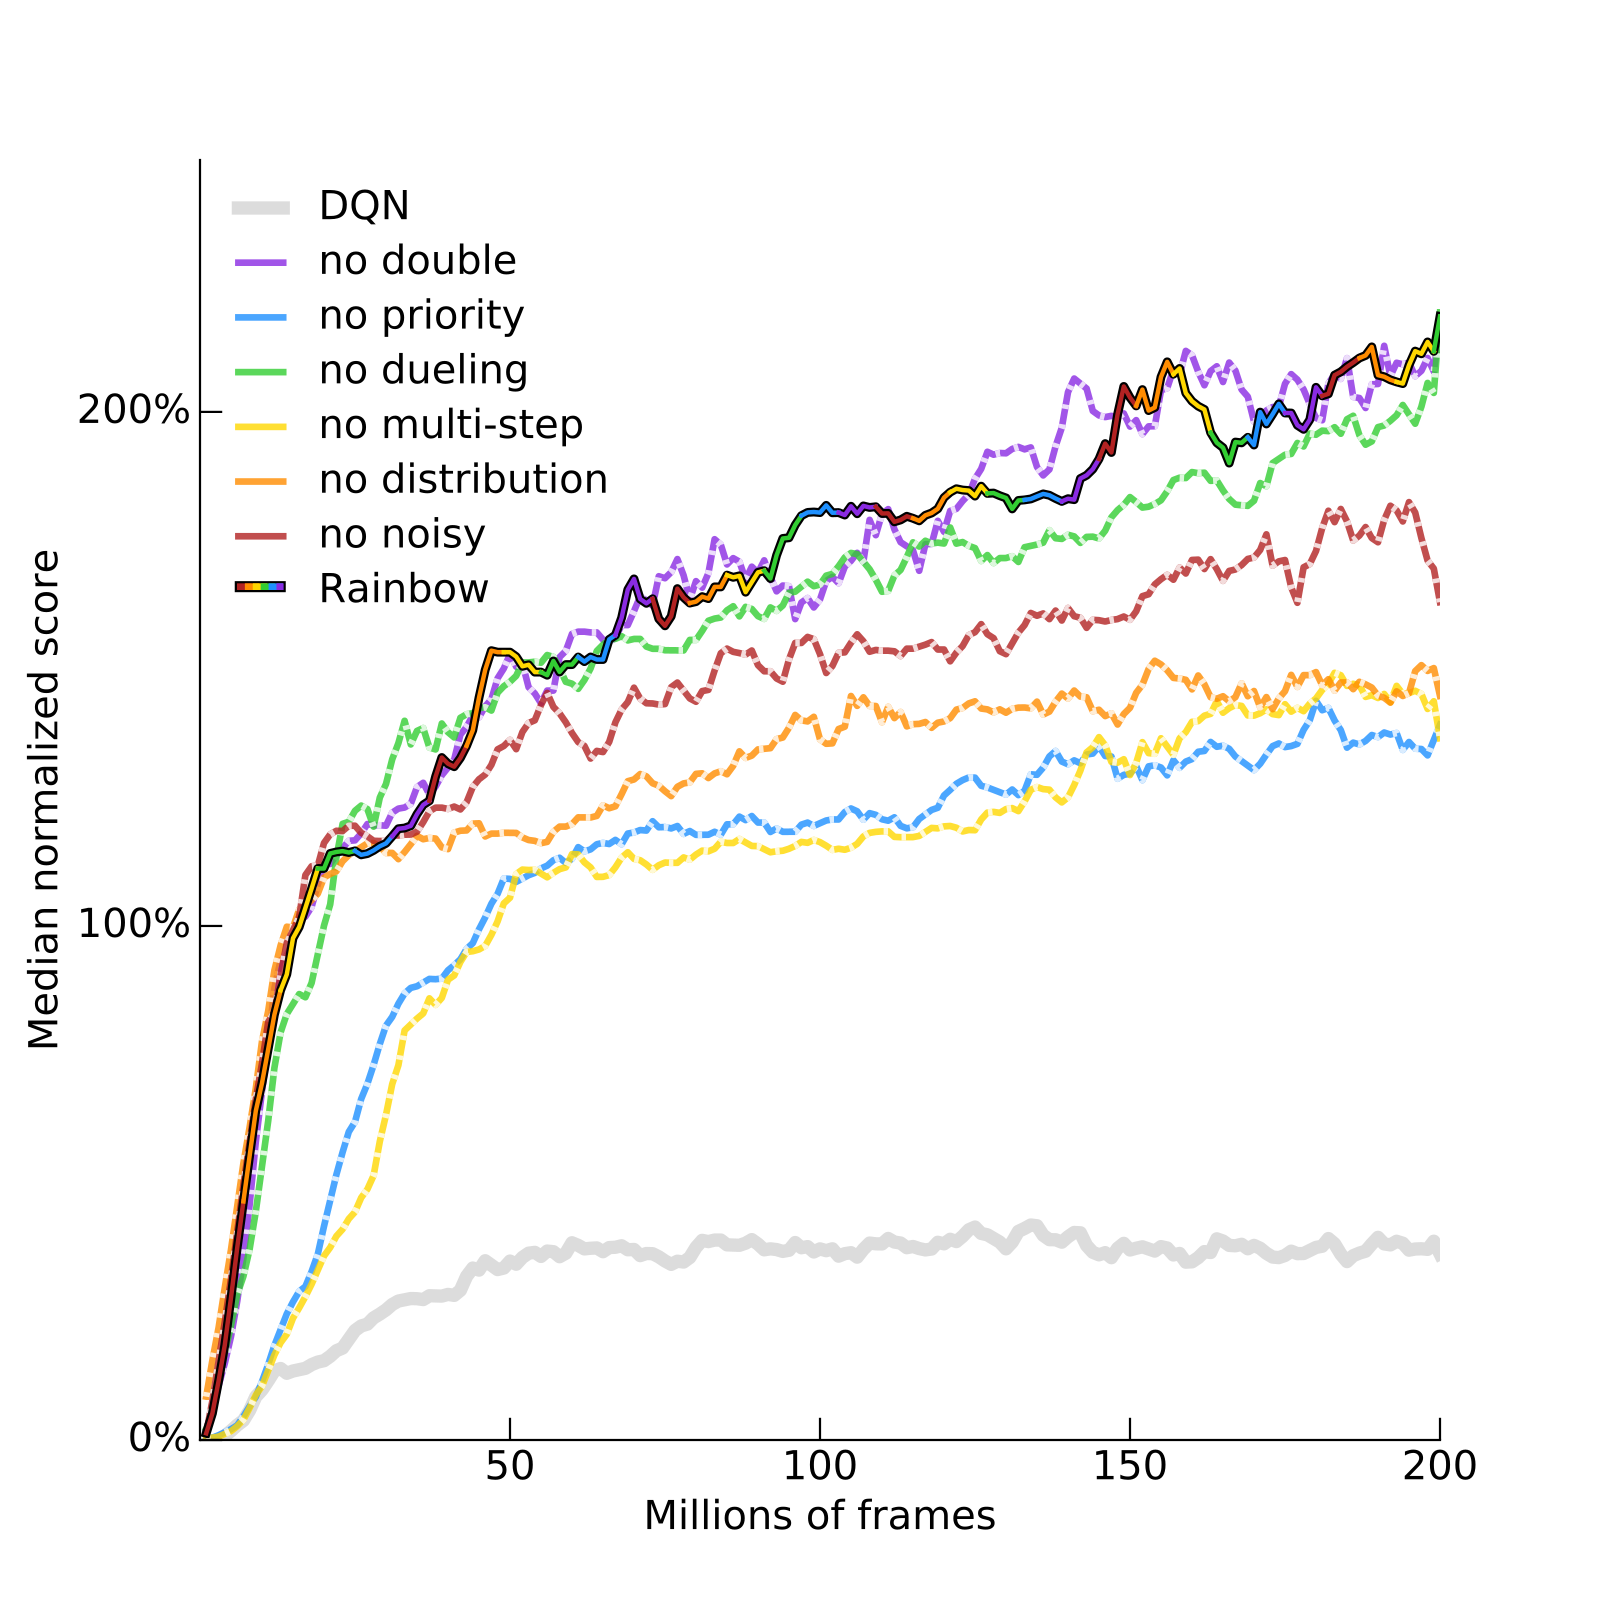
彩虹色实线是完整组合,虚线每次只删一个组件;横轴是百万游戏帧,纵轴是57游戏的人类归一化中位数,越高越好。100%是归一化的人类参照,不能读成100%任务成功率。先在同一帧预算下比较完整方法与某条虚线,再去逐游戏图检查差异;图注说明曲线作移动平均,这份平滑不表示跨种子置信区间。
图1是57游戏人类归一化中位数随训练帧数的整体比较,不能代替逐游戏失败检查。图3在完整组合上逐项移除组件,所测是其他组件存在时的边际作用;图4按学习曲线面积比较每游戏退化,并省略两个DQN优于Rainbow的游戏,阅读覆盖范围必须保留这一点。表2又采用最佳快照汇总,因此组件贡献不能相加,最佳值也不能当固定最终模型表现。 查看原文。
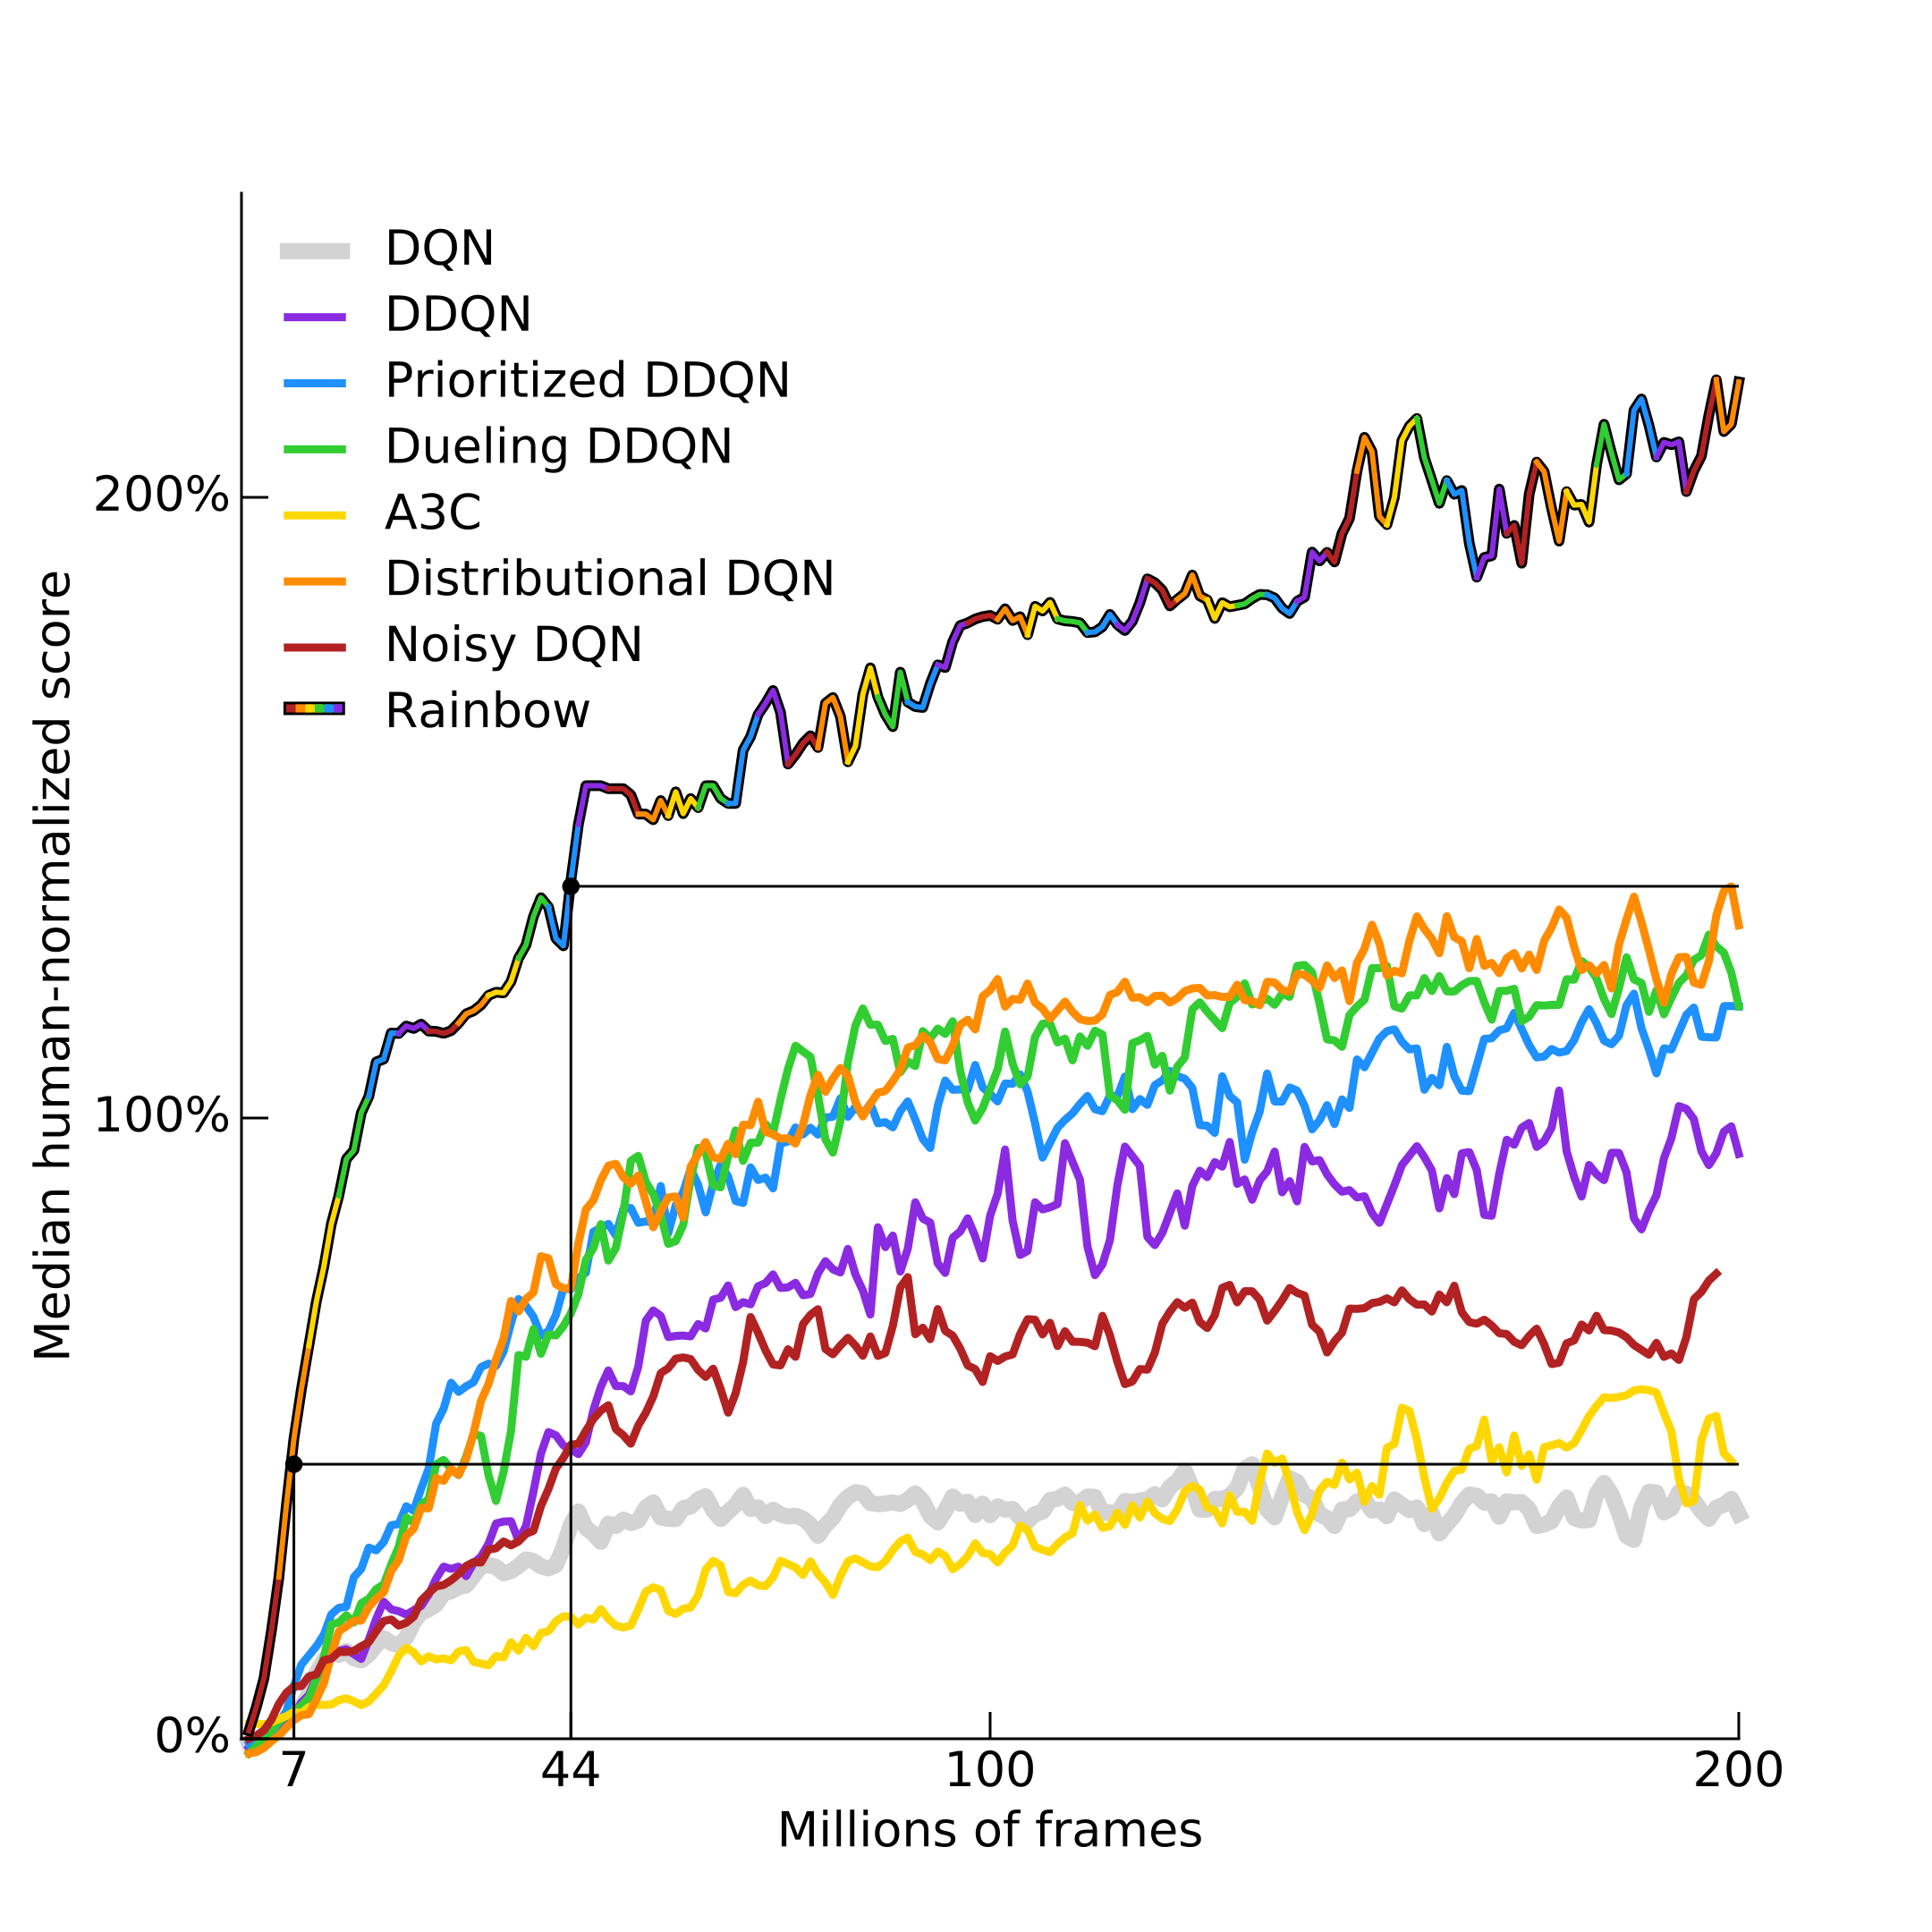
彩色Rainbow曲线汇总57款游戏的人类归一化中位数,横轴是百万帧。7M与44M标记回答达到已有基线水平要用多少数据,不能解读成每个游戏都已超过人类。
五、识别替代作用而不把增益相加
57项Atari的逐项移除测量模块在其他组件存在时的贡献。删除一项后最优超参数也可能变化,因此未重调参的消融不是普遍必要性证明;模块越多,故障定位与复现成本也越高。
六、继续追问:消融、交互与预算
1. 移除组件后是否应重新调参?
若问题是“这个已调好的系统移除组件会怎样”,固定其他超参数的消融合理;若问题是“无该组件的最佳可达表现”,就应给每个变体相同调参预算。两者回答不同因果问题,最好同时报告。重新调参也须用独立验证协议,避免把某变体较多搜索机会误当算法收益。
2. 六项中哪些改变数学对象,哪些只改训练机制?
分布式价值把标量 Q 扩展为回报分布;多步回报改变自举目标的跨度,Double Q 改变目标中选动作与估值的配合。Dueling 主要改变表示结构,优先回放改变样本抽取与校正,Noisy Nets 改变参数化探索。它们都可能影响实际优化分布,分类不是互不作用;组合实验应检查接口,如多步目标与分布投影、优先级与损失的关系。
3. 用最终检查点而非最佳快照,结论是否保持?
不能仅从最佳快照表推断。挑选最大评测值带来选择乐观偏差,且曲线波动越大、检查次数越多,偏差通常越大。应事先固定最终检查点或末段平均窗口,对所有方法重算同一汇总,并保留逐游戏与种子结果。若作者只提供最佳快照,结论应限定该协议,不能未经重算宣布最终策略排名不变。
七、回到具体接口定位组合失败
目标接口回看:C51。支撑裁剪会改变末端分布,可能影响其他去偏模块的可见收益。
抽样接口回看:PER。分布损失与重要性权重共同决定更新量,应先核对实际优先级定义。
选择接口回看:Double DQN。在线分布均值选动作、目标分布评分,仍需保留选择与评价的顺序。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么六项改进的收益不能直接相加?
参考答案:它们会改变彼此面对的数据与误差。例如优先回放依据 TD 误差选样本,而多步目标和分布式学习又会改变误差结构。组件可能互补,也可能替代某些作用,组合收益取决于相互作用。
问题 2:移除一个组件后性能下降,能否说明它单独也有效?
参考答案:只能说明在这个完整系统和实验配置中,移除它会损失性能。它单独加入基础算法是否有效、是否依赖其他组件、效果是否来自超参数匹配,都需要额外实验。消融结论应绑定具体上下文。