第 23 天|GAIL:模仿专家的行为分布,而不只复制单步动作
原论文与版本:Generative Adversarial Imitation Learning,2016。原论文。
先接住前作的问题
GPS借助局部轨迹优化提供好样本,但模仿并不总有可用动力学模型。只在专家状态上做动作监督,策略偏离后又会进入没见过的区域。GAIL改为用交互匹配长期状态动作占用,并把TRPO作为优化模块;它是与GPS并行的模仿路线,不是从A3C并行训练推导出来的算法。
五个前置概念
- 行为克隆:监督拟合专家动作。
- 占用分布:策略访问状态动作的长期频率。
- 判别器:区分专家与学习者样本。
- 逆强化学习:从行为推断目标或奖励。
- 分布偏移:部署状态不同于示范状态。
一、问题设定:模仿逐步动作之外,怎样匹配长期到达的状态
专家示范包含在哪里行动以及怎样行动。行为克隆直接学后者,却可能因早期小偏差改变后续状态。GAIL希望让学习者整段访问分布都接近专家,判别器据此提供可用于策略优化的代价;它不要求恢复唯一的真实奖励。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 基于专家示范的模仿学习,训练通常在线交互 |
| 状态/观测 | 环境状态 |
| 动作 | 策略动作 |
| 奖励或学习信号 | 判别器生成训练信号,评价可用真实任务回报 |
| 终止/边界 | 与原任务一致 |
二、从占用分布密度比构造对抗模仿目标
行为克隆在专家访问过的状态上预测动作,部署走偏后却可能进入训练集没有的状态。GAIL把目标转为匹配折扣状态动作占用分布:不仅某一步像专家,还要让长期访问位置与动作组合像专家。
固定策略后,判别器的最优输出对应两种占用密度的比例;把它代回对抗目标会得到分布散度形式。这给模仿一个整体目标,却不恢复唯一“真实奖励”。同一种行为可以由许多奖励解释。
策略不能像普通GAN生成器那样穿过未知环境直接反传。原文用判别器给出的代价驱动TRPO,再收新轨迹更新判别器。若D定义为学习者概率,策略奖励为−logD;换成专家概率时必须同步换损失,不能混用网上相反的标号。
由判别器最优解推到占用分布联系
设D为“来自学习者”概率:。策略等价使用奖励 。换成D表示专家概率时,公式需相应对调。
可把“占用密度比”亲手推出来:对某个 ,令 、,固定策略后判别器最大化 。其导数为
这里假设两侧采用相同总质量/采样权重,且 ;两侧都无覆盖的位置没有约束。代回后才得到原文§5的占用分布散度联系。实际有限容量判别器未必达到这个最优式,熵正则也会影响策略折中,故“判别器接近二选一随机猜”仍要配合任务评估判断。
判别器接近二分之一只是一项条件现象
在相同总质量且最优判别器的理想条件下,意味着该位置两类占用相等;有限容量D输出1/2也可能只是分不出来。要区分这两种情况,需要独立验证占用或任务表现。
验算两类占用为何产生不同奖励
以下是可手算的教学构造,不是论文实验。
两类状态动作位置,专家占用(0.8,0.2),学习者占用(0.2,0.8)。等量采样下最优“学习者概率”D=(0.2,0.8),奖励−logD约为(1.609,0.223),促使策略增加第一类访问。
等占用时D=0.5并不表示任务失败,而表示判别器已无法区别。反过来,一个只记住有限专家样本的D也可能误导策略,所以判别准确率不是最终模仿质量指标。
三、固定判别器标签约定并交替采样训练
输入:专家状态动作集 E、可交互环境
初始化策略π与判别器D
循环:
  用π采集完整轨迹
  D最大化 mean_learner logD + mean_expert log(1-D)
  对学习者轨迹设置奖励 r=-logD(s,a)
  用该奖励估计回报与优势
  按TRPO等原文优化策略以混淆D
输出:模仿策略;不必显式恢复真实奖励
实现要点:仍需环境交互,判别器奖励可能被利用。
四、同时计算专家示范与环境交互预算
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 原文模拟控制任务 |
| 数据来源与规模 | 有限专家轨迹+持续在线学习者轨迹 |
| 对比基线 | 行为克隆、相关逆RL/模仿方法 |
| 训练预算与资源 | 专家轨迹数与环境采样需分开;完整预算本文未核实 |
| 指标及其含义 | 任务回报和不同示范量下的表现 |
| 随机性与不确定性 | 全部随机重复本文未核实 |
| 实际验证的假设 | 匹配占用分布能否优于仅匹配专家动作 |
实验解读(本文分析):图1专家归一化分数要与专家示范条数一起看。FEM、GTAL和GAIL获得相同环境交互预算,但行为克隆无需交互。Reacher上行为克隆反而更省专家数据,原文也承认GAIL的环境交互量并不小。因此“样本高效”必须明确是专家样本还是环境步。
将专家归一化分数与示范条数一起读
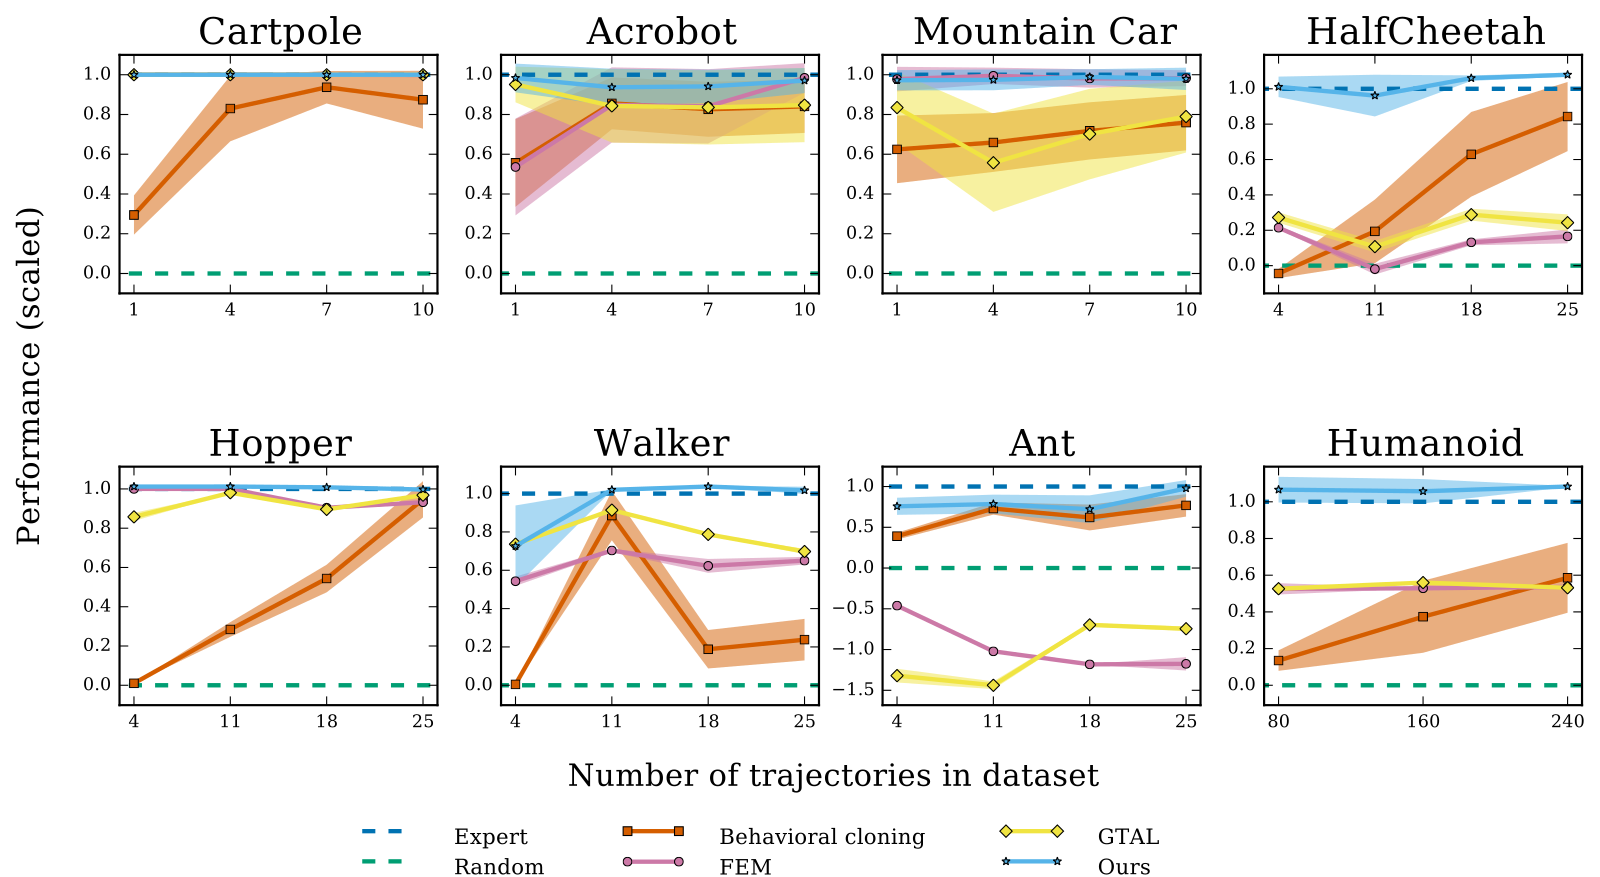
横轴增加的是专家轨迹条数,纵轴是按随机策略0、专家1缩放的任务表现,较高较好;超过1只表示在这套评估中超过专家基准。星标蓝线是GAIL,方形橙线是行为克隆,专家/随机用虚线。各面板的示范预算范围不同,Humanoid与简单控制不能按相同横坐标位置直接比较;这张(a)图也没有展示正文提到的(b)熵正则消融。
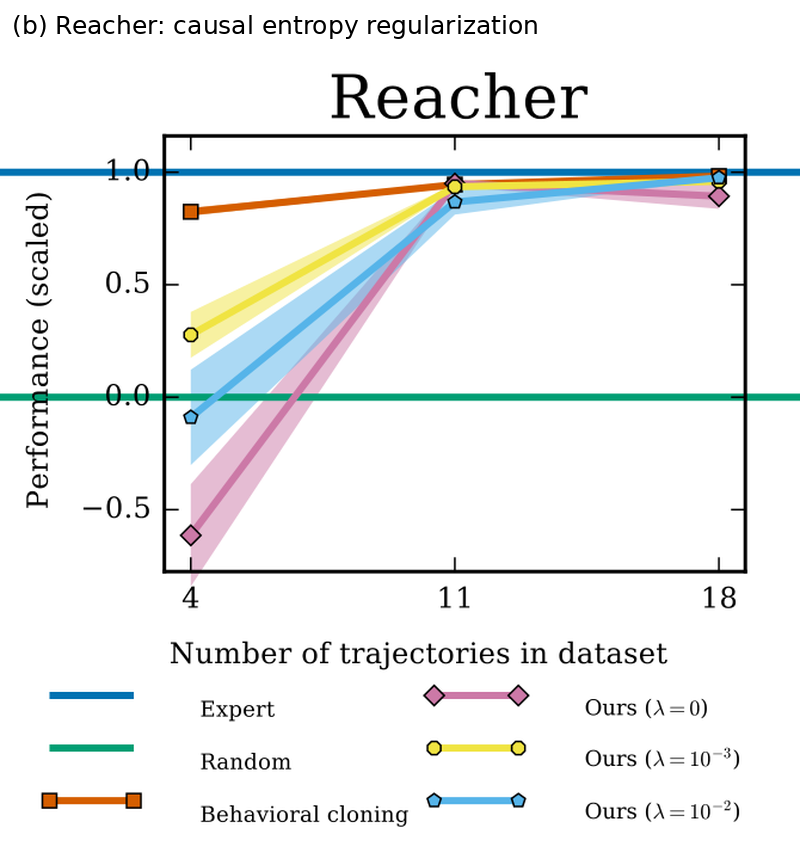
补齐的(b)仅改变Reacher上的因果熵正则系数,横轴仍是专家轨迹数。少量示范时不同正则强度差距大,轨迹增加后都接近专家水平;行为克隆在这个任务的少数据区间表现很强,不能从(a)的总体印象抹掉这一例外。
占用分布推导把对抗模仿解释为匹配专家状态动作分布,但不识别唯一真实奖励。算法1必须反复从当前策略收集环境轨迹,再更新判别器和策略;因此它不是只用离线示范的行为克隆。图1(a)纵轴将专家表现缩放为1、随机策略为0,以示范量变化比较模仿效果,(b)检验熵正则;阅读这张图还要把策略交互量纳入成本。 查看原文。
五、判别准确率不能代表模仿成功
专家覆盖不完整时,判别器可能记住无关特征,奖励也可能被策略利用。训练分布匹配不保证新环境目标一致;判别损失接近平衡可能来自能力太弱,仍需独立任务评估。GAIL节省专家示范的结果也不能免去环境交互成本。
继续追问:奖励等价、覆盖与交互成本
1. 判别器无法区分是否一定代表策略学对?
不一定。理想无限容量判别器、充分数据和收敛的对抗优化下,不可区分支持占用分布匹配;实际判别器可能容量不足、优化失败,或只观察了忽略关键行为的特征。应在独立轨迹上训练更强审计判别器,并测真实任务收益、约束违规和长时状态覆盖。训练判别器准确率约50%既可能是成功,也可能是判别器失效。
2. 专家有多种风格时该匹配什么?
若目标是整体模仿,可以匹配专家混合占用分布,但无条件随机策略可能把不兼容风格混在同一回合。需要保持一致风格时,应加入可解释条件或潜变量,在风格内匹配并检查每种风格覆盖。仅学动作均值会在多峰连续动作中产生不存在于示范的危险动作;评价要分风格、分状态,而不能只报一个总体判别损失。
3. 如何把在线采样成本纳入与行为克隆的比较?
把专家示范量与策略在线环境交互分别列出,并计入判别器和策略交替训练的计算。行为克隆通常无需额外交互,GAIL 的优势可能部分来自大量在线修正分布偏移。可在同示范量下报告收益-交互曲线,再在同总墙钟或同机器人试验预算下比较;示范更少不自动等于总数据成本更低。
六、继续比较引导样本和占用匹配
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:没有人工奖励,GAIL 如何知道策略应该往哪里改?
参考答案:判别器比较专家与当前策略产生的状态—动作样本,提供区分信号;策略通过强化学习让自己的行为更难与专家区分。目标是匹配长期占用分布,而不仅是在专家访问过的状态上预测单步动作。
问题 2:为什么 GAIL 仍不能保证学到“专家真正想完成的任务”?
参考答案:行为相似不等于意图相同。有限示范可能遗漏关键情形,判别器也可能关注无关特征。若观测无法区分重要状态,或新任务分布发生变化,模仿到的行为模式可能失效。它仍依赖示范与交互资源。