第 25 天|MADDPG:训练时看全局,执行时各自行动
原论文与版本:Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments,2017。原论文。
先接住前作的问题
DDPG让连续Actor通过Critic的动作导数学习,但把其他学习者当环境后,Critic面对的规律也在变化。MADDPG直接扩展这条路线:训练时以联合信息和动作作为条件,执行时Actor仍只看本地观测。它不是A3C的多环境worker,因为这里多个主体会互相改变同一个环境的结果。
五个前置概念
- 非平稳性:其他策略更新改变数据规律。
- 集中训练:学习时可使用联合信息。
- 分散执行:部署时各自凭可用信息决策。
- 联合动作:所有智能体动作的组合。
- 信用分配:把共同结果归因到参与者行为。
一、问题设定:队友策略变化以后,本地相同动作为何有不同后果
同样是向右推,队友同时推或拉会产生不同结果。独立Critic若只看自己的输入,就把这些不同条件混成噪声。集中训练允许评价器利用更多条件,但这种训练权限不能悄悄变成部署时Actor能读取全局信息。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 多智能体、集中训练分散执行、连续策略梯度 |
| 状态/观测 | Actor用局部o_i;Critic用联合信息x |
| 动作 | 每个智能体a_i,联合为a_1…a_N |
| 奖励或学习信号 | 可合作共享或各自不同奖励r_i |
| 终止/边界 | 联合任务终止 |
二、让集中Critic解释联合动作条件
独立学习者眼中的环境在变化:相同本地观测和动作,队友或对手策略更新后会产生不同后果。MADDPG在训练期给Critic更多条件,包括联合观测信息与各智能体动作,从而把部分“环境变化”解释为可观察输入变化。
Actor仍只看自己的观测。对第i个Actor求导时,仅沿自己的动作进入集中Critic,其他智能体动作不随这次梯度联动。Critic是训练辅助,部署时无需向每个Actor提供完整全局状态,这就是集中训练、分散执行的边界。
它没有消除所有非平稳性:联合策略仍在改变、回放数据仍可能陈旧,联合输入还随人数增长。原文的策略ensemble是另一个稳健性组件,用多种对手行为训练;不能把收益全归于集中Critic,也不能把ensemble当测试时必须投票的唯一形式。
在固定其他动作时求自己的梯度
只有a_i路径对Actor i反传;别的动作应按该更新的采样与停止梯度约定处理。
在实际replay更新中,期望取联合样本 ;Actor 的导数要在 处计算,其余 按该样本固定。于是集中Critic能够回答“在这些队友/对手动作条件下,我的动作微调会怎样”。这与在本次更新里同时让所有Actor重新选动作并联合求导不同。原文式(5)与Algorithm 1给出了这处采样与代入约定;执行时仍只需要 。
集中Critic不是一个公共奖励函数
每个Agent可以有自己的 和奖励 ,集中的是条件信息而非效用目标。竞争任务中同时提高各自目标会产生互动变化,不能把联合输入误读成大家共享同一个团队回报。
用共同推箱区分缺信息与动作微调
以下是可手算的教学构造,不是论文实验。
两智能体共同推箱,单步回报为。在(0,1)处,Actor1收到梯度,应增加推力。若只看a₁而不知道队友a₂,样本(0,0)与(0,2)要求不同更新,Critic会把它们混合。
集中Critic知道a₂,并不允许Actor1执行时偷偷读取a₂。训练可用信息和部署可用信息必须分列。
三、只沿当前Actor自己的动作反传
用各Actor+探索噪声联合交互
存储联合观测、动作、各奖励与后继观测
每个智能体i:
  用所有目标Actor生成后继联合动作
  y_i←r_i+γ*(1-done)*目标Q_i(x_next,联合动作)
  更新集中Q_i
  用μ_i(o_i)替换联合动作中的a_i
  最大化Q_i更新Actor i,冻结其他Actor
  软更新目标网络
部署:每个Actor只接收自己的o_i
实现要点:集中信息和联合动作输入限制可扩展性。
四、把集中评价与策略ensemble的消融分开
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 合作通信、捕食追逐、协作导航、欺骗等粒子任务 |
| 数据来源与规模 | 联合在线replay |
| 对比基线 | 独立DDPG及原文相关基线 |
| 训练预算与资源 | 完整步数、网络和调参预算本文未逐项核实 |
| 指标及其含义 | 各智能体回报、合作/竞争任务结果 |
| 随机性与不确定性 | 全部种子与不确定性本文未核实 |
| 实际验证的假设 | 集中评价能否缓解其他策略变化 |
实验解读(本文分析):图3左比较MADDPG与独立DDPG,右才比较单策略与ensemble,不能混成单项消融。§5.4按任务使用2或3个子策略,并以双方交换角色交战评估强弱。粒子环境支持协作/竞争机制演示,但人数规模、观测权限和通信动作均限制外推。
图3左右分别检验两个不同组件
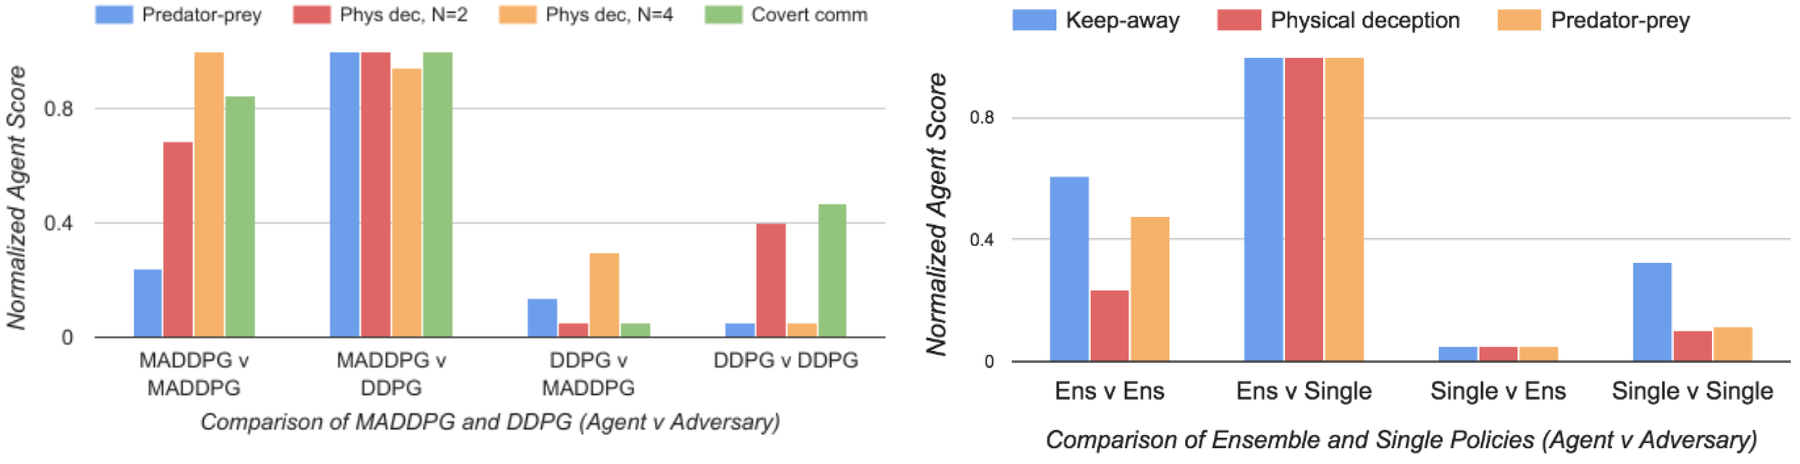
图1明确训练Critic可看集中信息,部署Actor只用自身输入;图2的任务图说明合作、竞争和混合场景不同。图3的每一组柱对应agent与adversary的特定配对,纵轴按0–1归一化,需先看谁对谁以及谁的分数,不能把竞争任务的收益合成全体改善。集中Critic和策略ensemble的作用也应分别读,联合动作输入带来的规模成本仍在。 查看原文。
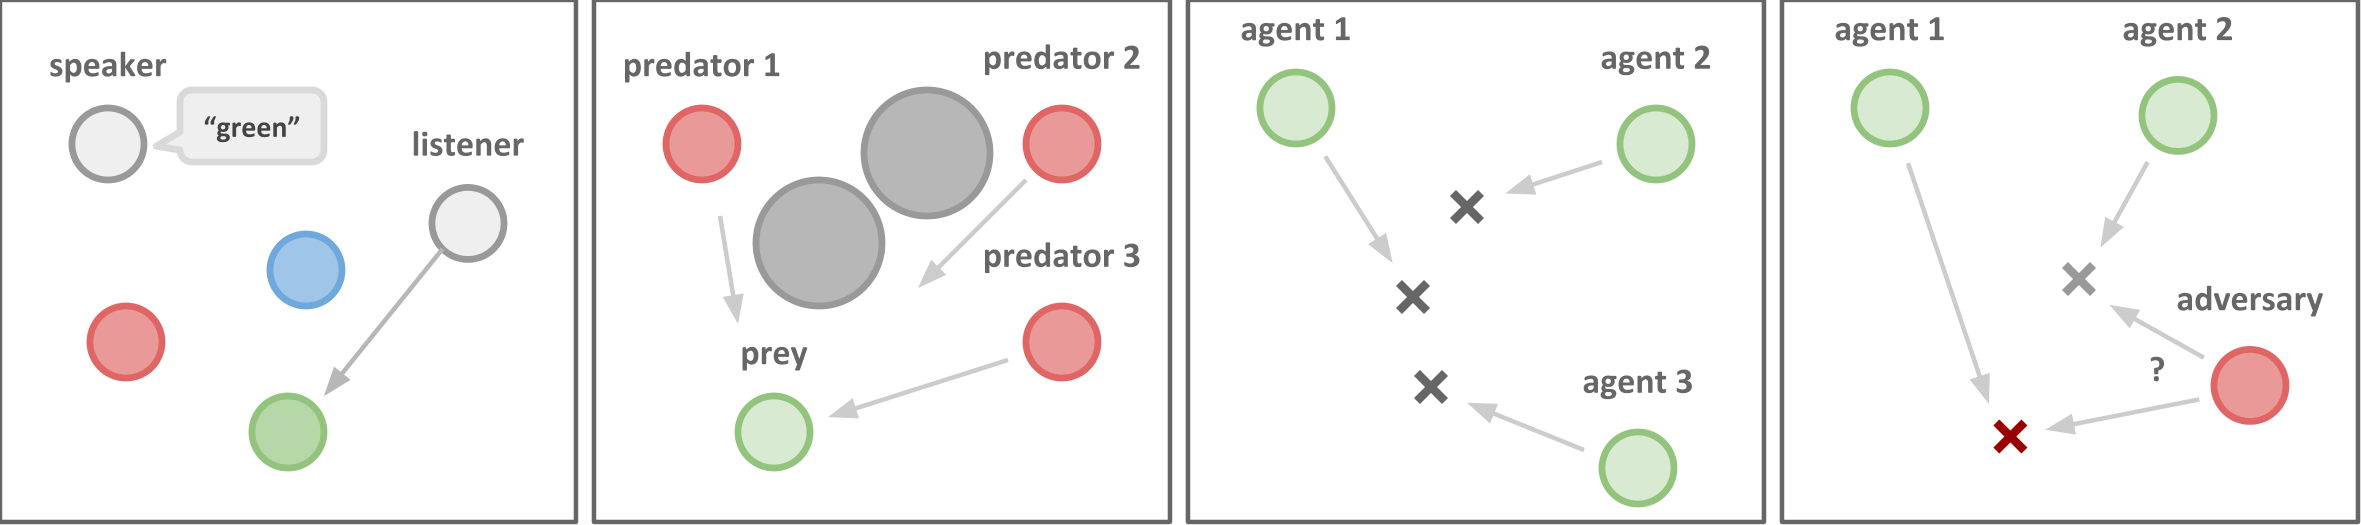
四个面板依次是协作通信、捕食者与猎物、协作导航和物理欺骗。它们的合作与竞争关系不同,后面的奖励曲线必须与具体任务匹配,不能把所有多智能体实验都称为共同团队回报。
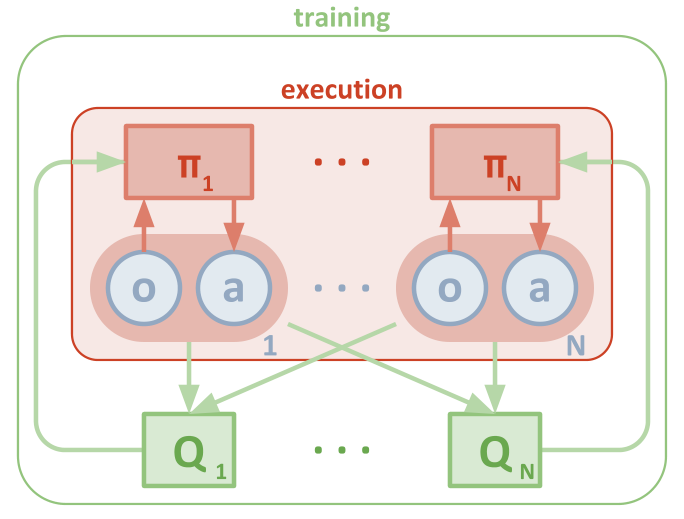
绿色训练范围让每个critic读取其他智能体的信息,橙色执行范围仍由各自观测驱动策略。集中的是训练信息,执行时不应偷偷继续读取训练才有的全局动作和观测。
五、联合条件不能完全消除非平稳性
联合输入随人数增长,旧回放和部署对手还可能偏离训练条件。合作、竞争与混合任务必须分别解释:一个智能体回报增加可能意味着另一个损失,不能统一称为整体协作提高。
六、继续追问:信息权限、人数与旧回放
1. 集中Critic使用的全局信息部署时真的不需要吗?
只有部署动作可完全由各 Actor 的本地观测或其本地历史计算,且归一化、记忆状态和动作选择不再查询全局量时,集中 Critic 才能被移除。训练允许的全局状态、其他智能体动作是额外信息权限,应明确列出。若实现把联合状态泄漏到 Actor 特征或共享预处理里,就不满足分散执行;可用屏蔽全局信息的部署测试验证。
2. 新对手策略会造成怎样的分布偏移?
环境对单个智能体而言的转移和奖励分布会随对手策略改变;原回放池和集中 Critic 可能只覆盖旧对手组合,新对手则使 Q 外推。策略集成可以增加训练多样性,但不保证覆盖任意对手。应使用未见对手池、交叉对战矩阵和适应前后表现,并区分对固定对手的利用能力与面对新策略的鲁棒性。
3. 如何评价竞争任务中谁受益?
需要分别报告每方收益、胜率和联合结果,并固定对手池与配对规则。在零和任务中一方提高必然损害另一方;在混合收益任务中“总分上升”可能掩盖某一方严重变差。可报告对战矩阵、最差对手表现及可利用性代理;自我对弈同一训练阶段的单条奖励曲线会随对手进步改变含义。
七、比较连续Actor与单调价值分解
平行CTDE路线:QMIX。合作离散动作场景还需保证局部贪心与团队价值一致;单调分解处理的是另一种执行接口。
基础机制回看:DDPG。集中Critic没有消除连续Actor利用估值误差的风险,动作梯度的可靠性仍需检查。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么多智能体训练中的环境看起来不稳定?
参考答案:一个智能体观察到的结果,取决于其他智能体的行为,而其他策略也在更新。MADDPG 的集中式 Critic 在训练时条件于更完整的观测和联合动作,减少把别人行为变化误当成不可解释环境噪声的问题。
问题 2:训练时使用全局信息,为什么不一定妨碍分散执行?
参考答案:关键是这些信息由哪个组件使用。Critic 训练时可以看全局,Actor 执行时必须只依赖实际可获得的信息。若把全局信息直接输入部署 Actor,却无法在真实执行时取得,就不满足分散执行设定。