第 34 天|QMIX:用单调混合,让局部贪心与团队价值一致
原论文与版本:QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning,2018。原论文。
先接住前作的问题
MADDPG用集中Critic训练局部Actor,说明训练信息可以多于执行信息。QMIX沿平行的集中训练、分散执行路线,改用局部效用和单调混合,让每个Agent的局部贪心能拼成所表示团队价值的贪心解。
五个前置概念
- VDN:把局部Q简单相加的分解。
- Mixer:组合局部价值的网络。
- 超网络:输出另一个网络参数的网络。
- 单调性:某输入增加时输出不下降。
- 局部历史:部分观测下用于决策的记忆。
一、问题设定:各自只看本地信息,怎样选出团队价值最大的组合
训练可以看全局状态,执行却不能枚举所有人的联合动作再集中选择。QMIX希望把团队价值分解成每个人可单独比较的效用,同时保留比简单求和更丰富的状态依赖。为了让这种局部选择一致,表示必须接受单调约束。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 合作多智能体、集中训练分散执行、值分解 |
| 状态/观测 | 局部历史给agent Q,全局状态给mixer超网络 |
| 动作 | 各单位离散动作 |
| 奖励或学习信号 | 共享团队奖励 |
| 终止/边界 | 团队胜败或任务截断 |
二、用单调混合把局部排序接成联合贪心
分散执行要求每个Agent仅凭本地历史选动作,而训练可以知道全局状态。QMIX用局部效用Q_i和状态条件混合网络表示团队Q,总价值对每个Q_i单调不减。于是逐个提高局部Q不会降低团队表示值,局部argmax组合就是该表示的全局argmax。
超网络根据全局状态生成非负混合权重,保留比简单求和VDN更多的非线性与状态依赖。但局部Q_i不是每个Agent独立奖励的严格价值,而是为联合价值分解服务的效用。执行时可以去掉mixer,不代表训练没使用全局信息。
代价是表达限制:如果一个人的最佳行动顺序会随着队友行动翻转,就可能无法用固定局部排序加单调mixer精确表示。QMIX保证的是所表示函数的贪心一致,不是真实环境总满足单调协作结构。
逐个替换局部最大值证明团队值不降
这是表示约束,不是对真实环境自动成立的事实。TD训练的是Qtot;局部Qi不必等于某个单独奖励的价值。
把单调性变成可检查的不等式:固定训练状态 和各局部历史,记 。任意联合动作的每个局部值都不超过 ;把输入逐个换成这些最大值,单调性使 每次不下降,故 。这证明的是所表示函数的联合最大值,允许并列最优;不是证明 等于真实个体贡献。下标 表示混合函数受全局状态条件化,执行时各Agent仍只用自己的历史。见原文§4及附录A。
集中状态不能绕过执行时的信息限制
mixer可随全局状态改变组合方式,但局部Agent部署时仍只按自己的历史排序动作。若相同局部历史对应两个需要相反动作的真实状态,单调混合不能凭训练时看过全局状态让Agent在执行时自动区分它们。
用协调矩阵检查不能表示的排序翻转
以下是可手算的教学构造,不是论文实验。
两人各选0或1,奖励为“动作相同得1,不同得0”。若第一个人的局部排序偏好1,则在队友选0时,真实奖励却更偏好0;若偏好0,又会在队友选1时相反。
这个简单协调矩阵说明固定局部效用排序难以精确表示全部联合值。QMIX仍可能学到一个好联合策略,但“能找到某个最优组合”和“能表示整张真Q表”不是一回事。
三、以全局状态生成权重并训练团队TD目标
各agent用局部历史选择动作并交互
将联合轨迹存入replay
抽序列以恢复循环网络状态
计算各局部Q_i(历史_i,a_i)
全局状态经超网络产生非负mixer权重
得到Q_tot
用目标网络的各局部argmax构造下一Q_tot目标
最小化团队TD损失
部署仅运行各agent网络
实现要点:单调性限制能表示的协作价值,不能覆盖所有博弈。
四、读分散评估与状态非线性的消融
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 两步矩阵博弈、六个StarCraft II战斗地图 |
| 数据来源与规模 | 联合在线轨迹 |
| 对比基线 | IQL(独立Q,非2021离线IQL)、VDN、QMIX |
| 训练预算与资源 | 完整环境步数与版本见实验节,本文未完整核实 |
| 指标及其含义 | 胜率、团队Q拟合 |
| 随机性与不确定性 | 图3、图4平均20独立运行、95%置信区间;每次评估20回合 |
| 实际验证的假设 | 更丰富的单调分解是否提高协作 |
实验解读(本文分析):§7每训练100回合,暂停做20次分散贪心评估;图3、图4平均20次独立运行并给95%置信区间。图4还拆解全局状态和非线性作用。这里的IQL基线指independent Q-learning,不能与本系列第46篇implicit Q-learning混为同一算法。
核对20次运行与独立Q-learning基线
原引用定位:原文。
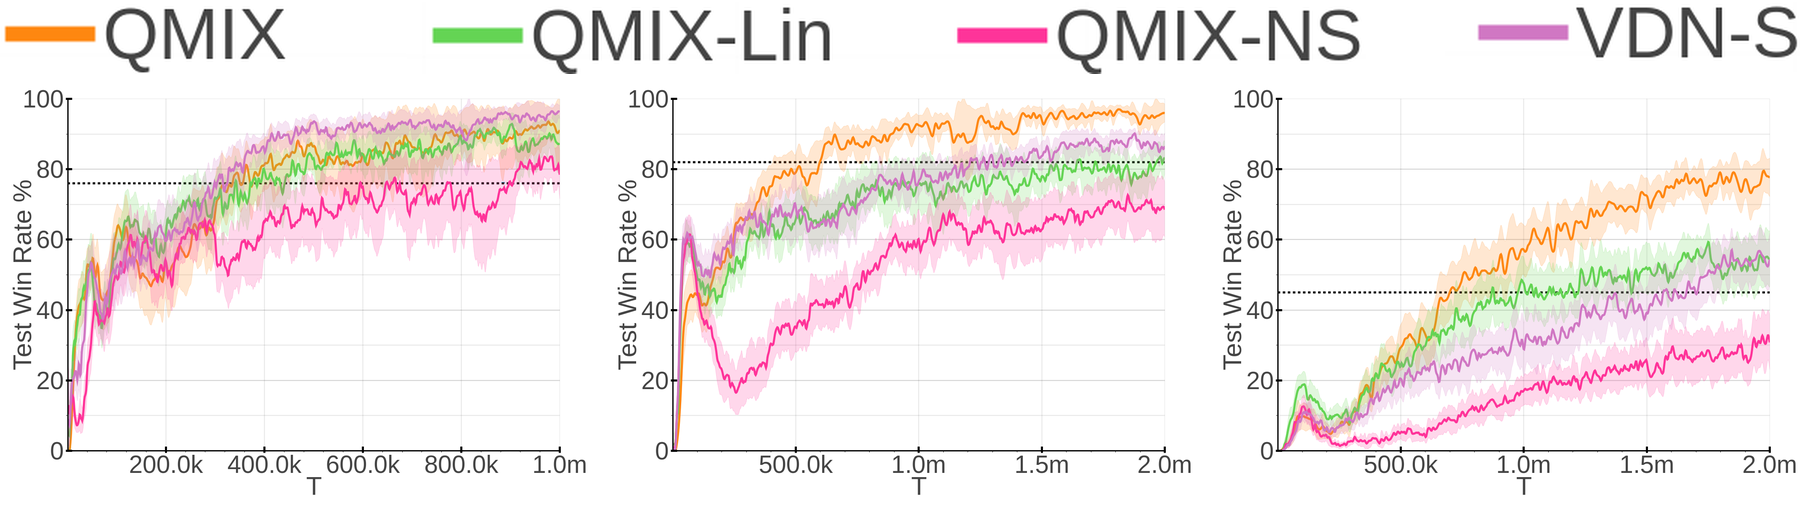
图例中的QMIX-Lin移除非线性混合能力,QMIX-NS移除混合权重对全局状态的条件依赖,VDN-S则给加和分解加入状态信息。因而应在同一地图、同一环境步数上比较这些颜色,分别问非线性和状态条件化有什么帮助;不能把所有消融统称“更小网络”。三张面板横轴上限也不同,靠右端点比较时须先核对预算。
图2中超网络为mixer生成非负相关权重,解释为何集中训练后的局部argmax可以分散执行;单调约束本身不证明真实联合价值满足该形状。两步博弈表比较的是相对VDN的表达能力,而图3在六张战斗地图看胜率,虚线为启发式基线。图4以环境步为横轴、测试胜率为纵轴,3m中几条曲线最终靠近,3s_5z中完整QMIX与移除结构的差距更明显;不能把某张地图的差距当成固定提升。消融必须与同地图对照读,环境版本和局部信息权限仍是复现条件。 查看原文。
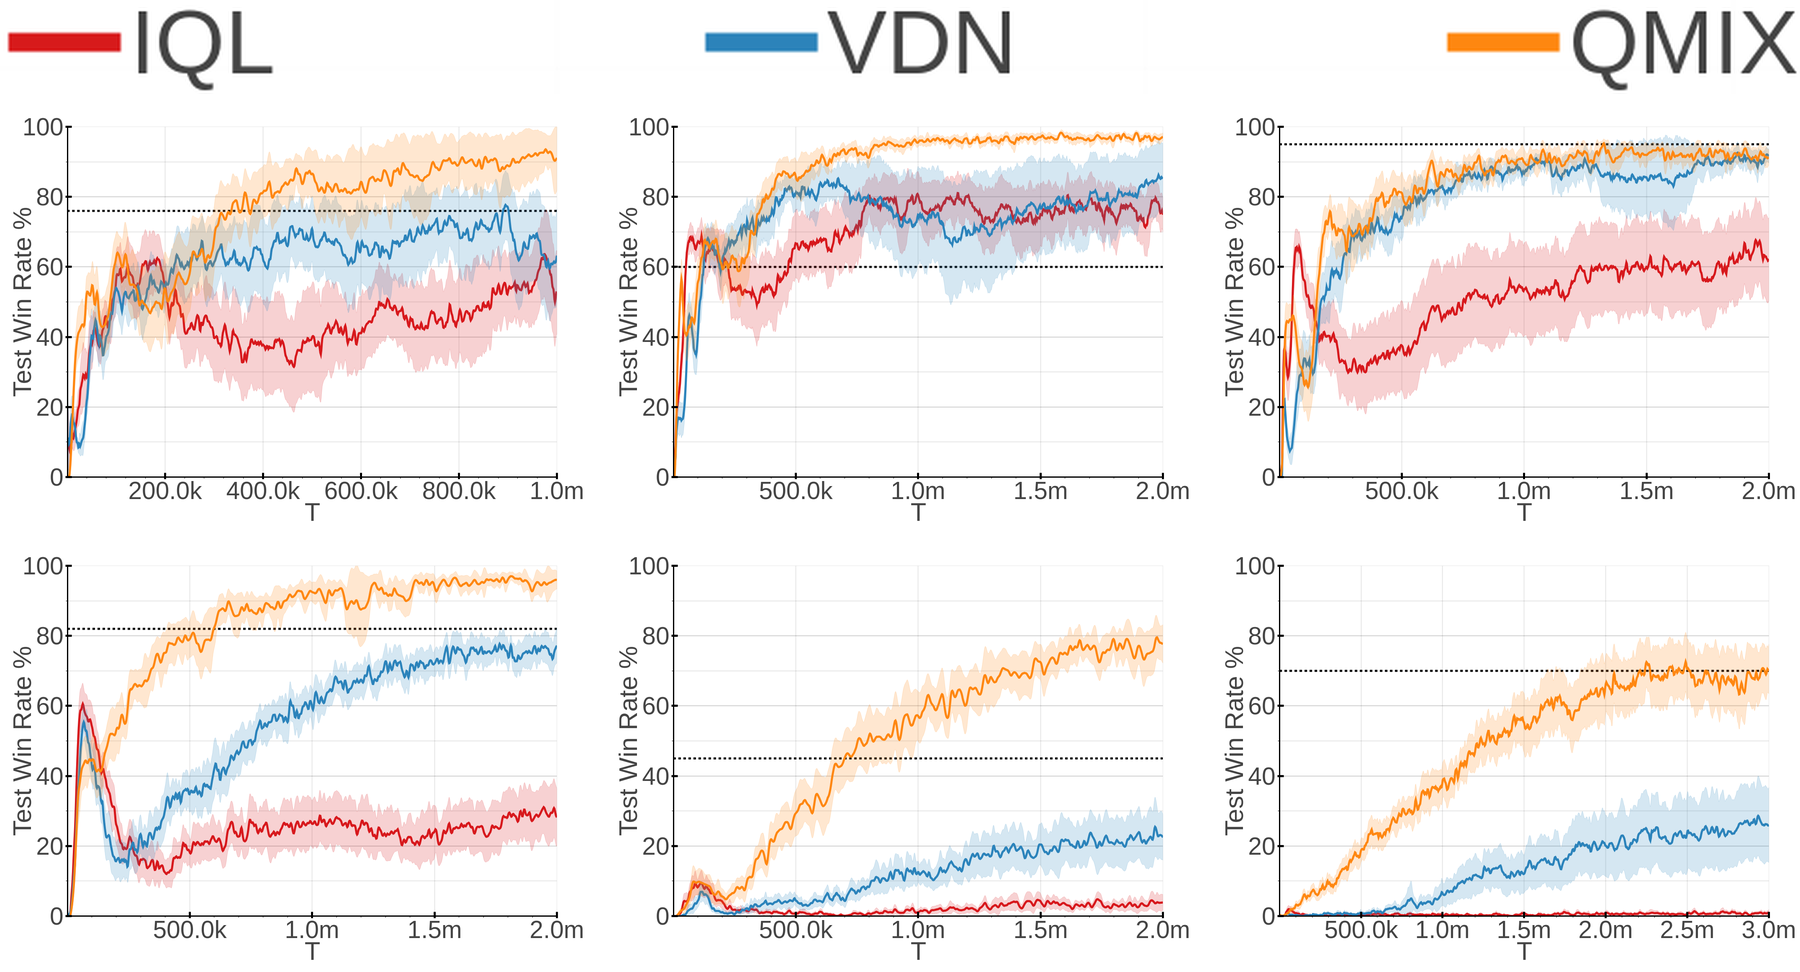
读图提示:六面板按从左到右、从上到下依次为(a)3m、(b)5m、(c)8m、(d)2s_3z、(e)3s_5z、(f)1c_3s_5z;先认地图,再比较同一环境步下的测试胜率,虚线是启发式基线。
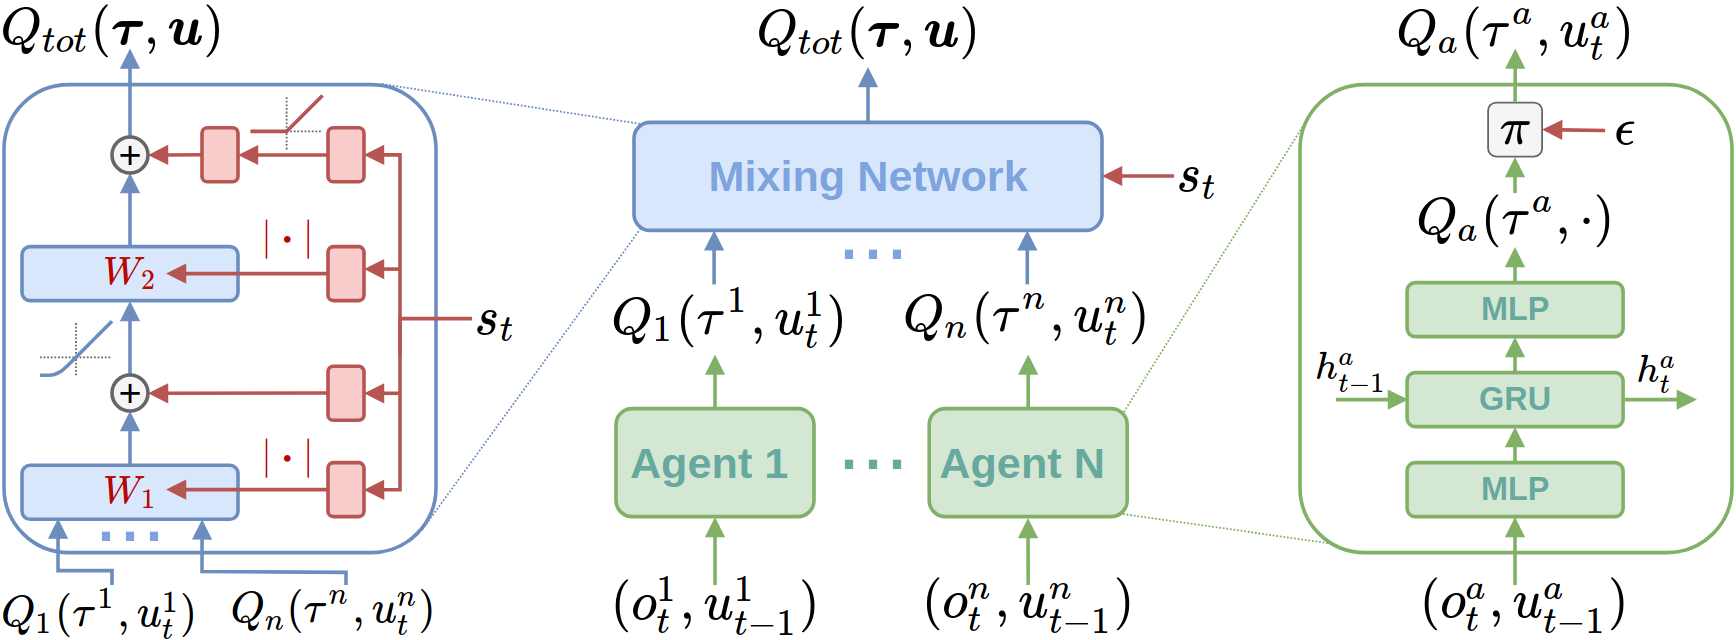
读图提示:三部分从左到右是(a)mixer及超网络、(b)整体集中训练结构、(c)单个智能体网络。红色超网络输出受约束权重,局部网络仍只使用执行时可获得的信息。
五、贪心一致性以牺牲部分价值表达为代价
单调性保证已表示Qtot的局部贪心一致,不保证真实协作价值都能被精确表示。两步博弈和StarCraft II结果显示相较VDN的收益,仍受该函数类限制;训练时全局状态也属于额外信息预算。
继续追问:排序翻转、效用与可用信息
1. 单调限制排除了哪些协作任务?
它排除需要同一智能体的动作偏好随其他智能体动作发生反转、且无法用局部信息决定反转的联合 Q 表。例如两人同动作获奖、异动作受罚的协调矩阵,无法对每个人固定一个局部动作排序来精确重建全部联合值。单调分解保证局部 argmax 可合成全局 argmax,但不是任意协作价值的通用表示;能找到一个最优联合动作与能精确拟合整张表也应区分。
2. 局部Qi能否直接解释为各单位贡献?
不能直接当作因果贡献或个体边际收益。局部效用与 mixer 一起只受联合 TD 目标约束,存在可重参数化和不同分解;效用尺度可变而总 Q 不变。真正贡献分析需要指定反事实基线与其他单位动作,或干预实验。把 可视化有助诊断决策,却不等于公平分摊奖励的解释。
3. StarCraft版本变化如何影响复现胜率?
单位属性、路径规划、攻击判定、地图脚本与环境接口变化都可能改变难度。复现需锁定 StarCraft II、SMAC/环境包版本、地图、观察/动作设置、奖励形状与评估协议,报告种子和失败运行。相同地图名不足以保证同任务,跨版本胜率差不应直接归因于算法;可先用基线在新旧版本复测来估计环境变化影响。
六、比较两条集中训练分散执行路线
平行CTDE方法:MADDPG。联合Critic梯度不要求单调效用分解,但训练Actor与动作空间条件不同。
术语辨析联系:Implicit Q-Learning。本篇实验IQL指independent Q-learning,与后来的implicit Q-learning无方法继承,查表必须核对全名。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:单调混合为什么允许各智能体分别选最大局部 Q?
参考答案:若联合价值对每个局部 Q 都单调不减,那么在其他输入固定时,提高任一局部 Q 不会降低联合价值。因此每个智能体都选自己的最大局部 Q,就能得到该混合函数的一个联合最大值。
问题 2:这种结构不能表达什么协作关系?
参考答案:例如两人动作不同才得奖励:第一个人应该选哪个动作,取决于第二个人选了什么,没有固定的局部优劣排序。此类条件性偏好可能违反单调分解要求。QMIX 用表达能力限制换取分散贪心选择的便利。