第 40 天|Dreamer:把策略训练搬到潜在世界里
原论文与版本:Hafner 等,Dream to Control: Learning Behaviors by Latent Imagination,2019/2020。正文。本文讨论初代 Dreamer;V3、V4 属于后续工作。
先接住前作的问题
MBPO用短模型轨迹生成显式训练转移;PETS则在行动时做模型搜索。Dreamer沿平行的模型控制路线,把像素压缩成潜在状态,并在可微想象中训练Actor与Critic。多步混合提供估计上的教学联系,但这里的目标由学得世界产生,不能当作真实轨迹优势。
五个前置概念
- 潜在状态:用于预测和控制的压缩表征。
- RSSM:结合递归记忆与随机潜变量的动态模型。
- 想象轨迹:在学习模型中生成的未来。
- λ-return:结合多步奖励与价值估计。
- 梯度穿模型:通过预测动态把回报影响传给动作。
一、问题设定:像素世界中,策略能否通过想象后果获得梯度
每次在像素空间长搜索成本很高,而模型预测也不必保留每个像素细节。Dreamer学习能支持动态、奖励和观测的潜在世界,再从真实观测推断的状态出发想象。关键是Actor怎样利用动作对未来的导数,以及有限想象外的收益由谁补上。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 在线视觉、模型驱动、潜在Actor–Critic |
| 状态/观测 | 图像编码后的随机/递归潜在状态 |
| 动作 | 连续控制动作 |
| 奖励或学习信号 | 学习奖励预测,真实环境监督 |
| 终止/边界 | 学习继续/终止语义并处理想象边界 |
二、以潜在动态连接动作、奖励与λ-return
像素空间做每步长搜索很贵。Dreamer先学压缩的潜在动态,再把策略优化放到这个可微世界中:真实观测训练模型,后验潜状态作为想象起点,Actor产生动作、模型预测后继及奖励,Critic补足有限想象之外的回报。
λ-return混合不同bootstrap深度,避免Actor只追求短期模型奖励。训练Actor时世界模型参数冻结,但动作→潜状态→未来奖励的导数必须保留;否则“在想象中通过未来后果学习”就失去作用。训练Critic则停止目标梯度,以免目标和预测互相追逐。
这与模型预测正确的要求不同。重构损失让潜变量保留观测信息,奖励预测让它关注任务,但Actor仍可能利用模型没见过的动作区域。潜在展开短并不自动避免模型利用;价值尾项也带估计误差。
用有限尾部价值启动λ-return反向递推
Actor最大化想象回报,Critic回归停止梯度的λ-return;世界模型另有重构、奖励、KL等损失,不是所有项共同随意反传。
递推式从哪里开始、在哪里结束: 是想象潜状态, 是模型预测奖励, 估计想象尾部的剩余回报;有限长度 的递推以 收尾,再从后向前计算。 时只用一步奖励和下一价值; 时用完整的这段想象奖励加末端价值,仍不是无误差的真实蒙特卡洛回报。中间值反复展开就给不同bootstrap深度几何权重。这也说明本篇接用TD(λ)的混合思想,但目标来自学得的世界;有终止预测时还需相应继续概率,不能把常数 简写当作所有任务的实现。见原文§3行为学习目标。
冻结世界参数仍允许哪些导数
把模型写成 ,固定φ只是不更新它;Actor仍需要 。停止整项输出梯度则会连动作到未来的路径一起切断,两种冻结在计算图上不同。
分开Actor的未来导数与Critic的冻结标签
以下是可手算的教学构造,不是论文实验。
两步想象奖励(1,2),γ=0.9、λ=0.5,V(z₁)=3、V(z₂)=4,尾部G₂=4。则G₁=2+0.9×4=5.6,G₀=1+0.9[0.5×3+0.5×5.6]=4.87。
这个目标混合了早bootstrap与更长回报。Actor可沿模型中“动作改变奖励/状态”的路径求导;Critic把4.87当冻结回归目标。两者不能使用同一套不加区分的反向传播。
三、冻结模型参数但保留动作到未来的导数
真实环境收集图像轨迹到replay
从序列训练潜在世界模型:重构+奖励+KL
从真实序列后验潜在状态开始想象
冻结世界模型参数
Actor采样动作,经模型展开H步
用预测奖励与末端V计算λ-return
沿模型动作路径更新Actor
以停止梯度return训练Critic
再到真实环境收集经验
输出:世界模型与直接行动策略
实现要点:模型幻觉与潜在表示丢失仍会影响控制。
四、比较想象长度、尾部价值和表示目标
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 20个DeepMind Control视觉任务 |
| 数据来源与规模 | 64×64RGB;动作维度约1—12 |
| 对比基线 | PlaNet、D4PG及表示/长度消融 |
| 训练预算与资源 | 原文V100加10CPU;平台与旧基线资源不完全一致 |
| 指标及其含义 | 回报、真实样本效率、训练时间 |
| 随机性与不确定性 | 完整种子与区间按图核对,本文未完整核实 |
| 实际验证的假设 | 潜在想象行为学习是否减少真实交互 |
实验解读(本文分析):图4直接比较有价值预测、无价值预测以及PlaNet在线规划,研究想象跨度。图8比较像素重构、对比与仅奖励的表示目标;表示学习质量影响控制,但更好重构不等于更好长期因果模型。20任务主结果要保留不同算法训练预算,不能把5M与更大预算写成同算力对决。
将价值消融与像素表示消融分别阅读
原引用定位:原文。
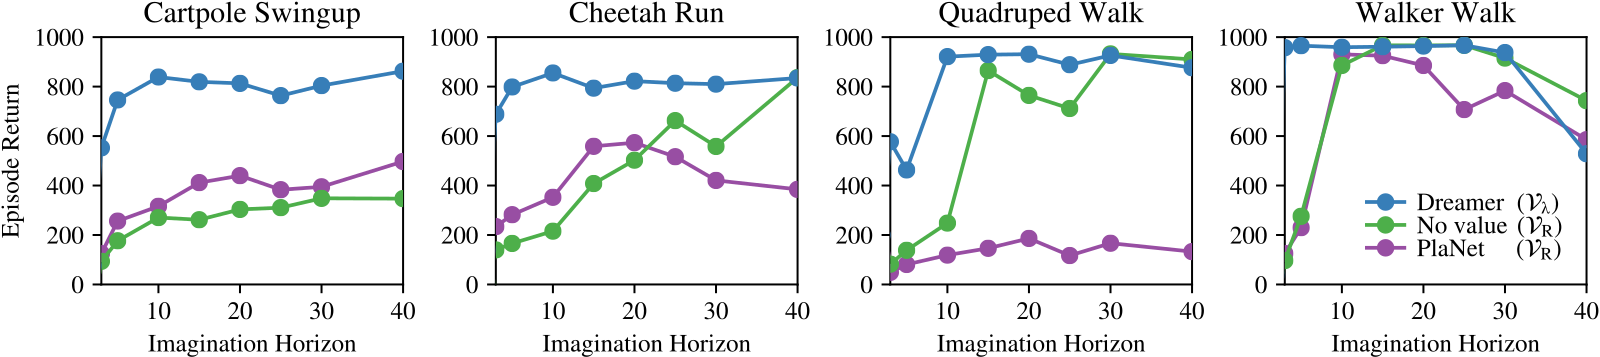
图4横轴是想象时域长度,纵轴是训练后真实环境的回合回报;它不是随训练步数前进的学习曲线。蓝色Dreamer用价值补足,绿色No value只看有限想象奖励,紫色PlaNet是在执行时规划。短时域下蓝绿差距检验尾部价值的作用;Walker Walk面板在较长时域反而下降,直接提醒“想象更多”可能增加优化和模型误差,不能把横轴越大当作默认越好。
图4改变想象时域并对照无价值补足的行为学习与在线规划,说明价值预测为何能缓解短视,而不意味着想象越长越好。图6汇总20任务平均回报,Dreamer与D4PG使用不同训练方案和数据预算;原文五种子均值不能被改写成同算力优势。图8比较像素重构、对比和奖励监督,支持表示目标影响控制,不能由此推出视觉重建越清晰必然越好。 查看原文。
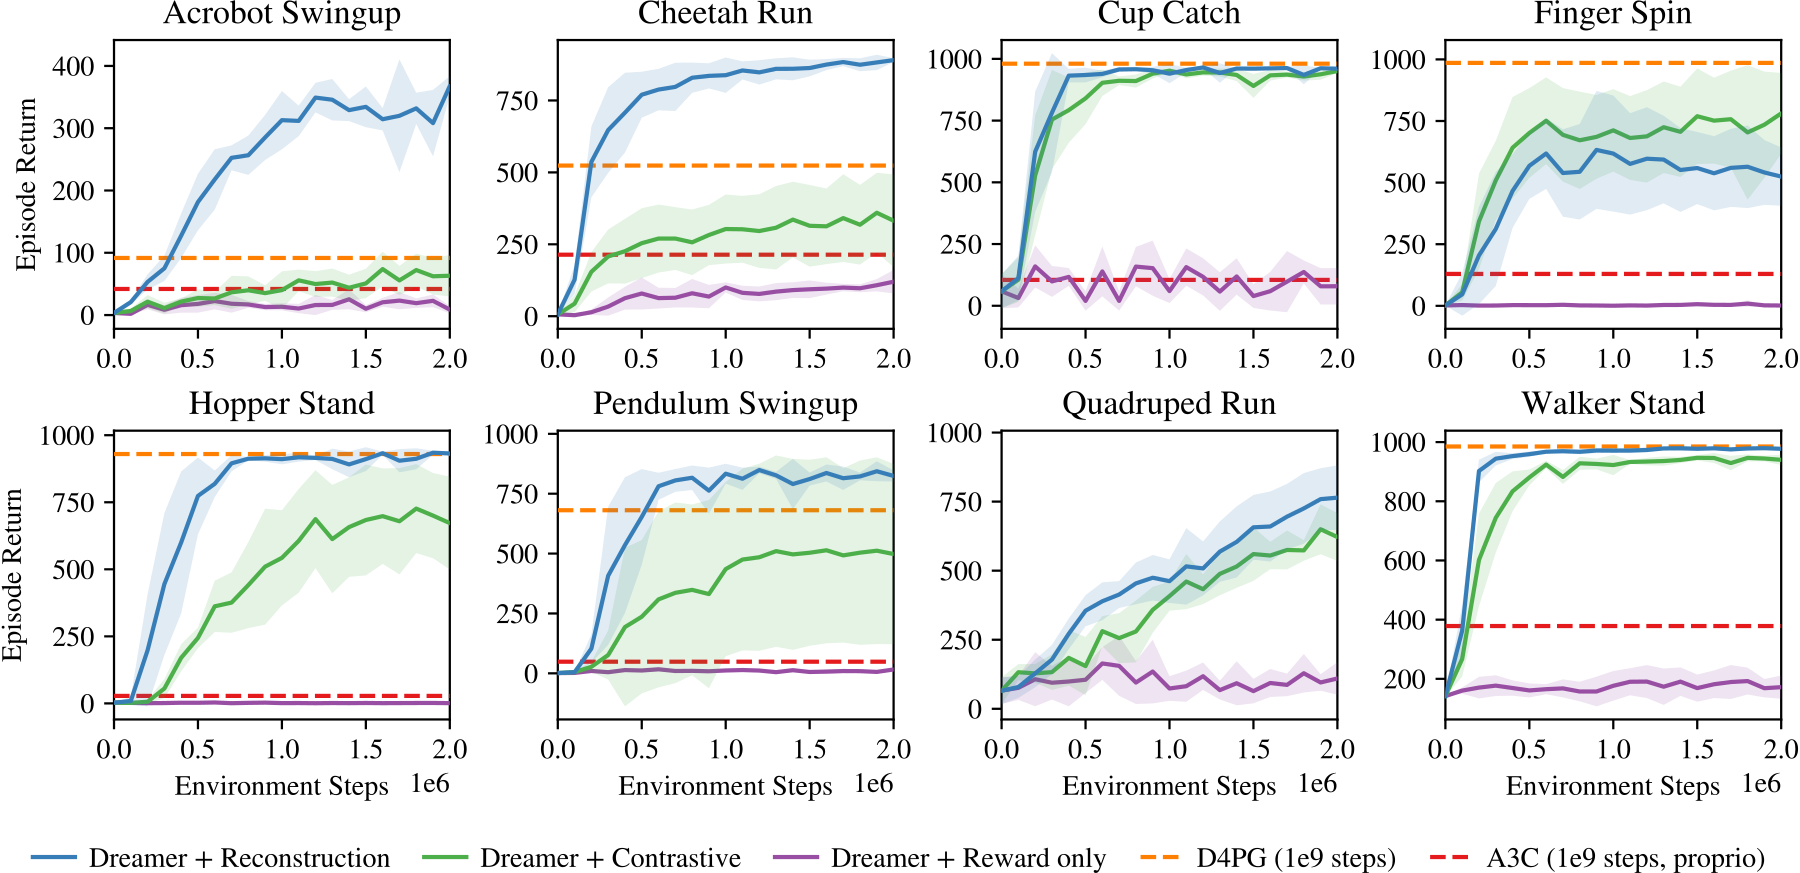
读图提示:八个任务保留重建、对比学习和仅奖励三种目标。像素重建在这些任务中表现更好,不等于任何环境都需要像素级预测。
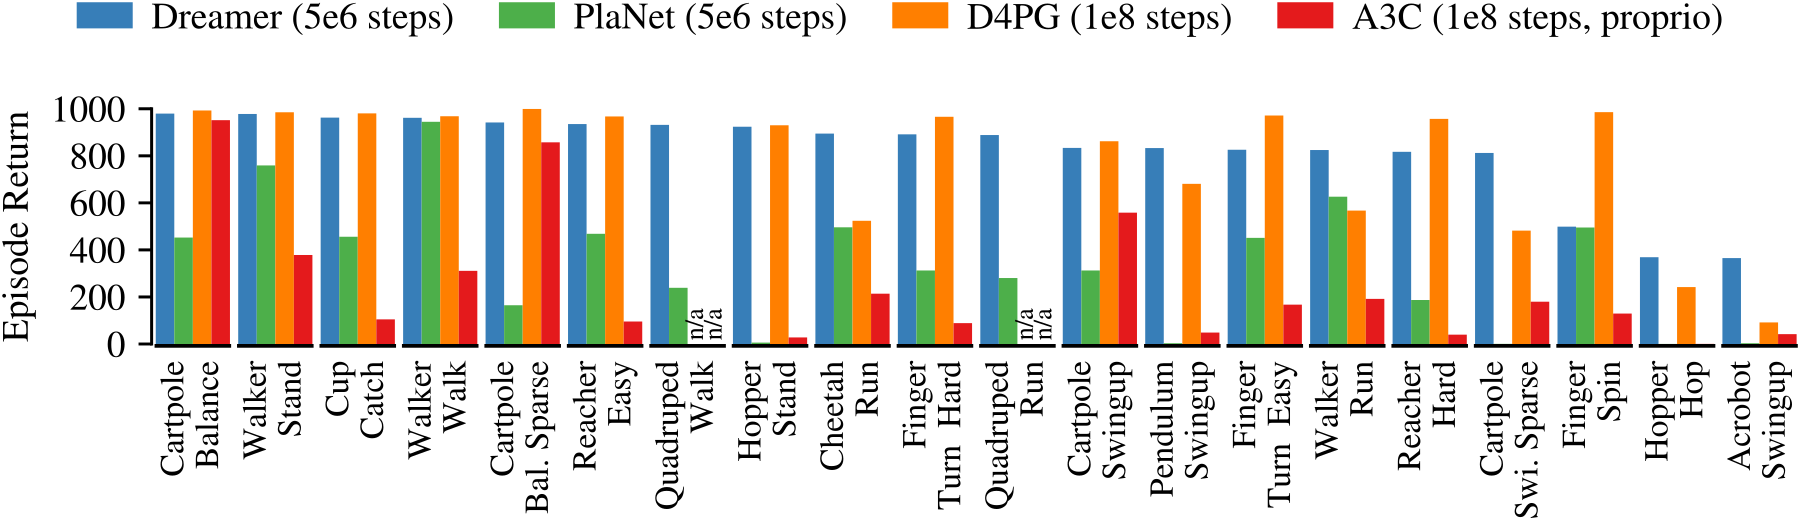
读图提示:各任务柱形保留Dreamer、PlaNet和无模型基线的图例及预算。横向比任务前先看训练步数与输入权限,不能把柱高差统一归为算法本身。
五、可微想象仍会传播模型与尾部估值错误
原文汇总中Dreamer在5M步平均回报约823,D4PG在更大预算内约786,是不同训练方案与预算的报告,不是同算力提升37分。奖励预测正确也可能漏掉控制信息;应分别评价重构、控制回报和真实环境稳健性,尤其检查Actor对模型外推的利用。
继续追问:梯度路径、表示与模型利用
1. 冻结模型参数为何仍能对Actor反传?
冻结模型参数是令其权重不更新,不是把整个计算图截断。想象状态仍是动作的可微函数,Actor 梯度可沿 及后续价值反传,再更新 Actor;模型权重只作为固定函数系数。若错误地 detach 想象状态,就切断了这条路径。需要区分冻结参数、停止目标梯度与停止输入梯度三个操作。
2. 图像重构与任务信息会冲突吗?
会。像素重构倾向保留纹理、光照等占据大量像素但可能与回报无关的信息;瓶颈容量有限时会挤占任务变量。另一方面,仅预测奖励又可能丢掉将来控制所需但当前不影响奖励的状态。应对照重构、对比和任务监督,检验真实控制、长时预测与干扰鲁棒性;视觉更清晰不等于任务充分统计量更好。
3. 如何区分模型利用和真正控制改善?
将想象回报与独立真实环境回报分开,跟踪策略更新后新访问区域的预测误差,并固定模型比较不同Actor优化强度和想象跨度。如果只在模型里提升、在真实环境下降,尤其模型分歧或约束违规增加,说明可能在利用漏洞。应报告多种子和失败任务,不能拿几段合理生成视频代替真实控制验证。
六、从初代想象行为学习走向跨任务稳健性
直接后作承接:DreamerV3。初代仍依赖模型质量与任务尺度,后作推进跨任务稳健性;V3组件应在后篇单独说明。
平行模型学习对照:MBPO。合成转移交给离策略学习器,与通过潜在动态导数训练Actor,是不同的模型使用接口。
教学阅读:Visual Model-Based Reinforcement Learning as a Path towards Generalist Robots · Mastering Diverse Control Tasks through World Models。仅借用本节的解释顺序与接口视角;具体算法、版本和实验以本篇原论文为准。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:Actor 怎样在世界模型里学会行动?
参考答案:先从真实观测推断潜在状态,再让 Actor 产生动作,世界模型预测后续状态和奖励,价值网络补足想象末端的收益。初代 Dreamer 沿这条可微想象轨迹传播梯度,更新 Actor,而无需每次更新都执行真实动作。
问题 2:为什么图像预测逼真,仍可能学出糟糕策略?
参考答案:视觉质量可能掩盖关键动力学错误,比如接触、碰撞或动作响应不准确。Actor 优化的是模型里的回报,可能专门寻找模型漏洞。因此关键不是单纯“像不像”,而是模型是否准确保留了决策所需的后果。