第 41 天|MuZero:不用重构世界,也能学出供搜索使用的模型
原论文与版本:Schrittwieser 等,Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model,2019/2020。正文。
先接住前作的问题
第21天 AlphaGo让策略先验、价值与树搜索协作,但搜索仍要能调用游戏规则:没有精确动力学时,树上的下一步从哪里来?MuZero接住的是这一模型与搜索接口问题,历史上经过AlphaZero等工作,不能把它写成AlphaGo的相邻小改版。第40天 Dreamer是潜在模型的并行路线:它主要在想象中训练可直接执行的Actor,本篇则在行动时继续搜索。
五个前置概念
- 表示网络:把观测历史变成搜索状态。
- 动态网络:预测潜在后继与奖励。
- 预测网络:给策略先验和价值。
- 搜索策略:由访问次数形成的动作目标。
- 展开训练:在多个预测步上施加监督。
一、问题设定:未知动力学下怎样保留搜索优势
给定观测历史,智能体既要决定当前动作,又要在未知环境里评估尚未执行的动作序列。直接重建所有未来像素是一项很强的建模要求;MuZero把问题缩到决策所需的信息:能否只预测奖励、剩余价值和搜索先验,就保留规划的收益?
这要求把两件事分开。潜状态不必还原物理世界,但搜索得到的偏好必须由真实环境反馈校正。本文研究的是各任务分别训练的模型与搜索系统,不能预先假定一个共同潜空间已覆盖所有游戏。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 模型驱动、潜在搜索、自我对弈或环境交互 |
| 状态/观测 | 观测历史经表示网络h编码 |
| 动作 | 合法动作 |
| 奖励或学习信号 | 环境奖励/终局胜负 |
| 终止/边界 | 按游戏结束;潜在展开长度只是训练截断 |
二、把表示、动态和预测接成可训练的搜索
h、g、f各自接收什么监督
训练损失是多步奖励、价值、搜索策略目标之和加正则;每个头的监督来源不同。
三个函数怎样连成一次可监督的展开:上标 是从当前根节点往后想象的步数,不是训练迭代; 是潜状态,不能与真实环境状态直接画等号。 只在根部吸收真实历史,后面的 用动作递推; 在每个潜状态给出动作先验 和剩余价值 。训练时对应时刻的实际奖励监督 ,真实奖励加未来搜索价值构成价值目标,归一化访问次数构成策略目标。三项误差共同反传,才把“搜索所需信息”压进潜状态;仅把三个网络按顺序调用并不能学到模型。见原文§3式1与补充图S2。
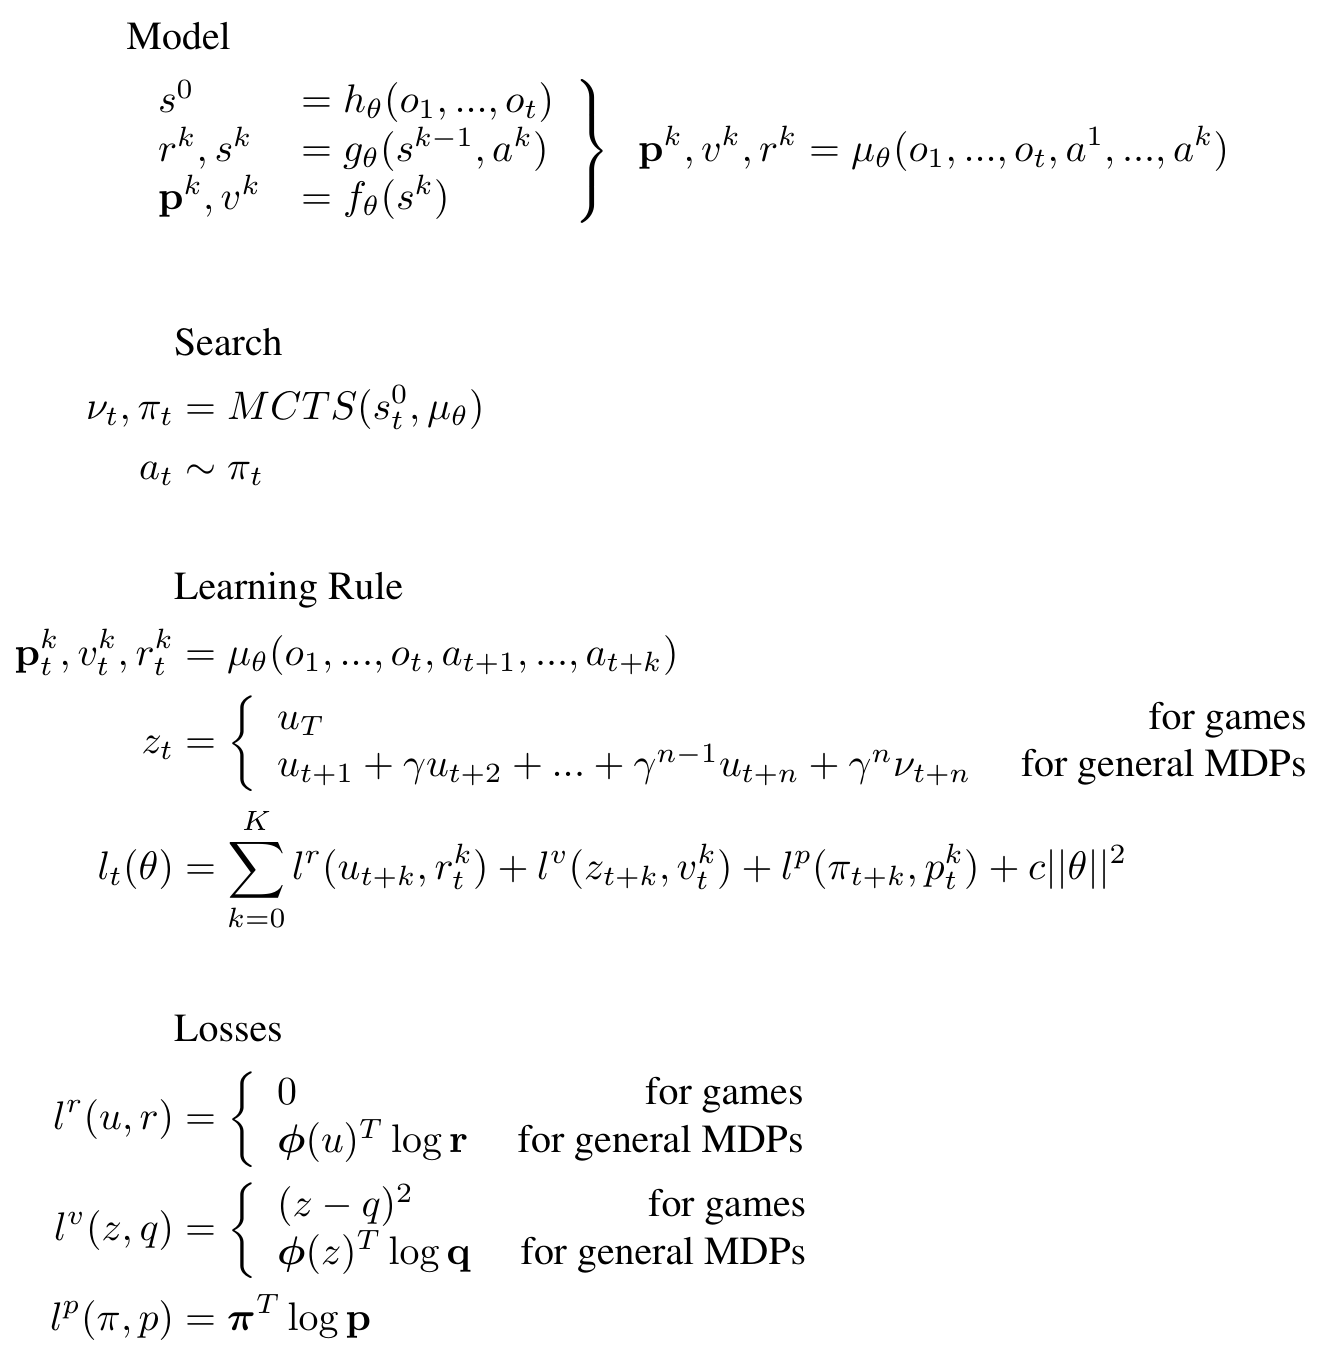
读图提示:四块依次汇总Model、Search、Learning Rule和Losses。沿展开步数k将奖励、价值和策略预测与对应目标配对;一般MDP的自举目标与终局游戏目标分开,不能把所有监督写成同一种回报。
搜索在潜空间反复选择、扩展和回传,将访问分布作为下一轮策略头的目标。由此,行动时的计算反过来改变后续训练,而不是只读一次网络输出。
模型价值等价不等于观测重建
如果两种潜状态给搜索动作序列相同的奖励与价值预测,规划可能无需区分它们的像素细节;反过来,重建相似并不保证动作结果相同。评价模型要贴着奖励、价值与搜索接口,而不能只看画面是否逼真。
用搜索访问次数核对三个标签
以下是可手算的教学构造,不是论文实验。
根先验为(0.7,0.3),一次搜索后访问次数(20,80),温度1的策略监督变(0.2,0.8)。策略头学习搜索后的偏好,而不是把自己原先的0.7再当标签。
若真实动作奖励为1,价值目标为4,这两者分别监督奖励头和价值头;把4写进即时奖励会在回传中重复计算未来收益。这个数据流比“用一个损失学世界”更值得逐项检查。
三、保存搜索目标,再沿真实动作展开训练
真实行动时:
  s0←h(观测历史)
  用f先验/价值和g潜在转移执行MCTS
  按根访问统计选择动作
  保存观测、真实奖励和搜索策略
训练时抽片段:
  编码起点并按真实动作展开K步
  奖励头对齐真实奖励
  价值头对齐真实回报/bootstrap目标
  策略头对齐当时搜索分布
  更新h,g,f
输出:网络加搜索决策器
四、读图2与搜索预算实验:学到的模型能否继续规划
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 围棋、国际象棋、将棋、57 Atari |
| 数据来源与规模 | 自我对弈或真实环境数据 |
| 对比基线 | AlphaZero及原文Atari方法 |
| 训练预算与资源 | 展开K=5;棋类800、Atari50搜索模拟;训练用大量TPU |
| 指标及其含义 | 棋力、游戏分数、搜索扩展收益 |
| 随机性与不确定性 | 完整种子与区间本文未逐项核实 |
| 实际验证的假设 | 任务相关模型是否足以支持强搜索 |
图2:按任务分开训练表现与额外搜索
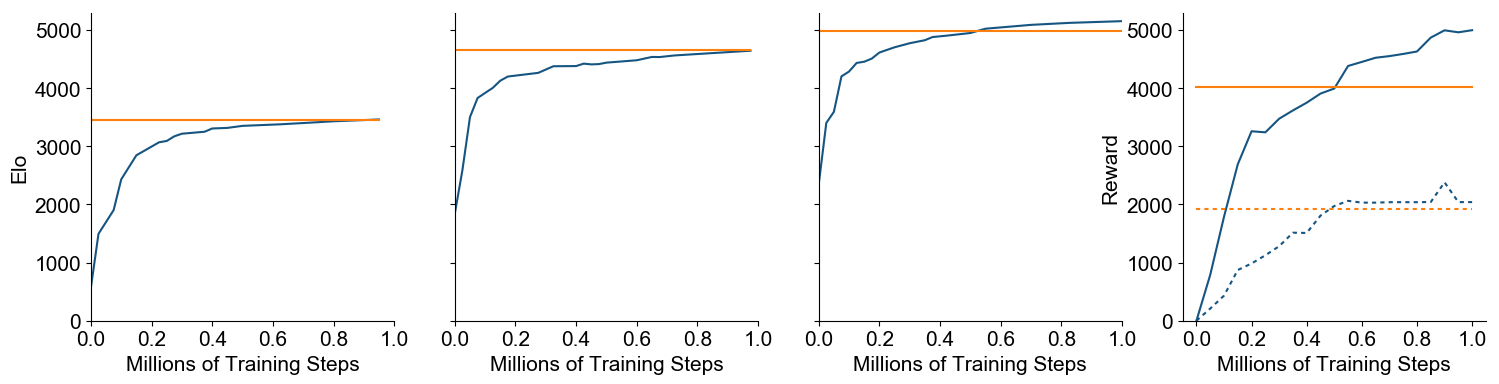
图2按训练进程展示棋类Elo与Atari指标:前三个面板依次为Chess、Shogi、Go,最后是57项Atari的人类归一化均值(实线)与中位数(虚线)。蓝色表示MuZero,橙色是原文的AlphaZero或R2D2参照;横轴为百万训练步,不能把棋类Elo与Atari分数直接相比。
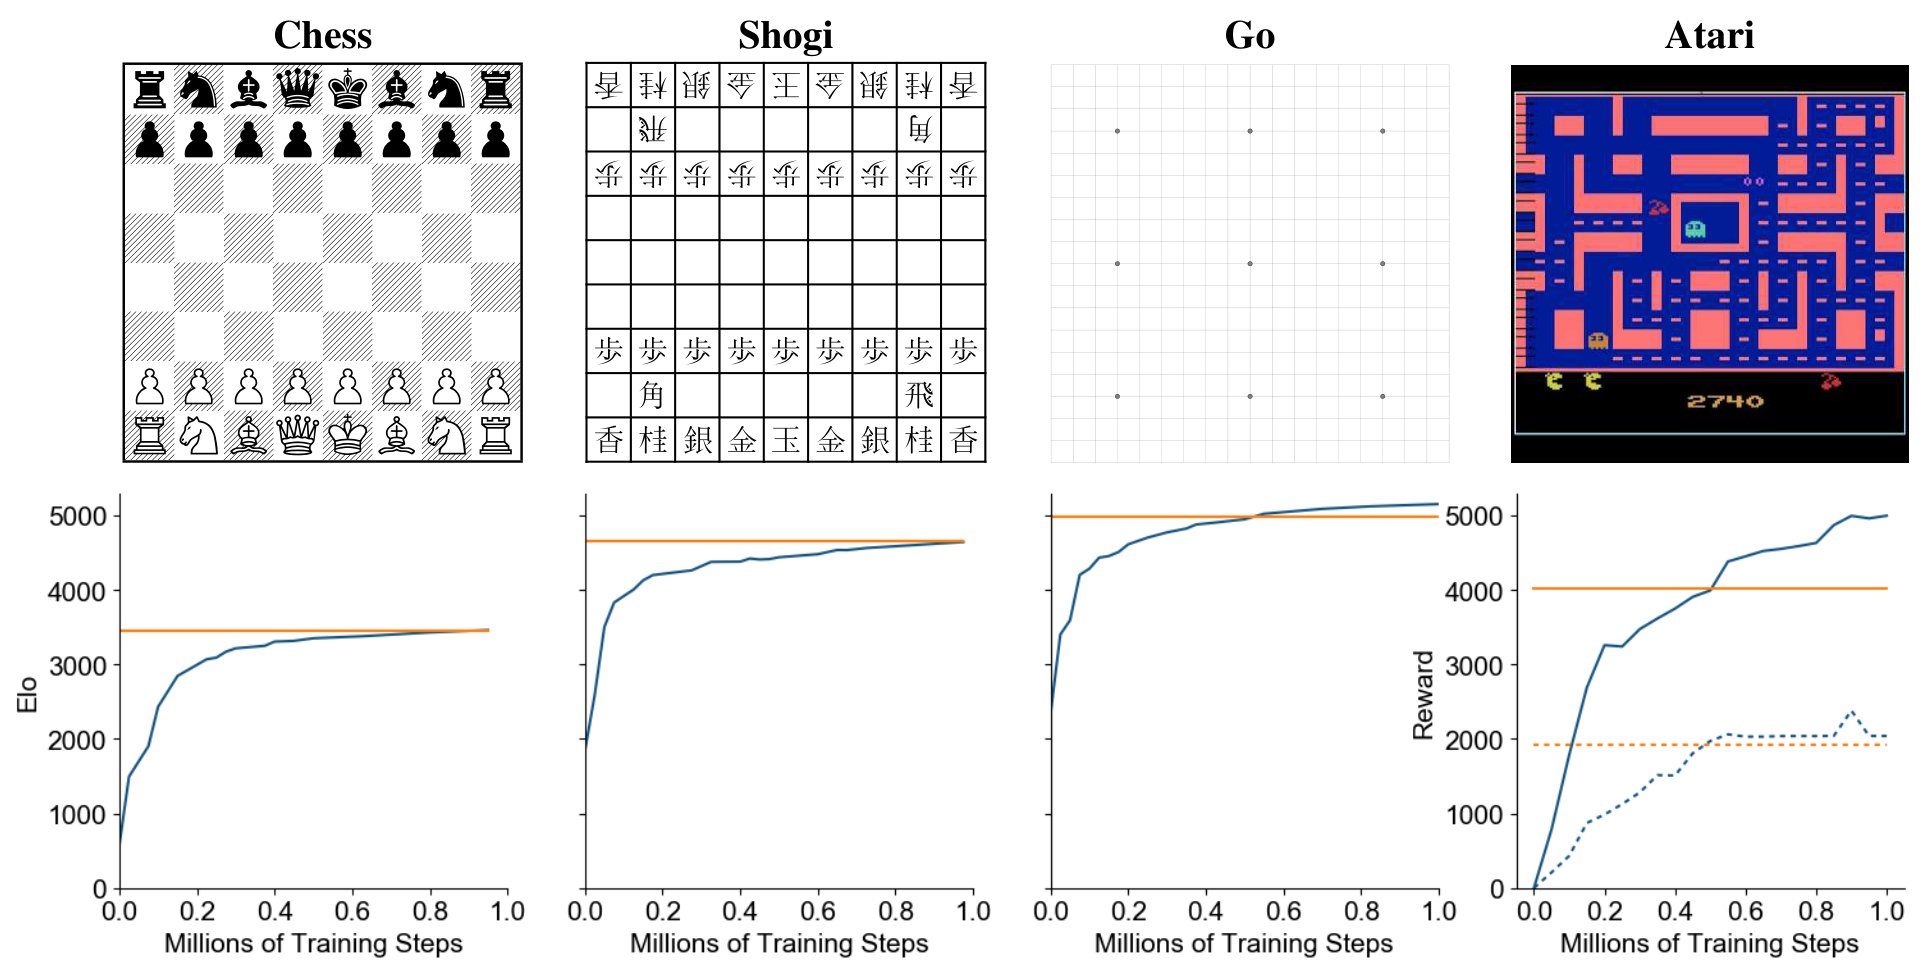
读图提示:四列依次为Chess、Shogi、Go、Atari,保留PDF中的棋盘和游戏样例。前三列蓝线MuZero对照橙线AlphaZero;末列实线与虚线分别为57游戏的均值与中位数,橙线对应R2D2。
图3:固定训练预算后,额外搜索能支持到哪里
图3的围棋网络均以每步800次模拟训练,再评估更长搜索;部分面板还将学习模型与真实规则模拟器对照。这支持学到的模型在该范围内可利用额外计算。Atari与棋类的预算并不相同,且各领域分别训练。
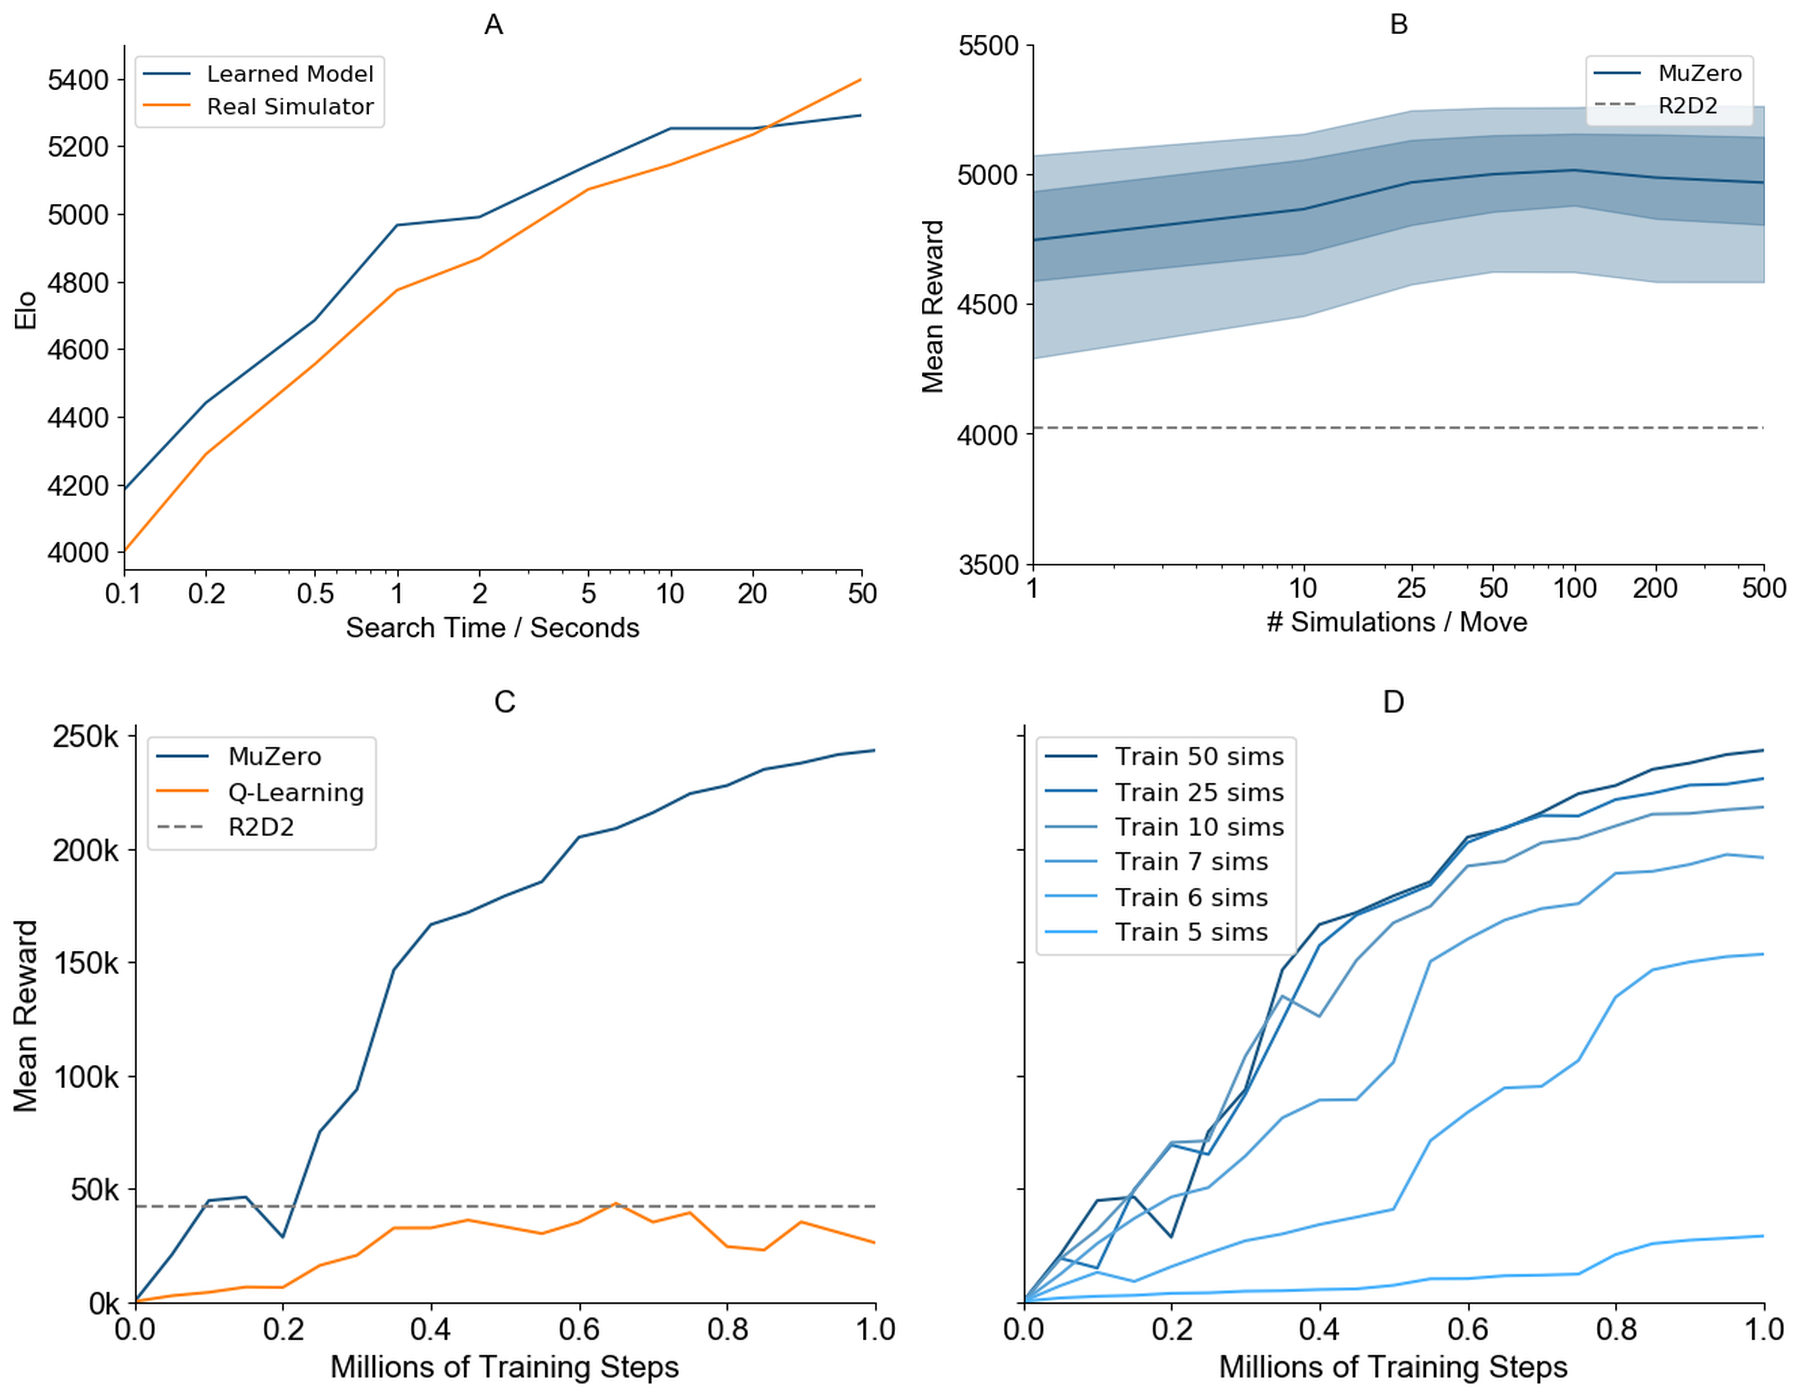
读图提示:(A)检验围棋搜索时间扩展,(B)检验Atari搜索模拟数,(C)(D)是Ms. Pacman训练与搜索消融。四个面板的预算轴不同,不能合读成单一扩展曲线。
五、搜索越深,哪些模型错误也可能被放大
潜在状态只需保留奖励、价值与搜索相关信息,不必逐维对应物理世界,因此未训练动作序列下的预测仍可能失真。训练与搜索资源巨大,额外搜索也可能放大模型漏洞;其收益应在实际预算曲线内判断。隐藏信息、随机性和奖励错误不因潜在表示而消失,搜索还会同时改变访问分布与训练目标。
六、三个值得继续追问的问题与参考答案
1. 搜索预算增加时为何可能利用模型误差?
搜索更充分地最大化学习模型给出的价值,可能找到训练分布外的动作序列,放大错误奖励或转移预测。若模型在新分支上不准确,更多模拟并不等于更多真实证据。应固定网络、逐级增加模拟次数,同时在真实环境测收益与规划深度误差,保留收益转折和失败案例;原文某预算区间的改善不能外推到无限搜索。
2. 没有重构损失如何保留关键信息?
模型由奖励、价值和策略目标约束,只需保留有助于这些决策预测的信息,不必重建所有像素。多步展开训练促使潜在动态支持未来决策,但监督覆盖不足时仍可能丢失关键变量。没有重构损失不等于潜在表示天然正确或可解释;应在干预、长时预测与新策略访问区域验证任务相关信息是否保留。
3. 模型与搜索各贡献多少需要什么消融?
可冻结同一模型比较零搜索、不同模拟预算和不同搜索策略,再固定预算替换模型质量或使用真实规则模型;训练目标、训练搜索和部署搜索也要分别控制。统计训练算力与推理调用,才能区分模型学习、策略改进和额外决策计算。仅比较完整 MuZero 与另一完整系统,无法分离每一组件的净贡献及其交互。
七、沿未解决的问题继续读
DreamerV3:如果更换奖励尺度与观测类型,潜在模型的公共训练配置还能否稳定?DreamerV3继续发展Dreamer的想象Actor路线,可与MuZero的行动时搜索作对照。(并行路线的后续发展)
MBDPO:搜索会不会反复选中价值网络缺少训练支持的动作序列?MBDPO用行为相关能量与扩散策略处理分布失配,继续追问同一规划风险,而非MuZero的直接升级。(后续问题对照)
原文核对与路线出处
- 原论文与图表入口。表示/动态/预测训练流程;图2、图3及搜索预算说明。
- 历史背景:AlphaGo。延续先验、价值与搜索协作,但MuZero连规划动态也从数据学习。
- 并行路线:Dreamer。均用潜在模型,Dreamer训练可直接执行的Actor,MuZero行动时还执行搜索。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:不重构真实观测,潜在模型凭什么能支持搜索?
参考答案:搜索需要知道候选动作如何影响奖励、未来价值和后续行动选择。MuZero 用这些决策相关目标训练潜在表示与动态,而不要求还原全部观测细节。只要保留足够的决策信息,模型就可能支持有效搜索。
问题 2:MuZero 的模型能否直接作为通用环境模拟器?
参考答案:不能这样推断。它可能丢弃与训练任务回报无关的物理或视觉信息,潜在状态也未必具有明确物理含义。支持特定策略搜索,与准确预测任意观测、回答任意任务问题,是不同要求。