第 56 天|MBDPO:让世界模型、价值学习与扩散策略更一致
原论文与版本:Cheng 等,Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,2026-05-25。正文。这里的 Diffusion Policy Optimization 与直接偏好优化 DPO 不是同一算法。
先接住前作的问题
第35天 PETS展示了在学习模型中评价候选动作序列,第40天 Dreamer把行为训练放进潜在模型。它们提供共同背景,却没有使高回报搜索与价值学习的数据分布天然一致。MBDPO具体问:搜索若不断挑中缺少支持的序列,怎样约束生成分布并摊销求解?它与Dreamer是平行模型路线;名称中的扩散DPO也不同于直接偏好优化。
五个前置概念
- Score:扩散分布对输入的log密度梯度。
- 能量模型:用标量分数描述样本相容性。
- Gibbs权重:按指数回报分配候选权重。
- 摊销推断:把昂贵求解结果学习进网络。
- 策略漂移:行动分布偏离训练支持。
一、问题设定:怎样约束模型搜索与价值学习的分布失配
世界模型中的高预测回报不必对应真实好动作。搜索越偏向高值,越可能访问价值网络缺少训练证据的序列,下一轮Bellman目标又把这些估值纳入训练,形成分布失配。
本篇用行为相关能量约束候选序列,把正则化回报转成分布,再训练扩散score网络。要判断它是否改善一致性,必须同时看策略漂移、价值误差代理、真实任务回报和MC/去噪成本,不能只看模型规模。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 模型驱动在线、离线预训练及在线微调 |
| 状态/观测 | 潜在状态z和环境观测 |
| 动作 | 多步连续动作序列 |
| 奖励或学习信号 | 预测任务回报加能量相关正则 |
| 终止/边界 | 环境终止与模型展开长度分别处理 |
二、用回报加权候选推导扩散score目标
高斯加噪为何导出加权后验均值
κ是回报权重温度;φ_MC使用噪声级别和加权干净候选序列计算,详见式15。能量用于正则化G,其与−log行为密度的联系取决于负样本分布。
为什么加权候选会变成score:前向加噪写成 , 为标准高斯, 表示保留的信号比例。对这个高斯条件密度的 求log梯度,得到 ;再对干净候选的后验取平均,就把 换成后验均值。原文的特定高斯提议与Gibbs回报权重,正是在近似这个均值,所以权重和为1、 越小越集中到高预测回报。换成任意提议而不修正密度比,便不再是同一估计。见附录式49—56及正文式15。
给带噪序列 ,从对应高斯提议分布采干净候选 ,在世界模型里算 ,以softmax回报权重近似后验均值。score因此为 。它不是直接朝回报梯度爬升,而是学习高回报分布经过加噪后的对数密度梯度。有限样本的自归一重要性比一般有偏;一致性或渐近无偏不能写成任意样本数都精确。
计算摊销把哪部分工作搬离部署
MC样本用来形成训练score网络的目标,部署再用已拟合score去噪。减少在线MC并不表示这部分成本消失,而是前移到训练;模型、候选数和去噪步数共同决定实际总预算。
两个候选的回报与能量怎样竞争
以下是可手算的教学构造,不是论文实验。
令一个一维带噪动作为0,,提议采得两个干净候选−1与1,回报分别0和log3,κ=1。权重为1/4、3/4,加权均值0.5,score目标为 ,指向正动作区域。
若第二个候选因行为支持薄弱多付出能量代价log3,两者正则化回报同为0,权重各1/2,score目标变为0。该构造展示回报与支持约束如何竞争;它没有证明学到的能量就是真实行为密度。
三、训练能量与MC目标,再把去噪求解摊销进策略
从真实replay训练编码、潜在动态、奖励和价值模型
训练能量模型:数据动作正例,规定的错配动作负例
训练扩散score:
  抽状态z、噪声级别τ和带噪动作序列
  从对应提议分布采T个干净候选序列
  在世界模型中展开,求正则化回报G_tilde
  softmax(G_tilde/κ)得到权重
  按原文式15构造Monte Carlo score目标
  停止目标梯度,拟合score网络
部署:从噪声用score迭代生成动作序列并执行规定动作
继续真实交互更新数据
四、读五个任务面板,并另查容量与时间曲线
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | DMControl、MetaWorld、ManiSkill2、MyoSuite共121任务 |
| 数据来源与规模 | 在线replay、30/80任务离线数据及微调 |
| 对比基线 | TD-MPC、TD-MPC2、SAC、DreamerV3 |
| 训练预算与资源 | 模型1.7M—340M;表1在线A800、离线H200上10M更新成本 |
| 指标及其含义 | 回报/成功、cross TD误差、策略漂移和时间 |
| 随机性与不确定性 | 视觉图5各任务5种子;其他实验范围单独核对 |
| 实际验证的假设 | 分布约束和摊销扩散策略是否改善世界模型学习 |
图4:五个面板的指标与交互预算
原引用定位:原文。
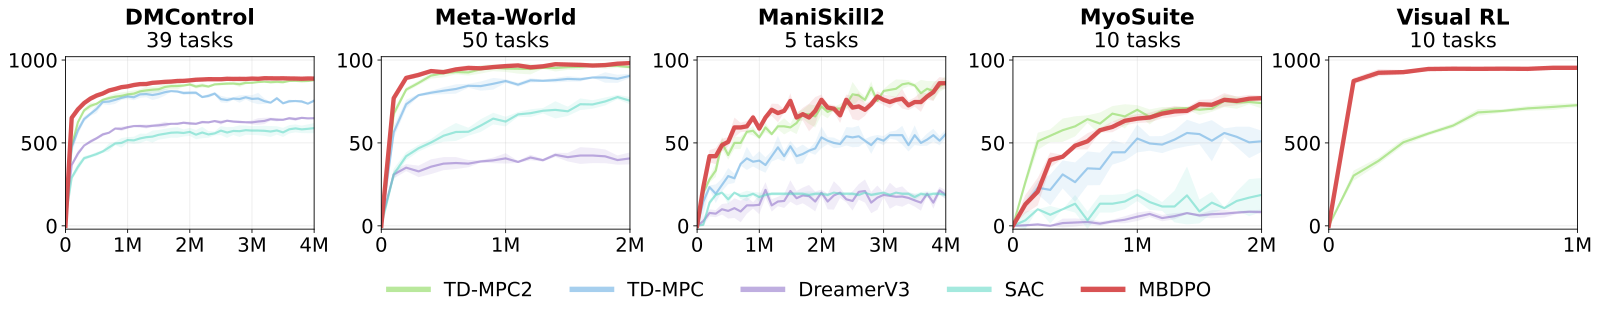
图4五列按图面板依次是DMControl、Meta-World、ManiSkill2、MyoSuite和Visual RL,横轴为各自环境交互步;前四列与视觉列的预算上限不同。纵轴也不可混比:DMControl/视觉任务画回报,其余面板主要按成功指标汇总。红色MBDPO应与同面板的绿色TD-MPC2等对照;ManiSkill2后期两者接近或交错,不能把红线总体较高改写成每任务、每检查点都获胜,更不能把此图读成参数规模扩展图。
图3左侧看cross-TD误差、右侧看动作漂移,检验策略与价值学习一致性代理,并非世界模型完全正确的证明。图4和图5扩大到多基准及视觉任务,图6的横轴才是模型参数规模,且要分别读30任务与80任务曲线;原文文字称30任务340M出现退化,并解释为数据容量饱和,但图6标值却是MBDPO 82.4→83.7、TD-MPC2 59.4→71.4;这里存在图文不一致,不能据图断言下降。图7还保留Hopper Hop迁移失败,表1的硬件与时间应按设备单列,不能用参数规模替代计算成本。 查看原文。
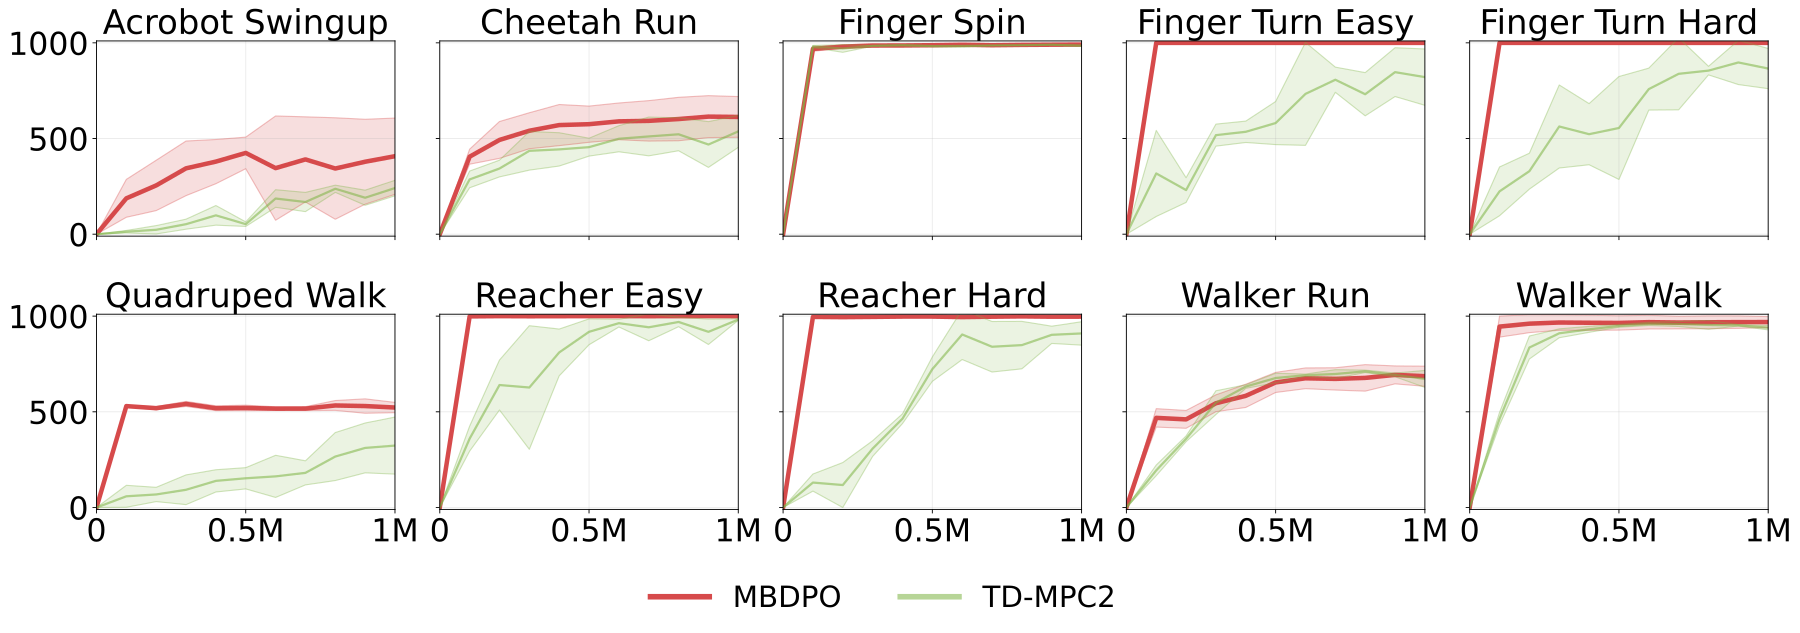
读图提示:十个视觉控制任务逐项保留,红色MBDPO对照绿色TD-MPC2。部分任务很快饱和、部分差距更大,平均收益不能替代每项任务的预算和曲线。
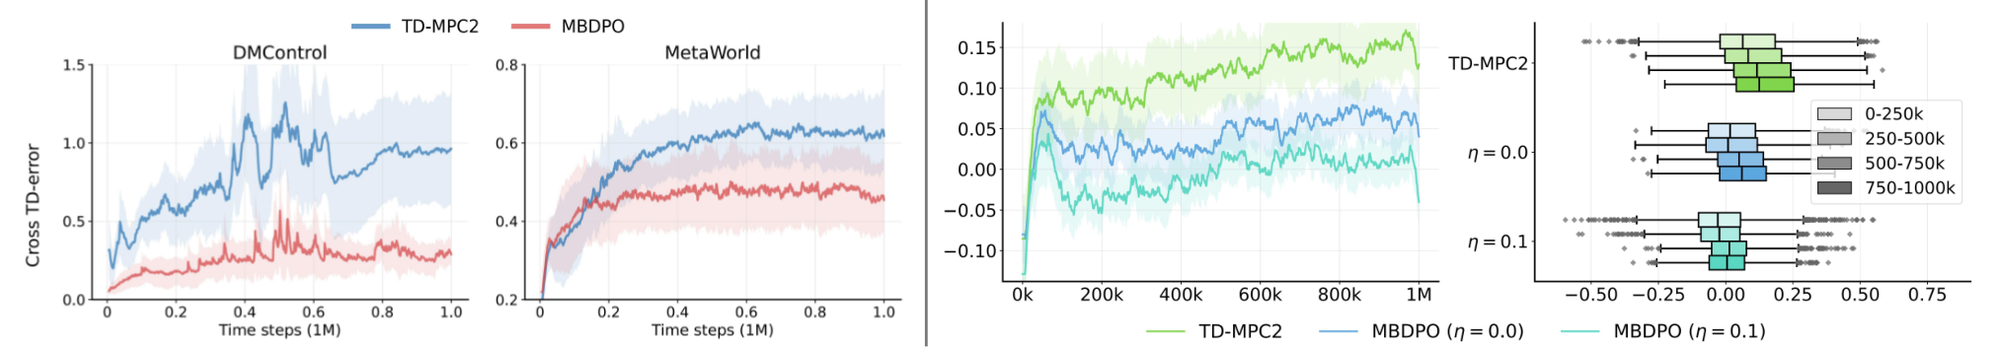
读图提示:左侧两图为cross-TD误差,右侧为动作漂移均值与分布。它们是策略与价值一致性的诊断代理,并非世界模型完全正确的证据。
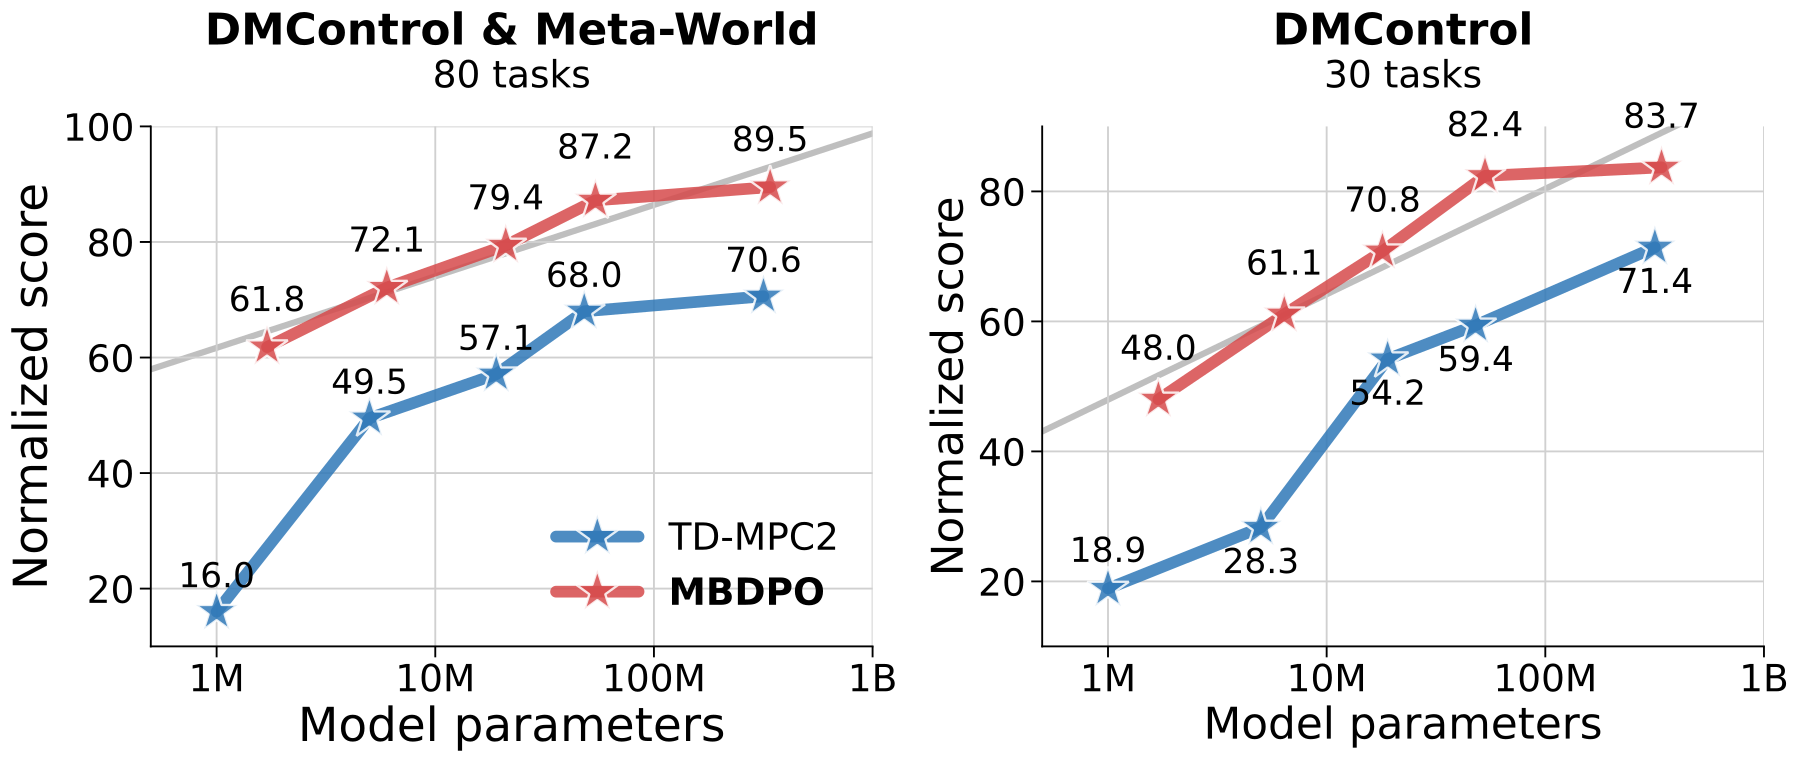
读图提示:左侧80任务,右侧30任务;横轴才是模型参数规模。右图MBDPO标注从82.4升至83.7,TD-MPC2从59.4升至71.4,与原文段落所称340M下降不一致。因此上文的下降说法来自作者文字叙述,不能由这张图直接验证。
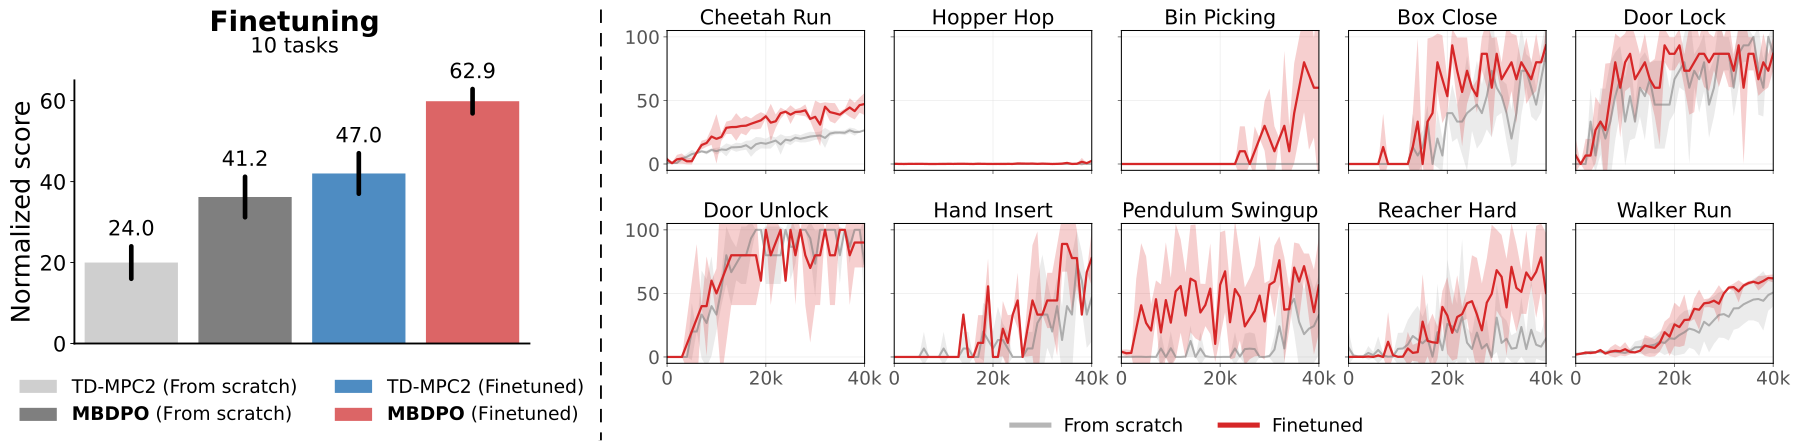
读图提示:左侧汇总离线到在线微调,右侧逐任务比较从头训练与微调;Hopper Hop仍保留失败。迁移收益与任务覆盖应逐项核对,不能只看汇总柱。
固定1000万更新的时间不等于同精度成本
原文分别报告在线、多任务离线和离线到在线设置,不能把这些预算合并成一条学习曲线。表1在固定1000万训练步下比较30与80任务的离线耗时,340M模型约203与207小时;“任务数增多而时间接近”不等于大模型廉价,也不等于达到相同精度的时间相同。MC样本数与去噪步数消融需要同时看得分和运行时间;理论分布误差还依赖模型、能量与score近似条件。
五、能量密度近似与非单调扩展都限制结论
能量的密度解释也有条件。对比学习使用其他状态的动作作负例,若负例边缘近似均匀,才有 。附录从逐步能量推向行为正则轨迹分布时,还近似短展开中的状态常数 ,不能把它当无条件恒等式。
候选数、去噪步数、score拟合与能量正则共同决定成本和质量;121任务、视觉及多任务结果不取消有限MC和密度近似条件。
六、三个值得继续追问的问题与参考答案
1. 负样本采样如何改变能量的密度解释?
二分类式对比学习的最优打分一般对应数据密度与负样本密度之比;若负例来自 ,能量或score中会包含与 有关的项。只有明确负例分布及归一化假设,才能把它换算成行为密度或其梯度。改变负采样而不调整推导,会改变解释甚至策略引导方向;应比较已知密度的合成分布并检查校准。
2. 固定总训练成本而非参数量时扩展趋势是否保持?
需要同总FLOPs、加速器时间、训练数据和推理预算的额外对照。较大模型参数可能提高表示能力,也增加模型、扩散采样和规划成本;参数曲线不能替代成本曲线。作者文字所称30任务340M下降与图6标值不一致,不能据图断言退化,也不能据这一处图文冲突概括严格单调性。应报告各数据设置的成本-收益前沿和不同种子,不据摘要措辞推断固定成本规律。
3. score拟合与世界模型误差各贡献多少失败?
可做二维消融:在可查询真实动力学的任务中替换学习世界模型,在可解析或高精度参考策略上替换score,再比较两类误差的单独与联合影响。固定轨迹预算,分别测动作score偏差、模型多步误差及真实收益,检查交互项。原文cross-TD和动作漂移是机制诊断,不足以直接分解所有失败比例,不能为两种误差分配未测百分比。
七、沿未解决的问题继续读
WorldSample:如果风险发生在合成转移进入Critic,而非候选动作生成分布,应该在哪个接口控制?WorldSample用Q筛选和熵调度处理,属于随后出现的平行模型路线。(后续平行路线)
DreamerV3:固定配方的尺度稳健与分布一致性究竟各解决什么?回看DreamerV3的组件消融,能把数值训练问题与本篇策略生成问题分开;这是前作对照,不是继承声明。(早期平行路线回看)
原文核对与路线出处
- 原论文与图表入口。主方法式15、附录score推导与能量密度近似、表1计算成本及消融。
- 并行路线:Dreamer。同用潜在世界模型,但本篇以回报加权score学习动作序列分布,而非直接复制想象Actor更新。
- 教学对应:直接偏好优化DPO。缩写相近而目标、数据和优化对象不同,应主动辨别。
- 历史背景:PETS。模型中评价候选序列是共同规划问题,MBDPO把生成分布摊销到扩散策略。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:搜索策略与价值学习的策略不一致,为什么会出问题?
参考答案:搜索可能挑中价值网络缺少训练支持的动作序列,并利用其中的高估。MBDPO 用行为相关能量约束候选行为,再通过世界模型回报构造加权 score 目标,训练扩散策略,将搜索与策略改进更紧密地结合。原文方法
问题 2:为什么不能直接把对比学习得到的能量当成精确的负对数行为概率?
参考答案:一般对比学习识别的是数据分布相对于负样本分布的密度比。只有对负样本分布作出适当假设,才能进一步解释成行为密度。因此,使用这种能量约束可能有效,并不自动证明它是准确的概率模型。