第 57 天|WorldSample:合成经验什么时候值得交给真实机器人学习
原论文与版本:Xue 等,WorldSample: Closed-loop Real-robot RL with World Modelling,2026-07-02。正文。
先接住前作的问题
第39天 MBPO通过短模型rollout权衡额外经验与模型偏差,真实机器人仍要面对视频模型、奖励标签和物理接触的额外误差。WorldSample接住的是“何时值得把合成经验交给Critic”这一问题,不能据相似点断言直接算法继承。第56天 MBDPO是同期附近的平行路线,干预的是策略生成分布,而本篇干预合成经验的选择和影响强度。
五个前置概念
- 合成经验:由生成模型产生的训练轨迹。
- PPL:按样本与训练阶段调节合成影响。
- 策略熵:行动分布不确定程度的统计。
- 奖励模型:为合成轨迹提供标签的评价器。
- 物理接地:预测与真实可执行交互相一致。
一、问题设定:合成经验何时值得交给真实机器人Critic
真实机器人试错昂贵,但一段看似合理的视频并不等于一条可信转移。若奖励模型也误判成功,合成TD目标会把模型的错误带进Critic,再影响真实动作。
WorldSample让真实交互、任务世界模型和策略共同更新,并将合成经验控制拆成两问:选哪些正负样本,以及当前训练阶段给它们多大影响。本文需要分别验证物理成功、人工接管和完整资源成本,不能用图像相似性包办三者。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 真实机器人在线RL加视频世界模型 |
| 状态/观测 | 侧视/腕部相机观测及策略所需状态 |
| 动作 | 机械臂和二元夹爪动作 |
| 奖励或学习信号 | 真实任务反馈与独立奖励模型的合成标签 |
| 终止/边界 | 任务完成/失败或最大交互边界 |
二、先选择合成正负经验,再调节Critic中的权重
Policy-Paced Learning分开解决“选什么”和“信多少”:Q感知筛选让成功与失败的合成轨迹共同约束价值,熵调度控制合成项在当前训练阶段的权重。
合成轨迹要由独立奖励模型标注,再参与TD目标;视觉一致性、动作因果后果和奖励正确性是不同误差源。只选成功视频可能抬高Q,只选失败视频又会过分保守。真实数据项始终承担物理锚点,但函数逼近共享参数意味着错误合成目标仍可能污染真实状态估计。
合成采样比例如何换成损失系数
上式是正文的概念调度,实现版差异见第三节。H是原文定义的策略熵统计,w_Q来自样本选择/权重。真实与合成项不是等可靠监督;正文“偏差趋零”的讨论还依赖额外近似关系。
损失权重和样本占比要分清: 是每条转移的价值回归损失, 改变哪些合成转移对梯度影响更大, 再控制整个合成项相对真实项的强度。若仅讨论无额外权重的混合采样,合成比例为 的平均损失是 ;把真实项系数归一到1后,相对系数是 ,并非 本身。这是教学换算,说明附录“比例上限”不能直接代替正文的损失系数。熵调度还需其统计量处于原式适用范围;连续动作微分熵会随坐标尺度变化。见正文式4、6—9与附录实现。
策略熵和模型预测误差属于不同对象
一个只选单个动作的策略熵可以接近零,而视频模型仍可能把该动作后果预测错。低熵可改变采样分布的集中程度,却不是无需外部验证的模型校准指标。
合成权重封顶后Critic仍可能偏移
以下是可手算的教学构造,不是论文实验。
设真实TD目标为1,合成TD目标误估为5,暂时都拟合同一标量q。损失 的极小值满足 。ρ从0升到0.3,q从1升到约1.92,合成权重被封顶仍不代表偏差消失。
若合成成功与失败的目标改为5与−3,等权平均为1,在这个极简二次问题里可相互平衡;真实高维训练则还取决于状态分布和误差相关性。这解释了“兼顾正负”为什么有意义,也说明仅凭均值平衡不能保证每个状态的Q可靠。
三、闭环更新真实回放、视频模型与合成筛选
正文写出随策略熵下降而增大的非线性ρ(H),附录实现则采用熵的线性近似调度并把合成比例封顶30%。二者应明确区分。
用20条示范初始化策略与任务世界模型
真实交互流:采集轨迹并更新真实replay
世界模型流:用新增真实数据继续适应模型
合成流:生成候选轨迹,由独立奖励模型标正负
PPL:
  按Q相关标准选合成样本
  从真实状态估计策略熵H
  计算合成权重ρ(H);复现时采用附录线性近似及30%上限
  用真实TD损失+加权合成TD损失更新Critic
  通过Critic更新Actor
记录模型生成、人工干预和真实交互总成本
四、按真实步数对齐成功与干预曲线,再复算主表
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | Galaxea A1X;推、插入、分类、抓放、组装五类 |
| 数据来源与规模 | 共同20人工示范;VLAW另用50合成示范;Cosmos-Predict2.5基座 |
| 对比基线 | HIL-SERL、VLAW、WMPO |
| 训练预算与资源 | batch256;表1汇总真实步数与时间 |
| 指标及其含义 | 成功率、训练步数、分钟;另有PSNR/SSIM |
| 随机性与不确定性 | 完整训练种子与置信区间本文未确认 |
| 实际验证的假设 | 合成经验能否在受控权重下减少物理试错 |
图3:同一真实步数下看成功与接管
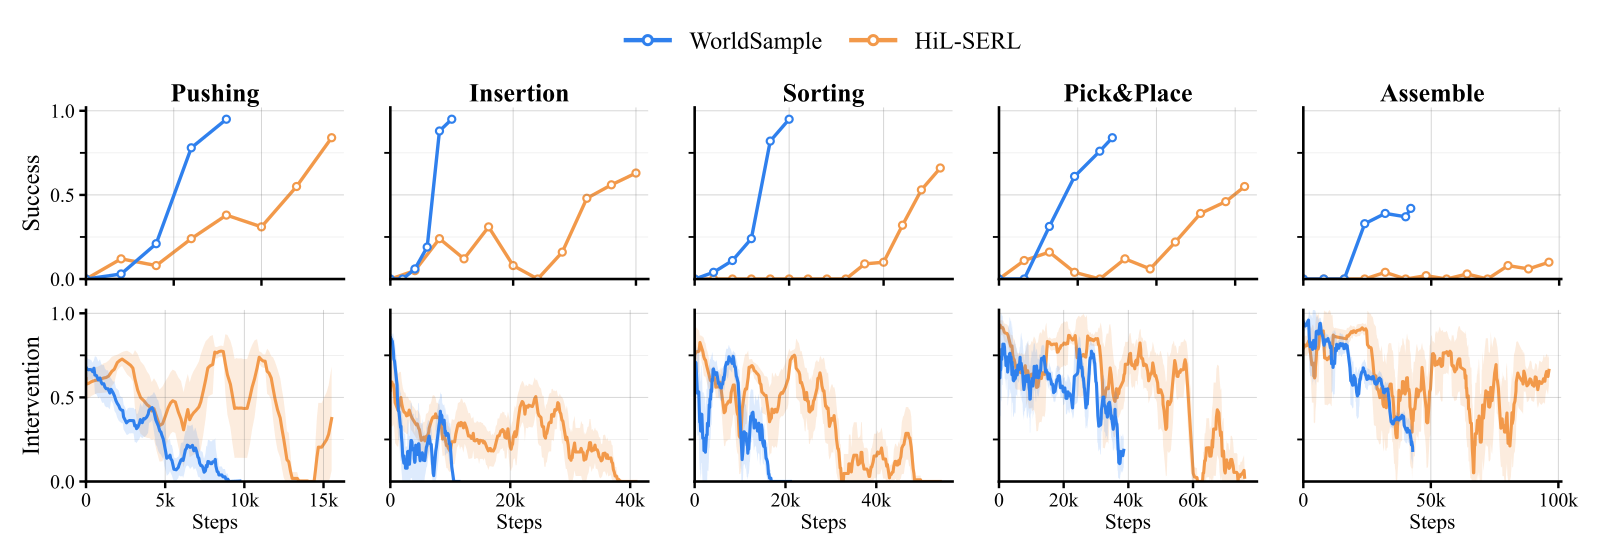
图3每列是一项机器人任务,上排纵轴是成功率,下排是人工干预率;横轴均为真实交互步,蓝色WorldSample与橙色HIL-SERL的终点预算不同。读“更快成功”应在相同横轴位置比较上排,再对照同位置下排是否仍依赖接管;不能直接用两个不同终点的高低当同预算效果。Assemble上蓝线仍远低于完全成功,提醒平均提升没有消除困难任务。
视觉表2及真实/生成帧对照用于检查图像相似性;图5再比较PPL选择与调度消融,须同时看成功和人工干预。核对原文。
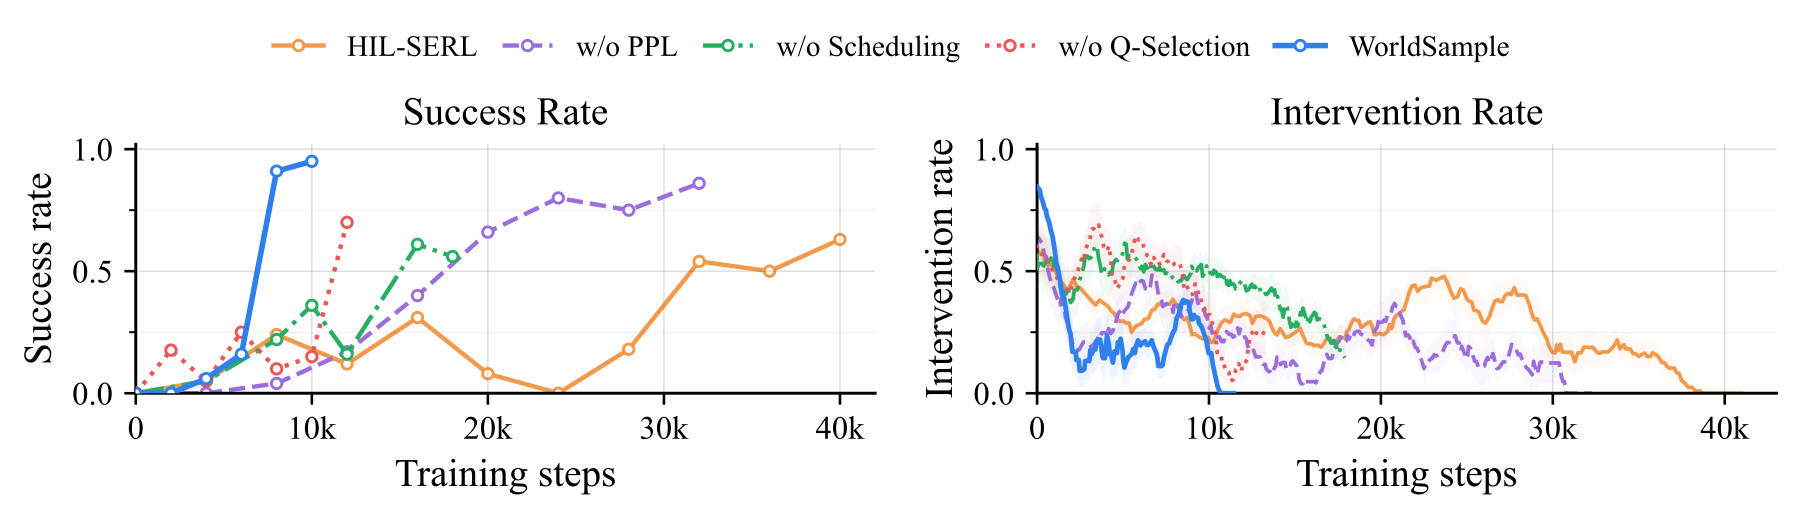
读图提示:左图为成功率,右图为人工干预率,保留全部消融曲线。两种指标需在同一训练步比较,不能把较早停止的高成功曲线直接视为同预算全面胜出。
共同示范、额外合成数据与摘要口径
实验控制相同机器人、观察、动作、奖励与干预协议,并以20条人类示范初始化;个别基线还使用额外合成示范,比较时需保留该差异。表中成功率、真实训练步数和分钟是不同指标,摘要百分比与主表归约口径存在需要核对的差别,因此本文不把所有提升压成一个倍数。PSNR/SSIM改善支持视频质量变化,不能独立证明动力学或奖励标签可靠。
五、熵调度不是误差保证,摘要口径仍需澄清
模型偏差与熵的近似关系不是误差消失定理。奖励模型与视频模型也可能共同偏离物理成功。
表内均值自算:成功率绝对差26个百分点、相对56约46.4%;真实步数降(56−23)/56≈58.9%,时间降(83−64)/83≈22.9%。摘要约28%及部分正文标签无法由这些数直接复原,仍需原始口径。预训练、示范和人工介入必须计入资源,不能称为零监督或全流程净成本收益。
六、三个值得继续追问的问题与参考答案
1. 低熵能否可靠预测合成样本误差?
不能直接。Actor低熵只表示策略集中,可能对错误动作高度自信,且不测世界模型的物理误差。应在保留的真实轨迹上检验熵与合成转移误差、接触违规和真实回报差的校准关系,并按任务与训练阶段分层。若低熵区域仍错误,需独立模型不确定性或真实验证约束;熵调度有效不等于熵已成为可靠误差估计。
2. 计入全部生成与人工干预后节省多少成本?
目前只能据原表明确真实步数和所报时间口径,不能给出包含所有生成与人工劳动的净节省。完整成本应含世界模型预训练/微调、合成视频生成、策略训练、真实机器人运行、接管与重置的人时。56K→23K与83→64分钟分别对应不同量,后者约22.9%下降,不能改称GPU或全流程成本;需作者日志补齐后再比较。
3. 表1与摘要差异来自何种加权或评估口径?
表内均值给出成功率56%→82%、真实步数56K→23K、时间83→64分钟,其简单差值与比例不能直接复原摘要约28%的说法。可能涉及按任务平均相对变化、加权、不同子集或另一预算,但这些只是待检验解释。应要求逐任务分子分母和聚合公式,并复算“先平均后求比”与“先求比后平均”;没有该证据就保留不一致,而不任选一种解释。
七、沿未解决的问题继续读
MBDPO:合成目标有误时,能否先限制策略离开行为支持?回看MBDPO可比较生成分布端与Critic数据端的干预,二者是平行路线,不是本文后继算法。(平行机制对照)
系列收尾:节省的真实步数能否抵消视频生成、模型训练和人工接管?收尾篇的统一账本继续核算这项未闭合问题,是教学归纳而非新的方法结论。(教学收束)
原文核对与路线出处
- 原论文与图表入口。PPL式4—9、实验控制协议、主结果表及附录线性熵调度和30%上限。
- 并行路线:MBPO。同样权衡模型经验与真实经验,但短rollout控制和视频合成筛样不是同一机制。
- 并行路线:MBDPO。MBDPO改策略分布优化,WorldSample重点改合成经验进入critic的方式。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么不能把世界模型生成的轨迹直接当成真实经验?
参考答案:合成轨迹可能存在动力学错误,奖励标签也可能错误,它们会通过 TD 更新污染 Critic。WorldSample 用 Q 感知的样本选择和策略熵相关调度,控制哪些合成经验参与训练以及参与程度。原文方法
问题 2:策略熵低,是否说明合成经验可靠?
参考答案:不说明。低熵只表示策略动作更集中,也可能是自信地犯错。它作为调度信号是一种启发式,不能替代模型误差测量。评估收益还应计入生成时间、模型训练、示范与人工干预,而不仅是真实交互步数。