第 44 天|Decision Transformer:把控制写成条件序列预测
原论文与版本:Decision Transformer: Reinforcement Learning via Sequence Modeling,2021。原论文。
先接住前作的问题
第42天 CQL继续使用Bellman自举,只是修正陌生动作的乐观Q;第43天 AWAC则用Critic优势筛选值得模仿的数据动作。它们共同留下一个更激进的问题:离线策略一定要先学价值吗?Decision Transformer改用回报条件下的动作序列预测,与这些价值方法平行,而不是由AWAC逐步删去Critic得到的历史继承。
五个前置概念
- Return-to-go:从当前时刻到终局的剩余奖励和。
- 因果mask:禁止模型读取未来信息。
- 条件模仿:在特定回报等条件下拟合行为。
- 上下文窗口:模型保留的历史长度。
- 行为分布支持:训练数据中可见的动作与结果。
一、问题设定:不学Bellman价值能否直接生成好动作
固定数据含有好坏不同的轨迹。直接行为克隆会把它们混在一起,价值方法则需要依赖自举目标;本篇尝试把“希望得到多少回报”作为输入,让同一序列模型根据历史和目标生成动作。
训练时剩余回报来自已完成轨迹,执行时却只是提出的目标。因而研究问题有两面:条件序列监督能否学出有效控制,以及请求的回报在真实环境中究竟能实现多少。没有Bellman误差,并不等于没有数据分布之外的请求。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 离线、回报条件的序列建模控制 |
| 状态/观测 | 状态历史+目标return-to-go |
| 动作 | 离散分类或连续动作回归 |
| 奖励或学习信号 | 训练RTG由数据未来奖励计算 |
| 终止/边界 | 回合边界与上下文窗口独立处理 |
二、把剩余回报放进因果序列,并推清执行递推
训练序列交替包含RTG、状态和动作,因果mask使动作预测只看到过去动作与当前状态。部署时的输入来源与递推在下式中分别说明。
动作监督损失不直接做Bellman备份;长上下文可区分同一观测下的不同历史,回报条件则可从混合质量数据中选择行为模式。
RTG递推与因果输入的边界
训练动作MSE或交叉熵;执行无折扣RTG时 。折扣版本需改递推。
因果预测的输入边界: 在训练中是从当前时刻到轨迹终点的实际奖励和,部署时则是希望获得的剩余回报;同一记号在两个阶段的来源不同。 明确排除要预测的 ,否则网络会复制标签而不是学决策。无折扣递推直接来自 ;若改成以当前步为基准的折扣回报,才需使用 (),并让训练标签与部署更新一致。这是递推的教学推导,原文DT采用无折扣形式,见§3。
区分剩余目标与状态价值估计
扣除已得奖励只更新“还要求多少”的目标账本,并没有调用Critic重估“当前还能拿到多少”。即使环境转移使原目标已不可达,递推仍会给出一个数;因此执行日志应分别记录请求目标与实际完成回报。
剩余目标10、8、5与不可控硬币
以下是可手算的教学构造,不是论文实验。
希望总回报10,前两步实际收到2和3,则输入RTG依次10、8、5。若每一步仍给10,就是反复要求“从现在再拿10”,条件序列不再符合训练递推。
再考虑掷硬币奖励与动作无关的任务:成功轨迹RTG=1,失败=0。模型可完美学习两类序列的统计特征,却无法因条件为1就让硬币必胜。这说明回报条件建模本身不是可达性证明。
三、生成RTG标签、遮住未来动作并滚动更新目标
从离线完整轨迹反向计算RTG
抽长度K片段,构造RTG/状态/动作tokens
加时序编码,使用因果attention mask
从状态位置预测对应动作,最小化监督损失
部署:
  指定初始目标RTG
  基于历史预测并执行动作
  观察实际r,目标RTG←RTG-r
  更新上下文窗口直到终止
输出:回报条件策略
四、读图4的请求—实得关系,再看延迟奖励实验
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 4 Atari、D4RL控制、Minigrid等 |
| 数据来源与规模 | Atari用DQN-replay的1%,约500k转移 |
| 对比基线 | CQL、BC及其他离线基线 |
| 训练预算与资源 | 训练更新与数据比例分开;无新增训练交互 |
| 指标及其含义 | 归一化回报、不同目标RTG效果 |
| 随机性与不确定性 | 主要任务3种子;文字与表对离散度称呼需逐项核实 |
| 实际验证的假设 | 序列监督能否替代TD提供有效控制 |
图4:请求回报并不总能兑现
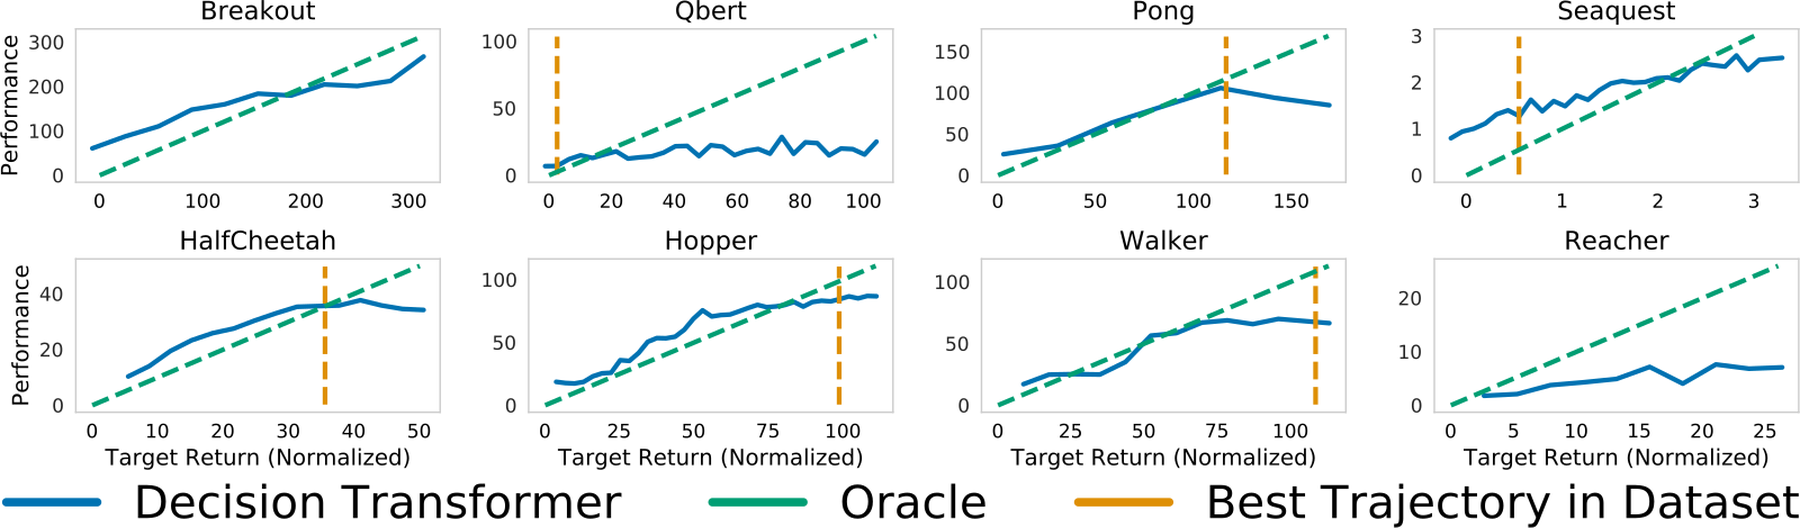
图4每个面板横轴是请求的归一化目标回报,纵轴是实际获得的归一化表现;这不是训练时间曲线。绿色斜虚线是“实际恰好实现请求”的理想参照,橙色竖虚线是数据集中最好轨迹的回报,蓝线是DT。Pong在较高请求区域回落、Qbert与Reacher未跟随理想线,说明条件数值能调行为却不能提供无限可达性;还要区分“超过数据最佳”的区域与普通插值区域。
图1展示RTG、状态与动作的因果排列。Atari与D4RL表格检验特定离线数据上的控制表现;请求—实得关系已由上面的图4单独检验,不能用训练损失替代这一评价。
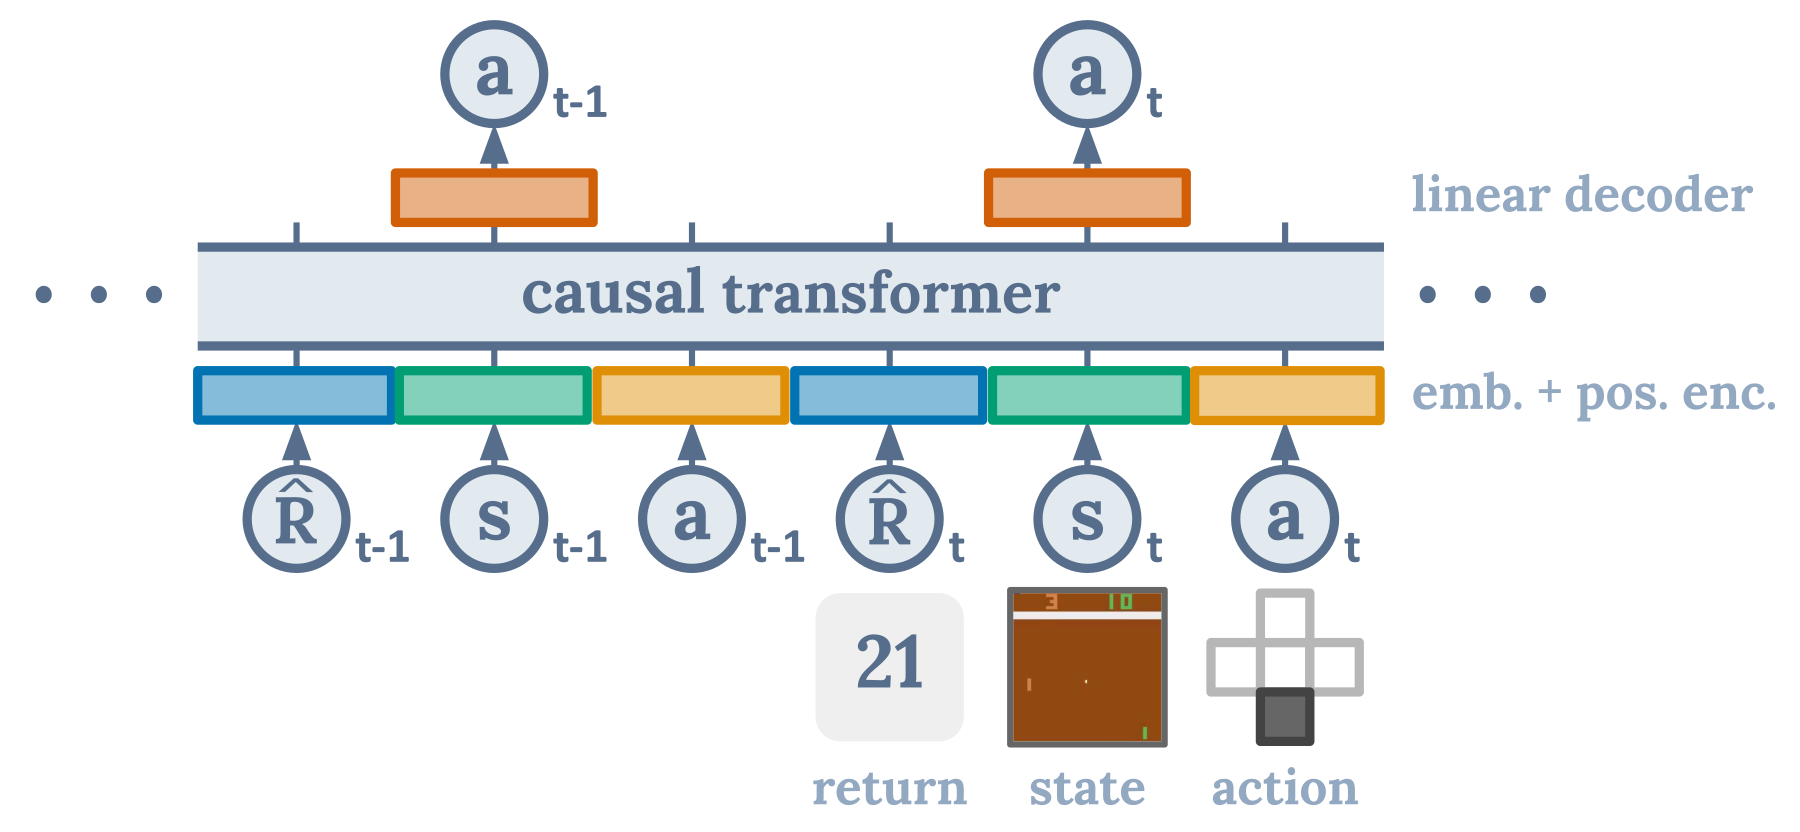
读图提示:序列中回报目标、状态、动作先分别嵌入,再经因果注意力预测后续动作。回报目标是条件输入,不能仅由这个结构保证能达到任意指定回报。
延迟奖励与图任务没有证明一般稀疏探索
表7把Hopper奖励全部延迟到最后,DT及模仿方法相对稳健,说明无需逐步TD传播的一项优势,但不证明已解决一般稀疏探索。主Atari基线有直接引用其他论文的数值;附录图最短路另有特定数据和回报生成机制,不能推广为任意跨轨迹拼接保证。
五、高回报条件不能替代可达性与轨迹覆盖
请求超过数据支持的RTG会进入分布外,不能靠不断提高输入目标补出缺失行为。无TD损失绕开了一类自举高估,却没有消除随机环境中的回报关联与可控性差别;若用测试成绩选择目标RTG,还必须计入模型选择权限。
六、三个值得继续追问的问题与参考答案
1. RTG调参会怎样影响公平比较?
RTG 是部署时的行为条件,试许多目标回报后挑最高测试分,相当于额外模型选择。应在训练/验证数据上预先确定目标或固定调度,并给所有方法相同调参预算,报告对RTG的敏感性和失败请求。超出训练支持的高RTG不保证更好,且不同数据集的回报尺度不同,不能用一个未经说明的目标值比较。
2. 未来奖励条件是否可能携带不可控随机性?
可能。实际回报由动作和环境随机性共同决定;用高回报轨迹做条件学习,会筛选到“运气好”的样本,模型可能把不可控结果误当作能靠动作实现。确定性或随机性较小环境弱化该问题,不能推广到任意随机MDP。应在重复相同动作的受控随机环境中比较条件回报与真实达成分布,识别选择偏差。
3. 何种任务需要TD式拼接而序列BC做不到?
当数据含通向中间状态的前半段和从该状态通向目标的后半段,但没有一条完整高回报轨迹时,Bellman备份可以在马尔可夫覆盖条件下传播并拼接价值。朴素条件序列模仿没有显式备份机制,若所需上下文组合不在数据中,未必学会连接。Transformer有可能通过结构泛化解决部分图任务,所以应把它表述为条件和实证问题,而不是绝对不能拼接。
七、沿未解决的问题继续读
IQL:当没有完整高回报轨迹、只有可连接的片段时,价值传播能提供什么?IQL的toy maze提供数据内拼接对照,是后续价值路线,与条件序列建模并行。(后续平行路线)
TD3+BC:条件Transformer的收益是否需要复杂模型,还是简单价值加模仿也有竞争力?同期TD3+BC提供简洁基线,比较首先要统一D4RL版本与调参预算。(同期并行路线)
原文核对与路线出处
- 原论文与图表入口。§3序列与训练;§5.6表7;附录回报条件与图任务。
- 并行路线:CQL。同为离线决策,DT改为条件序列监督而非保守TD。
- 并行路线:TD3+BC。同期以简洁价值加模仿基线检验不同方法复杂度的必要性。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:目标剩余回报在训练和执行时分别怎么获得?
参考答案:训练时从已有轨迹计算真实 return-to-go;执行时人为指定期望回报,并随实际奖励更新剩余目标。模型学习在历史与回报条件下预测动作,因此可以通过不同条件请求不同水平的行为。
问题 2:把目标回报设成 10000,为什么不会自动得到超强策略?
参考答案:模型只学到了数据覆盖下的条件关系。极高目标可能落到训练分布之外,环境也未必允许实现。条件输入表达愿望,不提供新的行为证据;数据中轨迹能否被有效组合也不能自动保证。