第 43 天|AWAC:先用旧数据起步,再顺利接入在线学习
原论文与版本:AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,2020。原论文。
先接住前作的问题
第30天 SAC的离策略Critic能持续利用回放,但直接从离线数据起步仍可能查询不可靠的新动作。第42天 CQL选择在价值端保持保守,另一项尚未解决的任务是:上线后,怎样既保留旧数据的帮助,又适应不断进入回放的新经验?AWAC在Actor端采用优势加权回归,是离线到在线的并行方案,不是给CQL直接追加一个阶段。
五个前置概念
- 在线微调:预训练后继续真实交互学习。
- 优势加权回归:按价值优势分配模仿权重。
- 行为模型:显式描述数据动作分布。
- 温度λ:控制权重集中程度。
- 初期退化:从离线转在线后表现短暂下降。
一、问题设定:离线起步怎样平滑接入在线学习
任务分成两个数据权限不同的阶段:起初只能读已有轨迹,随后可以继续与环境或机器人交互。评价目标因此不只有最后的回报,还包括离线起点是否可靠、刚上线是否掉分,以及新增真实交互多久才产生改善。
强行为约束能保护离线阶段,却可能拖慢在线适应;完全放开策略又可能马上利用Critic误差。AWAC要让Actor继续从数据动作学习,同时用优势改变每个动作的模仿强度,使旧数据与新数据能够进入同一个训练接口。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 离线初始化加在线微调,Actor–Critic |
| 状态/观测 | 状态/机器人观测 |
| 动作 | 连续动作 |
| 奖励或学习信号 | 任务奖励,旧新数据都需一致 |
| 终止/边界 | 按任务边界 |
二、把KL约束的策略改进投影成加权回归
从KL驻点推到指数优势权重
A=Q−V,λ控制权重集中程度;实际大权重常需数值处理。论文从分布约束推导回归形式。
指数权重为何出现:固定状态,最大化期望优势并扣除 ,再加概率和为1的约束;对每个动作概率求驻点,得到 ,所以最优分布正比于行为概率乘指数优势。投影时就把这些比值当成模仿权重。要注意 是各状态自己的归一化常数,上面的实用回归式省略了它;这保持同状态动作间的相对权重,却会改变不同状态的相对训练权重,不能说两种目标无条件完全相同。见原文策略改进推导及附录A的归一化讨论。
写成 后,行为分布通过数据采样进入加权回归,不需再拟合一个上线后不断过时的β网络。
指数优势权重的比值更直接说明选择性
同状态两个数据动作优势分别为 ,未裁剪权重之比为 。共同减去同一状态基线不改这个比值,却影响不同状态样本的整体尺度;有限批次归一化还需按实现核对。
两条数据动作怎样获得不同模仿强度
以下是可手算的教学构造,不是论文实验。
某状态数据动作A、B各一条,估计优势为0和2,λ=1。加权似然权重为1与e²≈7.39,归一化后约(0.119,0.881),于是策略更偏B而非各一半。
如果B的高优势来自Critic误差,同一指数机制也会放大错误。把λ增到2,B权重比例降为e≈2.72,改进更温和,却也更难利用真正好的罕见动作。
三、混合旧新回放并持续更新Actor与Critic
stop_gradient 表示停止向目标量传播梯度。
用先验数据初始化replay
先进行若干离线更新
循环离线/在线阶段:
  抽replay转移,更新TD Critic
  估计数据动作优势Q(s,a)-V(s)
  权重←stop_gradient(exp(A/λ))
  Actor最大化加权数据动作log概率
  在线阶段用Actor交互并加入新数据
输出:可继续在线改善的策略
四、沿图3的上线边界读初期退化与后续进步
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 模拟控制与真实机器人操作 |
| 数据来源与规模 | 先验RL轨迹/示范+新在线交互 |
| 对比基线 | SAC、BC初始化及其他离线到在线方法 |
| 训练预算与资源 | 旧数据量与新增环境步数必须分开 |
| 指标及其含义 | 回报、操作成功率、微调初期退化 |
| 随机性与不确定性 | 完整重复次数与预算本文未核实 |
| 实际验证的假设 | 先验数据能否转化为快速在线进步 |
图3:上线退化与行为模型失配各看哪个面板
原引用定位:原文。
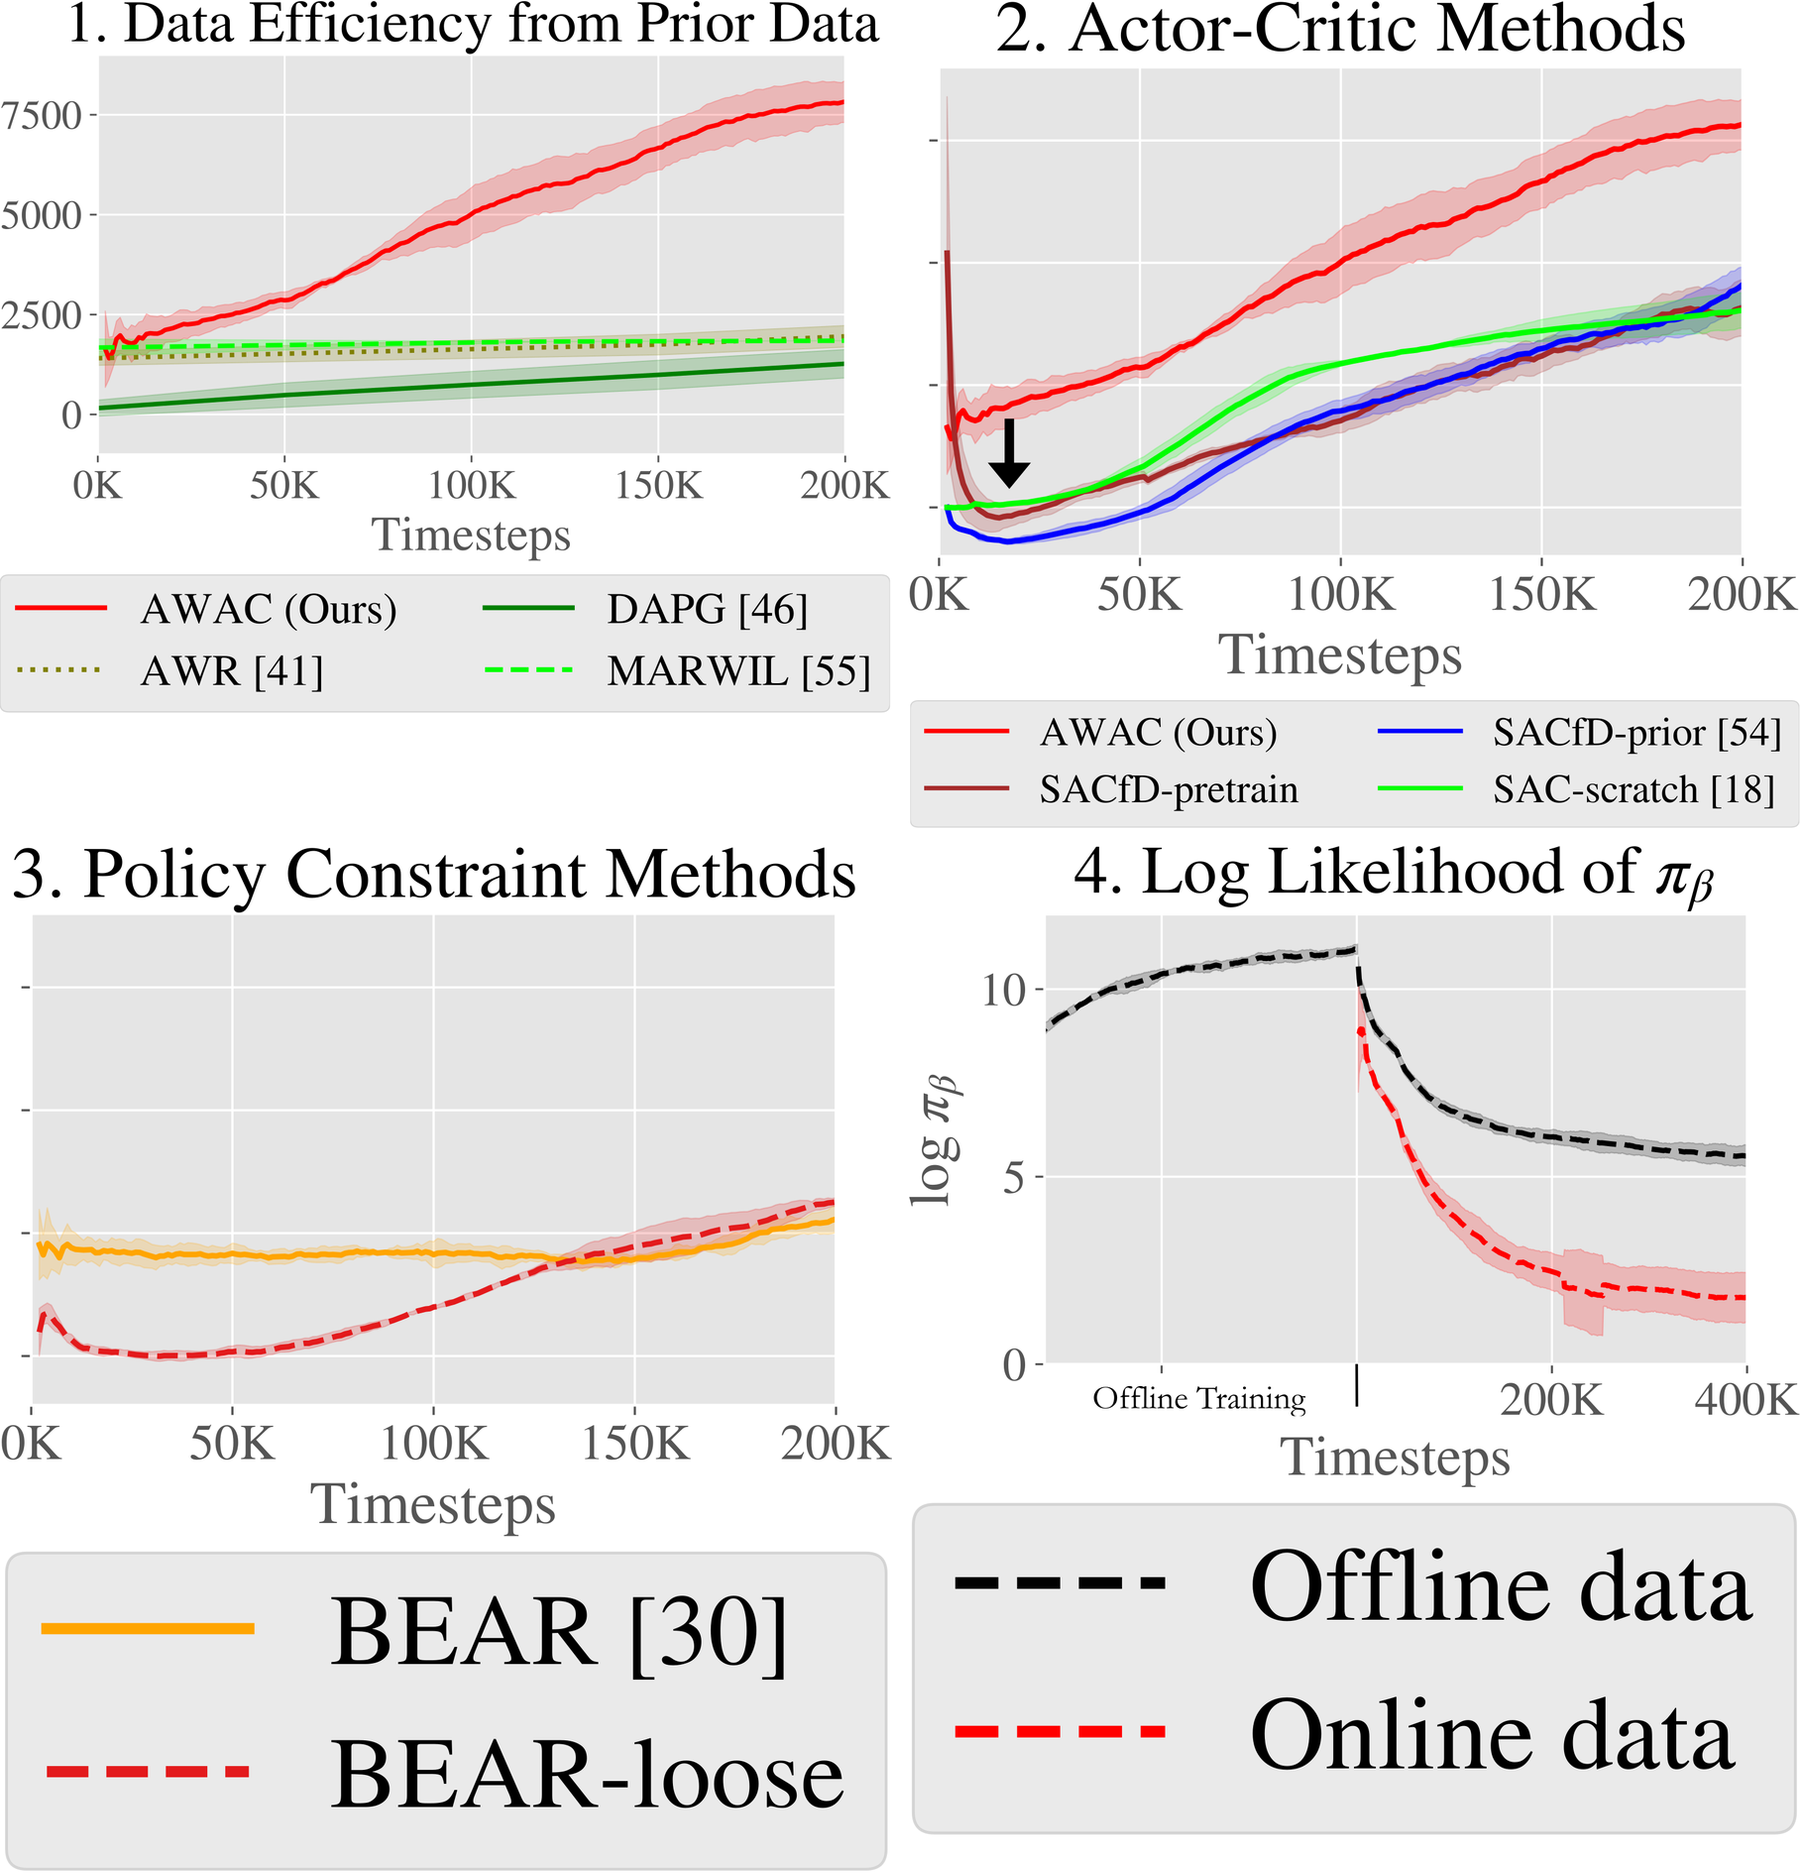
前三个面板的横轴是在线环境步数,纵轴是平均回报,分别比较利用旧数据、Actor–Critic和显式策略约束的方法。第二面板箭头标出的上线初期下跌,说明高预训练分不保证平滑衔接。第四面板改画行为模型对离线/在线数据的对数似然,虚线分界前后对应离线训练与在线阶段;似然下降支持“行为模型追不上新分布”的诊断,不是策略回报又下降了同样数值。
真实机器人还要计入先验数据、奖励与重置
图2画清先用历史数据、再在线微调的两阶段权限。真实机器人还依赖奖励、先验数据与环境重置,评价应同时报告离线数据来源、预训练计算和新增真实交互,而不是只数在线分钟。
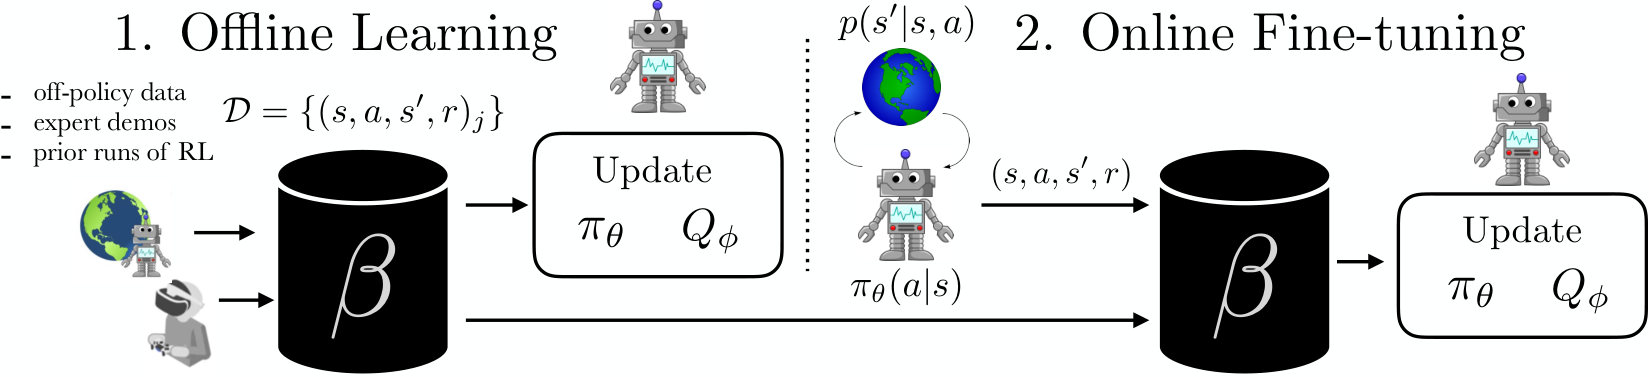
读图提示:左半是既有数据上的离线学习,右半加入新交互做在线微调。沿数据进入缓存的箭头区分两个阶段,不把在线改善全算作离线学习收益。
五、Actor贴近数据,Critic仍可能查询陌生动作
Critic仍会查询当前策略的后继动作,并非IQL式全程仅评价数据动作。指数优势会放大估值误差,λ过小可让极少数样本支配更新;在线数据加入后,隐含行为约束也随之改变。因此旧数据、奖励与新交互带来的收益,应和Actor更新本身分开。
六、三个值得继续追问的问题与参考答案
1. Q误差如何经指数权重放大?
权重约为 ,优势误差 会把权重乘上 ;温度越小,误差放大越明显,少数错误高值样本可能主导拟合。应报告权重分布、有效样本量、裁剪或归一化规则,并检验Q误差与动作覆盖。裁剪改善稳定性,但改变理想优化目标,不能继续称为精确指数更新。
2. 旧数据和新数据比例如何影响适应?
旧数据保留已有技能和覆盖,过多时可能拖慢向新分布适应;新数据改善当前策略区域的评价,但早期质量差或覆盖窄时可能造成遗忘。比例还与采样方式、更新次数及奖励分布相互作用。应固定总梯度预算对比混合比例,分别测旧任务保持、新任务进展和初期性能下跌,不只看最终检查点。
3. 与IQL的Critic目标为什么不同?
AWAC 通常仍以当前策略在下一状态的动作构造离策略Q目标,因而可能查询数据支持外的动作;其主要约束在优势加权的Actor回归。IQL 先对数据动作Q做上分位 expectile 聚合得到V,再用 更新Q,避免在该评价目标中查询新动作。两者Actor形式相近并不意味着Critic相同;IQL部署策略仍可能外推。
七、沿未解决的问题继续读
IQL:能否保留优势加权的策略提取,却不让Actor提出的未知动作进入Q目标?IQL正是在价值学习端另建expectile与V回归,Actor相似不代表整套算法相同。(后作延续策略提取接口)
WorldSample:机器人仍要付出真实试错成本时,新增经验能否部分来自模型?WorldSample筛选和调度合成转移,是后续数据来源问题的对照,不是AWAC的直接继承。(教学与应用问题对照)
原文核对与路线出处
- 原论文与图表入口。优势加权更新与离线/在线设定;图3衔接分析。
- 历史背景:SAC。共享off-policy价值学习背景,Actor改为优势加权数据回归。
- 后作承接本篇:IQL。后作也可使用优势加权策略提取,但Critic与V训练另有改变。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么对行为克隆样本按优势加权?
参考答案:不是所有旧动作都同样值得模仿。优势衡量动作相对该状态基准的好坏,AWAC 用类似指数优势权重的方式,更强地拟合较好动作。这样既利用现有动作支持,又能偏向数据中的优质行为。
问题 2:为什么优势加权可能把错误放大?
参考答案:优势来自 Critic。如果某个坏动作被高估,指数权重可能让它主导更新。离线到在线的转换还会改变数据分布,需要新经验持续修正价值;加权模仿本身不能保证估值正确。