第 60 天|DRACO:没有成功验证器时,如何把评分准则分配到步骤
原论文与版本:Gandhi 等,DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training,2026-09-03。正文。
先接住前作的问题
第52天 GRPO需要可比较的组奖励;长工具任务若没有训练时成功检查器,奖励从哪里来?DRACO先用动态准则judge产生反馈,再重分步骤信用。第58天 FACTOR以续跑价值做细粒度归因,是平行对照而非本篇的直接前身。第59天 TTPO同样面对标签不足,但多数伪答案与外部judge是不同监督来源。
五个前置概念
- Rubric:可逐项检查的评价准则。
- Outcome-blind:训练不访问真实任务成功答案。
- 步骤引用:judge指出判断相关的轨迹步骤。
- 保符号重分配:只改信用大小,不翻转原有符号。
- Pass^k:多次执行全部成功的一致性指标。
一、问题设定:没有成功验证器怎样给工具步骤分信用
任务指令、轨迹和工具反馈可见,真实成功检查器只用于独立评价,不能进入训练。固定的一套准则可能很快饱和,整轨迹分数又无法告诉策略哪些工具步骤应承担更多更新。
DRACO的研究问题由此分两层:怎样动态形成仍有区分度的评分准则,以及怎样把得到的组优势分给步骤。judge是额外训练监督;保留总信用和符号则只是分配约束,都不能直接替代真实成功或因果归因。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | outcome-blind多轮Agent GRPO |
| 状态/观测 | 任务指令、对话与工具反馈历史 |
| 动作 | 可执行工具/代码步骤中的token |
| 奖励或学习信号 | 动态rubric通过/失败汇总,训练不读取真成功检查器 |
| 终止/边界 | AppWorld最多50轮、τ-bench100轮 |
二、先由动态准则评分,再按步骤质量分配总信用
DRACO先改奖励来源,再改奖励落点。冻结judge根据任务指令和同组轨迹提出准则,合并去重,仅保留至少被某条轨迹违反的条目;逐轨迹给pass/fail/not applicable,并引用相关步骤。训练无需真成功检查器,但仍依赖judge的额外监督,不能称为无监督或零成本。
先定义整轨迹计数,再定义被引用步骤的质量
分别是整条轨迹适用准则中pass与fail的数量,not applicable不进入分母; 则只统计引用第 步的准则判断。轨迹净通过率与局部通过率为
无适用准则时令R=0;未被引用的步骤继承已引用步骤的平均质量。对同任务组奖励归一化后得到轨迹优势 ,其正负表示组内相对好坏,不等同于真实任务成功与失败。 是judge通过率,不是Bellman动作价值。
令 为第 步的有效token数,;不属于可训练步骤的gap token不计入N。正优势轨迹用 ,负优势轨迹用 ,使较应承担当前更新的步骤取得较大份额。先将总信用 按 分给步骤,再除以该步长度,得到每token系数
这里守恒来自份额相加为1,而不是价值或judge一定正确。等步骤权重只保证各步总量相等,短步骤分给每个token的系数会更大;非负权重也使负优势轨迹中的好步骤只能少受罚,不能转成正奖励。该标量记账不保证参数梯度或反事实因果正确。见附录E.7—E.9。
静态准则饱和与零分母是两种不同退化
所有引用判断相同时,步骤质量失去区分,等权分配仍让每token系数随 变化;只有权重和为零或整条轨迹没有引用时,才回退统一优势 。因此“静态准则饱和”不能一概写成“每token已与普通GRPO完全相同”。
两步长度下的正负信用与回退
以下是可手算的教学构造,不是论文实验。
一条正优势A=1的轨迹有两个步骤,长度2与6,质量0.75与0.25。N=8,权重和1,故每token系数分别为3与1/3;总系数2×3+6×(1/3)=8,等于原统一系数的8。
若A=−1,权重变为0.25与0.75,每token系数均为−1,此处长度恰抵消质量差。所有系数仍非正,不会把好步骤转成奖励。若正优势轨迹所有q均为0,则权重和为0,必须回退统一A,不能直接应用归一化公式。
三、合并准则、引用步骤并处理所有退化分母
两步长的例子区分了步骤总量与token系数;实现还须明确未引用步骤、gap token和零分母各走哪条规则。
同任务采G条多轮轨迹
judge从指令与轨迹提出rubrics,合并去重
过滤规定的无区分准则,逐条评价并引用步骤
按通过/失败数计算轨迹R;无适用准则按原文退化
组内规范化得到A
每步由引用准则计算q;未引用步按附录填补规则
按A符号选w,再以步长和总长度归一a_j
遇零分母按附录回退,不直接除零
仅在规定的可训练动作token广播a_j,做GRPO更新
独立评估使用真实任务检查器
四、读任务表现—评价成本图,并分清重复评估口径
守恒公式可以直接验算,任务收益则要放在同一split、基座和评价预算下读,不能把美元横轴当完整训练成本。
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | AppWorld90训练任务;测试168普通/417挑战;τ-bench97 |
| 数据来源与规模 | 在线工具轨迹、冻结judge评价 |
| 对比基线 | 基座、相同预算真结果奖励、静态rubric/无信用消融 |
| 训练预算与资源 | Qwen3.6-27B100步/20epochs;32B75步;8H100、LoRA;judge成本另计 |
| 指标及其含义 | TGC、SGC、SR与重复执行可靠性 |
| 随机性与不确定性 | 最后3个检查点平均,每检查点3评估运行,不等于3训练种子 |
| 实际验证的假设 | 动态准则与步骤分配能否在无真训练标签下改善Agent |
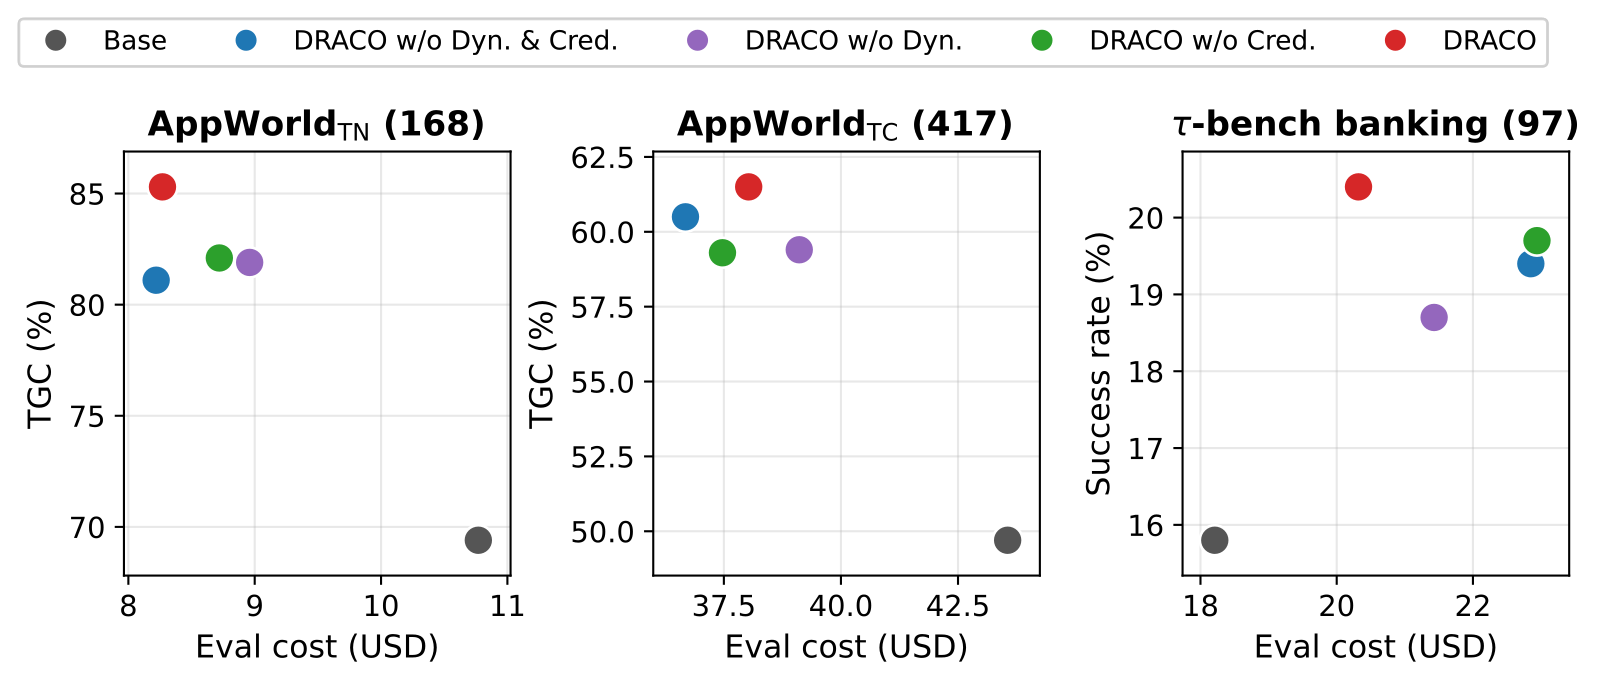
图2:任务表现与一次完整评价的美元成本
图像许可:上述作者原图按 CC BY 4.0 提供;此处只截取对应图形区域并适配显示尺寸,数据与图形内容未重绘。核对原版许可。
图2三面板分别是AppWorld普通集、挑战集和τ-bench banking;前两图纵轴为TGC,后一图为成功率。灰点是基座,蓝/紫/绿点分别移除两组件、动态准则或步骤信用,红点是完整DRACO。应在同一面板寻找左上方的成本—表现折中;τ-bench成本还含用户模拟器和评审调用,不能把三张横轴的美元数简单当成同数量任务的推理单价。图中各点使用单次成功口径。
表2按同基座和split比较主结果与消融,部分指标并不单调。主结果取最后三个检查点,每个检查点重复评估三次;这是评估重复,不是三次独立训练,也不同于TTPO的峰值检查点选择。训练不用真实成功检查器,独立评估可以使用,权限并不冲突。重复可靠性指标pass^k要求k次都成功,与pass@k的至少一次成功不同。图2横轴是一次完整split的评估成本,不是完整训练成本。核对原文评价协议。
五、judge偏差、同号分配与训练成本尚未闭合
普通AppWorld的TGC相对基座提高15.9个百分点,相对结果奖励基线提高5.3个百分点。τ-bench常规judge与self-judge是不同配置,不能拼取各自最好值。动态rubric可能漂移或偏爱风格,步骤引用也不是因果证据;全流程成本还需计入judge的准则生成、去重与评分。
六、三个值得继续追问的问题与参考答案
1. judge偏好与真实成功偏离时如何诊断?
把judge分数与独立任务成功、工具状态检查和人工审计并列,按任务/准则画校准与误判分布;用固定保留rubric给不同训练阶段重评分,避免动态规则变化掩盖漂移。再检查长输出、迎合措辞和无效步骤是否被奖励。分数上升而成功率不升说明代理可能偏离;更强judge或self-judge对照也必须固定其他条件与成本。
2. 负轨迹中的真正好步骤是否需要允许正优势?
从细粒度归因角度,失败轨迹里确实可能含有值得保留的好步骤;但是否给正优势取决于目标和反事实基线,不能仅凭局部文本看起来好就翻转符号。原配方的步骤分配受轨迹信用设计约束,允许异号会改变守恒与优化性质。可构造“局部正确、后续失败”任务,用可靠反事实评估比较同号分配与异号改进,原结果不能替代这项消融。
3. 计入judge调用后与真奖励训练的成本差多少?
需分别比较训练judge的准则生成/去重/评分调用、策略生成与更新、真实环境或结果验证成本,以及部署评估成本。论文性能-评价成本图并不直接等于完整训练成本;外部judge与self-judge也不是同一价格与监督质量。只有固定成功目标、模型与总预算并获得全流程日志,才能给净差值;现有条件不足时应列明缺项而不把judge视为免费。
七、沿未解决的问题继续读
系列收尾:更细的奖励究竟来自更可靠归因,还是更多judge信息与计算?收尾篇以监督、权限和成本账本总结这一未闭合问题,不宣称已有新的直接后继算法。(教学收束)
FACTOR:如果能取得独立续跑价值,步骤引用是否与它一致?回看FACTOR的校准与扰动诊断,可设计平行比较;标量守恒的两套公式不提供相同因果保证。(早期平行路线回看)
TTPO:不同额外监督与检查点选择怎样影响收益可信度?TTPO的伪标签和峰值协议提供邻近问题对照,不能把两套最终分数拼成同一训练系统。(教学对照)
原文核对与路线出处
- 原论文与图表入口。§3动态准则与步骤分配、§4评价协议;附录E.7–E.9等步骤总量、1/n_j token分配及零分母/全无引用回退。
- 模块组合:GRPO。动态rubric产生组奖励,再替换其统一token优势。
- 并行路线:FACTOR。都约束标量总量,但一个用judge步骤引用,一个用续跑TD与动作均值归约。
- 教学对应:TTPO。都借助额外评估信号,然而监督、训练权限和检查点选择协议不同。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:没有训练时成功验证器,DRACO 如何奖励多步骤任务?
参考答案:冻结评审模型依据任务与轨迹生成动态评分准则,评价准则通过情况并引用相关步骤。轨迹评分形成组相对优势,再依据步骤评价重新分配。监督来源从真实成功检查器转向准则评审,因此仍有额外评审能力与成本。原文方法
问题 2:失败轨迹中的正确步骤,为什么可能只少受罚,而不获得正奖励?
参考答案:步骤权重非负,乘以负的轨迹优势后仍然非正。被判较好的步骤可以得到较小负权重,但不会仅靠这次重分配变成正向优势。这保留了轨迹优势的符号,也限制了对“失败过程中的正确局部行为”的独立奖励能力。