第 52 天|DeepSeekMath/GRPO:用同题多回答,替代独立价值基线
原论文与版本:Shao 等,DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models,2024。正文。GRPO 在这篇论文中提出,而非首次出现在 R1。
先接住前作的问题
第27天 PPO用价值函数辅助优势估计,第47天 InstructGPT将其与语言模型奖励训练组合。对同一题已经要生成多个回答时,能否用它们相互比较,省去独立Critic?GRPO在DeepSeekMath中直接改造PPO的优势接口与裁剪目标;它并不由上一篇KTO的单条反馈效用演化而来。
五个前置概念
- 组相对基线:用同题多个回答相互比较。
- 结果奖励:整条回答获得一个终局评分。
- 过程奖励:为中间步骤提供评价。
- Old与Ref:分别对应采样策略与漂移基准。
- 零方差组:所有回答奖励相同的组。
一、问题设定:同题多回答能否替代独立价值基线
数学提示固定后,当前策略可以生成一组回答,并由结果或过程奖励模型评分。这里的成本问题是额外价值模型,统计问题则是如何判断某个回答相对同题其他回答更值得增加概率。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 语言模型数学后训练,组相对策略梯度 |
| 状态/观测 | 数学提示及回答前缀 |
| 动作 | 下一个token |
| 奖励或学习信号 | 原论文含学习到的结果/过程奖励模型 |
| 终止/边界 | EOS或原文生成长度上限 |
二、把同题奖励变成优势,再接回token裁剪目标
对同一问题采G条回答,用组内奖励均值作基线、标准差作尺度,把结果优势广播给该回答的token。原论文仍使用奖励模型,移除独立critic并没有省去评分步骤。
优化端继承PPO的新旧策略token比与裁剪,并额外约束相对参考策略的偏离。原版结果监督目标先对每条回答按长度平均,再对组平均;这给长短回答不同的单token系数,后来DAPO和Dr. GRPO会分别调整。原文迭代算法还可在外层更新参考策略,因此π_ref不能永远机械地解释为最初SFT模型。
新旧概率比、参考KL与两层平均
数值实现必须处理std为零;旧策略概率用于ρ,参考策略用于KL。它们可在外层流程更新,但角色不可混用。
先看概率比作用在哪个对象上: 比较同一token、同一前缀在新旧策略下的概率;clip简写为截到 。当 ,超过上限后这条代理项不再奖励继续提高概率;当 ,低于下限后不再奖励继续压低概率。它不是把整个策略投影到此区间。 是同题回答数, 是该回答有效token数,原式两层平均决定每个token的系数;与参考策略的KL是另一个约束对象。可对照原文§4.1式3—4。
组标准化对奖励平移和缩放的响应不同于固定尺度
同题奖励统一加常数,中心化优势不变;统一乘正数,在忽略数值保护时标准化优势也不变。这说明组标准差同时抹去该组绝对奖励尺度,而去掉标准差后尺度会重新影响更新大小。
全同奖励组与长短回答的系数
以下是可手算的教学构造,不是论文实验。
同题四条回答奖励(0,0,1,1),按总体标准差计算,均值0.5、标准差0.5,优势为(−1,−1,1,1)。若全部变为(1,1,1,1),有ε保护时优势全为0:绝对正确并不产生同组比较信号。
再令两个正优势回答长度分别2和8,原版先按回答平均,则每个token的未裁剪系数分别为1/2和1/8,短回答token获得4倍权重。两条回答的总系数一样,但神经网络每token的梯度方向不同,不能据此说参数更新也一样。
三、冻结采样策略、处理零方差并按回答归约
固定本轮参考、奖励模型;冻结π_old
对每个提示从π_old采G条回答
给每条回答评分;计算组均值和标准差
若标准差为零:按实现置相对优势为0
否则A_i←(r_i-均值)/(std+数值保护)
对有效回答token广播A_i(结果监督版)
按每回答平均的裁剪目标减KL更新策略
按原文外层流程更新数据/RM等
输出:数学策略
注:过程奖励版需另外构造逐步优势
四、用表5重绘隔离SFT到RL阶段的增量
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | GSM8K、MATH等数学评价 |
| 数据来源与规模 | RL约144k问题;前置预训练/SFT数据另计 |
| 对比基线 | 基座、SFT、GRPO与不同监督设置 |
| 训练预算与资源 | 原文每题64回答,最大1024token;lr约1e-6,KL系数0.04 |
| 指标及其含义 | 无工具数学正确率与有工具设定分开 |
| 随机性与不确定性 | 训练种子、评价采样与问题数不可混淆 |
| 实际验证的假设 | 组基线能否节约Critic并提升SFT策略 |
表5重绘:相同7B系列的无工具正确率
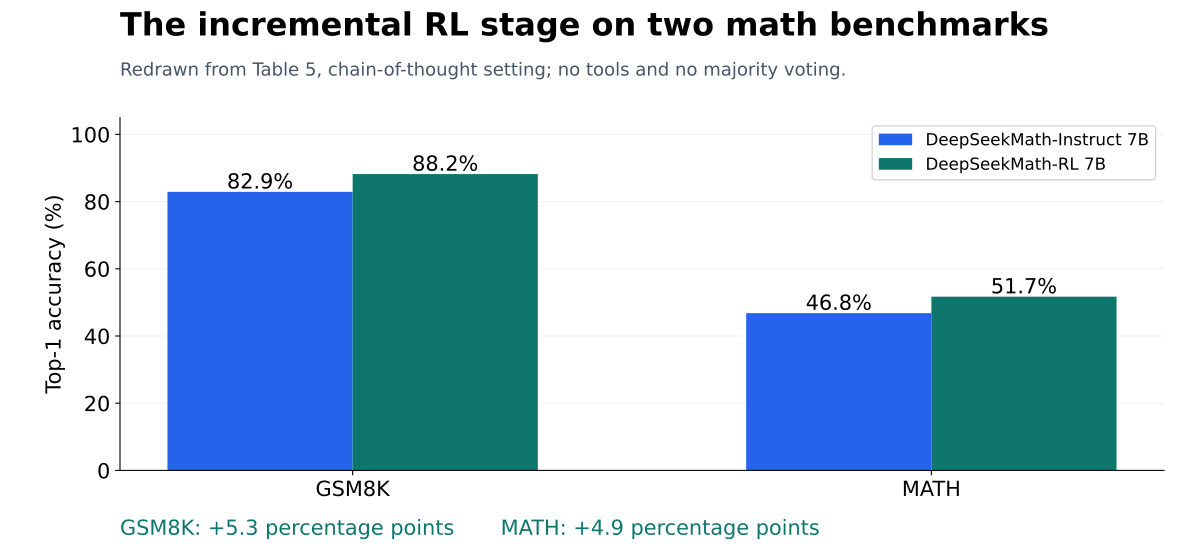
蓝柱与绿柱对照相同7B系列在指令微调及RL阶段后的Top-1正确率,均取表5无工具的Chain-of-Thought行。GSM8K增加5.3个百分点;MATH增加4.9个百分点,相对SFT约为10.5%。这是指定RL阶段的增量,不能把预训练、SFT、外部模型规模或工具使用差异都算给GRPO。原表未在这四项旁提供误差条,因此本图没有自造区间。
迭代RL同时改变数据与奖励模型
迭代RL还改变采样数据与奖励模型,不能只按一次GRPO更新解释前后变化。结果监督、过程监督与迭代训练应作为不同反馈条件阅读,不代表所有奖励设计等价;后来的R1规则奖励也不是2024原论文的唯一设定。
五、组规模、标准差和回答长度仍在改变训练权重
同题全同分时没有相对区分信号,标准差很小时微小奖励差又可能被放大;组均值包含样本自身,不能直接套用动作无关基线的无偏性结论。按回答长度平均改变单token系数,按组标准差缩放改变题目间权重,两者应分别诊断。
六、三个值得继续追问的问题与参考答案
1. 全部答错时怎样获得学习信号?
若同组奖励完全相同,中心化优势为零,单靠该结果奖励项没有区分方向;KL项仍可能更新,但不提供解题正确性的信号。可增加探索或组规模、引入更细的可靠过程反馈、调整任务课程,或保留偶然正确轨迹。任何额外反馈都改变数据与成本条件;不能用加很小的标准差常数声称已从全错组创造学习信息。
2. 组标准差为何改变不同问题权重?
标准化使同一原始奖励差除以该问题组的样本标准差,因而不同问题得到不同梯度尺度;低但非零方差组可能被放大,高方差组被压低。二值奖励时这一尺度与当前成功概率和有限组采样密切相关。应记录组奖励分布、零方差比例与按题梯度贡献,区分方差控制收益和隐含难度重加权。
3. 省Critic后总生成/奖励模型成本是否下降?
省去价值网络可减少其参数、激活、前向和训练开销,但多候选生成与奖励计算仍在,甚至可能占总成本大头。应固定模型、组规模、序列长度和硬件,分别计量生成、RM/验证器、策略更新和显存峰值,再与PPO比较。仅报告Critic参数减少不能推出总token数或总墙钟按同比例下降。
七、沿未解决的问题继续读
DeepSeek-R1:可验证推理奖励与更强基座如何进入完整训练流程?R1使用既有GRPO式更新,另区分直接RL、冷启动多阶段与蒸馏。(后作直接应用)
DAPO:全同组与探索坍缩使有效更新变少时怎么办?DAPO改采样、裁剪、token归约和超长处理,是GRPO的系统改造。(后作方法承接)
Dr. GRPO:标准差与长度分母究竟怎样重加权?Dr. GRPO分别移除这两种归一化,检查它们诱导的训练动态。(后作机制诊断)
原文核对与路线出处
原论文与图表入口。GRPO方法式3—4、结果监督与迭代RL算法。
本篇承接:PPO。本篇保留裁剪策略更新,把独立critic优势换成同题组相对量。
后作承接本篇:R1。后作R1把GRPO式更新用于可验证推理奖励和多阶段训练。
后作承接本篇:DAPO。后作DAPO修改裁剪、筛样与token归约,暴露原版目标的训练动态。
教学阅读:GRPO Trainer。仅借用本节的解释顺序与接口视角;具体算法、版本和实验以本篇原论文为准。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:组内比较怎样替代独立 Critic?
参考答案:同一问题生成多个回答,用组内平均奖励作为相对基准,常见形式为:
这样无需训练独立价值网络来估计基线。但仍需多次生成、计算奖励和更新策略,不能把“没有 Critic”理解为成本很低。
问题 2:一组回答全部正确或全部错误,会发生什么?
参考答案:若奖励完全相同,中心化后的任务优势为零,该组无法提供区分回答的奖励梯度;其他正则项仍可能起作用。如果奖励方差很小,标准化还可能放大细微差异,因此组构成与奖励尺度很重要。