第 54 天|DAPO:GRPO训练中的采样、长度与裁剪,如何一起修正
原论文与版本:Yu 等,DAPO: An Open-Source LLM Reinforcement Learning System at Scale,2025。正文。
先接住前作的问题
第52天 GRPO省去了独立Critic,却保留了对称裁剪、零方差组和逐回答平均;这些环节在长推理训练里会怎样限制学习?DAPO直接改造这套训练系统。它与第53天 R1共同使用组相对思路,但不是把R1的多阶段流程顺序接下去;Dr. GRPO则是同时期检查归一化的另一条路线。
五个前置概念
- Clip-Higher:提高裁剪区间上侧阈值。
- 动态采样:过滤无区分组并继续补采。
- Token级归约:按整体有效token聚合损失。
- 超长惩罚:针对接近或越过生成上限的反馈。
- 熵塌缩:策略分布过早变得过度确定。
一、问题设定:长推理训练的有效信号在哪里丢失
在线数学RL每轮都要生成、评分、筛样并更新。即便名义上都叫GRPO,一次更新中可能只剩很少有区分度的组,策略可能过早确定化,长回答的token也可能因归约被压低权重。
DAPO分别处理探索、有效样本、token权重和生成边界。研究问题是这些修改能否共同改善训练,而不是只把更新步数变少;所有被筛掉的生成和超长样本仍消耗资源。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 在线推理RL,规则奖励,GRPO衍生配方 |
| 状态/观测 | 数学提示与回答token |
| 动作 | token |
| 奖励或学习信号 | 数学正确性及超长相关处理 |
| 终止/边界 | 长度上限/缓冲惩罚区/EOS |
二、拆开裁剪、筛样、token归约与超长信号
Clip-Higher将概率比的上侧裁剪阈值放宽,让已经获得正优势、但原本低概率的行为有更大增长空间;下侧阈值另设。它只改变代理目标,不构成硬KL约束。动态采样过滤无奖励差异的组并继续采样,直到凑够有效训练组,
Token-Level Policy Gradient把有效token项统一求和,再除本批实际有效token总数,取消原版每回答1/L_i的单独权重。overlong reward shaping则在临近或达到长度上限时设计更柔和的训练信号,避免把截断边界当作普通错误答案。原数学配置去掉参考KL是经验选择,不能推广成所有对齐任务都不需要行为约束。
非对称裁剪与全局token分母
原文采用非对称阈值,示例ε_l=0.2、ε_h=0.28。m屏蔽padding及规定的无效位置;这是全局token平均,非固定最大长度分母。
这个式子是要最大化的代理收益:若实现使用梯度下降,应最小化其相反数。 是新旧策略对同一前缀下token的概率比, 为同题组相对奖励, 指示有效token。增大 只延后正优势项在上侧进入平坦区的时刻;负优势的下侧由 控制。分母是被纳入此次归约的有效token数,所以改变长度分布会改变各回答占据的总份额。本文用batch写法展示token归约,原文§3.3式12的组内求和与实际跨设备batch归约仍需在复现时明确。
接受率怎样换算成补采预算
作一个固定接受率的教学近似:若每组独立且以概率p保留,凑够B个有效组平均需生成B/p组。p=0.25、B=100时,平均预算是400组;实际训练的接受率会随策略和题目分布改变,不能把这个数当成论文实测成本。
十个token的权重与三组补采的成本
以下是可手算的教学构造,不是论文实验。
两条回答长度2与8,优势同为1,先忽略裁剪。GRPO的“先回答平均再组平均”给每token系数1/4与1/16;DAPO给十个token统一系数1/10。总和都可为1,但长回答占的总权重从1/2升至4/5。
若一轮生成三组,奖励分别(1,1)、(0,0)、(1,0),动态采样只保留最后一组。训练日志写“1个有效组”不应隐去实际生成了3组;若更好的梯度让收敛轮次减少,最终墙钟仍可能下降,二者并不矛盾。
三、补采有效组并按实际有效token汇总更新
冻结π_old
反复采提示与每题G条回答,直到收集足量有效组
  评分并识别全对/全错零优势组
  按动态采样规则过滤并补采
  处理超长截断和软长度惩罚
计算组相对优势
使用非对称clip和全batch有效token聚合
更新策略;记录被丢弃的全部生成成本
输出:推理模型
注:原文数学配置移除KL,不能默认所有RLHF也应移除
四、读准确率与熵的成对曲线,再看累加消融
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | AIME评价、Qwen2.5-32B |
| 数据来源与规模 | 约17k数学题构造训练集 |
| 对比基线 | naive GRPO及逐项加入组件、相关R1-Zero结果 |
| 训练预算与资源 | 每提示16回答、512提示batch;评估32重复平均 |
| 指标及其含义 | AIME平均正确率;不是pass@32 |
| 随机性与不确定性 | 重复作答32次不等于32训练种子 |
| 实际验证的假设 | 各训练配方是否缓解无效梯度与熵/长度问题 |
图2:Clip-Higher的熵与准确率轨迹
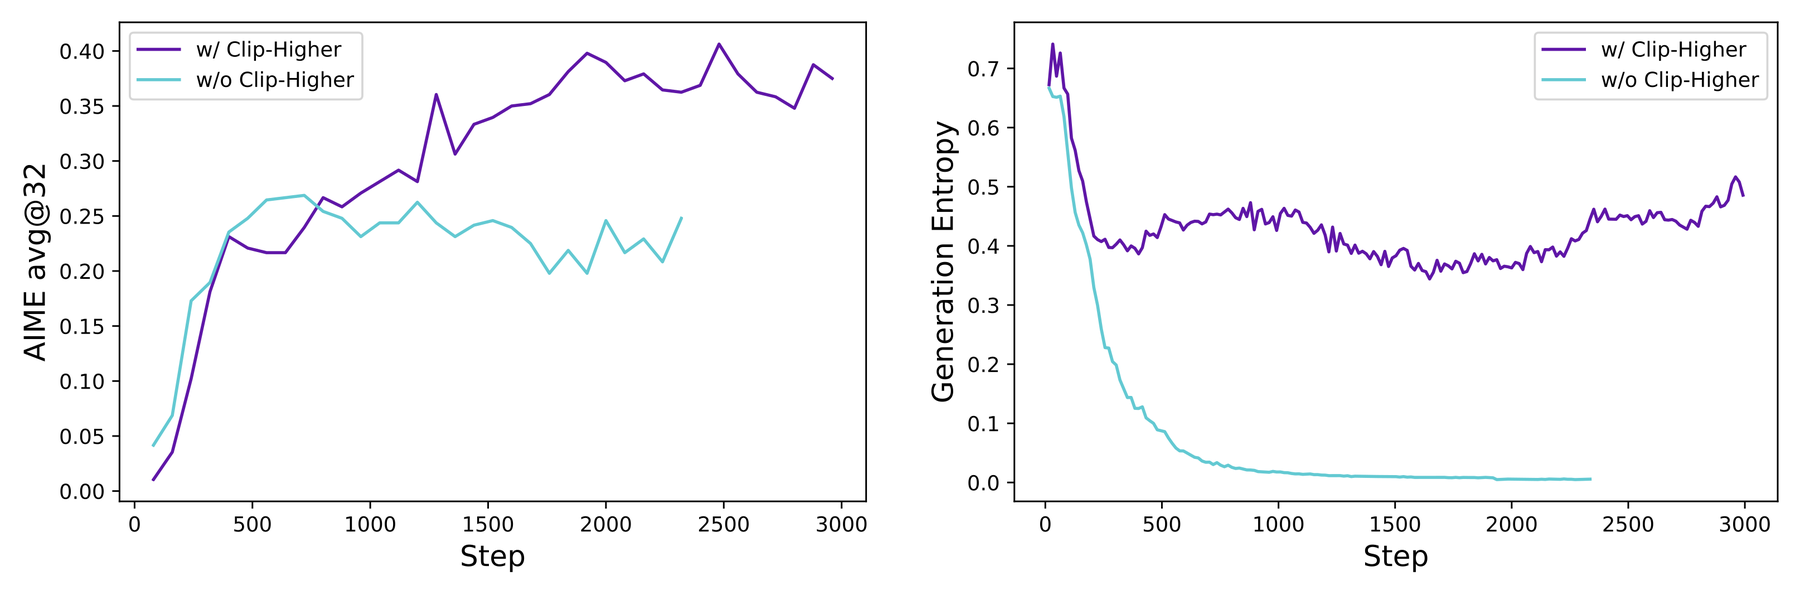
图2左图纵轴是AIME avg@32,右图纵轴是生成分布熵,横轴都为训练步。青线去掉Clip-Higher后熵快速接近零,左图准确率较早停滞;紫线保留更高熵并继续改善。这支持本设置下避免过早确定化的解释,不意味着熵本身越高越好,也不是32候选“至少答对一次”的pass@32曲线。
图3的子图标题分别为最大裁剪概率和全对样本比例,与其笼统图注不完全一致,应依子图标识读,勿转述为单一指标。图4和图5再分别观察熵/长度与超长奖励处理,动态采样的训练进度在图6。 查看原文。
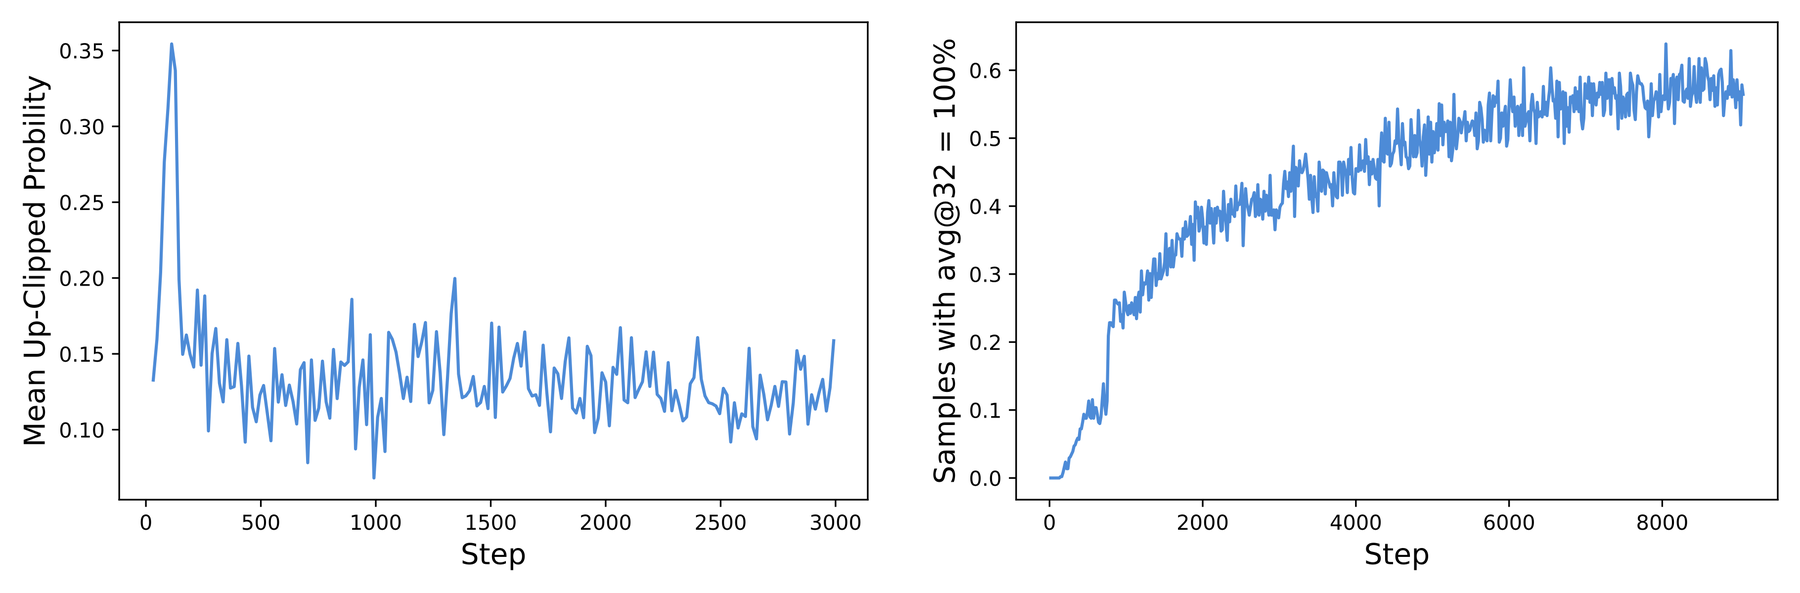
读图提示:左轴标题是平均上裁剪概率,右轴是avg@32全对样本的比例;原文笼统图注与面板标题不完全一致,这里按实际坐标识读,避免误报为熵或长度。
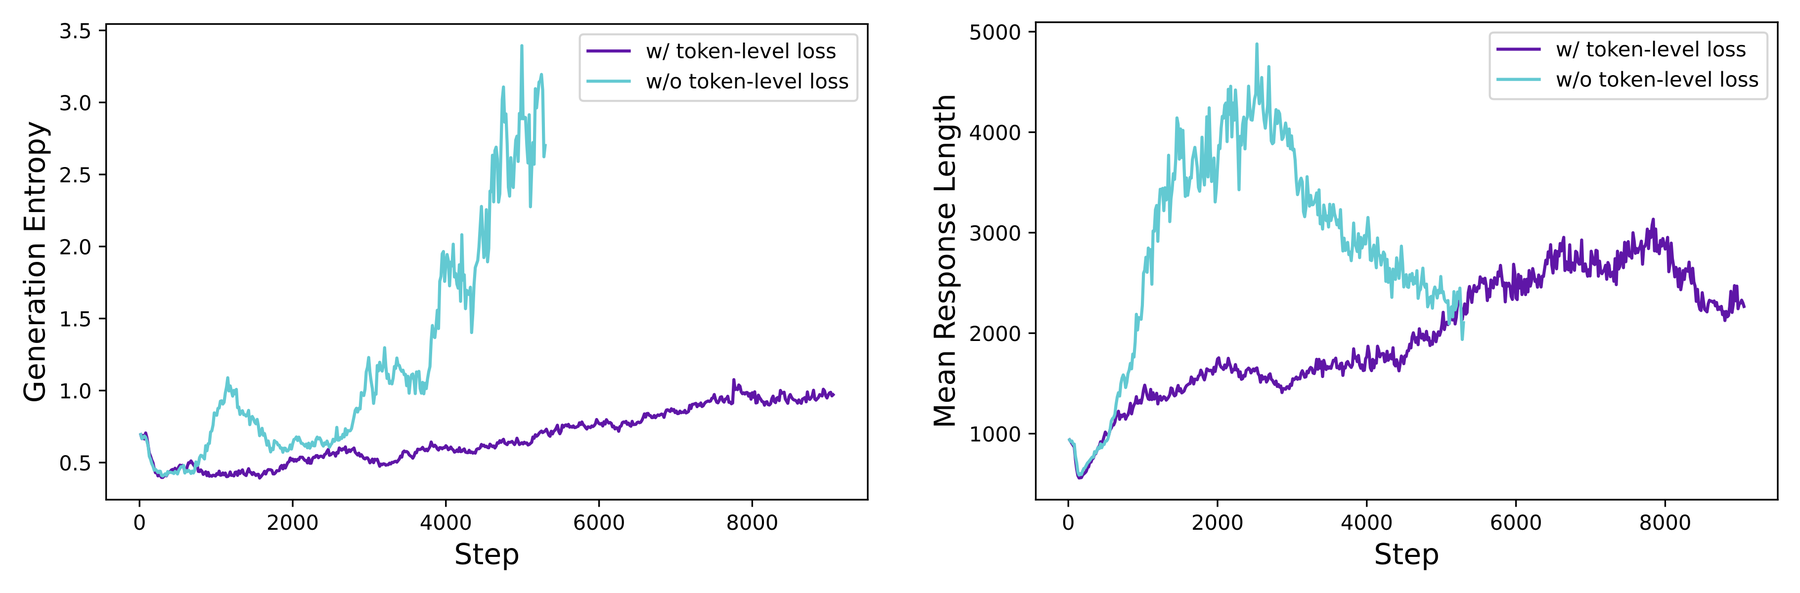
读图提示:左侧是生成熵,右侧是平均回答长度;两条线比较是否使用token级损失。分母改变样本权重,不能把长度变化直接视为准确率变化。
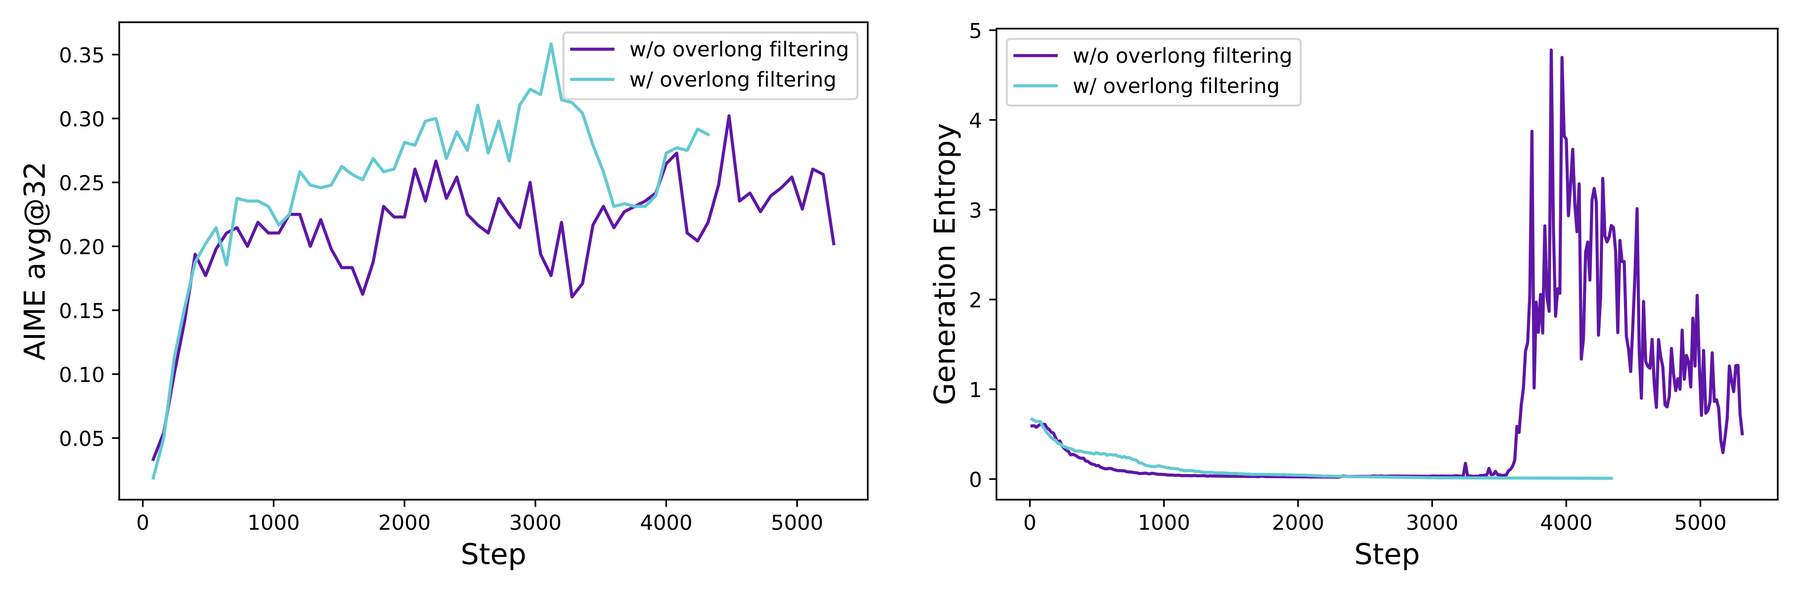
读图提示:左侧为AIME avg@32,右侧为熵;图例比较是否过滤超长样本。末段熵尖峰和准确率波动说明两个指标不能互相代替。
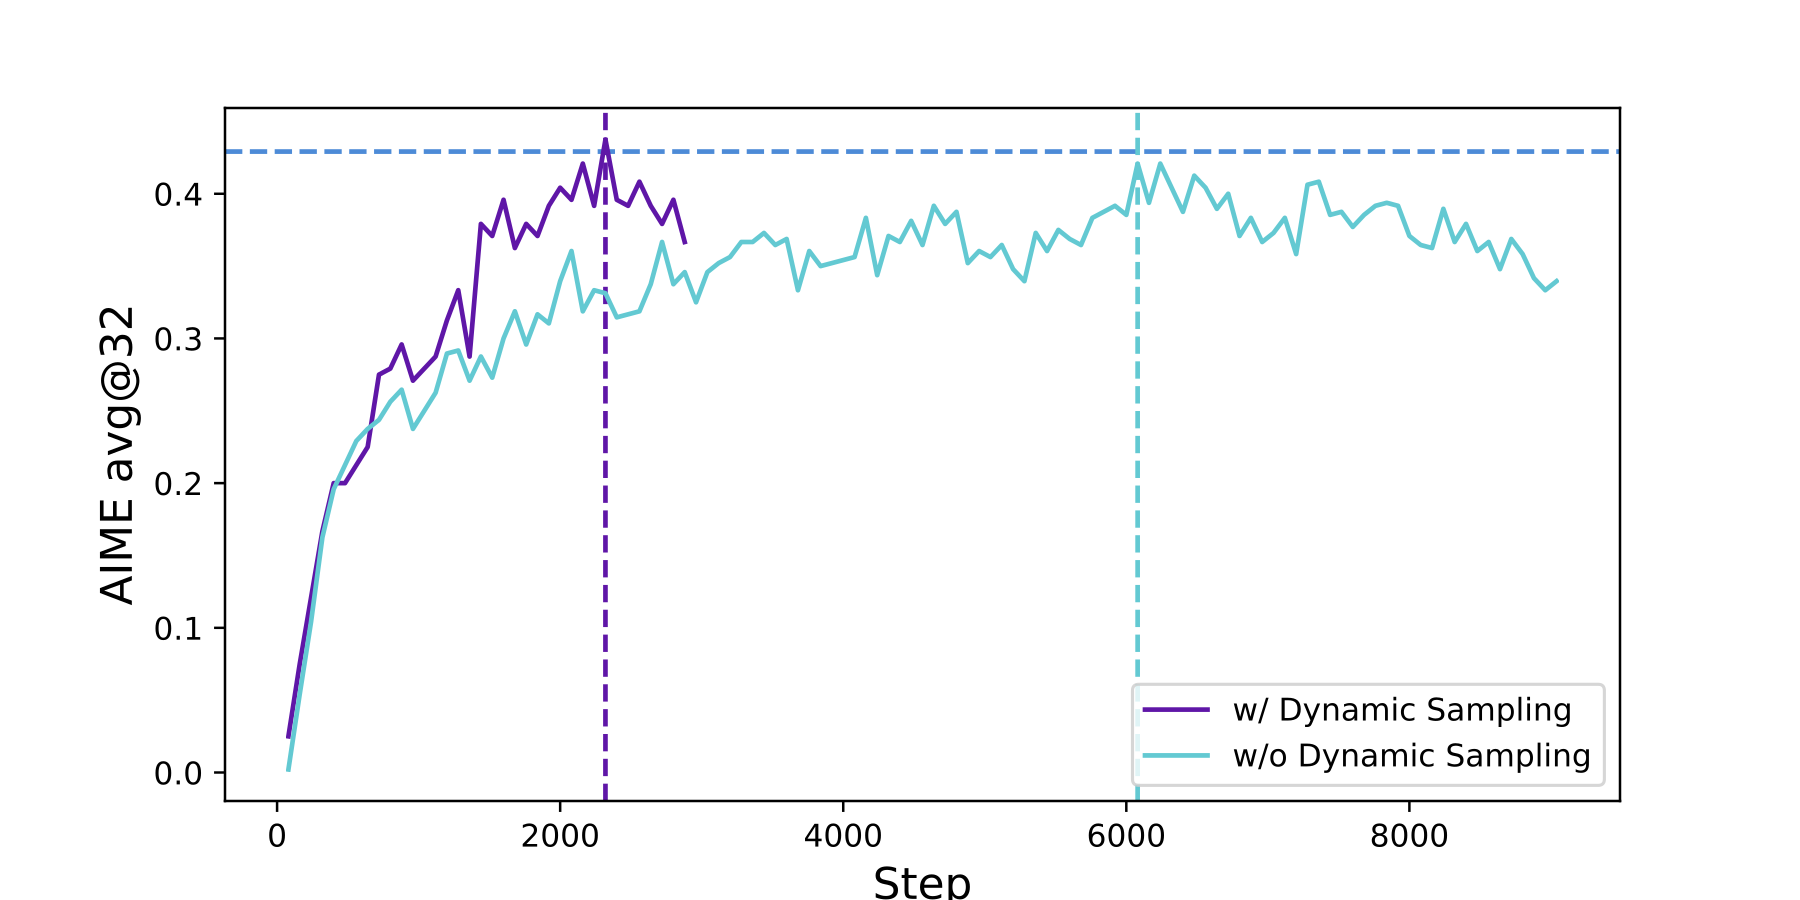
读图提示:紫线使用动态采样,青线不使用;横轴为训练步而非已尝试的全部生成成本。达到相近准确率所需步数减少,不自动等于同幅度总计算节省。
累加消融没有隔离全部组件交互
首版表1是累加配方的消融链,AIME24 avg@32随组件依次变化,最后到50;它不能替代全部组件组合的因子实验。
五、更新更有效之后,还要核算采样分布与总成本
Qwen2.5-32B的AIME结果来自整套配方与累积消融,不能隔离每个组件的全部净收益。过滤全对或全错组会改变题目分布,并可能增加补采;所谓半数训练步必须连同全部rollout和生成token核算。
六、三个值得继续追问的问题与参考答案
1. 补采后总token成本是否仍更低?
动态采样可能减少无效梯度更新,却为凑齐有区分度的组生成额外回答。应把所有被丢弃和保留样本的生成token、验证成本、训练token与墙钟都计入,比较达到同一独立测试分数的总成本。论文训练步数减半不自动等于总生成成本减半;若缺少完整补采日志,只能确认更新效率,不能补出成本降幅。
2. 丢弃全错组是否妨碍学习最难问题?
可能。全错组当前没有组内相对奖励信号,但长期丢弃会让最难问题不参与更新,训练分布转向中等难度题。是否妨碍最终能力取决于共享泛化、补采次数与探索能否产生正例。应分难度跟踪保留概率和学习进展,并对比课程、探索或更细反馈;“无梯度”不等于“该问题永远没有价值”。
3. 非对称clip为何不是动作概率硬上限?
clip限制的是目标中的概率比在某些优势方向上的贡献,不是对模型输出概率做约束投影。较大的上裁剪阈值允许正优势样本在更大范围继续得到激励,但其他样本、共享参数、熵项和多轮更新仍能把比率推得更远。应观察真实ratio与KL分布,不能把 解释成动作概率或全部更新的硬上限。
七、沿未解决的问题继续读
Dr. GRPO:实际token总数仍会随批次变化,固定最大长度分母会怎样?Dr. GRPO是并行归一化分析,同时移除组标准差;两种分母不能当同一改动。(同期并行路线)
FACTOR:长多轮轨迹中,统一token权重是否仍太粗?FACTOR进一步拆动作总信用与token落点,属于后续细粒度信用问题,不是DAPO的直接升级。(后续问题对照)
原文核对与路线出处
- 原论文与图表入口。四项方法、式12 token级目标、表1累加消融与动态采样成本说明。
- 本篇承接:GRPO。本篇改造其概率比裁剪、样本筛选和损失归约。
- 并行路线:Dr. GRPO。两者都研究长度权重,DAPO分母是实际token总数,Dr. GRPO使用固定长度常数。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:动态采样为什么能提高每次更新的有效性?
参考答案:同题回答奖励全部相同的组,缺少相对优势信号。筛掉这些组、补采有差异的组,可以提高训练 batch 中的有效信号密度。但被筛掉的回答已经消耗生成资源,所以更新次数减少不一定等于总成本减少。
问题 2:为什么按 token 归约损失会改变长短回答的影响?
参考答案:每条回答先平均,再跨回答平均,会让每条回答拥有相近总权重;对所有有效 token 统一平均,则较长回答包含更多项。改变归约方式会改变隐式权重,不能只把它理解为无关紧要的实现细节。