第 53 天|DeepSeek-R1:区分纯RL探索、完整训练管线与蒸馏
原论文与版本:DeepSeek-AI,DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning,2025。初版正文。
先接住前作的问题
第52天 DeepSeekMath/GRPO已经提出无需独立Critic的组相对更新。本篇接着问:从强预训练基座直接做可验证推理RL,会出现怎样的能力与行为变化?R1沿用该更新机制,但R1-Zero、完整R1、蒸馏是三条不同路径。第47天 InstructGPT仅提供SFT与RL组合的并行背景,奖励和阶段目的并不相同。
五个前置概念
- 冷启动:RL之前使用少量格式良好数据。
- 可验证奖励:能以规则或执行器判断的反馈。
- 拒绝采样:从生成候选中筛选合格样本。
- 蒸馏:把大模型行为迁移给小模型。
- Pass@k:k候选至少一次成功的指标,需按论文定义。
一、问题设定:推理RL增益究竟来自哪条训练路径
要解释推理增强,必须先固定起点和训练权限。R1-Zero从已预训练的DeepSeek-V3开始,完整R1再加入冷启动和后续数据流程,小模型蒸馏则读取大模型生成的筛选回答;它们回答的因果问题不同。
本篇的问题因此不是“RL能否从无到有创造全部推理”,而是在这些明确起点下,结果反馈怎样改变回答分布,以及观察到的更长输出、自检行为和正确率如何分别验证。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 大模型可验证推理后训练;多个不同训练路径 |
| 状态/观测 | 题目与推理/回答前缀 |
| 动作 | token |
| 奖励或学习信号 | 正确性与格式规则等;完整R1还含其他任务反馈 |
| 终止/边界 | EOS/生成预算;超长处理影响结果 |
二、拆开三条训练路径与终局奖励的token作用
R1-Zero从已经预训练的DeepSeek-V3基座出发,直接进行推理RL,研究无需先做推理SFT时能否改善表现;“Zero”不意味着随机权重、没有语言知识或没有预训练数据。其组相对更新承接DeepSeekMath,贡献是训练现象与配方,而不是重新证明策略梯度。
完整R1针对R1-Zero的可读性和语言混杂问题加入冷启动,再进行推理定向RL;之后用拒绝采样整理推理数据并加入非推理数据做SFT,最后进行更广场景的RL。规则可核验数学最终答案,不代表所有训练阶段、所有任务都只用同一种规则奖励。语言一致性等奖励也会引入可读性与任务表现之间的权衡。
蒸馏是第三条路径:较小模型用筛选后的大模型回答做监督训练。大模型RL产出的数据可以迁移能力,但小模型的蒸馏成绩不能被当作它自己通过同等RL预算学出的结果。
序列概率分解不等于逐步因果验证
核心仍是组相对优势与裁剪目标;规则奖励 是示意,具体规则与权重以版本为准。
为何整条回答的奖励会影响每个token:对给定提示 ,序列概率分解为 ,取对数再求导得到 。结果奖励构造的同一个优势可以乘上这些token梯度,所以正确终局会给整条采样路径提供更新信号;它没有识别哪一步实际导致正确。这是裁剪前的教学score-function分解,R1使用的组标准化、长度归约和KL要按初版§2.2.1及GRPO前篇另行加入,不能从终局奖励推出逐步因果验证。
一个准确率点必须带着生成预算
单次采样正确率衡量一次回答,多数投票则利用多次回答及聚合规则;后者改变了推理计算。训练曲线上的响应长度还会改变每题token预算,因此能力比较需同时固定采样次数和长度上限。
终局奖励广播与小模型蒸馏的区别
以下是可手算的教学构造,不是论文实验。
设一题采四条回答,其中两条答案正确,一条错误,一条格式不合规。为演示,令总奖励为(1,1,0,0),则组优势(1,1,−1,−1)会鼓励前两条的所有有效token,无法单独判断正确回答中哪一步推理必要。
现在收集一万条经筛选的正确回答,给小模型做交叉熵训练。小模型没有再次接触规则验证器也可能变强;这是蒸馏证据。若要证明小模型独立RL更优,必须另做相同基座、数据与计算预算的RL对照,不能沿用大模型的过程作替代证据。
三、分别执行直接RL、多阶段R1与监督蒸馏
路径A:R1-Zero
  从预训练基座出发
  多次采同题回答→规则评分→GRPO更新
路径B:完整R1
  冷启动数据SFT
  推理定向RL
  生成并筛选推理/非推理训练数据
  再SFT,再进行多场景RL
路径C:蒸馏
  用R1生成的筛选数据监督训练较小模型
三条路径分别评估,不混成同一个算法成绩
四、读R1-Zero曲线时锁定pass@1、投票与采样预算
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 数学、代码及综合能力基准 |
| 数据来源与规模 | 预训练基座、RL题目、冷启动/筛选数据;路径各不同 |
| 对比基线 | R1-Zero、R1、不同基座/蒸馏模型及外部模型 |
| 训练预算与资源 | 原文未给足以完整等成本复现全部流程的账本 |
| 指标及其含义 | pass@1、重复平均、多数票各自定义 |
| 随机性与不确定性 | 多次生成不等于多次独立训练 |
| 实际验证的假设 | RL、冷启动和蒸馏分别能带来什么 |
图2:pass@1与cons@16不能混读
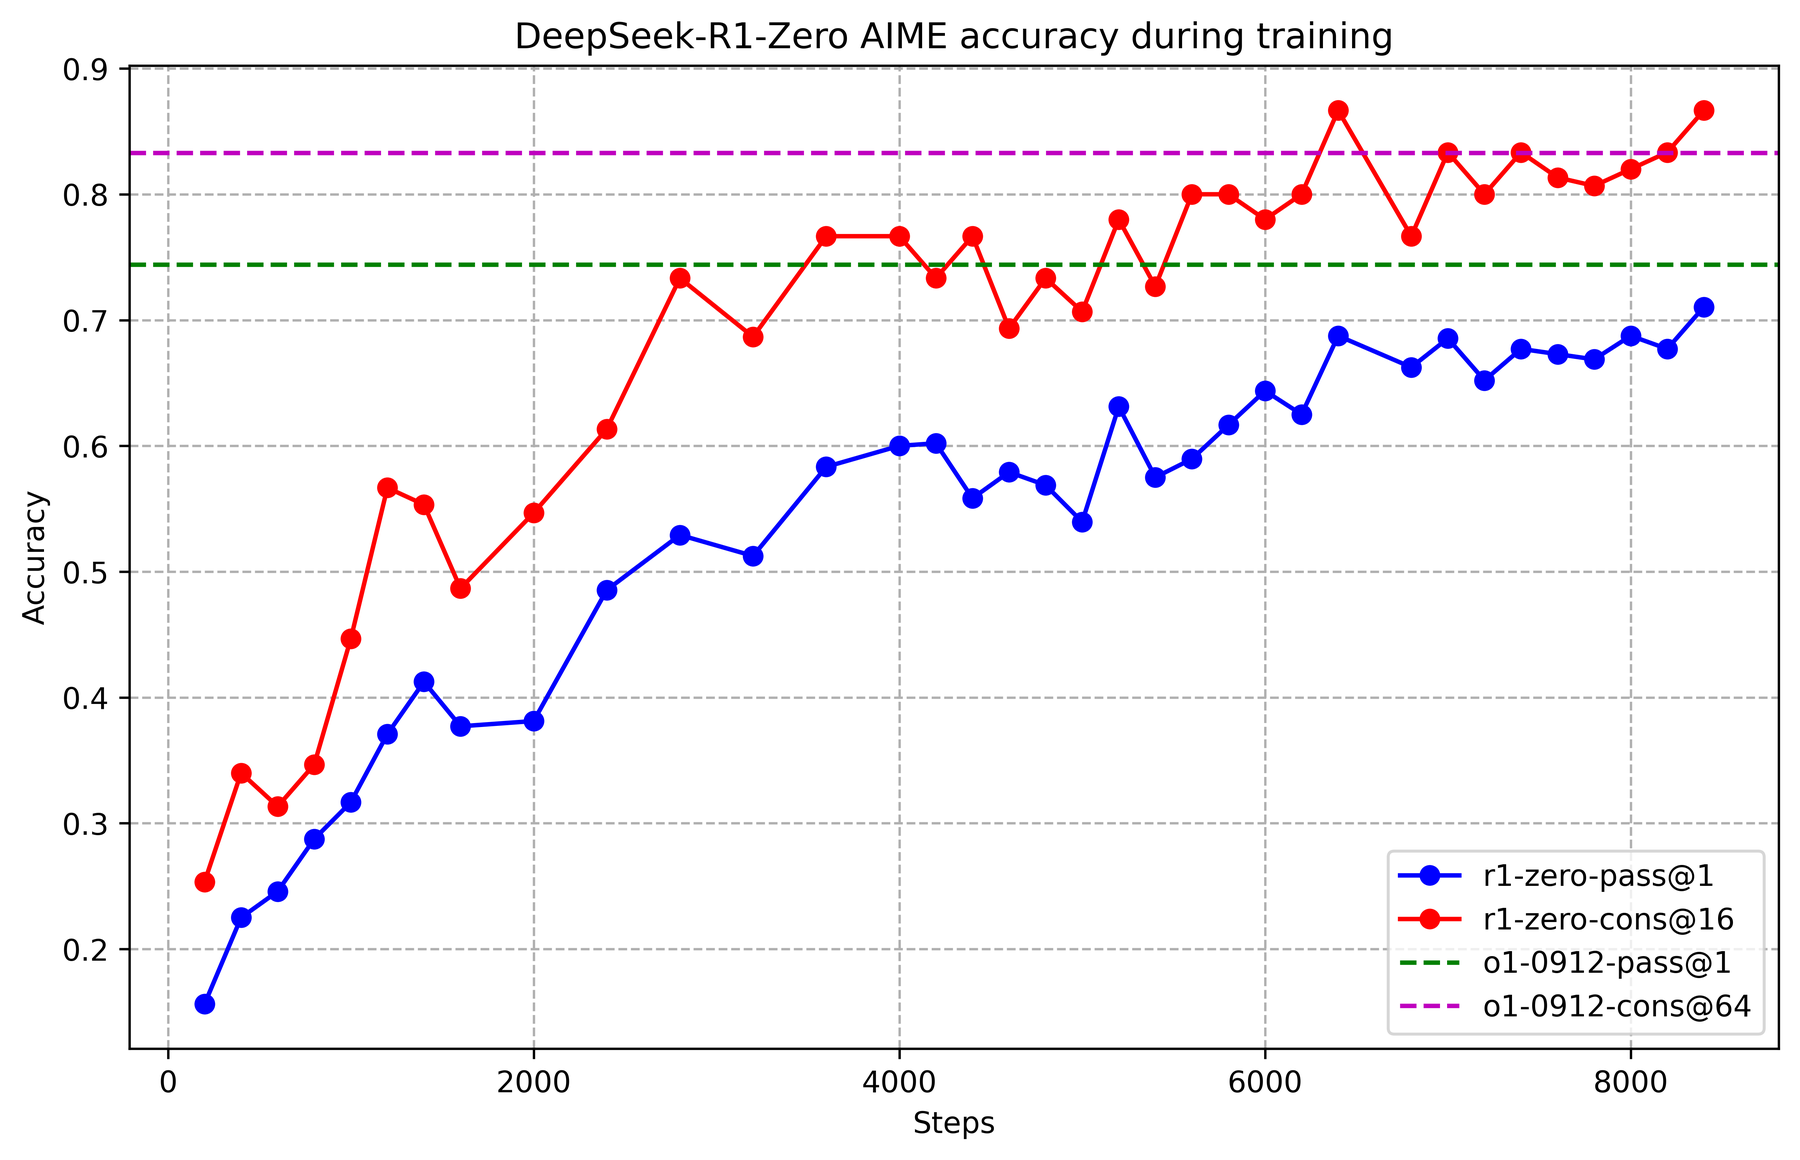
图2横轴是RL训练步,纵轴是AIME2024准确率。蓝线pass@1用每题16次采样来降低估计噪声,红线cons@16先对16个回答投票,二者的推理资源不同;绿虚线是o1-0912的pass@1,紫虚线是其cons@64,红线跨过紫线也不是相同候选数的比较。这里的红线应按图例保留cons@16,不能与主表另列的cons@64互换。
图3记录训练集响应长度,不能用它替代图2的准确率。完整R1和蒸馏表还用了额外阶段或监督数据,不能直接续接R1-Zero的单一路径曲线。
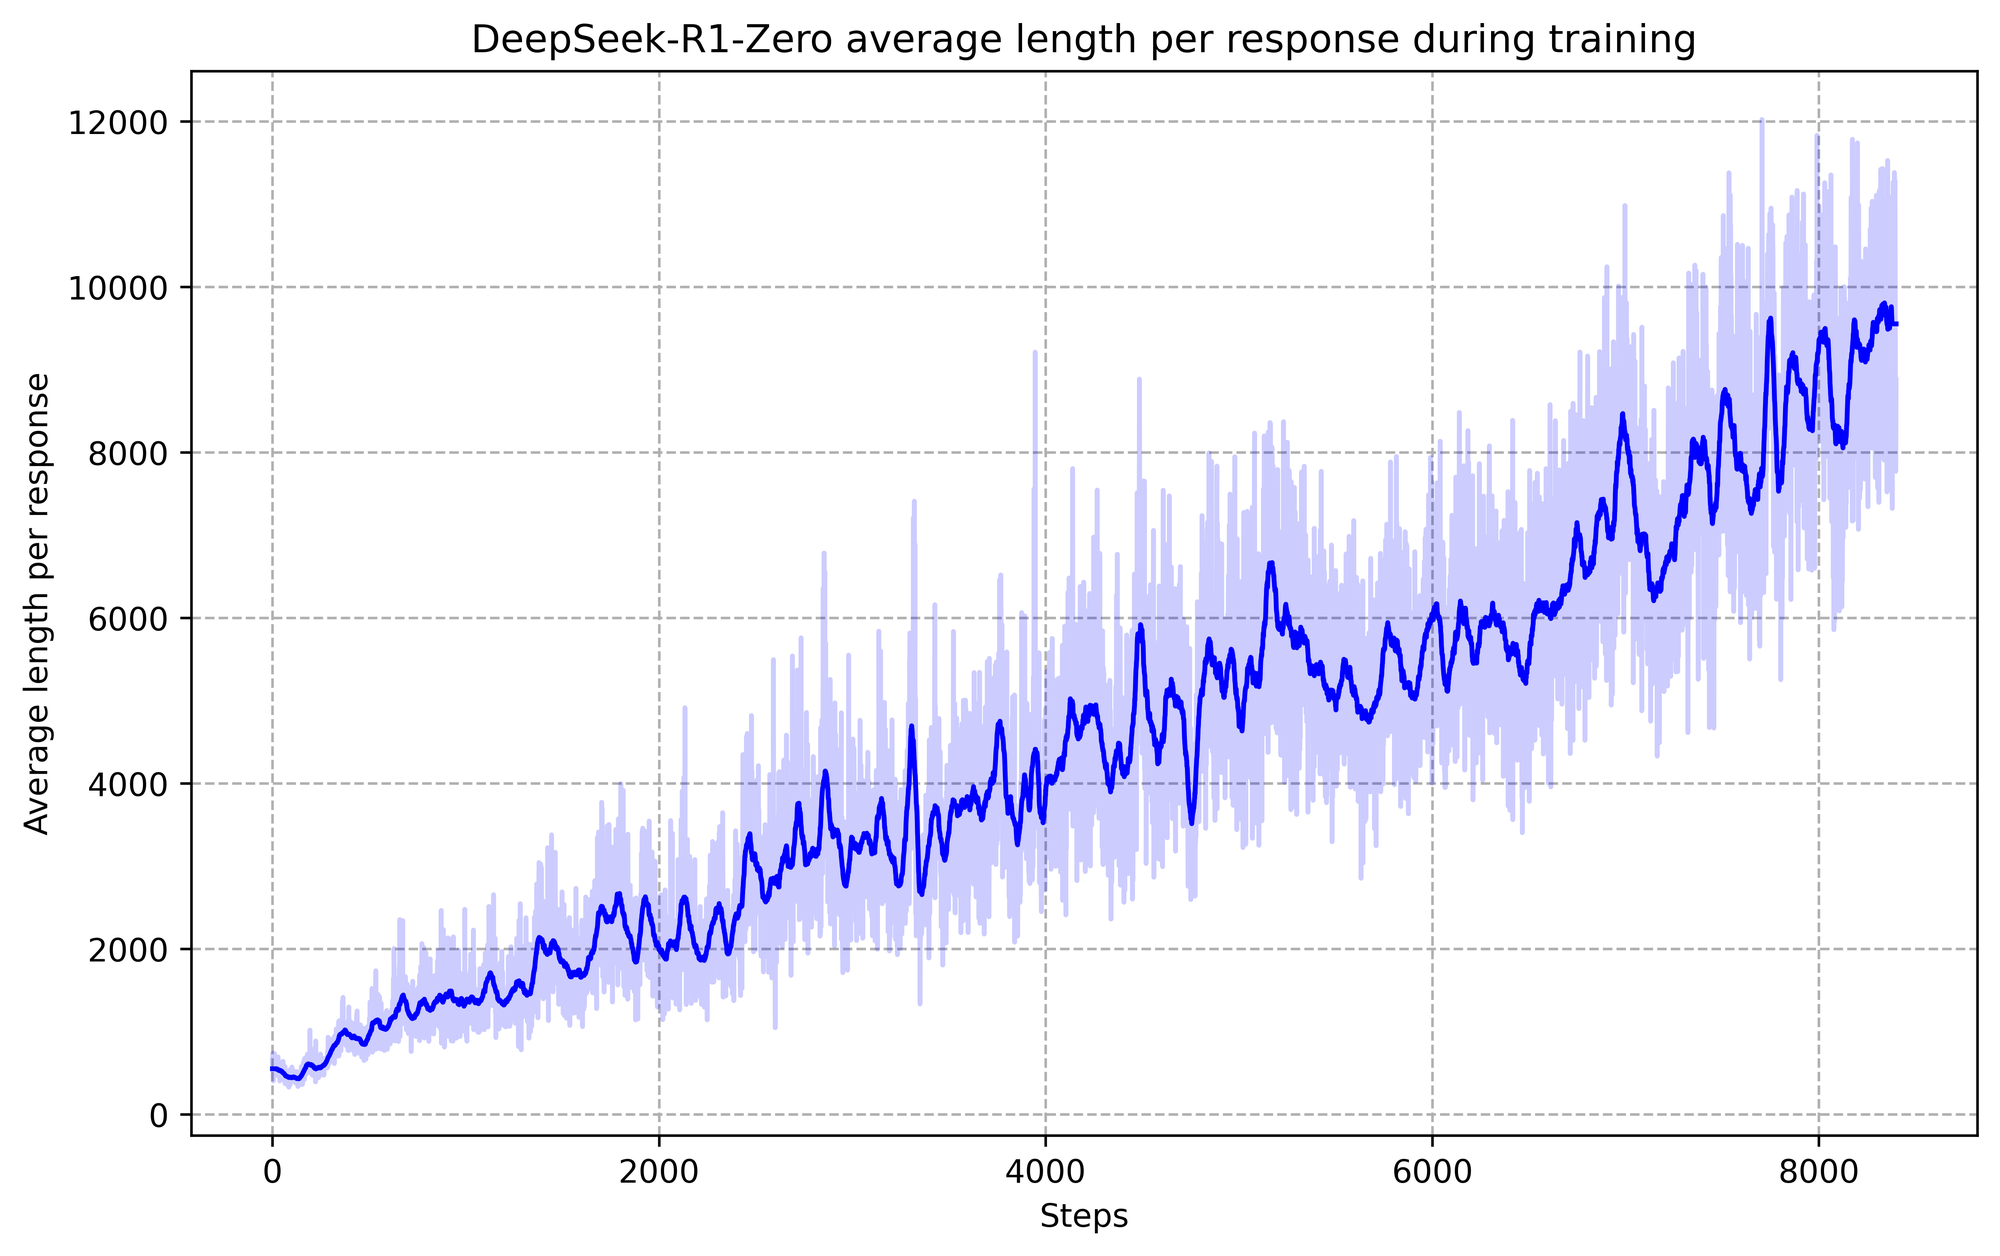
读图提示:横轴为RL步数,纵轴为训练集平均响应长度。长度增加记录了行为变化,仍须与准确率证据分开,不能由更长回答直接推出推理更正确。
行为样例与多阶段结果不能隔离GRPO净贡献
自检与“aha”片段展示可观察行为,却不能单独区分基座已有的低概率能力与RL新增能力。每题多次生成也不是独立训练重复。完整R1与外部模型的比较还改变预训练、训练数据和采样成本,无法据此单独估出GRPO的净贡献。
五、可观察推理行为与机制因果之间还缺什么
15.6→71.0属于指定基座及AIME2024协议下的R1-Zero,不与多数投票或完整R1最终结果拼接。响应变长不是推理质量的独立证据;可读性与语言混合还推动了后续阶段设计。数据、验证器与采样预算都可能影响高分,基座上的RL和小模型监督蒸馏也不能统一称为随机初始化的能力涌现。
六、三个值得继续追问的问题与参考答案
1. RL新增了什么行为,如何与基座已有能力区分?
先在同一基座、相同提示和采样预算下测行为与正确率,再比较RL后结果;增加基座采样温度、best-of-N或投票可检验相关行为是否原已存在但低概率。还要区分出现自检措辞与自检确实修正错误。单个“aha”样例不能证明新能力从无到有;需要频率、成功关联和干预实验,且仍只能识别所测分布上的变化。
2. 如何控制长输出导致的额外计算收益?
同时报告固定每题token预算、固定总生成token和允许自然长度的结果,并记录推理时间与采样数。把长输出截短可能改变策略,应使用预先定义的预算规则和多档预算曲线,而非只事后除以长度。若RL只在更高推理计算下获益,这仍可有价值,但应称为能力-计算折中改善,而非相同成本的纯训练收益。
3. 开放任务没有可靠验证器时可沿用多少配方?
可以沿用组采样、保守策略更新和多阶段数据流程等技术,但核心奖励可靠性不再成立。开放任务需明确的人类反馈、经过验证的RM或可审计工具结果,并检查长度偏置、投机和评审漂移。训练奖励变高不等于真实质量提升;必须用独立评价和风险边界检验,不能把数学正确性验证器的结果直接外推到所有开放问题。
七、沿未解决的问题继续读
Dr. GRPO:同样基座换提示模板与归一化,会改变多少所谓RL增益?Dr. GRPO是后续诊断路线,提供控制起点与目标权重的检查。(后续诊断路线)
DAPO:长推理在线训练怎样避免熵塌缩、无效组与粗糙超长惩罚?DAPO沿GRPO改系统配方,与R1流程研究并行。(后续并行路线)
TTPO:训练结束后能否继续用测试题更新参数?TTPO开放额外的测试时适应权限,应与R1的训练阶段增强分开记账。(后续教学对照)
原文核对与路线出处
- 原论文与图表入口。§2 R1-Zero、冷启动及完整R1多阶段流程、蒸馏和行为讨论。
- 本篇承接:DeepSeekMath/GRPO。本篇把既有组相对更新用于直接推理RL与后续多阶段流程。
- 并行路线:InstructGPT。都组合SFT和RL,但数据、奖励与阶段目的不同,不能把R1视为简单复刻。
- 并行路线:Dr. GRPO。后作从基座、模板与归一化角度审查推理RL增益的来源。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:R1-Zero、完整 R1 和蒸馏模型分别说明什么?
参考答案:R1-Zero 研究预训练基座在没有前置 SFT 的特定 RL 流程中如何变化;完整 R1 使用冷启动及多阶段训练改善能力和输出;蒸馏模型从大模型生成数据中学习。它们不能统称为“同样通过纯 RL 学会推理”。
问题 2:出现更长的反思文字,为什么不能单独证明推理更强?
参考答案:反思文字可能是有效计算,也可能只是重复表达。需要在匹配题目与生成预算后,检查正确率、鲁棒性和泛化。预训练知识、验证器、采样数量与训练数据都可能影响成绩,不能仅凭文本风格归因。