第 51 天|KTO:只有“好/不好”标签,如何进行模型对齐
原论文与版本:KTO: Model Alignment as Prospect Theoretic Optimization,2024。原论文。
先接住前作的问题
第49天 DPO需要同提示的胜负回答对,第50天 IPO修正间隔目标但仍使用成对比较。若真实反馈只有“这条回答好/不好”,怎样保留可用的学习方向?KTO改变反馈接口与效用定义,是共享参考对数比思想的平行路线,不是IPO有限margin公式的下一步推导。
五个前置概念
- 二元反馈:每条回答独立标好或坏。
- 参考点:决定收益与损失相对尺度的基准。
- 效用函数:把隐式奖励映射成优化偏好。
- 类别权重:调整好坏样本贡献。
- HALO:原文对一类人类感知式损失的命名。
一、问题设定:只有单条好坏标签怎样定义更新方向
现在每个样本只有提示、单条回答和好坏标签,未必存在一个能与它配对的回答。收集要求因此变轻,但相对胜负与绝对好坏的含义并不相同:从一对回答拆出的胜者,也可能只是两个坏答案中稍好的一条。
KTO要在这种反馈形式下构造相对参考点的更新方向。方法是否有效,除了看目标函数,还要问参考点怎样估、两类标签有多少,以及单样本权重怎样与类别比例共同决定梯度。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 离线二元反馈的语言模型策略对齐 |
| 状态/观测 | 提示x |
| 动作 | 单条回答y |
| 奖励或学习信号 | desirable/undesirable标签 |
| 终止/边界 | 回答结束 |
二、以参考点分开两侧效用,并检查KL代理
定义参考修正的隐式奖励 ,再与参考点z比较;可取回答希望r高于z,不可取回答希望低于z。两个方向的sigmoid效用与类别权重共同决定梯度,心理学只是设计启发,不能据此声称模型获得了人类心理机制。
好坏两侧损失的梯度朝哪里走
令 ,参考点为z。好样本效用 ,坏样本效用 ;最小化对应最大效用减当前效用。此处z=βz₀以保持奖励单位一致;z₀依原文KL代理估计和停止梯度处理,不直接用本条标签泄漏构造。
把效用明确写成要下降的损失:好样本为 ,坏样本为 。在冻结参考点时,前者对 的导数为负,后者为正,所以梯度下降分别提高和降低该回答的参考修正分数。sigmoid两端的斜率都接近零,说明类别数×权重相同仍未必产生相同梯度;参考点把样本移入哪段效用曲线同样重要。这里的损失方向来自修订v5的KTO定义,不要求把两条回答配成一对。
本篇将z写在奖励单位中,即 。论文概念上的 是相对参考的KL,但实际修订版用微批内错配的(x_i,y_j)估计对数比均值,再截为非负,并停止梯度。错配回答不是从当前条件策略采样,所以这是有偏代理;截断还会额外引入向上偏差。“KL非负”不能证明这个微批代理是精确KL。
数量平衡后还要看sigmoid的局部斜率
取β=1并固定参考点,若好样本的r−z为0,其sigmoid斜率为0.25;若坏样本的z−r为log9,斜率只有0.09。即使样本数与类别权重已平衡,两类对分数的梯度量级仍可不同;这把参考点位置的影响与下面的数量比例例子区分开。
标签方向、类别数量与错配参考点
以下是可手算的教学构造,不是论文实验。
设β=1、参考点z=0,某回答的策略/参考概率比是2,则r=log2。标好时效用为σ(log2)=2/3,标坏时效用为σ(−log2)=1/3;相同概率变化对两类标签方向相反。
若好坏数量比为1:10,λ_D=λ_U=1时坏样本总量压倒好样本。取λ_D=10、λ_U=1才大致平衡数量贡献,仍不保证实际梯度等大,因为sigmoid斜率也不同。
若两条错配回答的对数比分别−0.2与0.1,均值−0.05被截为0。真实KL不可能为负,但这个计算只能说明估计器遇到了负均值,不能说模型的真实KL就是0。
三、估计并冻结参考点,按标签聚合效用损失
输入单条(x,y,label)数据,固定参考模型
每batch:
  估计原文规定的KL参考点z并停止其梯度
  r←β*(logπθ(y|x)-logπ_ref(y|x))
  if label=好:utility←λ_D*sigmoid(r-z)
  else:utility←λ_U*sigmoid(z-r)
  最小化各类常数上界-utility
检查好坏标签比例与权重
输出:二元反馈对齐策略
四、匹配模型规模读图3,再检查失去配对后的证据
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | 原文多种模型与对齐数据 |
| 数据来源与规模 | 单条好坏标签,可由原偏好数据构造 |
| 对比基线 | DPO等HALO与非HALO方法 |
| 训练预算与资源 | 表1含超参数扫描;数据与模型规模须分开 |
| 指标及其含义 | judge胜率与标准任务评价 |
| 随机性与不确定性 | 图3为GPT-4-0613裁判、90%二项区间;其他设置和训练重复未逐项复核 |
| 实际验证的假设 | 非成对反馈能否训练有效对齐模型 |
图3:模型家族、SFT前置与胜率百分点
原引用定位:原文。
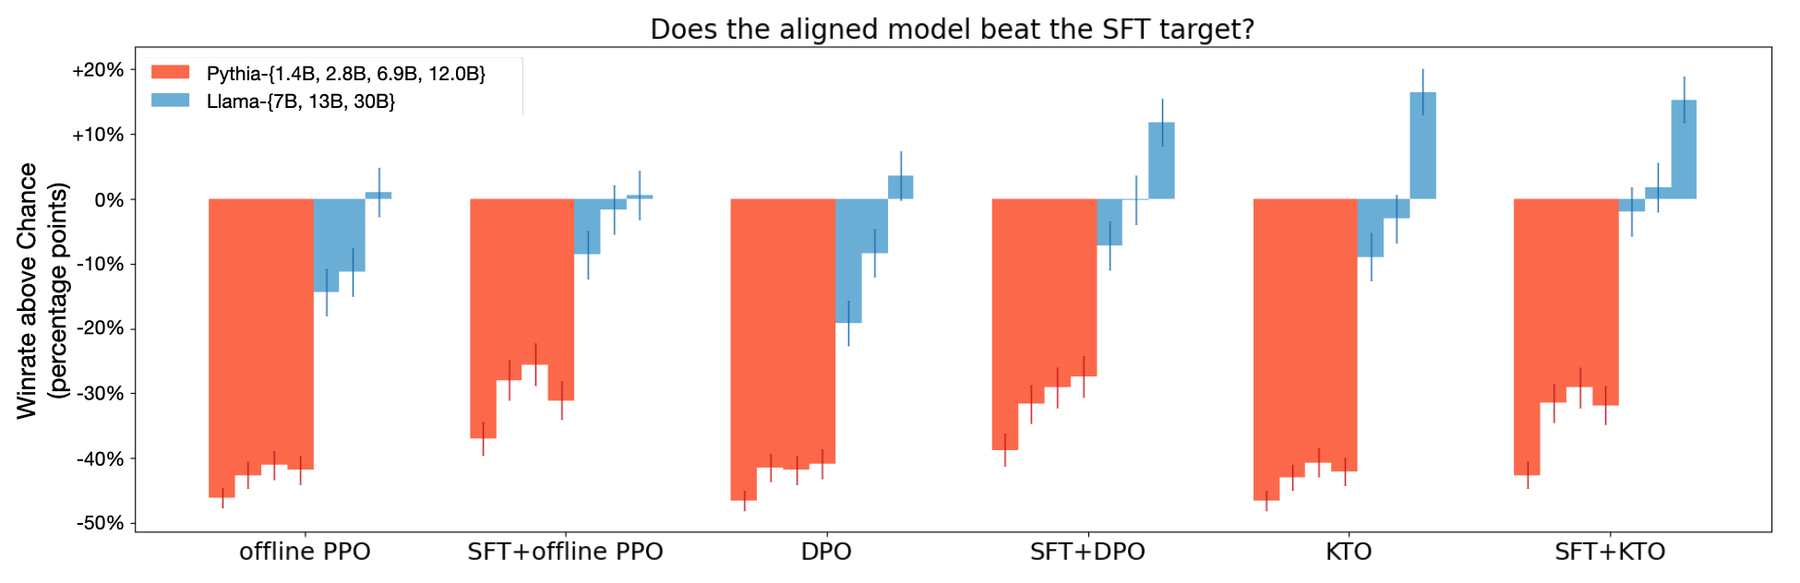
横轴每组是训练路线:offline PPO、DPO或KTO,以及是否先做SFT;同组内橙红柱为不同大小Pythia,蓝柱为不同大小Llama。于是比较KTO与DPO时要匹配模型家族和规模,比较KTO与SFT+KTO时才是在看前置SFT的作用。跨颜色最高柱相减会同时改变模型本身,不能直接叫作KTO的净提升。
图1比较目标隐含的效用形状;图2比较HALO与非HALO类目标,而KTO对DPO的规模比较在图3。图3纵轴是胜率减50%后的百分点,0意味着约打平SFT目标,不是零胜率。
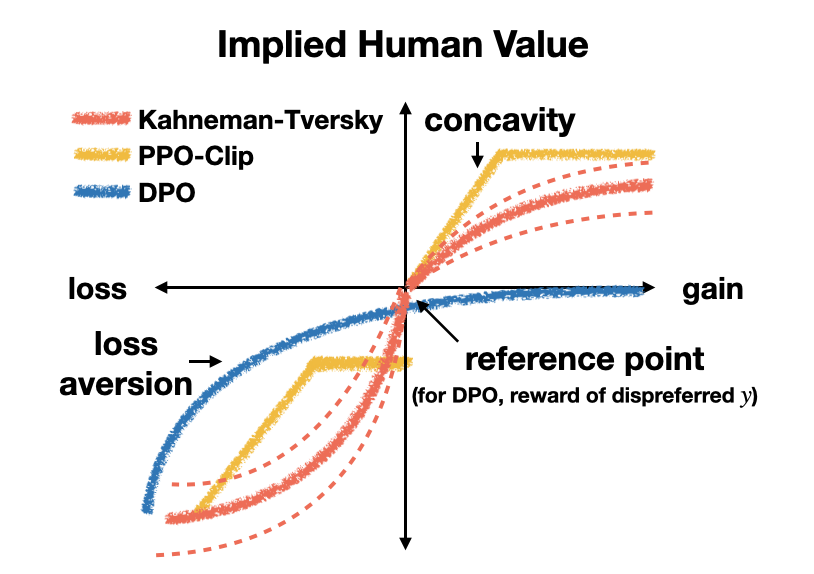
读图提示:横轴相对参考点区分损失和收益,纵向曲线表示不同目标隐含的效用形状。该示意解释损失规避的设计动机,不是对真实人类偏好的逐点测量。
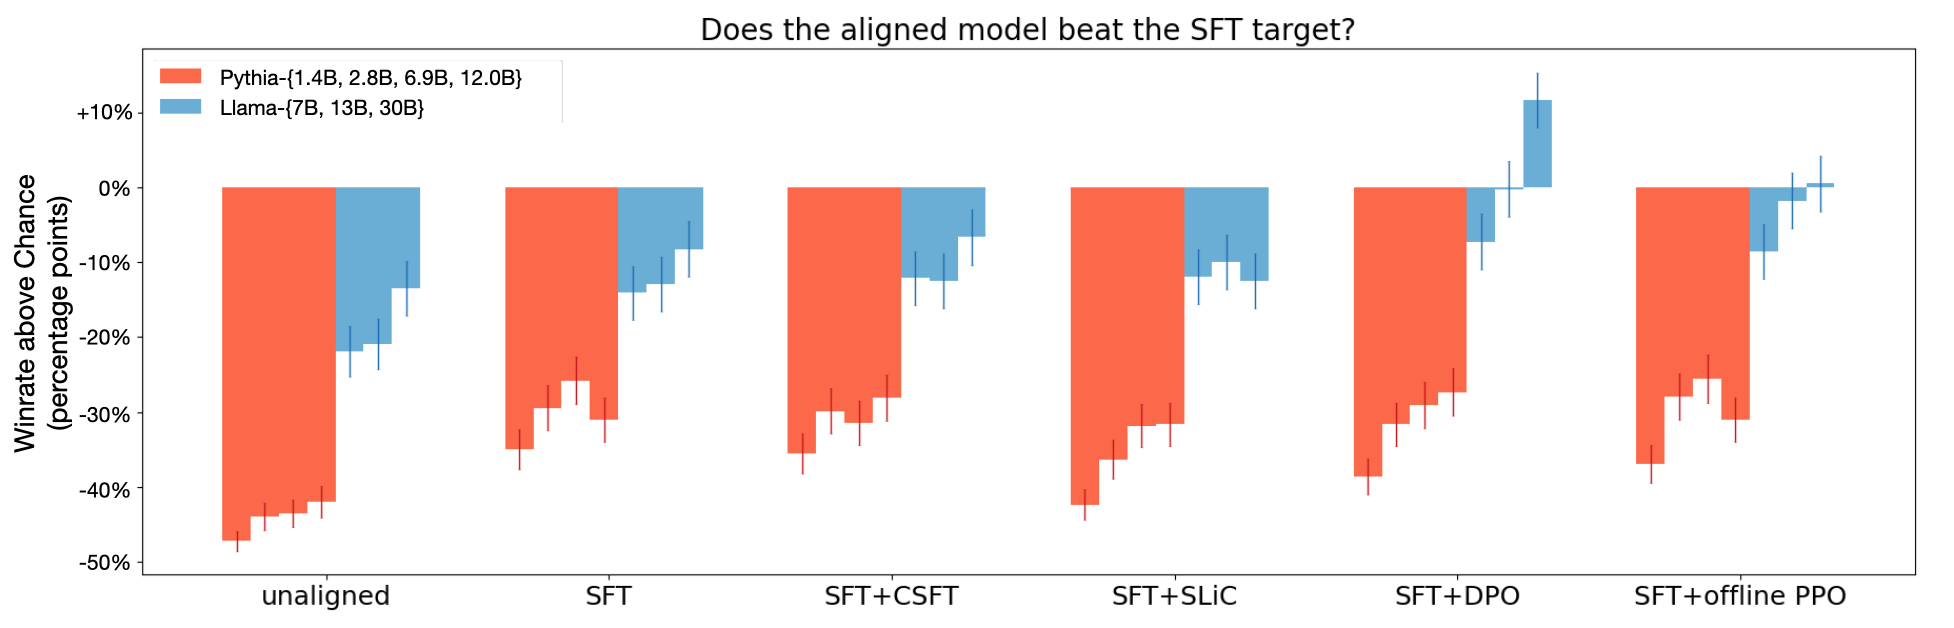
读图提示:橙蓝分别为Pythia与Llama模型家族,各组柱反映不同规模。纵轴是胜率减去50%后的百分点;零点表示与SFT目标打平,不表示零胜率。
one-y-per-x与90%区间各检验什么
修订正文图3用GPT-4-0613裁判给出胜率与90%二项置信区间;这反映评测回答抽样的不确定性,不等于多次训练种子的方差。one-y-per-x实验只保留每提示一条回答,较直接地测试失去配对后是否仍能学习,但也同时减小数据量。本文使用可读修订版的方法细节,2024仅指首发年份,各版实验差异未完全追踪。
五、反馈易得不等于标签含义与梯度权重不变
胜者标好、败者标坏只是便捷转换:两条可能都好或都坏。跨提示的标签标准、参考点估计、类别比例与λ_D/λ_U共同决定目标,不能只报单样本权重。单条反馈更容易收集,也不代表含有与成对比较相同的信息;评测区间不能抵消这些系统偏差。
六、三个值得继续追问的问题与参考答案
1. 相对胜负拆成绝对标签会丢失什么?
成对胜负表示同一提示下A优于B,不蕴含A绝对好或B绝对坏;两者可能都好或都差。拆成绝对标签会丢掉比较对象、差距与上下文,甚至引入矛盾监督。KTO适合真正可解释的好/坏反馈,但把成对数据转换为该格式是额外建模选择,应检验转换噪声、提示分布和独立评价,而非称为无损拆分。
2. 好坏比例变化时如何调整λ?
应关注有效权重 与 及各类梯度大小,而不只看原始样本数。类别比例改变后可以按目标偏好和验证数据调整正负权重或采样率,避免多数类压倒少数类;机械逆频率也未必最佳,因为噪声与难度不同。报告好坏定义、权重记号和分组表现,不能宣称固定一组 适合所有比例。
3. 参考点估计偏差会怎样影响两类样本?
参考点决定相对收益的零点,估得偏高会把更多回答移向“损失”一侧,偏低则相反;好坏分支的sigmoid可能因此进入不同饱和区,改变梯度规模和类别平衡。它不只是可忽略的常数,因为效用非线性。可用独立批次或多次配对估计检验稳定性,并同时监测参考点、两类有效梯度和验证偏好。
七、沿未解决的问题继续读
DeepSeekMath/GRPO:如果训练中能够对同题重新生成多条回答,是否还必须沿用固定好坏数据?GRPO用组奖励构造在线优势,是反馈权限不同的平行路线,不能把组比较等同KTO标签。(后续教学对照)
DRACO:多轮工具任务连可靠好坏标签也缺少时,反馈如何产生?DRACO用动态准则与judge生成评价,是后续监督来源问题,未解决KTO标签含义的条件也仍值得检查。(后续问题对照)
原文核对与路线出处
并行路线:DPO。共享参考对数比思想,反馈单位由成对比较改为单回答标签。
教学对应:InstructGPT。人类反馈可进入不同目标;二元KTO标签不等于InstructGPT的排序奖励模型。
教学阅读:KTO Trainer。仅借用本节的解释顺序与接口视角;具体算法、版本和实验以本篇原论文为准。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:没有成对回答,KTO 怎么构造学习方向?
参考答案:它比较单个回答的策略—参考策略对数比与一个参考点。好标签推动该相对评价向上,坏标签推动向下,并通过效用函数与类别权重控制更新。因此不要求同一提示下总有一对可比较回答。
问题 2:把好坏标签收集得越多,是否一定越好?
参考答案:标签来源、好坏比例和评价标准同样重要。大量偏向某种文风的标签,可能让模型学会迎合风格;类别严重失衡也会改变梯度贡献。KTO 简化反馈形式,但没有取消对数据质量和权重设计的要求。