045|FastSLAM:不删除相关性,而是把它放进轨迹假设
论文:Michael Montemerlo、Sebastian Thrun、Daphne Koller、Ben Wegbreit,FastSLAM: A Factored Solution to the Simultaneous Localization and Mapping Problem,AAAI 2002,593–598。会议原文 · 作者出版页。
先接住前作的问题
联合EKF-SLAM保留相关性,但地图协方差会变大。本篇条件于轨迹分解路标,并用粒子承载历史歧义;GMapping承接这一骨架,GraphSLAM则采用历史优化的平行路线。
五个前置概念
五个前置概念:条件独立是在给定特定变量后独立;Rao–Blackwell 化对可解析部分积分、对其余部分采样;提议分布决定粒子从哪里产生;重要性权重修正提议与目标分布差异;持久化树共享不变数据并局部复制更新。
一、问题设定:地图相关性怎样在轨迹条件化后分解计算
上一章说明地图点不能直接当成独立变量,因为它们共享机器人轨迹的不确定性。FastSLAM 没有否定这个结论,而是换了表示方式:先保留多种机器人走过的路线;对于每条路线,单独维护一份地图。在某一条路线已经确定的条件下,各地图点才可以分别估计。
问题与假设
机器人平面位姿为 ,地图包含 个静态路标 。输入运动 、观测 ,以及已知或待推断的数据关联 。输出是轨迹和地图的后验表示,而不是动作策略。
运动模型 可以是非线性的;观测取决于当前位姿和被观测路标。论文先推导已知关联情形,再讨论未知关联。每步只写一个路标观测是记号简化,不是传感器必须每次只看到一个物体;多观测可依次处理,但计算成本也随观测数量增长。
地图静止、条件观测结构及路标先验的相应独立性,是分解成立的基础。如果观测本身测量的是两个地图点之间的相互关系,或地图先验含有额外耦合,不能不加分析就照搬逐点独立表示。
二、把联合后验分成轨迹粒子与条件路标滤波
核心公式:条件独立与边缘独立不是一回事
用 表示完整轨迹,将所有已知观测、运动和关联记作 ,原文式(4)的思想为
右侧的乘积以整条轨迹为条件。这并没有推出 ;对轨迹积分后,地图点一般仍然相关。
FastSLAM 用 个粒子近似轨迹后验。粒子 包含最新位姿、祖先所代表的轨迹假设,以及各路标的均值 与协方差 。概念上它代表一整条历史,递归实现却不必每步复制所有历史姿态:过去的信息已经进入条件地图及粒子祖先选择。
这里有三层准确程度。后验分解在给定模型下是精确恒等式;粒子集合是有限采样近似;非线性观测的单路标 EKF 也是近似。 不能因为第一层精确,就说整个实际算法精确计算了完整后验。
一步更新究竟做什么
第一步根据运动模型采样新位姿:
第二步对被观测路标计算预测观测 。令 是观测对路标坐标的 Jacobian,预测观测协方差为
第三步用更新之前的路标分布计算观测似然,形成粒子权重:
这是假设上一轮已经重采样为等权、已知关联且使用运动提议分布的常见写法;没有每轮重采样的实现还要乘上上一轮权重。分布的归一化因子也重要,不能只比较残差平方而忽略协方差体积。原文式(11)用对路标位置积分的观测概率推导这一权重。
然后在每个粒子内部,仅更新对应路标的低维 EKF,最后按归一化权重重采样粒子。未观测路标在该粒子的条件分布中保持不变;粒子总体权重改变后,它们的边缘分布仍可能变化。
条件独立怎样仍保留强烈的地图相关性
教学双粒子:轨迹假设A下,两路标均值为1、3;轨迹假设B下,为11、13,两假设各半,暂忽略每粒子内部方差。两点边缘均值为6、8,各自方差25,交叉协方差也为25,所以间距方差为 。每粒子里路标独立,并未抹掉“整张地图一起平移”的边缘相关性,它由粒子间差异承担。
若重采样把A全部删掉,之后每个路标EKF都十分精确,也无法恢复那条丢失的历史轨迹。这是Rao–Blackwell分解与有限粒子退化之间的界线。原文开头同时报告某些环境所需粒子数会很大,因而 中的 不能当作不受任务难度影响的常数。会议原文第593–594页
与MCL是粒子定位模块的组合及扩展;与联合EKF-SLAM是同一相关性问题的平行表示;GraphSLAM随后显式优化历史状态,选择保留的历史信息和可重线性化方式不同。比较地图规模时,应同时注明关联是否已知、粒子数以及回环长度。
为什么平衡树不是可有可无的实现技巧
每粒子维护 个小滤波器,看起来每次只更新一个就足够快。但重采样会复制粒子。如果复制粒子等于深拷贝全部 个路标,总时间仍会达到 。
原文第 596 页 Figure 2–3 将路标放在平衡树叶节点。一次更新只创建从根到被修改叶子的路径,其他分支引用旧节点。这是持久化数据结构的思路:共享部分必须不被原地修改,否则更新一个粒子会悄悄改变其他粒子的地图。
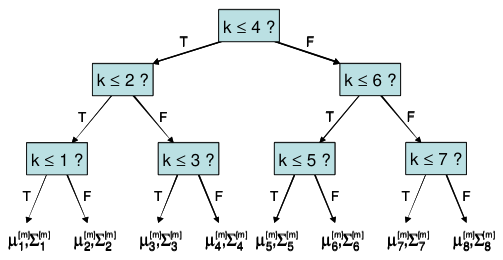
读图:内部节点按地标索引分支,叶节点存各自的均值与协方差;查找一个地标只需沿树的一条路径下降。
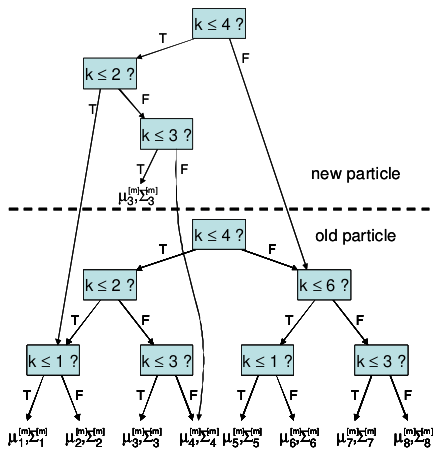
读图:虚线上方的新粒子只新建发生变化的路径节点,下方其余子树仍可共享;这解释了重采样不必逐次完整复制全部地标。
由此,已知关联、单个路标观测下,每粒子查找与更新路径长度为 ,总更新为 。这个复杂度没有说内存只需对数规模,也没有承诺 不会随问题难度增长。若数据关联需要扫描所有路标,完整系统也不再自动满足同样界。
在未知关联小节,作者提出每个粒子独立选择最可能关联,因此不同粒子可拥有不同地图数量和解释。作者关于特定假设下对数时间关联搜索的说法是可实现性的判断,不能当成正文已经完整证明了任意关联搜索的复杂度。
条件分解减少了路标之间的联合计算,重采样时整图复制仍可能抹掉收益。下面把共享树更新接到粒子循环,再读大地图复杂度。
三、更新粒子地图,并用共享树避免整图复制
输入:粒子集合,各粒子的条件路标地图,控制 u,观测 z
for 每个粒子 i:
    从运动模型采样新位姿 s[i]
    确定本粒子的观测关联 k
    if k 是已有路标:
        从本粒子的地图树读取旧均值和协方差
        计算预测观测、Jacobian 与创新协方差
        用旧路标分布计算观测似然权重
        更新该路标的 EKF
        仅复制地图树中通向该路标的分支
    else:
        按新路标模型初始化条件分布并增广地图
        使用与新路标假设一致的权重处理
归一化权重
按权重重采样,共享未修改的地图子树
输出:新粒子及条件地图分布
伪代码是教学重排。新路标分支与未知关联需要明确先验及阈值,不能直接沿用已有路标的高斯似然并假装已经完整解决地图生长。
一个自构小例子
机器人看到两根柱子,却不确定刚才向左还是向右偏了。保留两个粒子:左偏假设对应一份整体偏左的柱子地图,右偏假设对应另一份地图。各粒子内的柱子位置可以很确定,两份地图的整体差异却很大。
下一次看到已知结构的相对关系,某个粒子的预测更符合观测,其权重上升。没有直接修改另一个未观测柱子的高斯,该柱子的总体估计也改变,因为两份地图的混合比例改变了。这就是条件独立仍然保留边缘相关的具体含义。
四、一起阅读路标规模、精度和困难程度
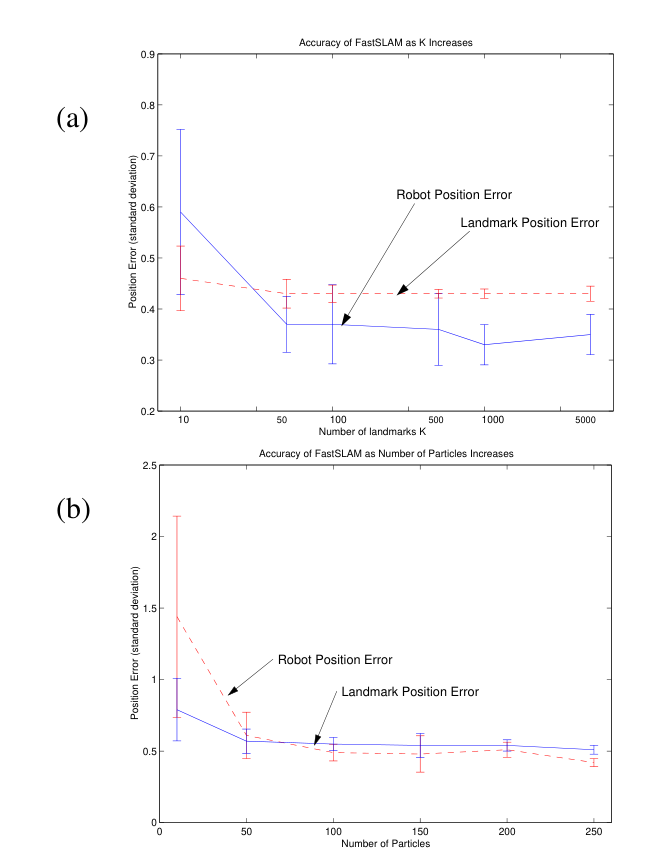
读图:两幅曲线分别改变路标数和粒子数,并给出区间。更多路标一方面加大地图,另一方面增加定位信息,因此误差下降不能解释为任何大地图都更容易。
这里是原始 FastSLAM,运动先验提议与后来使用当前观测的 FastSLAM 2.0 不同;同样的地图图形不能抹掉输入和提议分布差别。
| 项目 | 原文实验 | 验证内容与限制 |
|---|---|---|
| 实体平台 | Pioneer 机器人、SICK 激光,火星车研究用小型岩石场地 | 真实传感器上的建图可行性;并非火星实地实验 |
| 实体运动 | 近似直线行驶,10 个粒子 | 简单轨迹下少粒子可用,不代表复杂回环也只需 10 个 |
| 参考地图 | 人工确定岩石位置 | 有外部比较,但参考测量也存在误差 |
| 大规模模拟 | 路标数量最多 50,000,报告可用 100 个粒子建图 | 验证特定模拟条件的扩展能力,不是实机五万个路标 |
| 变量 | 路标数、粒子数和传感范围 | 区分更多几何信息与更复杂地图的不同作用 |
| 指标 | 地图与位姿误差,图中 95% 置信区间 | 支持趋势;正文没有给出可直接复现所有条件的完整参数表 |
| 计算比较 | 与传统 EKF 的规模复杂度和参数量比较 | 不等于在全部任务、相同精度下的统一墙钟排名 |
五个证据位置
Figure 1、式(4),第 594 页:图模型支持轨迹条件下的独立性。这是结构推理,不能由它单独推出实际粒子数应该是多少。
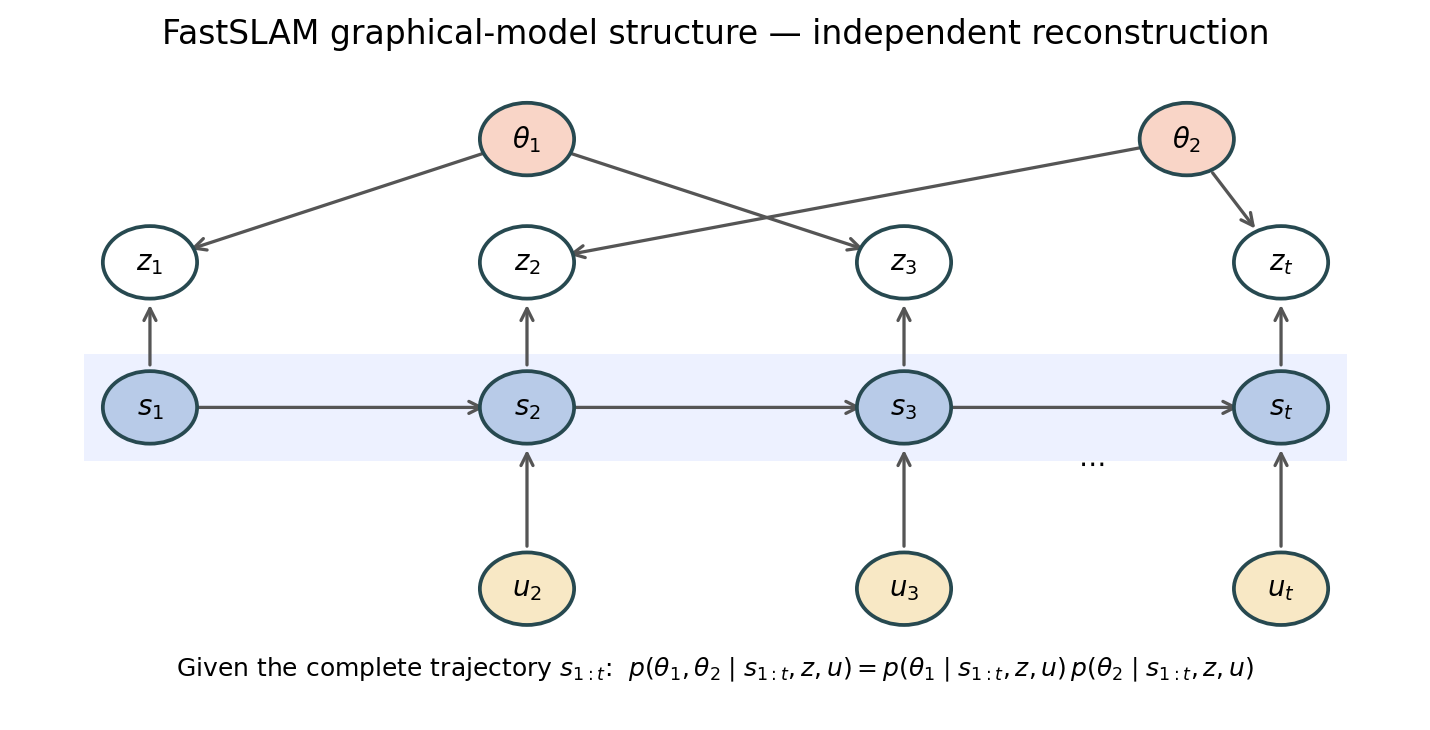
读图:此图独立重绘了原文图1的结构关系:控制影响后续位姿,位姿与地标共同决定观测;给定整条轨迹后,不同地标的后验可以分解。蓝色底带表示被条件化的轨迹,不是新的测量数据。
Figure 2–3,第 596 页:展示八个路标的树和只复制局部分支的更新。支持实现复杂度分析,尚不能证明未知关联前端也有同等效率。
Figure 4,第 597 页:原始路径和量测与最终岩石地图形成对照。作者报告相对人工地图的平均残余误差 8.3 厘米;这是指定场地、路线和地图比较,不是长期定位 RMSE。
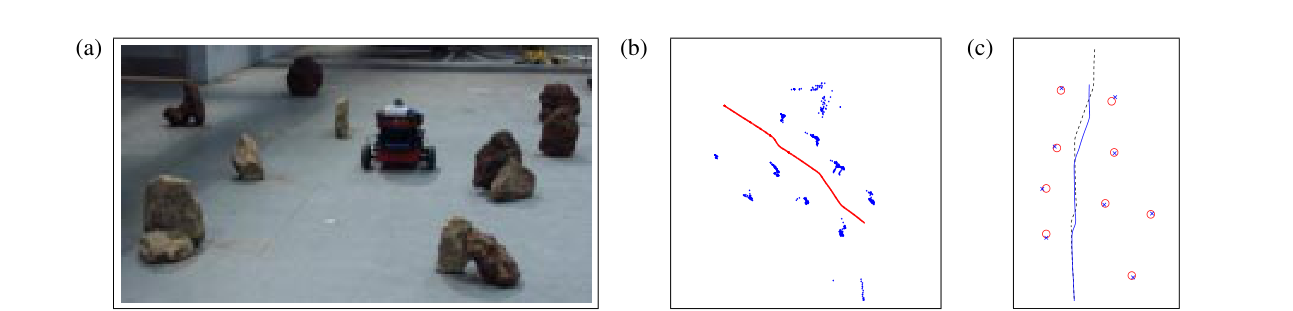
读图:三面板分别展示平台、带噪声的观测/路径与估计出的岩石位置;图中的小测试场景不能替代任意大规模环境的成功率。
Figure 5,第 598 页:较大与较小感知范围下的地图椭圆来自粒子和高斯的综合不确定性。它说明估计并非只有单一条件地图;不能将某个粒子内很小的协方差当成全局确定性。
尚未内嵌:图 5。概率依赖关系已原创重绘,三面板岩石平台/观测/地图已补齐;剩余为另一组物理与合成场景地图。当前数值精度、算法结构和具体地图证据已展示,暂不把额外地图集也全部复制。
Figure 6,第 598 页及第 597 页正文:粒子增多带来误差改善,部分模拟中路标增多也减小误差,并有 95% 置信区间。更多路标同时提供了更强定位信息,因此不能把这个结果读成“地图越大,任何环境都越容易”。
作者在开头也明确承认,有些条件需要的粒子数量可能高得不可接受。这与固定粒子数下的对数地图复杂度并不矛盾:算法成本包含 ,地图几何和运动噪声会影响需要多大的 。
五、检查轨迹退化、非线性近似与关联错误
如果运动模型散布很宽,而观测非常精确,先按运动采样可能很少命中高似然区域,权重会集中到极少数粒子。重采样复制它们后,历史路线的多样性丢失;很久以后回到旧地点,已被淘汰的合理历史并不会自动回来。
数据关联按粒子分开可以保留多个解释,但每粒子最大似然决策仍可能过早选错,而且有限粒子可能同时丢掉正确关联。它提高的是表达多个假设的能力,不是保证任何误匹配都可恢复。
与完整 EKF 的区别也不是“FastSLAM 不需要考虑相关”。相关信息从大协方差矩阵转移到轨迹假设的混合分布中。若只保存一个粒子并把它当成确定路线,就会丢失这个混合层的不确定性。
六、追问:条件于一条轨迹时路标独立,混合两条轨迹后为什么又相关?
条件于一条轨迹时路标独立,混合两条轨迹后为什么又相关?
参考答案:设两条轨迹假设都给出精确的相对地图,但一个整体向左偏、一个整体向右偏。条件在任一轨迹上,路标可分别估计;边缘化轨迹时,各路标一起选择左或右偏,因而重新相关。符号上,乘积的混合 一般不等于各边缘的乘积。这个两假设展开沿Särkkä条件分解的概率视角,解释轨迹粒子承载的是哪一类共同误差。
七、改善粒子提议,或改用稀疏历史优化
- 直接继承:GMapping:让粒子在有证据的地方采样。用当前扫描改善提议分布,并在必要时才重采样。
- 平行路线:GraphSLAM:让整段历史一起解释地图。改用历史轨迹的稀疏优化,避免把有限粒子当唯一表示。
八、自测与参考答案
问题 1:上一章说不能忽略地图点相关性,为什么 FastSLAM 可以用独立的小 EKF?
参考答案:小 EKF 只在一条给定轨迹的条件下独立。跨粒子的轨迹不确定性使地图边缘分布仍相关。删除全局交叉协方差与保留条件混合是不同操作,后者没有直接假设所有地图点在总体上独立。
问题 2:为什么只更新一个地图点,重采样仍可能很贵?
参考答案:如果每次抽中粒子就深拷贝其全部地图,每粒子要复制 个路标。平衡树允许共享未修改子树,只复制一条分支,才把这个步骤降到对数级;共享节点必须避免被原地改写污染其他粒子。
问题 3:论文在五万个路标上用一百个粒子成功,能否推出城市 SLAM 固定一百个粒子足够?
参考答案:不能。原结果来自特定模拟观测、运动与几何条件。需要多少粒子取决于后验多峰、噪声、回环间隔和关联歧义;更多路标有时增加观测约束,但真实城市的遮挡和歧义也可能令后验更难表示。