055|GMapping:让粒子在有证据的地方采样
总览 · 目录 · 上一篇:Capture Point · 下一篇:PTAM
论文:Giorgio Grisetti、Cyrill Stachniss、Wolfram Burgard,Improved Techniques for Grid Mapping With Rao-Blackwellized Particle Filters,IEEE Transactions on Robotics,23(1),34–46,2007。作者实验室全文;出版记录。以下依据作者稿方法、复杂度分析与实验正文,定位采用稿内章节、图表。期刊年份为 2007,DOI 中的 2006 不是应当替代它的发表年份;2005 年会议前作与这篇扩展版也有方法差别。
先接住前作的问题
FastSLAM的分解减少地图耦合计算,却仍可能把粒子浪费在观测不支持的位置。本篇把扫描信息放进提议分布并调节重采样。
五个前置概念
五个前置概念:占据栅格把空间离散为带占据概率的单元;条件独立让固定轨迹下的地图更新变简单;重要性采样用权重纠正抽样分布与目标分布的差异;扫描匹配寻找当前扫描与旧地图的局部几何对齐;粒子贫化指重采样使历史解释的多样性丧失。
一、问题设定:新扫描怎样在抽样之前减少无效轨迹粒子
机器人认为自己往前走了一米,轮子却可能打滑;激光看到的墙壁又把位置限制在很窄的范围里。如果先按照宽泛的里程计分布撒点,再用激光给这些点打分,大量点从出生开始就几乎没有用。地图还要跟随每个点各存一份,这种浪费尤其昂贵。
问题定义:一个粒子其实带着一段历史
状态 是平面位姿,输入 是相邻更新间的里程计增量,观测 是激光扫描, 是占据栅格地图。这里没有奖励、策略学习或训练回合;目标是随数据到来估计轨迹和地图的联合后验。
第 II 节式(1)把联合分布分为:
如果已经知道一条轨迹,把每束激光投到地图上就相对简单;困难在于不知道该相信哪条轨迹。粒子因此代表轨迹假设,各自关联条件地图。它不是“机器人当前坐标加一点随机噪声”这么简单:重采样删除一个粒子,也会删除其独有的历史解释。
它沿用 RBPF 的分解与重要性采样,采用栅格而非预先提取的离散路标。和 FastSLAM 的共同点是对轨迹采样、对条件地图做更直接的估计;区别包括地图表达、观测似然和提议分布的具体构造。
基本假设包括可用的运动与测量概率模型、相邻扫描足够接近、地图主要满足平面和静态结构近似。动态行人或不平地面偶尔出现并不必然导致失败,但演示能容忍一些违背不等于摆脱了这些假设。
二、结合扫描与里程计构造提议,再选择性重采样
最优提议不等于每个粒子最终都同样可信
记第 个粒子的旧地图为 。在给定旧粒子的条件下,理想的新位姿提议是:
这是观测似然乘运动先验。第 III-A 节讨论它降低重要性权重方差的性质。它仍然依赖旧粒子的历史;两个地图对新扫描的解释能力不同,权重不会自动相等。
若能精确按这个条件分布抽样,权重增量是归一化常数:
把观测用于提议后,不能再不加区分地套用“旧权重乘新位置的似然”,否则忽略了提议分布的变化。一般重要性公式必须包含目标密度与提议密度的比值。
实际系统用局部高斯近似
栅格似然没有方便的闭式积分。作者先从里程计预测启动扫描匹配,找到每个粒子附近的高似然位置,再在其邻域取评估点 。令
随后从 采样,以邻域积分的近似更新权重。这是式(15)—(19)的思路,不是精确表达任意多峰后验。角度在局部邻域内处理,跨越角度周期边界时实现仍须保持一致。
2005 年前作在局部区域近似把运动先验视为常数;这篇明确把运动先验也纳入矩估计。在长直走廊里,激光对沿走廊方向的位移约束弱,里程计就不能随意丢掉。这个差别解释了扩展版的一组专门实验。
重采样看权重,不看时钟
归一化权重为 时:
作者在它低于 时重采样。均匀权重给出 ,单个粒子独占权重则接近 1。该量诊断的是权重集中程度,不能检查所有粒子是否一起相信了一张错误地图。
把观测移到提议分布里,权重公式也必须一起改
记运动先验 、当前扫描似然 、采样提议 ,则新粒子权重与 成正比。若理想提议取 ,其中 ,同一旧粒子的所有新样本权重都只剩 。观测引导采样减少权重波动,原因正是分子与提议匹配,而非“粒子都往峰顶放就行”。
教学高斯例运动先验 、位置观测为1且噪声方差0.01,理想后验均值约0.9901、方差约0.009901。只按先验抽样会浪费大量粒子;扫描匹配附近的提议更集中,但若匹配选错重复走廊的峰,局部高斯同样可能自信地错。
本篇承接FastSLAM的Rao–Blackwell骨架,并把占据栅格作为条件地图模块。原文第II–III节同时改进提议与重采样时机,所以实验中的少粒子优势不能只归因于扫描匹配,也不能直接比较不同更新频率的运行时间。
提议分布先使用新扫描,权重更新和重采样必须与这一选择一致。下面用窄观测约束的例子检查有效粒子,再比较拓扑正确率与整体成本。
三、执行局部匹配和权重更新,用窄似然验算
输入:旧粒子(位姿、权重、地图),里程计增量,新激光扫描
对每个粒子:
    从里程计产生扫描匹配初值
    在该粒子的旧地图中做局部扫描匹配
    若匹配失败:
        从运动模型采样新位姿
        权重乘该位姿下的观测似然
    否则:
        在匹配位置附近评估“观测似然 × 运动先验”
        计算局部高斯均值、协方差和近似归一化常数
        从高斯采样新位姿,用对应常数更新权重
    依据新位姿把当前扫描融合到该粒子的地图
归一化权重,计算有效样本数
若有效样本数 < 粒子数 / 2:重采样粒子及其关联地图
输出:更新后的轨迹与地图假设集合
这是依照 Algorithm 1 整理的教学伪代码。关键顺序是用旧地图评价当前扫描、估计位姿,再将扫描写入地图;先把当前扫描写入再评价它,会制造自我支持。
一个可手算的小例子
下面是教学构造。把位置简化成一维,里程计给出 ,激光相当于观测 、标准差 0.02。高斯相乘得到
因此 ,。按旧运动先验撒点与按这个条件分布撒点,计算预算相同,落入激光支持区的比例却截然不同。真实栅格没有这样的闭式高斯,所以论文才需要扫描匹配和局部矩估计。
再假设四个归一化权重是 0.7、0.1、0.1、0.1,则 ,触发重采样。如果四点都是同一个错误位置的复制品且权重各 0.25,有效样本数反而为 4。这说明它不是“正确假设数”。
四、比较拓扑正确率门槛、粒子数与计算成本
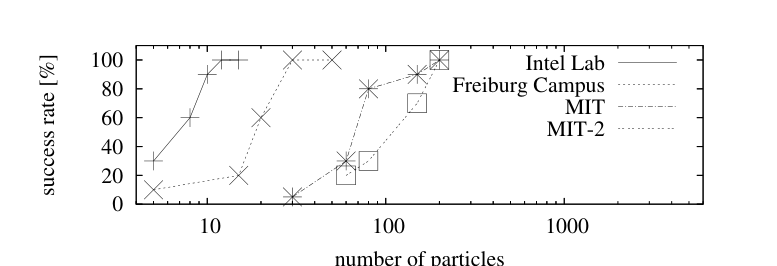
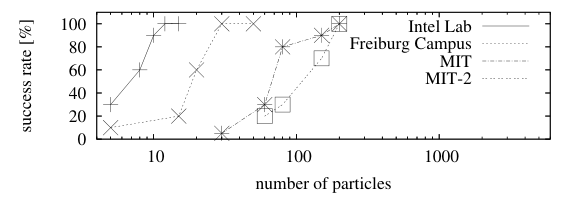
读图:完整横轴标为number of particles并使用对数尺度,纵轴为成功率;四组环境达到高成功率所需粒子数不同,MIT-2还禁用了自适应重采样,不能把所有差异都归因于地图大小。
读图:横轴粒子数、纵轴成功比例把多环境的预算需求并列。先看每个场景何时开始稳定成功,再讨论建议粒子数;不同地图的阈值不能简单互换。
实验如何验证
| 项目 | 原文设置与要验证的内容 |
|---|---|
| 数据 | Intel Research Lab、Freiburg Campus、MIT Killian Court 等真实机器人日志;包括室内与室外 |
| 传感器 | Pioneer 与 B21r 等平台、SICK LMS/PLS 激光;不是 RGB-D 或现代多线三维雷达实验 |
| 主要对比 | Hähnel 等人的 RBPF;关闭自适应重采样;提议分布中忽略或考虑里程计 |
| 指标 | 地图拓扑正确率、达到门槛的粒子数、地图外观、运行时间与内存;不是统一真值 ATE 排行 |
| 重复与判断 | 图 7 每个成功率来自 20 次运行;由非作者检查者盲评地图一致性,以拓扑正确为成功标准 |
| 数据版本 | MIT 使用没有预先校正里程计的原始版本;混用已校正版本会改变问题难度 |
| 时间预算 | 默认 30 粒子,移动超过 0.5 m 或旋转超过 25° 才融合新扫描;不是每个传感器帧都运行完整更新 |
| 资源 | 第 VI-F 节为 2.8 GHz PC;Intel 日志采集 45 分钟,处理少于 30 分钟,约 150 MB 内存 |
“训练与测试分离”不直接适用,因为没有训练一个跨日志预测模型;但参数选择是否针对某些数据、日志来源是否一致、重复是否只是同一条日志换采样随机数,仍影响外推。20 次算法运行也不能当作 20 次独立环境采集。
五处证据,以及不能推出的结论
图 2:观测改变了不确定性的方向。 开放走廊中的粒子沿走廊分散,末端出现后位置进一步收紧。这支持几何信息决定提议形状,不能证明图中的窄分布一定与真实误差校准一致。
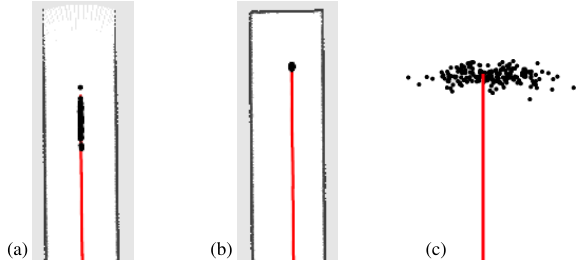
读图:三个面板对照粒子沿走廊和横向的散布;观测约束能压缩某些方向的不确定性,却不能凭空消除走廊方向的歧义。
表 II:比较条件是至少 60% 拓扑正确。 Intel、MIT、Freiburg 所需粒子分别为本文 8、60、20,对比方法 40、400、400。对应粒子数量比为 5、约 6.67、20,并非三个任务都刚好十倍。它也不是定位误差降低这些倍数。
图 6 与第 VI-A 节:拓扑正确不等于墙壁精确。 MIT 用 60 粒子可生成拓扑正确地图,但有时出现双墙;80 粒子改善地图质量。这正好说明只报二值成功率会隐藏局部几何缺陷。图 4 的厘米级网格放大展示也不等于有独立真值证明厘米级定位精度。
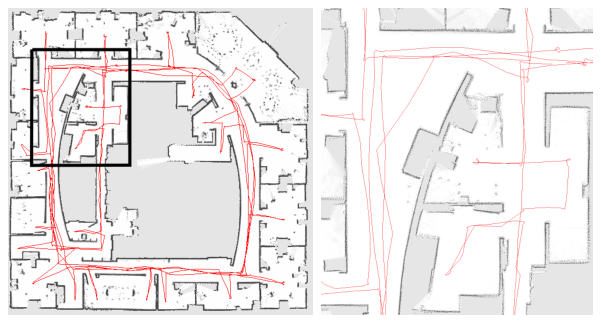
读图:左图显示整体地图和轨迹,右图放大方框区域;闭环后局部墙线是否对齐比只看轨迹是否围成一圈更有诊断价值。
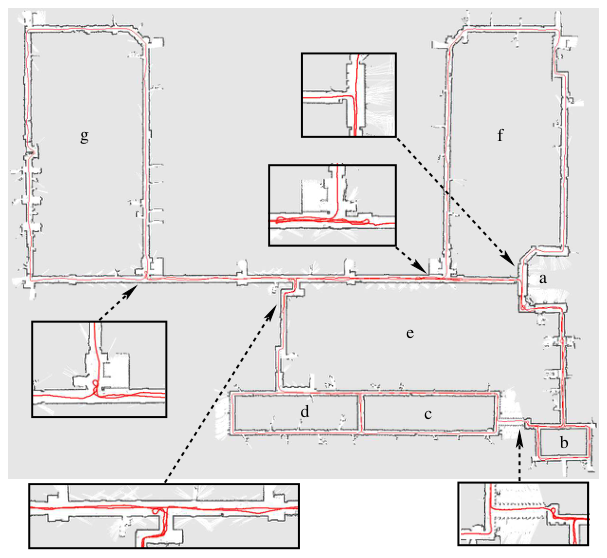
读图:多个放大框检查同一地图的局部墙线重合情况;整体轮廓看似完整时,局部重影仍可能暴露累积位姿误差。
图 7、8:自适应重采样的作用有单独证据。 MIT-2 关闭自适应重采样,成功率随粒子数的曲线与完整方法比较;有效样本数随回环事件变化的图解释了为何需要有选择地重采样。图形支持该设置下的改善,不能把某个事件之后的权重下降直接视作回环检测器。
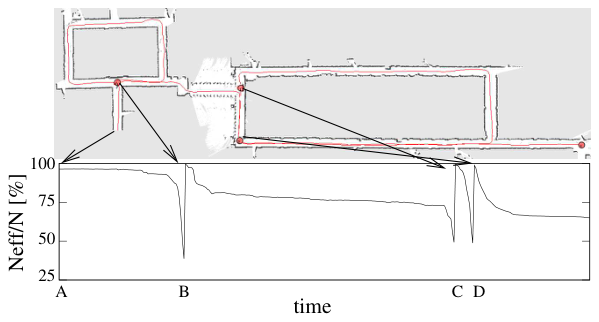
读图:上方路径标记对应下方Neff/N曲线的时间点;急剧下降说明权重集中,重采样时机应依据这一退化信号。
第 VI-F 节和表 III:少粒子不等于毫秒更新。 完整日志可以快于采集时间处理,但融合是按运动阈值触发的。表 III 分项包括提议、权重及地图更新平均 1910 ms,重采样检查 41 ms,重采样 244 ms。不能将“在线”误读为每帧都满足激光原始频率的最坏延迟保证。
五、检查局部模式遗漏和粒子地图代价
贡献是把观测引导采样和有效样本数控制落实到密集栅格 RBPF,并解释它们如何共同减少地图假设的浪费;这些概率原则各有前人,不能说粒子滤波或自适应重采样由本文首次提出。
第 III-C 节承认局部扫描匹配可能遗漏其他峰。多个粒子的不同初值能够保留若干解释,但一旦正确历史都已被删除,局部高斯不会凭空重新创造它。严重重复结构、很差的里程计与低重叠扫描可能共同放大这个问题。
第 VI-E 节记录了玻璃走廊中的行人遮挡、空旷停车场大量最大量程返回等扫描匹配失败情形。回退里程计让系统继续更新,却不表示信息损失已经被补回。长时间没有几何约束时,后验应扩散。
复杂度表中通常更新对粒子数线性,依赖局部搜索和观测规模固定的条件;复制整张地图的重采样最坏为 , 为地图大小。更精巧的共享地图数据结构可以改善开销,但不是这篇给出的全部解决方案。
六、追问:更少粒子达到同样正确率,是否已经证明总计算更少?
更少粒子达到同样正确率,是否已经证明总计算更少?
参考答案:还需计算每个粒子的扫描匹配、地图更新与重采样开销。改进提议让单个粒子更有效,但单个粒子也可能更贵。应在相同日志和正确率口径下报告整体时间与资源,不能只按粒子数给出加速倍数。
七、区分粒子地图与历史图优化
- 模块组合:Occupancy Grid:地图不只记录哪里有墙,还记录有多确定。粒子内部地图采用占据栅格,仍要检查传感器与独立性近似。
- 平行路线:GraphSLAM:让整段历史一起解释地图。用历史图优化组织相同估计目标,不能仅按粒子数评价优劣。
八、自测与参考答案
1.激光已经用于生成新粒子,为什么还要更新权重?
答: 提议只是在某个旧轨迹、旧地图条件下生成新位姿。不同历史对当前观测的整体解释能力不同,仍需比较其证据 。精确条件提议消除了新位姿采样带来的一部分权重波动,却没有消除不同历史之间的概率差异。实际高斯近似还引入了近似误差。
2.为什么扫描匹配很准,仍然不能只留一个粒子?
答: 很准可能只是某个局部模式内的拟合很尖锐。两条外观相似的走廊能分别形成很好的局部匹配,但历史不同;一个位姿点不能表达这种歧义。单粒子还无法在错误历史和正确历史之间重新分配概率。只有场景和运动已充分消除歧义时,少量假设才可能足够。
3.复现发现 8 个粒子就能得到 Intel 地图,能否写“GMapping 只需 8 个粒子即可可靠建图”?
答: 不能。表 II 的 8 对应特定日志、参数和至少 60% 拓扑正确的门槛,不是高可靠性保证,更不是任意环境结论。还要说明是否出现双墙、是否使用同一原始里程计版本、重复次数与失败比例;若要宣称可靠部署,需要独立场景和更严格的错误指标。